


3360亿晶体管!性能怪兽-英伟达 Rubin GPU 架构全面拆解分析
英伟达RubinGPU采用台积电3nm制程,集成3360亿晶体管,配备288GBHBM4内存与22TB/s带宽,TensorCore及TransformerEngine全面升级,智能体吞吐量较Blackwell提升10倍,已进入全面供货阶段。
终于,英伟达完整披露了 Rubin AI GPU 架构的细节。这颗芯片,可以说是为智能体时代量身打造的,其性能相较于上一代 Blackwell,实现了堪称飞跃式的提升。
英伟达用 Rubin 重塑了数据中心的标准,它宣称,这颗芯片拥有全球最快的 AI 性能。没错,Rubin GPU 是下一代数据中心平台的核心,历经数年打磨,如今终于进入全面供货阶段。首批 Rubin AI 平台已经落地全球多家大型科技公司,英伟达也终于到了可以完整公开其架构细节的时候——正是这些设计,造就了这颗将深刻影响智能体格局的强力 AI 芯片。
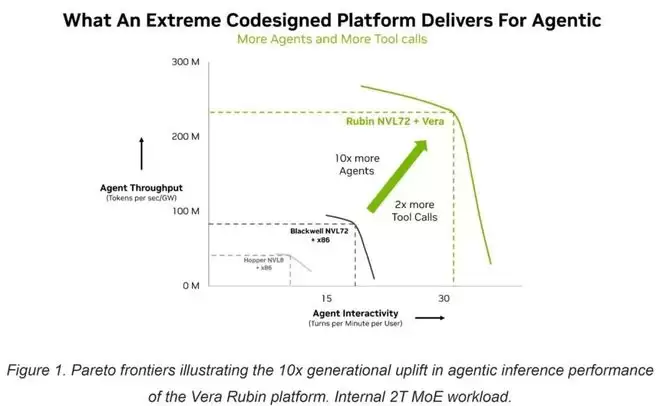
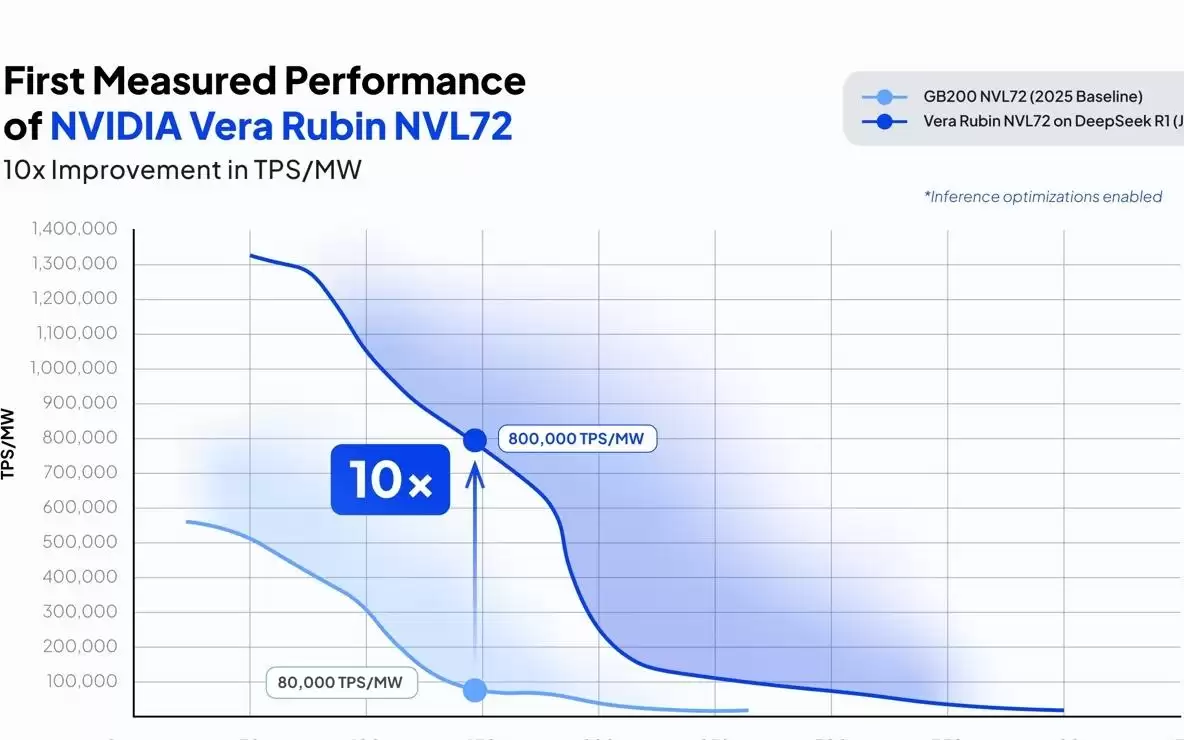
先看一张图,它直观展示了极端软硬协同平台在智能体场景下的交付能力:Rubin NVL72 搭配 Vera 处理器,相对 Blackwell NVL72 搭配 x86 方案,可支持 10 倍的智能体吞吐量和 2 倍的工具调用能力。
那么,这惊人的 10 倍提升(单位能耗下的智能体吞吐)从何而来?英伟达指出,主要依托三大架构变革:
- 增强型 Tensor Core,精度能力进一步扩展
- 全新的 HBM4 内存子系统
- 第三代 Transformer Engine
我们从架构拆解入手,看看这颗芯片内部到底藏着什么秘密。
Rubin 架构拆解:数百亿晶体管级的巨兽
英伟达 Rubin 芯片采用台积电 3nm(N3P)制程,使用了两个光罩极限尺寸的管芯(die),来实现其高密度与高效率。这两颗管芯通过英伟达的高带宽接口(NV-HBI)封装在一起。整颗芯片总共集成了 3360 亿个晶体管,比 Blackwell GB300 多出了 62%。
每颗 Rubin GPU 内部有 8 个 GPC(图形处理集群),合计 224 个 SM(流式多处理器)和 896 个 Tensor Core。平均下来,每个 GPC 大约有 28 个 SM 和 112 个 Tensor Core。但从架构框图来看,GPC 实际上分为两类,一类拥有 30 个 SM,另一类有 26 个 SM。
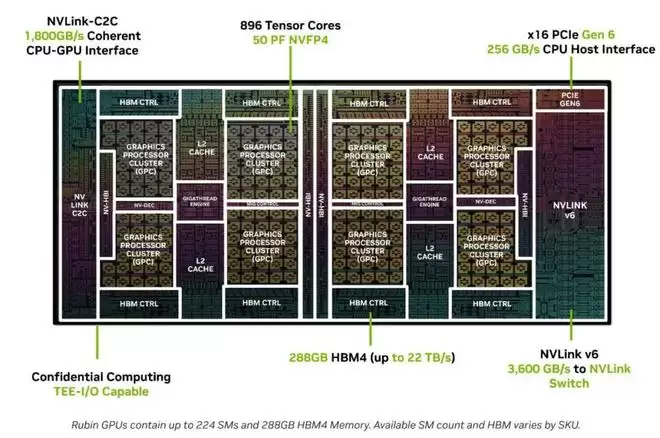
具体来看架构概览:它拥有 1,800 GB/s 的一致性 CPU–GPU 接口;896 个 Tensor Core,支持 50 PF NVFP4 精度;配备 288 GB HBM4 内存,带宽最高可达 22 TB/s;通过 NVLink Switch 实现 3,600 GB/s 的互联带宽。
每颗管芯内部有 4 个 GPC,连接着两大块去中心化的大容量 L2 缓存、Gigathread Engine、四个 HBM 通道(每管芯 4096 位)以及 NVLink 接口。芯片还集成了 PCIe Gen6 控制器,用于对接主机 CPU。NVLink v6 IO 与 NVLink 交换机相连,带宽为 3600 GB/s。此外,还有 MIG 控制器用于将 GPU 划分给多任务负载,以及 NV-DEC 用于加速解码。
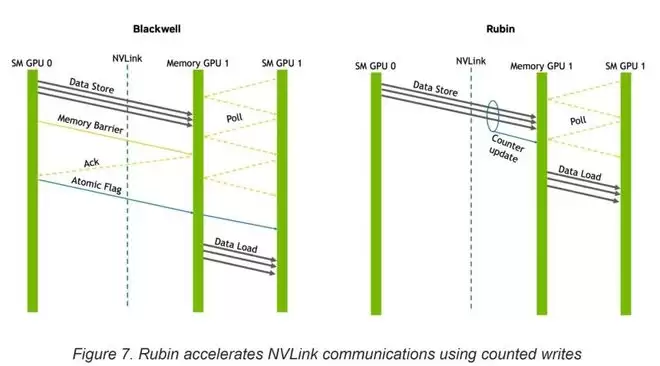
在通信方面,Rubin 通过计数器更新等方式,加速了 NVLink 通信,与 Blackwell 相比有显著改进。芯片还通过 TEE-I/O 支持机密计算,可以在 AI 工作流中保护静态、传输中与使用中的数据安全。
市面上最快的 HBM4:更快的数据搬运
内存方面,Rubin 采用了最新的 HBM4 标准。在当今 AI 场景中,数据搬运速度至关重要。Rubin 全力配置了 288 GB 容量,由八个 12 层堆叠(12-Hi)组成,每堆叠 36 GB,每颗 DRAM 3 GB。这些堆叠的峰值带宽达到了 22 TB/s,是目前市面上最快的 HBM4 方案。
英伟达还采用了新一代增强型 Tensor Memory Accelerator(TMA),在片内高效搬运高度复杂的数据。同时,NVLink 6 提供了 3600 GB/s 的 scale-up 带宽,支撑全互联的 GPU 间通信。NVLink-C2C 接口提供 1800 GB/s 的 CPU 到 GPU 通信;PCIe Gen6 ×16 通道为主机 CPU 连接提供了 256 GB/s 的带宽。
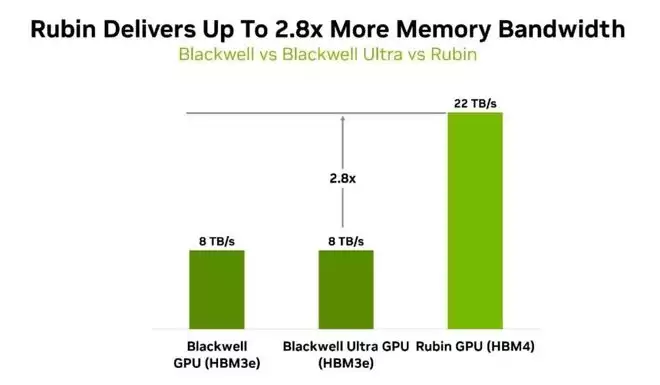
从这张图可以清晰看到,Rubin 的内存带宽最高可达前代的约 2.8 倍——Rubin(HBM4)为 22 TB/s,而 Blackwell/Blackwell Ultra(HBM3e)均为 8 TB/s。
HBM4 助力 token 生成
Rubin 的 HBM4 面向功耗与算力效率最大化设计,能够带来更快的解码与 token 生成能力。当今多数负载都长时间处理长上下文、大 KV 缓存以及交互式 token 生成,这使得带宽变得至关重要。相比 Blackwell 内存方案的 2.8 倍提升(22 TB/s 对 8 TB/s),HBM4 方案带来的好处是:
- 容量:支撑模型常驻、更大上下文窗口、更大 KV 缓存与更高并发,减少不必要的 KV 缓存换出(offload)。
- 带宽:支撑逐 token 生成阶段——模型权重与 KV 状态必须快速搬运,才能让计算引擎保持忙碌。
- 内存子系统:TMA 与内存局部性策略帮助软件高效使用内存子系统,使复杂数据布局也能达到较高的实际带宽。
可以说,HBM4 放大了 Rubin 的能力,对支撑数万亿参数级模型、在不必费力换出 KV 缓存的情况下拉长上下文,以及实现更高并发与长视野推理负载,都至关重要。
增强型 Tensor Memory Accelerator:加速 MoE 与 token
Rubin 还搭载了增强型 Tensor Memory Accelerator(TMA)。随着 MoE 模型中专家数量增加,TMA 能高效地定位并搬运专家权重。通过改进的描述符(descriptor)处理,TMA 降低了数据搬运开销,让软件路由与执行更高效。Inline Descriptor 也更新了对 TMA 的支持:内核可以为共享同一布局的张量保留一份统一描述符,并在运行时直接在 TMA 指令中覆盖内存指针、步长等字段。
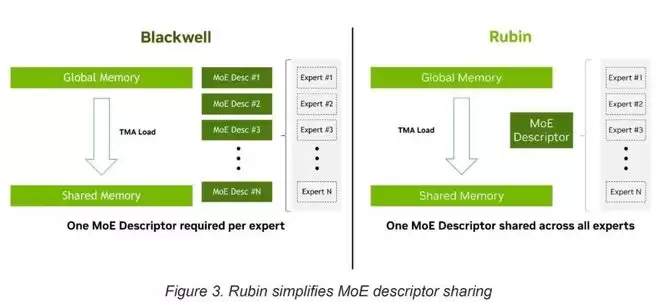
对比来看,Blackwell 每个专家需要一份 MoE 描述符,而 Rubin 可以在所有专家间共享一份 MoE 描述符。结果是:即使专家数量增加,MoE 模型的扩展也更高效。芯片可以把更多时间用于推理计算,从而获得更高吞吐。
更快的 Tensor Core,更高吞吐
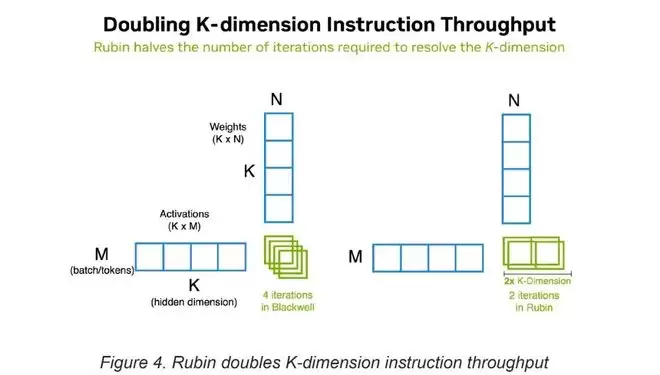
增强型 Tensor Core 实现了每时钟周期吞吐翻倍。做法是把 Tensor Core 沿 K 维一次可处理的数据量加倍。这对吞吐受限内核以及内存/延迟受限内核都有帮助。英伟达解释,更大 K 维的好处是减少 K 循环迭代次数。例如,在 Blackwell 上需要 4 次 K 迭代的 GEMM,在 Rubin 上只需 2 次即可完成。
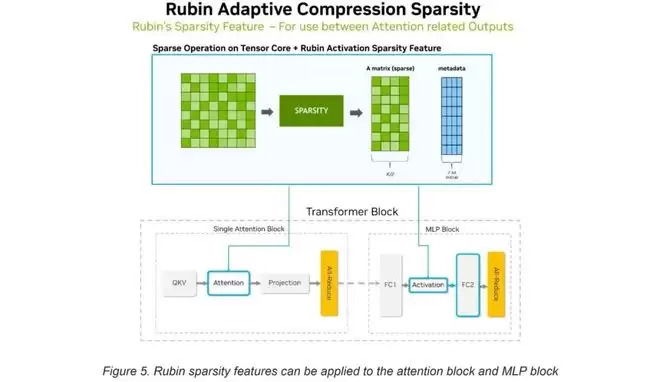
注意力(attention)机制也有改进:将激活稀疏与自适应压缩结合,并提高了 softmax 吞吐。注意力流水线先做稠密 QK^T 计算,生成中间注意力分数。随后,Rubin 可将该中间数据从 Tensor Memory 加载为结构化的 2:4 稀疏压缩形式,同时生成非零值及高效使用所需的元数据,从而降低分数的写回代价与存储需求。这样,后续注意力阶段可在更少数据上运算,同时仍保持模型其余部分期望的稠密输出格式。
相对基线 Blackwell,Rubin 的指数(exponential)吞吐能力也有提升。相对 GB200,Rubin 提供每时钟每 SM 2 倍的 FP32 吞吐,与 GB300 相同;BF16/FP16 吞吐相对基线 Blackwell(GB200)为 4 倍,相对 Blackwell Ultra(GB300)为 2 倍。
Rubin 还支持依赖内核之间更细粒度的协同。消费端工作可以在所需输入数据就绪后更早启动,而不必等更大一批生产端工作全部完成。
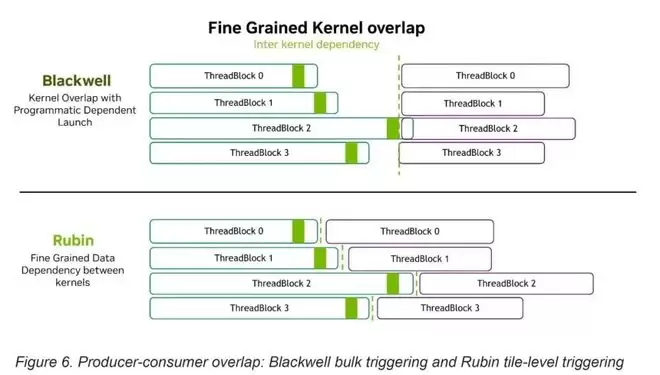
结果是 GPU 时间线更紧凑,空闲空隙减少,依赖内核之间的重叠更好。这对智能体推理尤其有价值:激活沿模型顺序流动,内核间延迟会直接反映到每用户每秒的 token 数上。
DSX MaxLPS:能效上的渐进提升
对当今 AI 数据中心而言,另一个关键因素是能效。Vera Rubin NVL72 属于顶尖系统,并引入了一些新手段来拓展能效,例如功率导向(power steering)以及带储能的智能功率平滑(Intelligent Power Smoothing),纳入同一执行域,目标是在固定功率包络内最大化有用 token 产出。
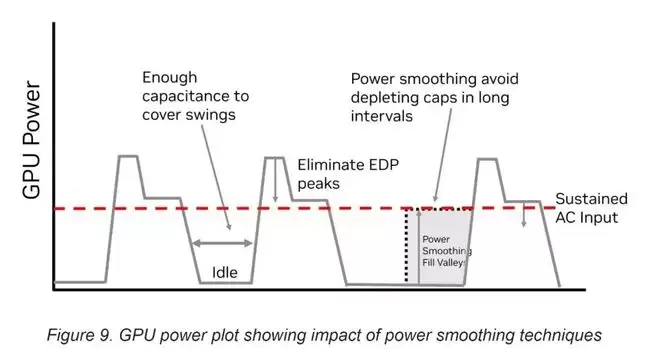
瞬态尖峰会拖累整体吞吐,让 AI 工厂中可用容量被“闲置”。为此,Vera Rubin 系统配备了基于荷电状态(SoC)的智能功率平滑电源,吸收这些瞬态波动,使平均功耗相对上一代约降低 10%。它们还将 50 ms 峰值功率降低 20%,形成更平滑的功率曲线,并能支撑最大功率需求。
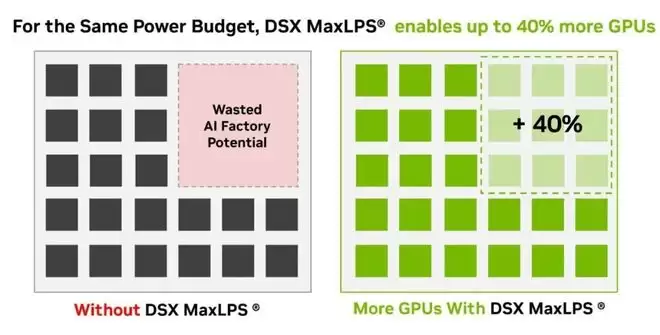
面向 AI 工厂,英伟达 DSX OS(含 DSX MaxLPS)覆盖 GPU、机架、液冷与工作负载,提供调度、生命周期管理与健康自动化等运维层能力,使在相同功率预算内可多部署约 40% 的 GPU,从而提高每次部署的吞吐。
上述能力合在一起,使 Rubin 成为 AI 数据中心的顶尖芯片,并将开启面向未来 AI 能力的新征程——覆盖智能体 AI 工作流,以及更往后的形态。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。