


Pythonfromimport导入模块所有内容的方法
引言 写Python代码的时候,很多朋友刚起步时特别喜欢用 from module import * 这种写法。说白了,就是图个省事——一行代码把模块里所有东西全搬过来,不用每次调用都敲一遍模块名。这种简化的语法在初学者圈子里特别受欢迎,感觉就像开了个捷径。但老实说,所有看似简单的解决方案背后,往往
引言
写Python代码的时候,很多朋友刚起步时特别喜欢用 from module import * 这种写法。说白了,就是图个省事——一行代码把模块里所有东西全搬过来,不用每次调用都敲一遍模块名。这种简化的语法在初学者圈子里特别受欢迎,感觉就像开了个捷径。但老实说,所有看似简单的解决方案背后,往往都藏着坑。随着项目越做越大,这些坑会从“小麻烦”变成“大事故”。今天咱们就来好好聊聊这个主题,看看它的真实面目到底是什么。
什么是from import *?基础语法与示例
from import * 这玩意儿的核心功能,就是把模块里所有公开的成员一股脑全导进来。Python的模块里可以装很多对象——函数、类、常量之类的。用 * 这个通配符,你就能省掉每次写模块名的麻烦,代码看起来确实干净不少。比如标准库里的 math 模块:
# 传统导入方式(需通过math前缀访问)
import math
print(math.sqrt(16))  # 输出4.0

# 使用from import *导入
from math import *
print(sqrt(16))      # 输出4.0(无需math前缀)
第二个例子里,sqrt 函数直接被拉进了当前命名空间,不用再写 math. 前缀了。这在简单的脚本里确实让代码更紧凑、更好读。random 模块也经常被这么干:
from random import *
print(randint(1, 10))  # 随机生成1-10的整数
这种写法在小型脚本或快速原型开发中挺常见。但问题是,它的简洁性值不值得冒那些潜在风险?咱们得好好琢磨琢磨。
关键点:* 只导入公共成员(以 _ 开头的私有成员会被跳过)。比如 math 模块里的 _sqrt 这种私有函数,from math import * 是不会把它带进来的。
为什么from import *如此吸引人?它的优点
实事求是地说,在初学阶段,from import * 的吸引力确实很大:
1. 代码简洁,减少冗余
不用反复敲模块名,代码量一下就降下来了。对于熟悉模块的人来说,这确实能提升可读性。比如处理日期的 datetime 模块:
# 传统方式(冗长)
import datetime
today = datetime.date.today()

# from import *方式(简洁)
from datetime import *
today = date.today()  # 无需datetime前缀
2. 快速原型开发
在快速实验或小型脚本中(比如数据探索阶段),from import * 能明显加速开发节奏。看看用 numpy 的例子:
from numpy import *
x = array([1, 2, 3])
print(mean(x))  # 输出2.0
这种写法让数据科学入门变得很简单,不用花时间去记模块名。
3. 简化学习曲线
对新手来说,import * 降低了起步门槛。他们不必立刻搞懂模块命名空间的概念,能更快地写出能跑的程序。比如学 turtle 绘图时:
from turtle import *
forward(100)
right(90)
这比写 import turtle 然后 turtle.forward(100) 直观得多。
官方怎么说:Python官方文档的态度是,import * 在脚本中用用还行,但不推荐在库或者大型项目里用。
深入陷阱:为什么from import *可能毁掉你的代码?
虽然优点挺诱人,但 from import * 的潜在问题会在项目膨胀时集中爆发。以下是几个关键陷阱:
1. 命名冲突:最常见且危险的错误
当多个模块导入了同名的对象,后导入的会把先导入的覆盖掉。看这个例子:
# 文件:script.py
from math import *   # 导入sqrt
from random import * # 导入sqrt(random也有sqrt?不,但假设其他冲突)

# 问题:sqrt被覆盖!
print(sqrt(4))  # 这里会出错?取决于random是否定义sqrt
实际冲突示例:math 和 numpy 都包含 sqrt,但行为可能不同:
from math import *
from numpy import *

print(sqrt(4))  # 会输出2.0(来自numpy?但取决于导入顺序)
如果 numpy 先导入,sqrt 就会被 numpy 的版本覆盖,math.sqrt 就没了。更糟糕的是,如果两个模块没有同名的函数,但其他名字撞车(比如 sin、cos),代码可能会在运行时挂掉,而且报错信息模糊得要命:
# 问题:导入顺序导致sin被覆盖
from math import *
from numpy import *

print(sin(0))  # 会输出0.0,但实际是numpy的sin
# 如果后续代码依赖math.sin,可能出错
报错时可能看到这样的信息:
NameError: name 'sqrt' is not defined
这种错误在大型项目里排查起来,真能让人崩溃。
2. 可读性与可维护性灾难
from import * 会让代码的来源变得模糊。当你看到 sqrt(4) 时,没法快速判断它来自哪个模块。这对团队协作和后期维护来说非常痛苦:
# 代码片段
x = sqrt(16)
y = randint(1, 10)
z = mean([1, 2, 3])

# 问题:sqrt, randint, mean 都从哪里来?需要全局搜索
对比一下清晰的写法:
import math
import random
import numpy as np

x = math.sqrt(16)
y = random.randint(1, 10)
z = np.mean([1, 2, 3])
在清晰的版本里,每个函数的来源一目了然。这不仅仅是代码风格的问题,而是可维护性的核心。Real Python 的文章强调,清晰的导入是高质量Python代码的标志。
3. 隐藏依赖与潜在性能问题
from import * 会导入所有对象,包括你根本用不上的那些。这可能导致:
- 内存浪费:加载了一堆不必要的东西。
- 命名空间污染:全局命名空间变大,还可能跟已有的变量冲突。
比如 from tkinter import * 会导入几百个GUI对象,你可能只用到了 Button 和 Label。这不仅浪费资源,还增加了意外冲突的风险。
4. 与模块设计原则冲突
Python的PEP 8(编码风格指南)明确建议避免 from module import *。PEP 8 的原话是:
“绝对不要用 from module import *。”
它强调显式导入才是可读性和可维护性的基础。用 * 完全违背了Python“显式优于隐式”的哲学。
5. 在库开发中绝对禁止
如果你在编写一个库(比如 mylibrary.py),绝对不能碰 from import *。原因很直接:
- 用户没法知道你导入了什么。
- 如果库内部用了
from import *,可能直接把用户自己导入的模块给覆盖掉。
假设库里有这么一行:
# mylibrary.py
from math import *
而用户的代码里已经定义了一个 sqrt 变量,库一加载就会把它覆盖,用户的程序直接就崩了。
用mermaid图表可视化命名冲突
下面用一个流程图来直观展示命名冲突是怎么发生的:
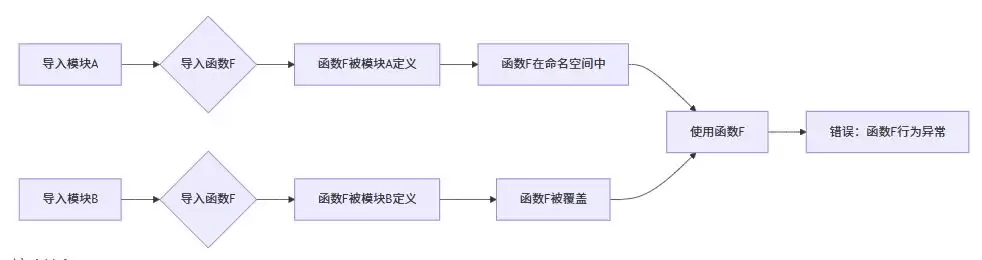
这个流程图展示的是:
- 模块A定义了
F。 - 模块B也定义了
F。 - 后导入的模块B把模块A的
F给覆盖了。 - 代码再调用
F时,行为完全取决于导入顺序,这种bug很难定位。
真实案例:Stack Overflow上有个高票问题,讨论的就是
from math import *和from numpy import *的冲突。回答里提到,很多做数据科学的初学者都在这上面栽过跟头。
替代方案:安全且高效的导入方式
既然 from import * 问题这么多,那该用什么呢?以下是推荐的实践:
1. 显式导入整个模块(import module)
这是最安全、最推荐的做法。保留模块前缀,来源一目了然:
# 推荐方式:导入整个模块
import math
import random
import numpy as np  # 通常用别名

# 使用时明确指定
print(math.sqrt(16))
print(random.randint(1, 10))
print(np.mean([1, 2, 3]))
优点:
- 彻底避免命名冲突。
- 显式展示依赖关系。
- 代码自文档化——一眼就知道功能是从哪来的。
2. 显式导入特定对象(from module import item)
如果你只用到了少数几个对象,可以精确导入:
# 导入特定对象
from math import sqrt, sin
from random import randint

# 使用时无需模块名
print(sqrt(4))
print(randint(1, 10))
优点:
- 保持简洁,但避免了
*的隐患。 - 代码里明确列出了依赖,阅读起来很舒服。
最佳实践:在大型项目中,绝对不要碰 from module import *。
3. 使用别名(as)简化导入
模块名太长的时候,用别名让代码更简洁:
import matplotlib.pyplot as plt
import pandas as pd

# 使用别名
plt.plot([1, 2, 3])
df = pd.DataFrame({'A': [1, 2, 3]})
优点:
- 保持显式的同时,去掉了冗余。
- 跟
*不同,别名是明确的,不会有冲突风险。
何时可以安全使用from import *?(极少数情况)
虽然 import * 有风险,但在某些严格受限的场景下,还是可以用一用的:
1. 仅限于单文件脚本
如果你只有一个独立的、小型的脚本(比如 data_processing.py),而且它不会被其他代码导入,那用 from import * 问题不大。但还是要小心:
# 仅限于小型脚本:data_processing.py
from numpy import *
from pandas import *

# 代码逻辑
data = load_data('file.csv')
result = process(data)
警告:要确认这个脚本不会被其他文件导入(比如通过 if __name__ == '__main__' 来运行)。万一被别的文件 import 了,风险就来了。
2. 在交互式环境(如Jupyter Notebook)
在Jupyter Notebook里,from import * 经常被用来快速做实验,因为:
- 代码是临时性的。
- 通常不会部署到生产环境。
- 可以很快重载模块。
# Jupyter Notebook示例
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

# 无需重复模块名
iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target)
model = RandomForestClassifier()
model.fit(X_train, y_train)
注意:即便在Jupyter里,也建议别在正式生成的代码里保留 import *,免得转成脚本时出问题。
为什么团队协作中必须避免from import *?
在团队环境中,import * 简直就是灾难的引信:
1. 团队成员没法快速理解依赖
看到 sqrt(4) 的时候,你得到处翻代码找出所有的导入语句,才能确定 sqrt 从哪来的。这对新人来说尤其不友好。
2. 无法自动化依赖管理
像 pipreqs 或 requirements.txt 这类工具,都依赖显式导入。用了 import *,工具根本检测不到实际用了哪些模块(因为导入是隐式的)。
3. 测试和重构困难
做测试时,经常需要模拟模块的行为。如果用了 import *,测试的设置会变得很麻烦:
# 问题:无法轻松mock
from math import *

def calculate():
    return sqrt(16)

# 测试时想mock sqrt,但无法知道它来自math
对比显式导入:
import math

def calculate():
    return math.sqrt(16)

# 测试时轻松mock
from unittest.mock import patch
with patch('math.sqrt', return_value=5):
    assert calculate() == 5
实际案例:一个因import *导致的生产事故
让我想起2018年一个数据科学团队踩的坑。他们的代码里用了 from scipy import *,但 scipy 和 numpy 在 linalg 模块里有同名的函数。当他们更新 numpy 版本时,linalg 函数的行为变了,导致模型预测结果全错。因为用了 import *,他们死活找不到问题出在哪:
# 问题代码:data_pipeline.py
from scipy import *
from numpy import *

# 使用linalg
result = eigvals(matrix)  # 依赖scipy的eigvals
错误原因:
scipy.linalg.eigvals和numpy.linalg.eigvals的行为略有不同。- 因为
import *,eigvals被numpy的版本覆盖了(如果numpy先导入的话)。 - 他们更新了
numpy,但根本没意识到这种隐式的依赖冲突。
修复过程:
- 花了几个小时排查。
- 最后重写为显式导入:
from scipy import linalg
from numpy import linalg as np_linalg
- 还加了单元测试来确保兼容性。
教训:在生产环境里,
import *绝对是个高风险操作。
如何检查代码中是否使用了import *?
在大型项目里,检查 import * 的存在很有必要。以下是一些方法:
1. 用正则表达式扫描
在终端里跑:
grep -r "from .* import *" your_project_dir
这会把所有用了 import * 的文件都列出来。
2. 使用代码分析工具
- Flake8:加上
F403规则(禁止import *)。
pip install flake8
flake8 --select=F403 your_script.py
- PyLint:配置
disable=import-star。
3. 在CI/CD中强制检查
可以在GitHub Actions或GitLab CI里加一个步骤:
# .github/workflows/lint.yml
name: Lint
on: [push]
jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Install dependencies
        run: pip install flake8
      - name: Run linter
        run: flake8 --select=F403
最佳实践总结:安全导入指南
以下是Python项目的导入规范(适用于所有场景):
| 场景 | 推荐方式 | 避免方式 |
|---|---|---|
| 小型脚本(独立运行) | import module 或 from module import item | from module import * |
| 库/模块开发 | 必须使用import module或from module import item | 任何import * |
| Jupyter Notebook | 仅限实验,但避免在生成代码中保留 | from module import * |
| 团队协作项目 | 强制显式导入(在代码审查中检查) | import * |
关键原则:显式优于隐式。这是Python哲学的核心,也是
import *被禁止的根本原因。
为什么学习者应该避免import *?
新手常常被 import * 吸引,但这会养成坏习惯。给初学者的建议:
- 从一开始就养成好习惯:用
import math而不是from math import *。 - 理解命名空间:搞清楚Python是怎么管理变量和模块的。
- 利用IDE提示:在VS Code或PyCharm里,输入
math.时IDE会列出可用函数,根本不用靠记忆。
结论:拥抱清晰,远离陷阱
from import * 是Python里一个典型的“甜蜜陷阱”。在小规模场景下看似方便,但随着代码膨胀,它会带来难以调试的错误、降低可读性,还会破坏团队协作。Python的哲学——“显式优于隐式”——在导入语句这里体现得淋漓尽致。
记住:
- ✅ 安全使用:
import module或from module import specific_item - ❌ 避免使用:
from module import *(除非是临时脚本且你能承受风险)
写任何Python代码的时候,都问自己一句:“如果别人看到这段代码,能立刻知道依赖的来源吗?” 如果答案是不,那就赶紧重构导入语句。
避开 import *,不光是为了让代码更健壮,也是在为未来的自己——还有团队成员——省下大把的时间。这不仅仅是语法上的选择,更是专业编程习惯的体现。从今天开始,让每一行导入都变得清晰、明确、安全。
最后一点思考:在Python社区里,import * 经常被调侃为“Python的 goto 语句”——看起来简单,但会毁掉代码质量。与其事后费力修复,不如从一开始就选对路。











正软商城本月促销专区,汇集办公、设计、安全、影音、系统工具及AI软件等正版软件优惠活动,提供限时折扣、特价授权和优惠购买信息,活动库存及价格以页面实时展示为准。

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
