


大数据开发语言选型:Java对比Scala与Python的优缺点及适用场景
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
一、核心选型指标与架构关系
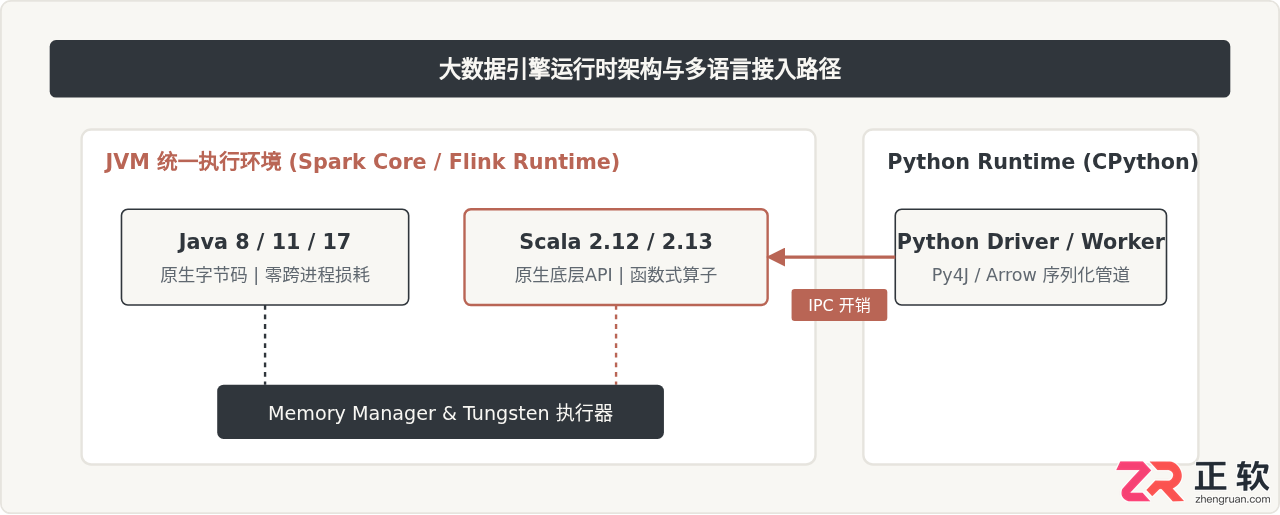
大数据计算引擎大多根植于 JVM 生态(如 Apache Spark、Apache Flink、Trino)。语言选型不仅仅关乎语法偏好,更直接决定了内存序列化开销、进程间通信损耗以及生产故障排查的复杂度。
在选型时,我们需要考察四个核心维度:
- 引擎亲和度与运行时开销:代码是否需要跨 JVM 进程桥接转换?是否存在跨语言序列化惩罚?
- 类型安全与重构成本:面对上百个字段的大宽表或复杂拓扑流作业,静态检查能否在编译期拦截 schema 错误?
- 生态工具链广度:与机器学习库、复杂数据格式解析、遗留企业系统的集成难度。
- 团队工程协作:人才招募门槛与长期工程代码的可读性、可维护性。
二、三种语言的优缺点深度剖析
1. Java:企业级工程基石与高吞吐流计算首选
优点:
- 底层生态完全对齐:Hadoop HDFS、HBase、Kafka 乃至 Flink 均由 Java 编写,排查 OOM、GC 调优或分析 Heap Dump 时无需任何语言转译。
- 极高工业规范度与代码稳定性:静态类型强约束与庞大的成熟工程框架,使得数十人规模的团队在维护复杂业务逻辑时极少出现意外的低级动态类型错误。
- 跨平台无兼容断层:没有 Scala 版本间字节码不兼容(Binary Incompatibility)的问题,依赖树冲突易于排查和统一。
缺点:
- 表达较为冗长:尽管 Java 8 引入了 Lambda 表达式,但在表达链式转换、高阶算子嵌套以及复杂模式匹配时,代码行数远多于 Scala 与 Python。
- 交互式探索能力弱:缺乏原生的 REPL 和交互式数据挖掘环境,构建临时分析任务较为繁琐。
2. Scala:原生计算引擎亲和度最高的高性能语言
优点:
- Spark 原生母语支持:作为 Apache Spark 的开发语言,所有新特性、底层优化与内部 API 均第一时间在 Scala 提供,编译级检查全面。
- 强大的表达力:结合了面向对象与函数式编程,Case Class、Pattern Matching 和简洁的集合操作可以在几行内清晰表达复杂数据处理管道。
- 零桥接运行开销:编译直接生成标准 JVM 字节码,执行期直接调用引擎内部数据结构,无跨进程跨语言序列化损耗。
缺点:
- 学习曲线极其陡峭:隐式转换(Implicits)、高阶类型系统容易被滥用,导致工程代码极难被新手阅读与接手。
- 二进制兼容性脆弱:Scala 主版本(如 2.11、2.12、2.13)之间编译产物不兼容,升级 Spark 版本或集成第三方库常面临严峻的依赖冲突(Jar Hell)。
3. Python:数据探索与 AI/ML 统一管线的绝对核心
优点:
- 极高的数据科学敏捷度:语法直观,搭配 Jupyter Notebook 能快速对海量数据进行取样、试错和可视化,开发周期短。
- 连接大数据与现代 AI:在特征工程产出后,可直接对接 PyTorch、TensorFlow、Scikit-learn,不需要在两套技术栈之间切分工程。
- DataFrame API 下执行性能接近 JVM:基于 Catalyst 优化器与 Arrow 内存格式,标准 SQL/DataFrame 操作由 JVM 执行底层计划,几乎无性能代差。
缺点:
- UDF 跨进程损耗显著:当逻辑无法用内置算子实现而必须编写 Python 原生 UDF 时,每行数据需要在 JVM 与 Python Worker 之间序列化来回拷贝,吞吐往往下跌数倍。
- 缺乏编译期类型校验:拼写错误、类型推导错误多在运行期乃至长周期任务运行几小时后才暴发,维护大规模纯管道项目风险较高。
三、核心维度横向比对
| 评测维度 | Java | Scala | Python (PySpark / PyFlink) |
|---|---|---|---|
| 纯计算性能 (无 UDF) | 极高 (JVM 原生执行) | 极高 (JVM 原生执行) | 高 (基于 Catalyst 优化与原生算子) |
| 自定义逻辑 (UDF) 性能 | 极高 (同进程内存共享) | 极高 (同进程函数引用) | 中/低 (依赖 Arrow 批量管道,原生较慢) |
| 流计算支持 (Flink) | 最优 (官方第一公民,API 最健全) | 良好 (历史版本常用,现略退居二线) | 基本可用 (PyFlink 功能与性能有局限) |
| 开发与迭代效率 | 中等 (样板代码较多) | 较高 (表达精练,需规避过度设计) | 极高 (快速原型与交互式调试) |
| 工程重构与代码审查 | 极容易 (工具链成熟,语义清晰) | 中等 (高级语法特性加大审查难度) | 困难 (重构大型项目需完善测试兜底) |
| 团队招聘与人才供给 | 极宽广 (后端研发易平滑切入) | 较狭窄 (人才集中在资深大数据圈) | 极宽广 (算法、数据分析师与全栈) |
四、实际代码对比:词频统计与异常处理
为了具体感受语法差异与静态/动态类型的边界,以下通过 Spark 经典统计逻辑在三种语言中的实现进行对照。
1. Scala 实现(核心逻辑)
import org.apache.spark.sql.SparkSession

object WordCountScala {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder().appName("WordCount").getOrCreate()
    import spark.implicits._

    // 强类型 Dataset 结合模式匹配
    val result = spark.read.textFile("hdfs:///data/logs.txt")
      .flatMap(_.split("\\s+"))
      .filter(_.nonEmpty)
      .groupByKey(identity)
      .count()

    result.write.mode("overwrite").parquet("hdfs:///output/scala_wc")
    spark.stop()
  }
}
实现解析:Scala 借助 spark.implicits._ 自动推导出强类型编码器(Encoder),代码极为紧凑,编译器能够在编译期拦截算子内部字段类型的错误。
2. Java 8+ 实现(核心逻辑)
import org.apache.spark.api.java.function.FilterFunction;
import org.apache.spark.api.java.function.FlatMapFunction;
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Encoders;
import org.apache.spark.sql.SparkSession;
import java.util.Arrays;

public class WordCountJava {
    public static void main(String[] args) {
        SparkSession spark = SparkSession.builder().appName("WordCount").getOrCreate();

        Dataset lines = spark.read().textFile("hdfs:///data/logs.txt");
        Dataset words = lines.flatMap(
            (FlatMapFunction) line -> Arrays.asList(line.split("\\s+")).iterator(),
            Encoders.STRING()
        ).filter((FilterFunction) word -> !word.isEmpty());

        Dataset counts = words.groupBy("value").count();
        counts.write().mode("overwrite").parquet("hdfs:///output/java_wc");
        spark.stop();
    }
} 实现解析:Java 代码对函数接口(Functional Interface)和序列化编码器(Encoders)必须明确显式传入。尽管视觉上稍显冗长,但类型传递链条极为清晰,对于 IDE 检索和团队协作排查没有任何认知歧义。
3. Python 实现(核心逻辑)
from pyspark.sql import SparkSession
from pyspark.sql.functions import split, explode, col

def run_word_count():
    spark = SparkSession.builder.appName("WordCount").getOrCreate()

    # 基于 DataFrame 高阶算子,避免跨语言 Python Worker 开销
    df = spark.read.text("hdfs:///data/logs.txt")
    words_df = df.select(explode(split(col("value"), r"\s+")).alias("word"))
    filtered_df = words_df.filter(col("word") != "")
    result = filtered_df.groupBy("word").count()

    result.write.mode("overwrite").parquet("hdfs:///output/python_wc")
    spark.stop()

if __name__ == "__main__":
    run_word_count()
实现解析:Python 应当优先采用 explode 与 split 这类 Catalyst 内置算子,数据全部留在 JVM 堆外内存处理;一旦改用 df.rdd.flatMap(lambda line: line.split()),性能将因 IPC 损耗骤降 60% 以上。
map/lambda,否则将触发每秒数十万次跨进程序列化,成为整个计算链路的致命吞吐瓶颈。
五、落地选型决策路径
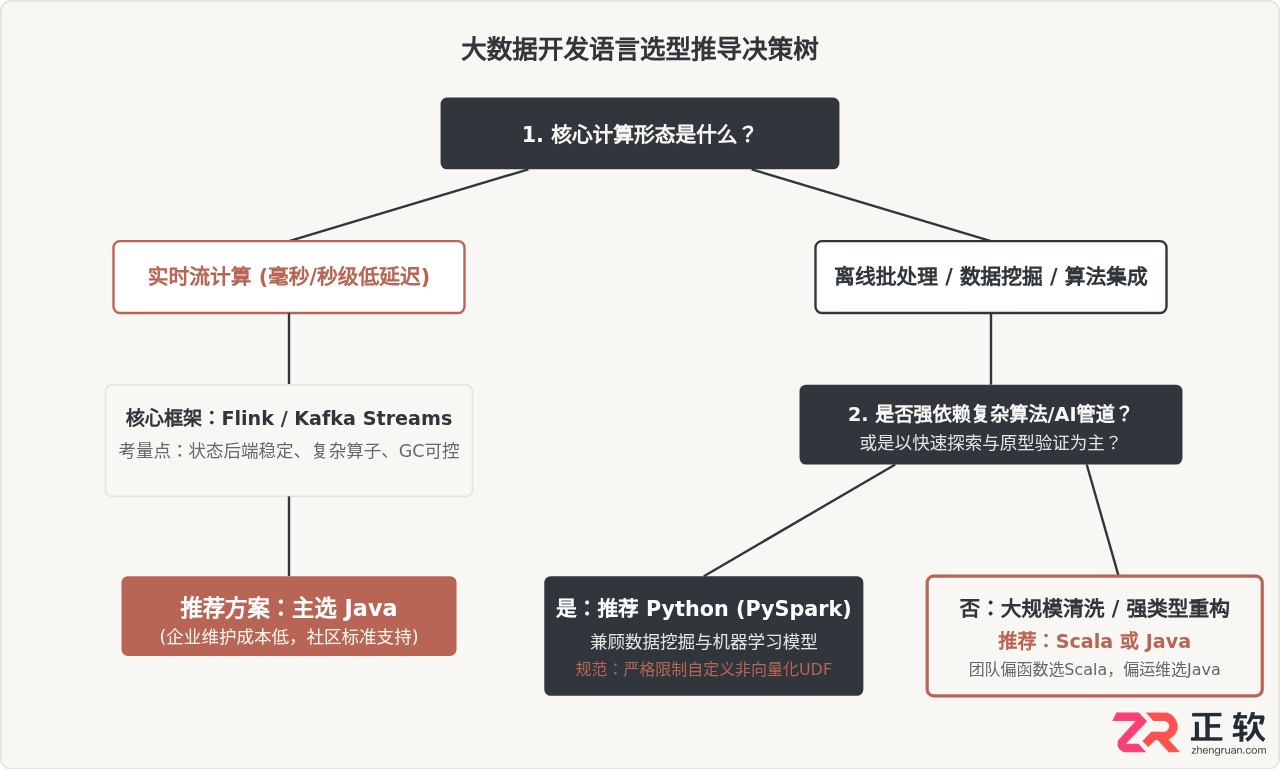
面对具体项目时,盲目追求单一语言往往导致效率灾难。实际决策应结合计算模式(批还是流)、业务复杂度以及下游消费链路分步推导。
六、生产环境典型场景落地建议
场景一:Apache Flink 驱动的实时数仓与规则引擎
结论:毫不犹豫选用 Java。
在毫秒级风控、实时双流 Join、CEP(复杂事件处理)等场景中,系统的绝对瓶颈往往不在于磁盘与网络 I/O,而在于 JVM 堆内存与 StateBackend(如 RocksDB)的交互。
- 早期 Flink 对 Scala 支持较多,但随着版本迭代,Flink 官方逐步淡化 Scala API(如 Flink 1.15+ 逐渐剥离 Scala Shell,主推 Java 接口),Java 成为唯一在所有版本中获得完全支持的语言。
- Java 的内存布局直观,团队在设置
Managed Memory比例、排查堆外内存泄露时,堆栈信息与官方文档完全对齐,避免跨语言框架引起的调用栈混淆。
场景二:基于 Apache Spark 的大规模离线数据湖 ETL
结论:推荐使用 Scala 或统一为 Spark SQL。
离线批量清洗任务往往涉及海量数据的 GroupBy、Window、Join 操作。
- 在此类场景中,代码主要由表达转换意图的 DSL 构成。Scala 简洁的语法使代码行数缩减 40% 以上,且能够在构建复杂 Case Class 时提供极强的类型推导保障。
- 若团队内部缺乏 Scala 基础,优先选择 Spark SQL + Java 封装通用框架,严禁未经培训直接在生产代码中大量编写过度抽象的 Scala 隐式转换。
场景三:特征工程、探索性分析与 AI 算法串联
结论:首选 Python (PySpark)。
数据开发如果最终是为算法模型提供服务,技术栈的分裂会带来极大的沟通成本。
- 如果上游数仓团队使用 Java 产出 Parquet,算法工程师使用 Python 重写逻辑,会导致逻辑维护两套代码(即“双重实现”问题)。
- 直接使用 PySpark 统一特征工程清洗阶段,利用
pyspark.pandas或向量化 UDF(Pandas UDF,底层由 Apache Arrow 驱动),可以在保证合理吞吐的前提下打通整个端到端流程。
七、总结与团队演进策略
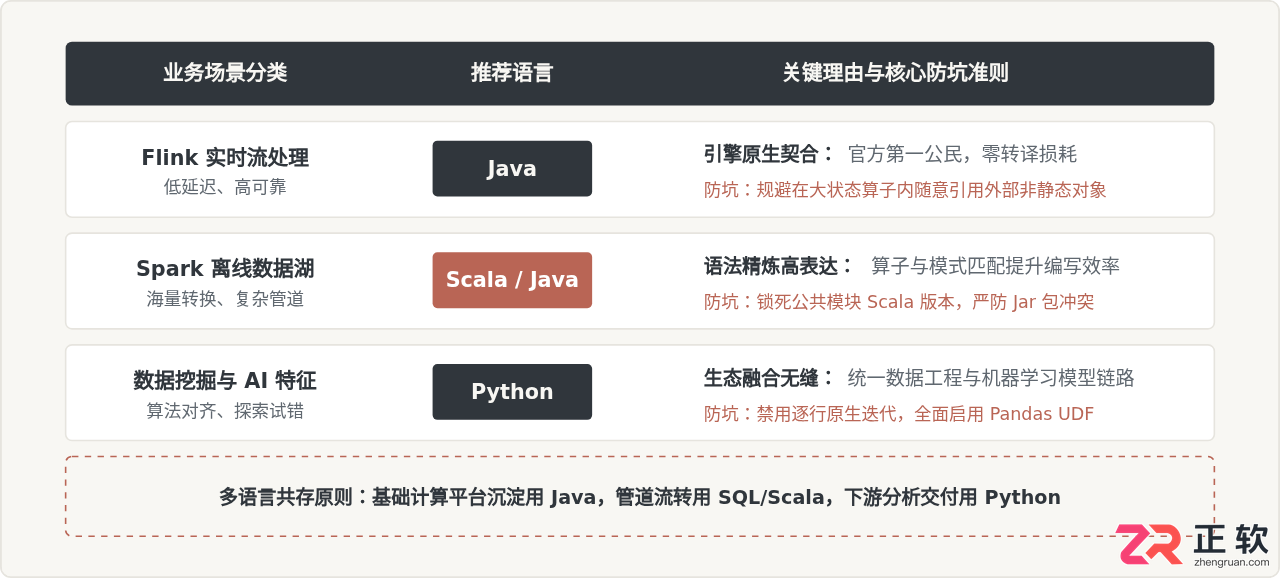
大数据语言选型不应是一锤子买卖,现代企业架构通常呈现“分层混合”的健康形态:
- 底层平台与接入层:日志采集、CDC、Kafka 接入及 Flink 实时核心规则链路采用 Java 构建,确保长周期运行下 GC 可预测、平台工具链可维护。
- 数仓中间层与批处理:以 Spark SQL 为主,辅以 Scala/Java 编写通用的复杂算子或数据脱敏插件,兼顾执行吞吐与工程规范。
- 分析探索与应用层:面向算法模型、指标临时拉取与可视化,全面放开 Python 接入,利用 Arrow 与向量化执行器规避性能短板,最大化发挥数据科学的探索效率。




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,