


Java变量未初始化报错解析:局部变量与成员变量默认值差异
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
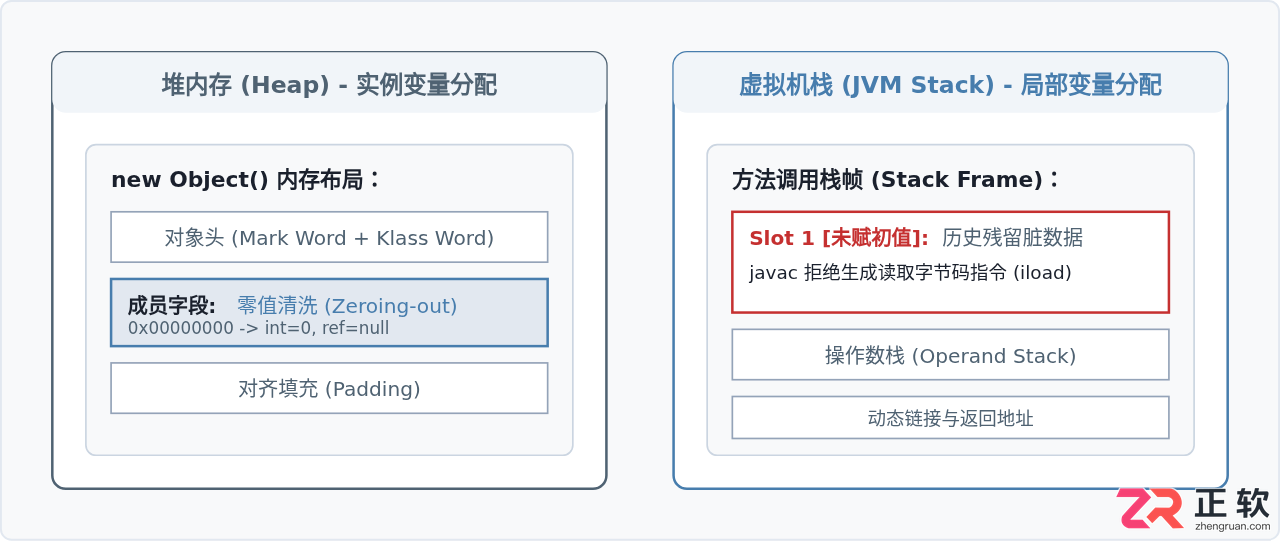
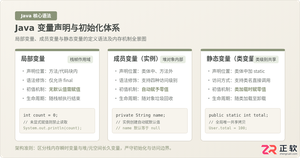
编写 Java 程序时,尝试读取一个没有赋值的局部变量,编译器会立即抛出 java: variable x might not have been initialized(变量可能尚未初始化)的错误;但如果你读取一个没有赋值的成员变量,程序不仅能正常编译,还会读出一个预设的零值或 null。这一差异的核心原因在于:成员变量存放在堆内存中,对象创建时由 JVM 统一执行零值填充;而局部变量直接在栈帧上分配,出于执行性能与消除内存脏数据的安全考量,JVM 不会自动为其赋初值,并通过编译器强制推行“确定性赋值分析”。
报错现场:编译器何时拦截局部变量
为了清晰对比二者的语法表现,我们可以看下面这段在同一个类中声明成员变量与局部变量的代码:
public class VariableDemo {
    // 成员变量(实例变量),位于对象内部
    private int memberCount;

    public void execute() {
        // 正常执行:打印 0,成员变量具备系统默认值
        System.out.println("成员变量: " + memberCount);

        // 声明局部变量,但未赋值
        int localCount;

        // 编译报错:java: variable localCount might not have been initialized
        System.out.println("局部变量: " + localCount);
    }
}
在这个例子中,仅仅声明 int localCount; 本身并不会引发任何错误。Java 允许定义暂不赋值的局部变量,但一旦代码的控制流尝试读取该变量的值,编译阶段的语法分析树就会被触发并直接报错。
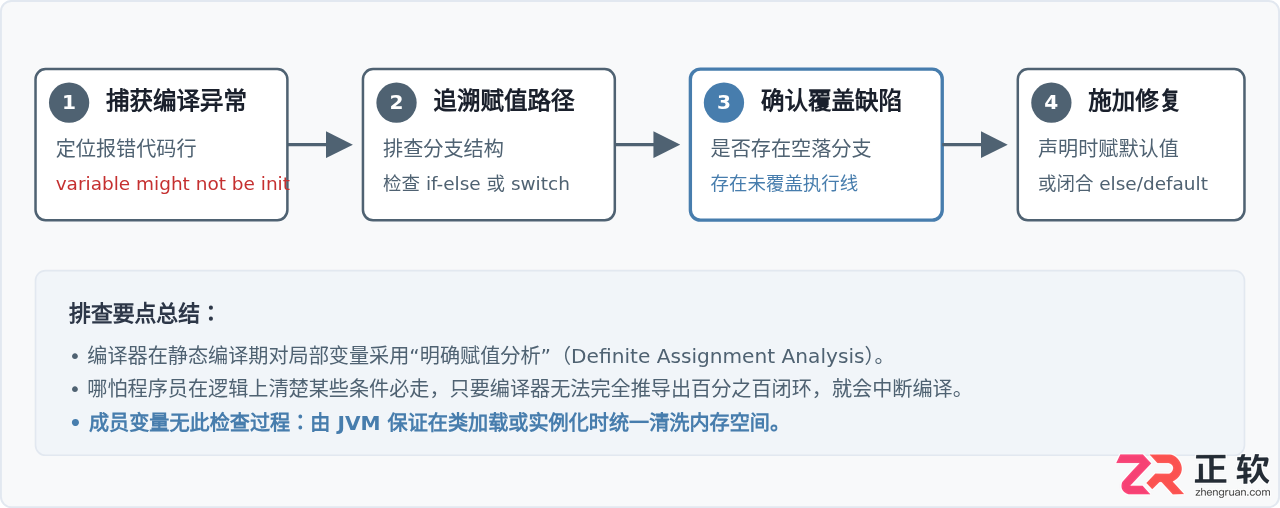
不同类型变量的系统默认值规则
成员变量(包括由 static 修饰的类变量和未由 static 修饰的实例变量)拥有一致的默认值体系。在没有任何显式赋值时,JVM 会按照其数据类型的二进制宽度写入对应的全零表示:
| 数据类型 | 成员变量系统默认值 | 局部变量默认值 | 未初始化直接读取的结果 |
|---|---|---|---|
byte / short / int |
0 |
无 | 编译期报错(Variable not initialized) |
long |
0L |
无 | 编译期报错(Variable not initialized) |
float / double |
0.0f / 0.0d |
无 | 编译期报错(Variable not initialized) |
char |
'\u0000'(空字符) |
无 | 编译期报错(Variable not initialized) |
boolean |
false |
无 | 编译期报错(Variable not initialized) |
引用类型(如 String, 数组, 自定义对象) |
null |
无 | 编译期报错(Variable not initialized) |
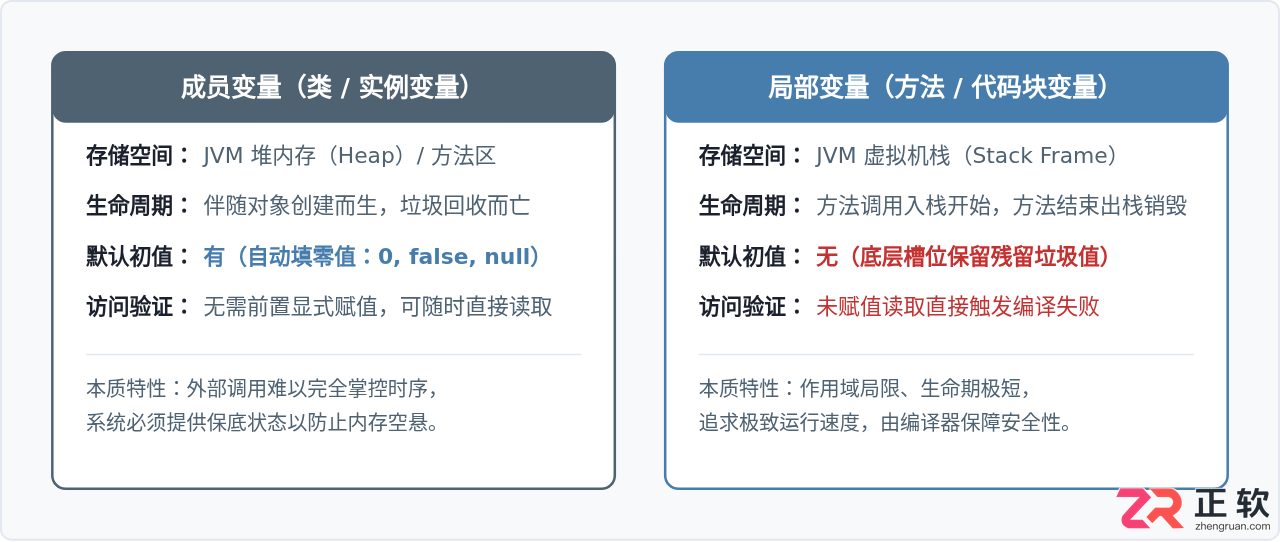
深层原理:为什么 Java 不为局部变量提供默认值?
很多初学者会有疑问:既然 JVM 能够给成员变量刷入零值,为什么不顺便在方法入栈时也给所有局部变量赋上默认值,从而省去编译报错?这一设计抉择背后包含三个层面的考量:
1. 栈帧执行效率的极致追求
Java 方法的调用与返回是高频操作。局部变量保存在虚拟机栈的局部变量表(Local Variable Table)中,每个变量占用一个或两个 Slot(槽位)。如果每次方法调用入栈,JVM 都要把这块内存区域逐个重置写入 0,在高并发、深层方法递归调用的场景下,将带来极大的 CPU 内存擦写开销。直接复用栈帧内存,把初始化的控制权交给业务逻辑,执行效率最高。
2. 语法安全与逻辑漏洞预防
局部变量几乎全部用于承载具体的计算逻辑。如果系统隐式将其初始化为 0 或 false,当开发者因为疏忽漏写了初始化语句时,程序将带着一个毫无业务含义的 0 静默运行,导致计算偏差或死循环,这种运行时逻辑 Bug 往往极难排查。编译器通过强制要求显式赋值,在构建阶段就把逻辑漏洞完全扼杀。
3. 成员变量与局部变量的外部可知性差异
成员变量属于对象状态,由外部调用方通过方法或字段进行访问。编译器无法在编译期预测对象的方法何时被调用、以何种顺序被调用。如果不设默认初始值,在构造方法执行期间或者外部提早读取时,就会直接读出底层随机内存数据。因此,JVM 必须在堆内存分配完成时,由底层统一将分配给对象的内存空间全部清零。
容易踩坑的场景:条件分支下的“确定性赋值”
Java 语言规范中定义了一套严格的确定性赋值(Definite Assignment)规则。在方法内部,如果存在条件分支,编译器会评估到达变量读取点之前的所有可能代码分支。只要存在任意一条分支可能导致变量未经赋值就被读取,就会判为编译错误。
看下面这个实际开发中非常典型的错误示例:
public String getUserRole(int level) {
    String role;

    if (level == 1) {
        role = "Admin";
    } else if (level == 2) {
        role = "User";
    }

    // 编译错误:variable role might not have been initialized
    // 原因是当 level 等于 3 时,role 完全未被赋值
    return role;
}level 只能是 1 或 2,但由于编译器在静态语法分析时不运行程序逻辑,它只关注控制流图的语法闭合性。只要没有兜底的 else 分支,编译器就判定赋值是不确定的。
修正这一问题有两种标准做法:
方法一:显式兜底分支
public String getUserRole(int level) {
    String role;
    if (level == 1) {
        role = "Admin";
    } else if (level == 2) {
        role = "User";
    } else {
        role = "Guest"; // 闭合全部可能性
    }
    return role;
}
方法二:声明时赋予初值(或默认安全值)
public String getUserRole(int level) {
    String role = "Guest"; // 声明时立即初始化
    if (level == 1) {
        role = "Admin";
    } else if (level == 2) {
        role = "User";
    }
    return role;
}
最佳实践与决策指南
为了避免变量初始化引发的编译期错误以及隐蔽的逻辑缺陷,日常编码中可遵循以下决策逻辑:
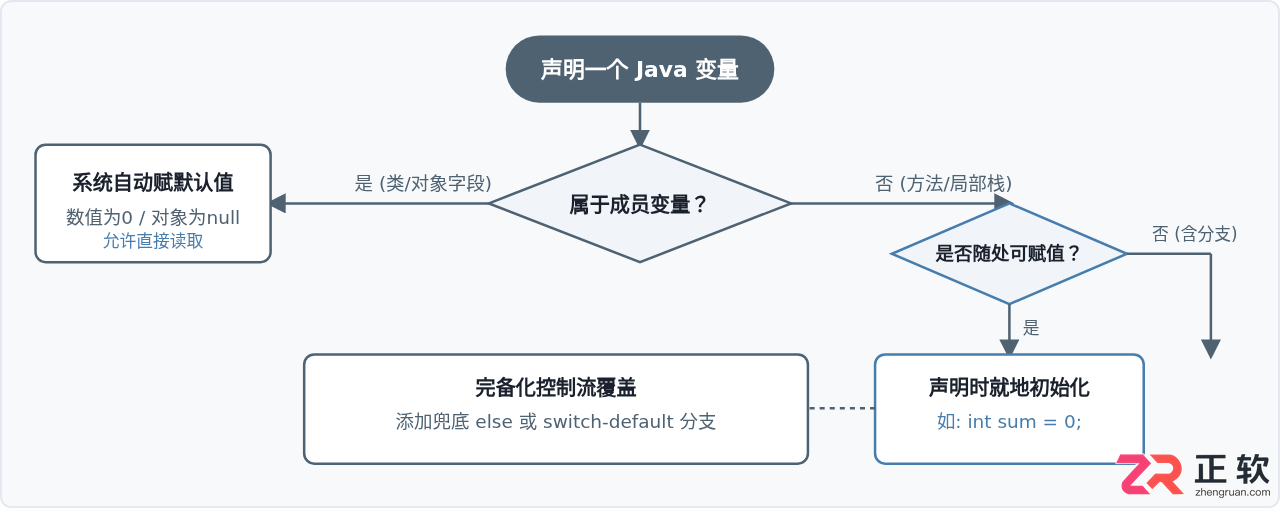
总结来说,遇到 might not have been initialized 报错时,并不意味着代码逻辑有致命缺陷,而是编译器无法在编译期绝对保证变量赋值的闭环。对于局部变量,优先在声明时赋予明确初始值,或在所有逻辑分支中补齐兜底分支;对于成员变量,则要结合业务需求评估系统默认的零值是否合理,必要时在构造方法中进行覆盖。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

Beamer 4是面向macOS的本地视频投屏工具,可将Mac中的影片投放到Apple TV、Chromecast及兼容设备,支持常见格式、多类字幕、环绕声、播放列表和电视遥控操作。
Boom 3D macOS版是一款系统级音效增强工具,可为音乐、电影、游戏和流媒体提供3D虚拟环绕声、31段均衡器、音量增强及应用独立音量控制,并支持本地播放器与多种音频输出设备。
Boris FX macOS版是一套面向剪辑、合成、调色及动态图形工作的专业后期工具,涵盖视觉特效、平面与三维跟踪、转描、画面修复、粒子动画和音频清理,可配合多种主流宿主软件使用。
Capto 是面向 macOS 的屏幕截图、高清录屏与媒体编辑工具,支持区域及整屏捕获、网页长截图、双音轨处理、图片和视频标注、素材分类与多渠道分享,适合教师、学生、内容创作者及需要制作演示教程的用户。
Cursor Crane 是一款仅面向 macOS 的键盘操控效率工具,可通过提示标签、网格、文字查找和窗口模式完成点击、滚动、定位与切换,并支持屏幕内容提取、脚本及工作流扩展。
Deep Freeze 冰点还原 macOS版通过冻结系统配置,让受保护的Mac在重新启动后回到预设状态,并提供解冻空间、维护计划、密码保护及Apple Remote Desktop管理能力。
Focusky macOS版是一款面向教学课件、商务汇报、产品展示和动画宣传内容的演示制作工具。它通过无限画布、路径编排、缩放旋转转场及多媒体编辑,将传统逐页幻灯片转化为更具空间感的动态演示。
Folder Colorizer 2 macOS版是一款直观的文件夹外观定制工具,可更换颜色,添加表情、贴纸及图片背景,并支持批量处理、智能推荐和恢复默认样式,帮助用户更快辨认工作、学习与生活资料。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。
AnyDesk Windows版是一款轻量化远程桌面与技术支持工具,可用于控制异地电脑、传输文件、远程打印及无人值守访问。它兼顾连接响应、安全权限和部署灵活性,适合个人远程办公、企业设备维护与客服支持。
Boom 3D Windows版是一款面向音乐、电影和游戏场景的系统级音效增强工具,支持虚拟3D环绕声、31段均衡器、预设音效、应用音量控制及本地音乐播放,可配合耳机、扬声器和蓝牙耳机使用。
Boris FX Windows版是一套服务于影视剪辑、视觉特效、运动跟踪、转描、图像修饰及音频修复的专业创作工具集合,可作为插件接入多种主流后期宿主,也包含可独立运行的应用,适合剪辑师、特效师与内容创作者使用。
ChemDraw Windows版是一款面向化学研究、药物研发、材料科学和教学工作的专业结构绘图工具,可快速绘制分子、反应式及生物聚合物,并提供结构整理、格式转换、性质计算和科研文档协作能力。
CODESOFT Windows版是一套企业级条码与RFID标签设计打印工具,可连接Excel、Access、SQL及云端数据源,支持变量、表单、GS1条码、数据库记录和多种工业打印机,适合制造、仓储、物流及合规标识场景。
Deep Freeze 冰点还原 Windows版通过重启恢复技术保护系统盘及指定分区,自动撤销恶意程序、误操作和配置漂移造成的改动,并支持密码保护、解冻空间与多硬盘管理,适合学校机房、公共电脑、办公终端及家庭电脑使用。
EDIUS 11 Windows版是一款面向影视制作、广播电视、纪录片、短视频及教育机构的专业非线性编辑工具,支持4K/8K、多格式混编、HDR调色、字幕、音频处理和后台渲染,并提供素材管理及丰富的导出预设。
FastStone Capture Windows版是一款轻量级屏幕捕捉、录屏与图像编辑工具,可截取窗口、区域、菜单和滚动页面,并提供标注、模糊、取色、OCR、录音录像及多格式导出能力,适合办公说明、教程制作和问题反馈。
Focusky Windows版是一款动画演示与交互课件制作工具,通过无限画布、缩放旋转镜头、模板素材和对象动画组织内容,可导入PPTX,并输出视频、EXE、PDF、网页等格式,适用于课堂教学、微课、商务汇报及产品展示。