


Python与C语言的性能差异及底层原理
深入解析Python与C语言在执行效率上的数量级差异,从编译机制、变量内存布局、动态类型推断到GIL锁,系统阐明底层核心原理。
在纯计算密集型任务中,纯 Python 代码与优化后的 C 语言程序通常存在 10 到 100 倍以上的执行时间差异。这种性能代沟并非简单的“编译与解释”表象,而是由执行执行模型、内存布局抽象、动态类型装箱机制以及并发运行时约束共同决定的底层必然结果。
基准测试:一个具体累加循环的性能表现
为了直观观察两者的性能差异,我们通过一个固定的千万次累加循环进行基准对照。在这个任务中,CPU 主要执行整数加法与计数器跳转,不涉及外部 I/O 阻滞。
C 语言测试代码(test.c):
#include
#include

int main() {
    clock_t start = clock();
    long long sum = 0;
    for (long long i = 0; i < 100000000LL; i++) {
        sum += i;
    }
    clock_t end = clock();
    double cpu_time_used = ((double) (end - start)) / CLOCKS_PER_SEC;
    printf("Sum: %lld, Elapsed Time: %f s\n", sum, cpu_time_used);
    return 0;
}
Python 测试代码(test.py):
import time

start = time.perf_counter()
total = 0
for i in range(100_000_000):
    total += i
end = time.perf_counter()

print(f"Sum: {total}, Elapsed Time: {end - start:.4f} s")
测试环境与执行输出对照(示例配置:x86_64, GCC 11.4 / Python 3.11):
# C语言编译优化后执行
$ gcc -O2 test.c -o test_c
$ ./test_c
Sum: 4999999950000000, Elapsed Time: 0.0452 s

# Python执行
$ python3 test.py
Sum: 4999999950000000, Elapsed Time: 4.8912 s
在关闭编译优化的基础场景下,C 语言耗时约为 0.2 秒;开启 -O2 级别寄存器分配与循环优化后降至 0.045 秒左右。而标准解释器 CPython 耗时接近 4.9 秒。两者的执行时间相差了约 108 倍。理解这百倍差距的来源,需要逐层剖析底层执行流程。
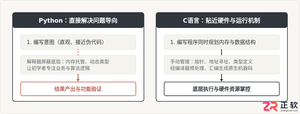
执行模型的本质不同:机器指令与虚拟机解释循环
C 语言属于编译型静态语言。源码在执行前,经由前端语法分析、中间表示优化,最终直接生成目标机器平台的原生汇编指令并链接为二进制 ELF 或 PE 文件。CPU 的指令寄存器(PC)直接装载并以流水线方式执行这些机器码。
标准 Python(CPython)则是虚拟机架构。.py 源码首先被编译为平台无关的 Python 字节码(Bytecode)。在程序运行时,核心实际上是一个庞大的巨大循环函数——_PyEval_EvalFrameDefault。这个循环不断读取下一条字节码,通过 switch-case 分发至具体的 C 语言评估逻辑。
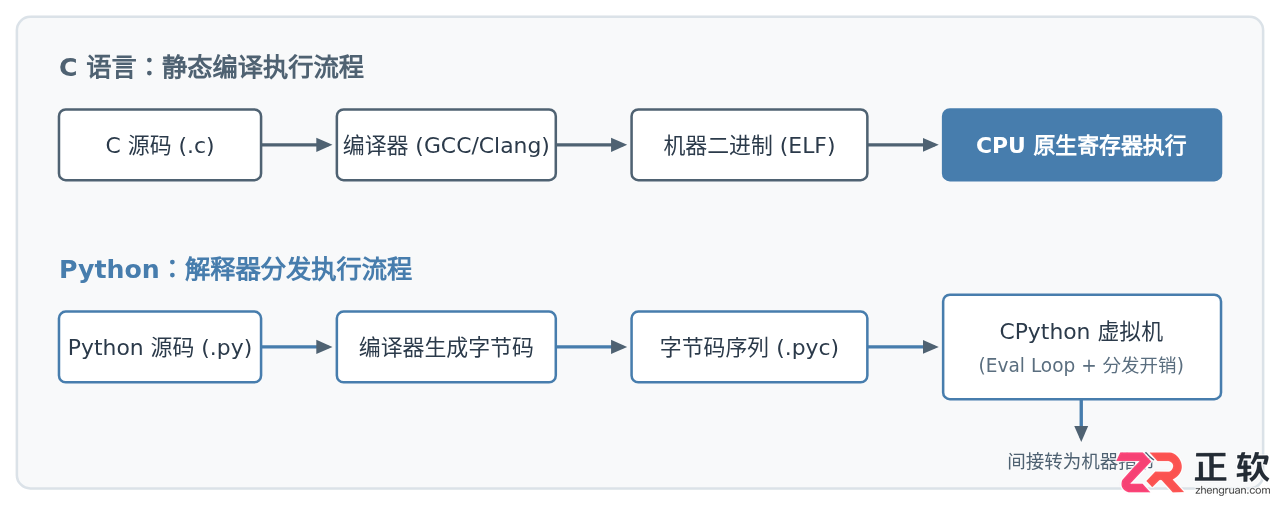
在 C 语言中,累加一行 sum += i 被编译器翻译为单条汇编指令:
addq %rax, %rbx现代 CPU 完成这条寄存器指令仅需 1 个时钟周期甚至由乱序执行引擎并行吞吐。但在 Python 中,完成一次 total += i 需要执行字节码 INPLACE_ADD。虚拟机必须经历以下步骤:
- 从评估栈栈顶弹出操作数引用;
- 解析目标对象的结构体头,检查对象的实际数据类型;
- 确认是否有重载的加法槽函数(如
nb_inplace_add或nb_add); - 动态开辟或调整内存,写入计算结果并更新栈指针;
- 维护引用计数,检查是否需要触发释放。
一个简单的算术操作在 Python 中变成了几十次内存读写与分支跳转,解释器本身的开销远超过实际的计算逻辑。
内存布局与数据封装:裸指针与 PyObject 结构体
在底层数据表达上,两者的内存 footprint(足迹)完全不在一个数量级。
C 语言中的数值是连续紧凑存放的。一个 64 位整数 long long 严格占用 8 字节连续内存,无需任何额外包装。如果你分配一个含 1000 个整数的数组,它在内存中就是一段严格占用 8000 字节的连续物理/虚拟空间,对 CPU 的 L1/L2 缓存预取机制极度友好。
而在 Python 中,“万物皆对象”。一个看似基础的整数 1 也是一个堆上分配的 PyLongObject。在 64 位机器下,该结构体至少包含以下部分:
ob_refcnt(8 字节):引用计数器;ob_type(8 字节):指向类型对象&PyLong_Type的元数据指针;ob_size(8 字节):记录变长数据的尺寸与正负号;ob_digit[1](至少 4 字节):实际存储数值的动态数组(Python 整数支持无限精度)。
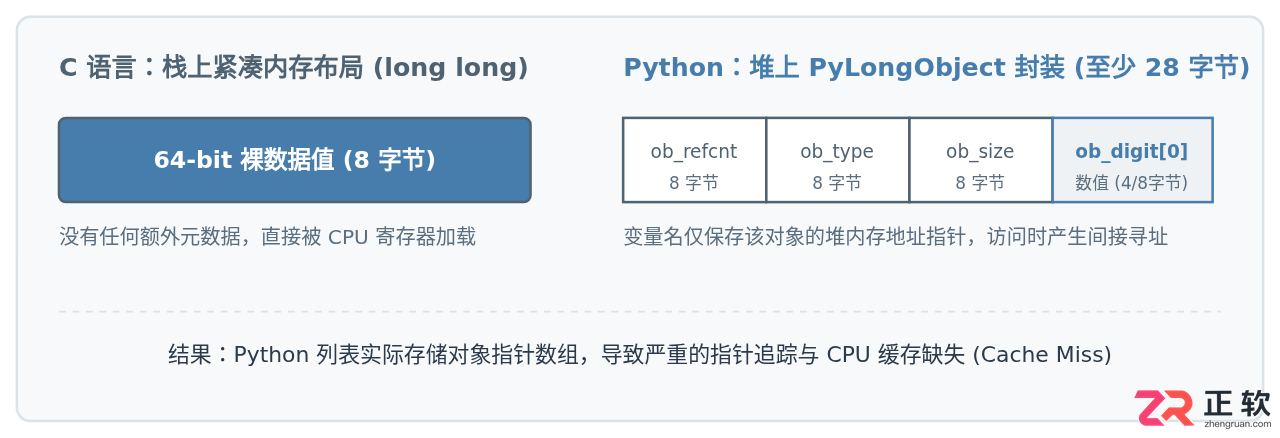
即使只是一个普通的 int,Python 也至少需要分配 28 字节空间。当遍历一个 Python 列表时,列表内部数组连续存放的实际上是一串 PyObject* 堆内存指针。CPU 在读取真正的数据时,不得不跨越指针去追踪堆中的离散内存块,导致 CPU 缓存预取命中率大幅下跌。
动态类型检查与运行时方法分发
静态类型与动态类型的性能分野同样发生在每一次基本操作中。在 C 语言中,编译期已经确定了类型契约:
int a = 5;
int b = 10;
int c = a + b; // 编译器确认两操作数均为 32位 signed int,直接生成 add 指令
在 Python 中,所有操作均采用“后期绑定”与动态查找:
def add(a, b):
    return a + b
因为 Python 不对 a 和 b 的类型做前置约束,解释器在执行加法时,无法预判两者的真实形态——它们可能是两个整数、浮点数、字符串、列表,或者自定义了 __add__ 魔法方法的类实例。
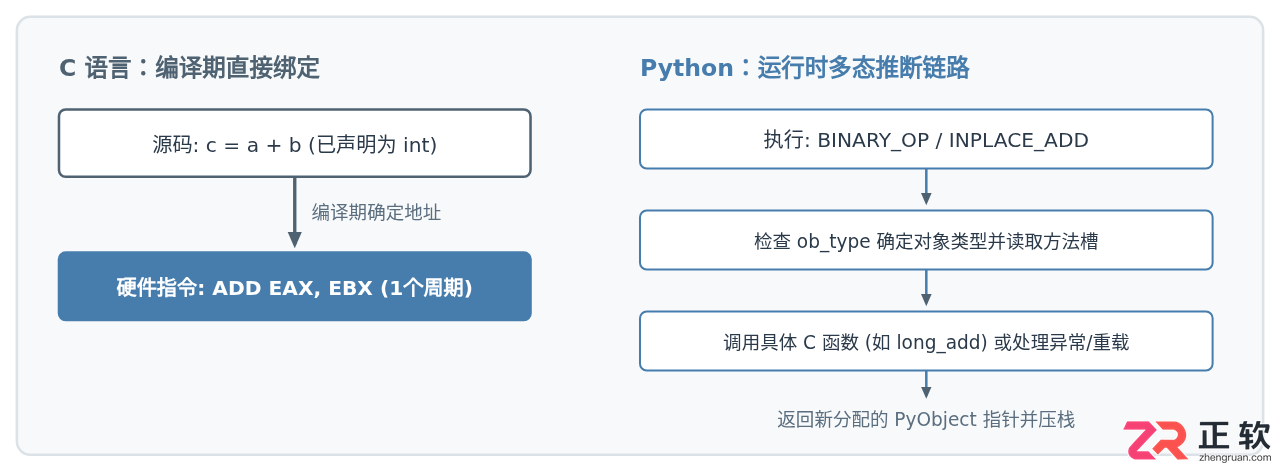
动态机制带来了代码书写上的灵活性,但这种灵活性在微观层面是以不断查询虚表、判断类型标签为代价换来的。
多线程与并发限制:GIL(全局解释器锁)
在涉及多核 CPU 的计算密集型场景中,Python 存在另一个著名的性能制约点:全局解释器锁(Global Interpreter Lock,简称 GIL)。
CPython 解释器的内存管理依赖于引用计数机制。如果有多个系统原生线程同时对同一个对象进行操作,引用计数的增减可能会发生竞态条件(Race Condition),进而引发内存泄漏或悬挂指针。为了保证绝对的线程安全与历史 C 扩展模块的简单兼容性,CPython 在解释器级别引入了 GIL:在任意给定时钟瞬间,同一解释器进程内只能有一个线程处于 Python 字节码执行状态。
相比之下,C 语言的多线程使用底层 POSIX 线程(pthread)或 Windows 原生线程接口,每个线程均由内核独立调度,能够完全占满多核硬件资源,各线程通过互斥锁(Mutex)、原子变量(Atomic Operations)自行管理并发同步,不会存在整进程级别的执行瓶颈。
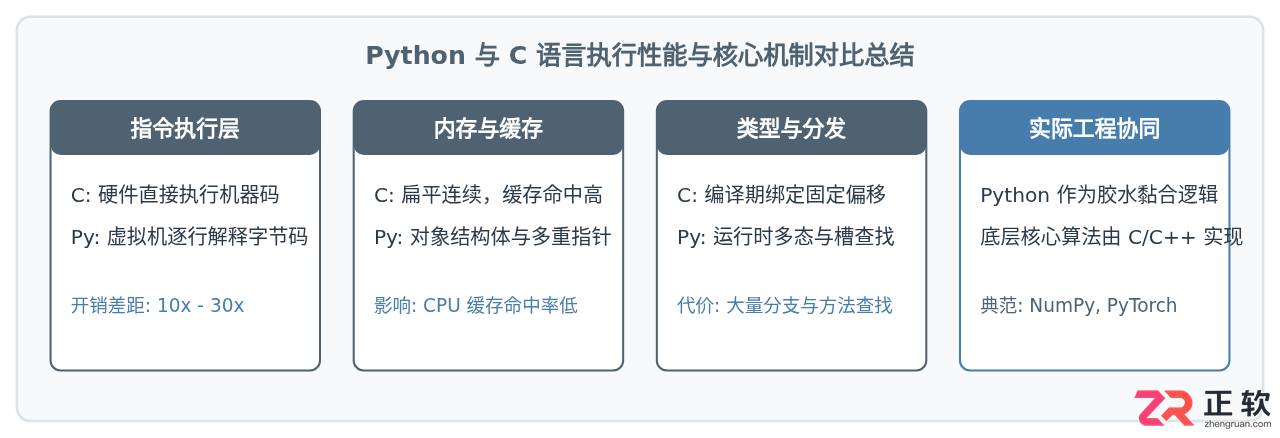
核心机制全景总结
综合以上各技术维度的差异,我们可以将 Python 与 C 语言性能分化的核心根源归纳如下:
| 对比维度 | C 语言 | Python (CPython) |
|---|---|---|
| 代码形态 | 直接编译为平台原生二进制机器码 | 先转为抽象字节码,由解释器分发 |
| 类型绑定 | 静态编译期绑定,无运行时判定 | 完全动态类型,运行时逐次查表分发 |
| 数值存储 | 紧凑原生数据类型(如 8 字节 long) | 堆上 PyObject 封装(含引用计数、类型指针等) |
| 内存管理 | 栈上手动/自动展开,完全由程序员掌控 | 引用计数 + 分代垃圾回收(GC),存在追踪开销 |
| 多核并行 | 无全局锁,原生线程可直接跑满所有物理核心 | 受限于 GIL,计算密集型线程无法并行利用多核 |
| 编译器优化 | GCC/Clang 支持向量化(SIMD)、循环展开 | 解释器层面优化空间受限,动态性阻碍了内联 |
工程视角的实践权衡
理解这两种语言的底层差异,最终目的是指导工程选型与性能调优:
- 不要使用纯 Python 循环处理重型数值运算:例如批量矩阵计算、图像滤波等。应利用基于 C/C++ 或 Fortran 实现的高性能数值库(如 NumPy、SciPy),让计算任务脱离 Python 虚拟机进入底层连续内存块。
- 利用扩展工具突破边界:在性能瓶颈段落,可以通过 Cython、CFFI 或 C/C++ 动态链接库(.so / .dll)承接核心耗时逻辑,由上层 Python 负责胶水逻辑,兼顾开发效率与硬件吞吐。
- 多核并行转用多进程:在 CPU 密集型任务中,优先采用标准库
multiprocessing或外部任务队列,通过多独立进程规避 GIL 的全局并发制约。





AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

Beamer 4是面向macOS的本地视频投屏工具,可将Mac中的影片投放到Apple TV、Chromecast及兼容设备,支持常见格式、多类字幕、环绕声、播放列表和电视遥控操作。
Boom 3D macOS版是一款系统级音效增强工具,可为音乐、电影、游戏和流媒体提供3D虚拟环绕声、31段均衡器、音量增强及应用独立音量控制,并支持本地播放器与多种音频输出设备。
Boris FX macOS版是一套面向剪辑、合成、调色及动态图形工作的专业后期工具,涵盖视觉特效、平面与三维跟踪、转描、画面修复、粒子动画和音频清理,可配合多种主流宿主软件使用。
Capto 是面向 macOS 的屏幕截图、高清录屏与媒体编辑工具,支持区域及整屏捕获、网页长截图、双音轨处理、图片和视频标注、素材分类与多渠道分享,适合教师、学生、内容创作者及需要制作演示教程的用户。
Cursor Crane 是一款仅面向 macOS 的键盘操控效率工具,可通过提示标签、网格、文字查找和窗口模式完成点击、滚动、定位与切换,并支持屏幕内容提取、脚本及工作流扩展。
Deep Freeze 冰点还原 macOS版通过冻结系统配置,让受保护的Mac在重新启动后回到预设状态,并提供解冻空间、维护计划、密码保护及Apple Remote Desktop管理能力。
Focusky macOS版是一款面向教学课件、商务汇报、产品展示和动画宣传内容的演示制作工具。它通过无限画布、路径编排、缩放旋转转场及多媒体编辑,将传统逐页幻灯片转化为更具空间感的动态演示。
Folder Colorizer 2 macOS版是一款直观的文件夹外观定制工具,可更换颜色,添加表情、贴纸及图片背景,并支持批量处理、智能推荐和恢复默认样式,帮助用户更快辨认工作、学习与生活资料。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。
AnyDesk Windows版是一款轻量化远程桌面与技术支持工具,可用于控制异地电脑、传输文件、远程打印及无人值守访问。它兼顾连接响应、安全权限和部署灵活性,适合个人远程办公、企业设备维护与客服支持。
Boom 3D Windows版是一款面向音乐、电影和游戏场景的系统级音效增强工具,支持虚拟3D环绕声、31段均衡器、预设音效、应用音量控制及本地音乐播放,可配合耳机、扬声器和蓝牙耳机使用。
Boris FX Windows版是一套服务于影视剪辑、视觉特效、运动跟踪、转描、图像修饰及音频修复的专业创作工具集合,可作为插件接入多种主流后期宿主,也包含可独立运行的应用,适合剪辑师、特效师与内容创作者使用。
ChemDraw Windows版是一款面向化学研究、药物研发、材料科学和教学工作的专业结构绘图工具,可快速绘制分子、反应式及生物聚合物,并提供结构整理、格式转换、性质计算和科研文档协作能力。
CODESOFT Windows版是一套企业级条码与RFID标签设计打印工具,可连接Excel、Access、SQL及云端数据源,支持变量、表单、GS1条码、数据库记录和多种工业打印机,适合制造、仓储、物流及合规标识场景。
Deep Freeze 冰点还原 Windows版通过重启恢复技术保护系统盘及指定分区,自动撤销恶意程序、误操作和配置漂移造成的改动,并支持密码保护、解冻空间与多硬盘管理,适合学校机房、公共电脑、办公终端及家庭电脑使用。
EDIUS 11 Windows版是一款面向影视制作、广播电视、纪录片、短视频及教育机构的专业非线性编辑工具,支持4K/8K、多格式混编、HDR调色、字幕、音频处理和后台渲染,并提供素材管理及丰富的导出预设。
FastStone Capture Windows版是一款轻量级屏幕捕捉、录屏与图像编辑工具,可截取窗口、区域、菜单和滚动页面,并提供标注、模糊、取色、OCR、录音录像及多格式导出能力,适合办公说明、教程制作和问题反馈。
Focusky Windows版是一款动画演示与交互课件制作工具,通过无限画布、缩放旋转镜头、模板素材和对象动画组织内容,可导入PPTX,并输出视频、EXE、PDF、网页等格式,适用于课堂教学、微课、商务汇报及产品展示。