


c语言段错误处理方法及排查解决步骤
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
Segmentation fault (core dumped) 并瞬间终止,没有任何详细行号提示。段错误本质上是进程访问了未分配、受保护或越界的内存地址,触发了操作系统的保护机制。定位这一问题的核心路径在于:明确发生段错误的内存机制,通过 GDB 结合 Core Dump 或 AddressSanitizer 精确锁定出错的代码行号与调用栈,修正指针操作与边界逻辑,并在编译期加入防范检测。
一、段错误的触发机制与常见场景
段错误(Segmentation fault,常缩写为 SIGSEGV)是硬件异常与操作系统协同防御的结果。现代操作系统为每个进程提供虚拟内存空间,并通过内存管理单元(MMU)进行虚拟地址到物理地址的映射。当 CPU 尝试执行非法内存访问时,MMU 会触发页错误中断,操作系统内核接管该中断后向违规进程发送 SIGSEGV 信号,默认动作即为终止进程并导出内存镜像。
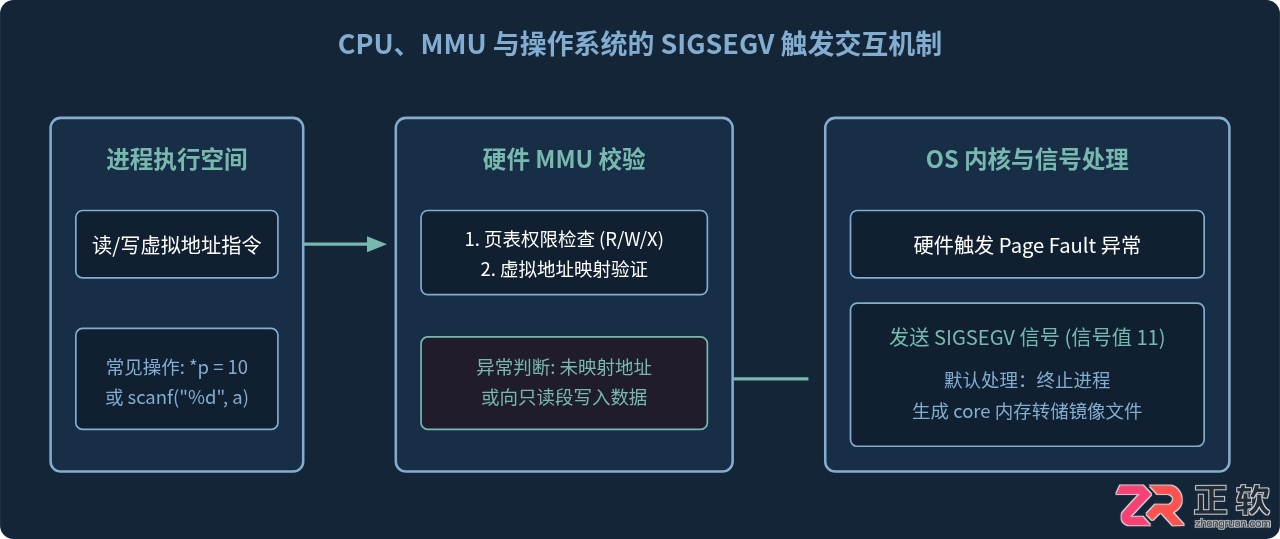
编写 C 语言代码时,引发段错误的原因虽然多样,但几乎均指向非法的指针与内存管理操作。以下是四种最典型的代码模式:
1. 空指针与野指针解引用
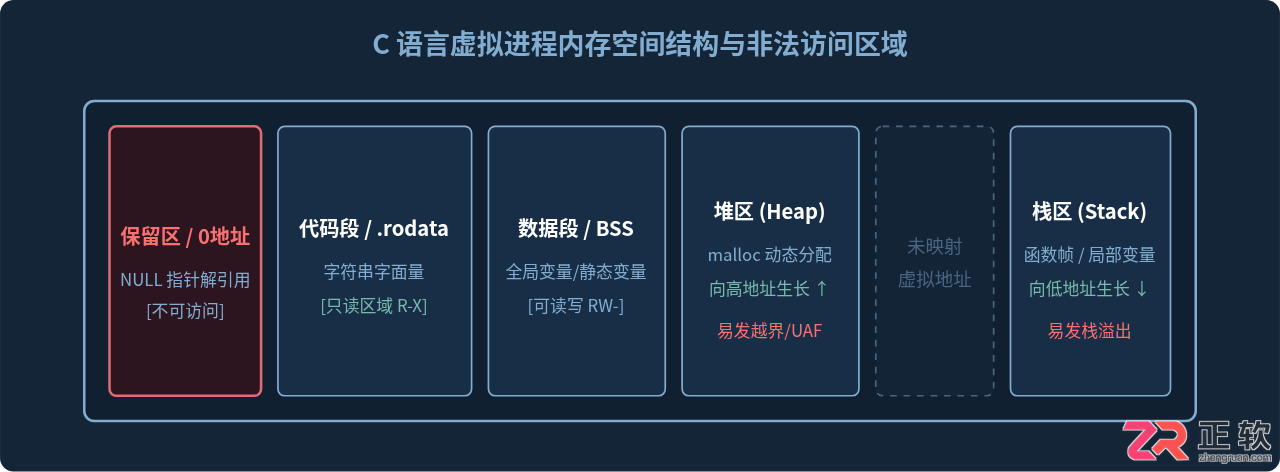
解引用未初始化或赋值为 NULL 的指针是最常见的触发方式。系统通常将 0 地址及附近区域标记为不可访问,对其读取或写入会立即触发中断:
// 错误示例:解引用空指针与未初始化指针
int *ptr = NULL;
*ptr = 100; // 崩溃:写入非法地址 0x0

int *wild_ptr; // 未初始化,内部值为随机脏地址
*wild_ptr = 50; // 崩溃或随机篡改未知内存
2. 向只读内存区域(常量区)写入
字符串字面量存储在程序的常量区(通常是只读数据段 .rodata)。尝试修改其内容会被 MMU 拦截:
// 错误示例:修改只读区域
char *str = "hello world";
str[0] = 'H'; // 崩溃:尝试向 .rodata 写入数据

// 正确写法:在栈上分配字符数组,允许读写
char str_arr[] = "hello world";
str_arr[0] = 'H';
3. 栈溢出与深层递归
栈的大小通常受到操作系统的硬性限制(在 Linux 下默认通常为 8MB)。如果在栈上分配了过大的局部数组,或者发生无限递归调用,栈指针超出分配范围并触及未映射的保护页(Guard Page),就会引发段错误:
// 错误示例:超大局部数组与未终止的递归
void deep_recursion() {
    char buffer[1024 * 1024 * 10]; // 尝试在栈上分配 10MB 空间
    deep_recursion();
}
4. 堆内存越界、释放后使用(UAF)与双重释放
使用 malloc 申请的空间如果访问越界,破坏了内存分配器维护的内部元数据,或者在 free 之后继续访问该指针,极易在当下或下一次分配操作时崩溃。
二、标准排查解决步骤
排查段错误不需要依赖盲目插入 printf,这种做法不仅耗时,还可能因为 I/O 缓冲区未刷新而产生误导。推荐按照由浅入深的标准化流程进行诊断:
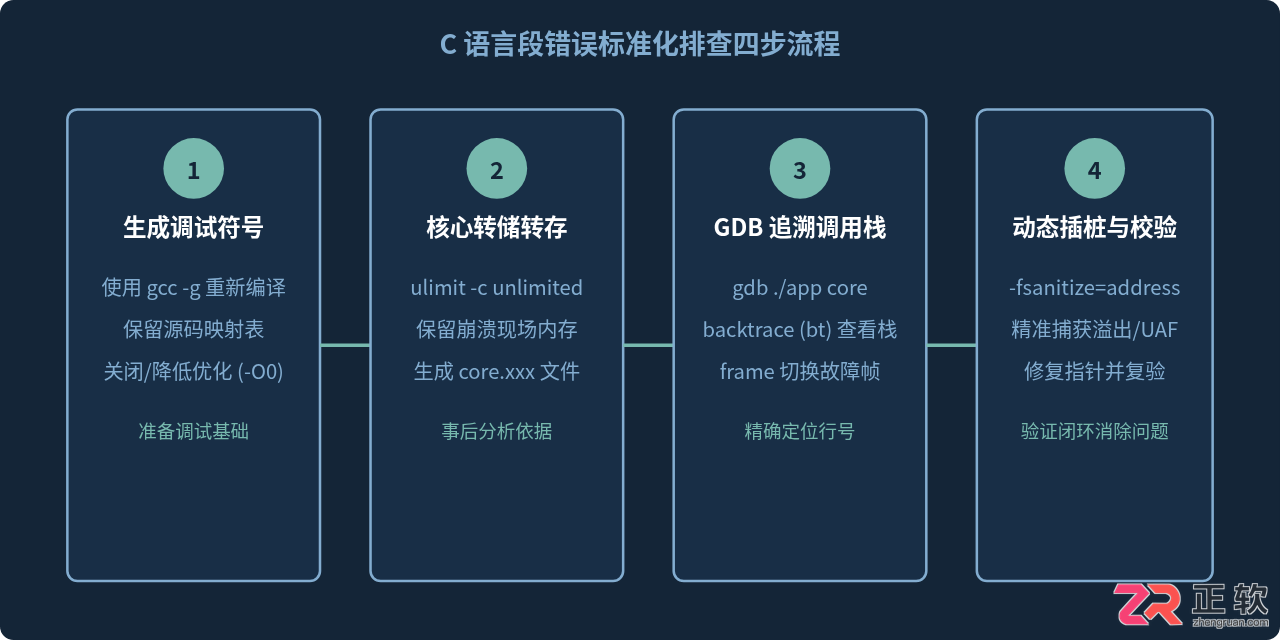
第 1 步:保留调试符号并开启 Core Dump
排查的第一步是确保编译产物带有调试信息,并且操作系统允许生成 core dump 镜像文件。如果使用 Release 配置或被 strip 过符号表,调试器将无法将内存地址还原为源码行号。
# 1. 编译时加上 -g 选项,建议加上 -O0 关闭优化避免指令重排
gcc -g -O0 -o demo_fault demo_fault.c

# 2. 查看当前 core 文件大小限制(若输出为 0,则系统不会生成 dump 文件)
ulimit -c

# 3. 设置允许生成不限大小的 core 镜像文件(仅对当前终端会话生效)
ulimit -c unlimitedsystemd-coredump 接管。如果在当前目录未看到 core 文件,可以通过命令 coredumpctl list 查看记录,并使用 coredumpctl gdb 直接拉起调试。
第 2 步:运行程序并捕获崩溃现场
运行编译后的可执行文件,复现段错误并产生核心转储文件:
./demo_fault第 3 步:使用 GDB 快速定位触发代码行
通过 GDB 加载程序及其对应的 core dump 文件(或者直接在 GDB 内部运行程序):
# 方法 A:事后加载 core 文件分析
gdb ./demo_fault core

# 方法 B:直接在 GDB 中启动调试
gdb ./demo_fault
(gdb) run
程序崩溃停顿后,GDB 会直接输出引发异常的指令地址与所在源码位置。此时运行 backtrace(缩写为 bt)查看完整的函数调用栈:
0x0000555555555169 in process_data (ptr=0x0) at demo_fault.c:8
8 *ptr = 100;
(gdb) bt
#0 0x0000555555555169 in process_data (ptr=0x0) at demo_fault.c:8
#1 0x000055555555519b in main () at demo_fault.c:15
(gdb) print ptr
$1 = (int *) 0x0
从输出中可以清晰看出,崩溃发生在 demo_fault.c 的第 8 行,原因是在 process_data 函数中向 0x0(NULL 指针)写入了数据。调用来自 main() 函数的第 15 行。
第 4 步:使用 AddressSanitizer 诊断复杂内存破坏
有些段错误并不会在越界发生的瞬间崩溃,而是静默破坏了相邻变量或栈帧返回地址,并在很久之后的其他函数返回时才报错。这种“延迟崩溃”通过 GDB 往往只能看到受损的表面现象。此时可以使用 GCC/Clang 内置的 AddressSanitizer(ASan):
# 使用 AddressSanitizer 编译
gcc -fsanitize=address -g -O1 -o demo_asan demo_fault.c

# 运行程序
./demo_asan
ASan 会在运行时注入影子内存(Shadow Memory)监测每一个字节的访问有效性,一旦发生数组越界、堆溢出或 UAF,会立即终止并输出精细的报错上下文,直接标明是“全局缓冲区溢出”还是“堆区越界访问”。
三、防御与修复策略总结
排查出具体出错位置后,需要落实到具体的代码规整与防御方案中,避免隐患残留:
- 防御性空值校验:所有对外公开的函数,接收指针参数后首先进行非空断言或条件拦截:
int write_data(int *buf, size_t size) { if (buf == NULL || size == 0) { return -1; // 参数非法,安全返回错误码 } // 执行后续操作 return 0; } - 指针释放后立刻置空:释放动态内存后,将悬空指针显式赋值为
NULL。再次解引用时能够稳定复现确定位置的段错误,而不会引发非确定性的内存污染:free(buffer); buffer = NULL; - 开启严格编译器告警:在编译期消除格式化字符串不匹配、类型隐式转换等低级隐患。编译参数推荐设置为:
gcc -Wall -Wextra -Wformat=2 -pedantic -g -o program main.c
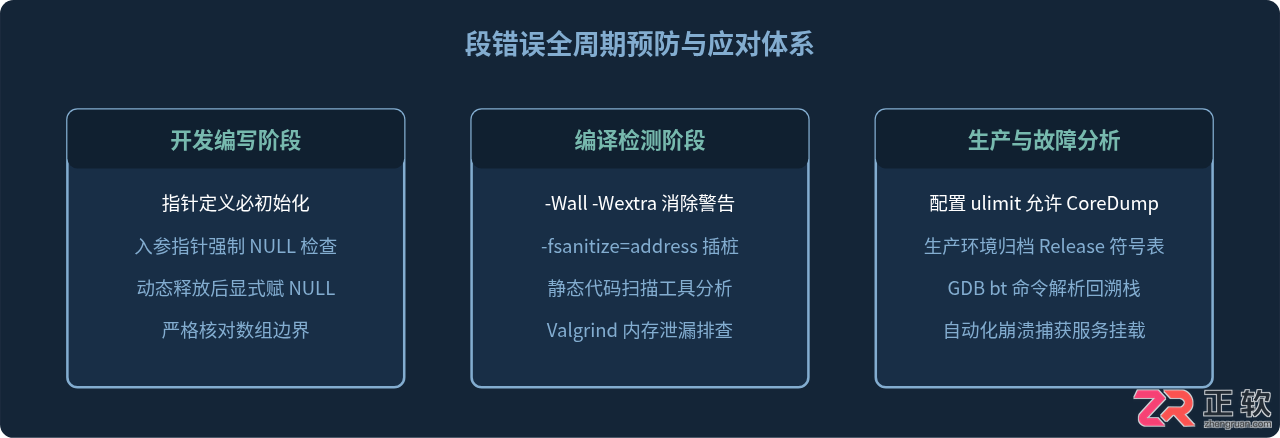
段错误虽然在发生时显得突兀,但只要掌握了“生成调试符号 → 启用 Core Dump / ASan → GDB 追溯调用栈 → 针对性实施边界与空指针防护”的标准化链路,就能够快速还原现场并将问题解决在测试与构建环节。








IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

Adobe After Effects 是面向动态图形、影视特效与视频合成的专业创作软件。它提供关键帧动画、遮罩抠像、运动跟踪、三维空间、文字动画和表达式等工具,并可与 Premiere Pro、Photoshop、Illustrator

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Adobe Bridge 是面向摄影师、设计师及内容团队的免费数字资产管理工具,可集中预览照片、视频和 Adobe 项目文件,并利用评级、标签、关键词、元数据、筛选与收藏集完成分类检索。它还支持批量重命名、格式导出、相机导入及 Camera

Adobe Illustrator 是 Adobe 推出的专业矢量图形设计软件,适合在 Mac 上制作标志、图标、插画、包装、信息图及印刷版面。它以路径和锚点构建可无损缩放的图形,并提供钢笔、形状、文字、图像描摹、渐变、画板及生成式功能。

Adobe InDesign 是面向印刷品与数字出版物的专业版面设计软件,可在 Mac 上制作书籍、杂志、宣传册、海报、报告及交互式文档。它提供精细的文字样式、网格、母版、长文档管理和印前输出能力。

Adobe Lightroom Classic 是面向桌面摄影工作流的照片管理与后期处理软件,可将原始照片保存在本地硬盘,通过目录、关键词、评分和收藏夹高效整理图库,并提供 RAW 冲印、蒙版、镜头校正、批量同步及多格式导出等功能。

Adobe Media Encoder 是 Adobe 推出的专业音视频编码与转码工具,可通过队列、预设和监视文件夹批量完成格式转换、代理文件创建及多平台成片输出,并与 Premiere Pro、After Effects 等软件紧密协作。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理软件,提供图层、蒙版、选区、修复、调色、文字排版、智能对象及生成式编辑等能力。Mac 版支持 Intel 与 Apple Silicon 处理器。

Adobe Premiere Pro 是面向专业视频制作的非线性剪辑软件,提供多轨时间线、调色、音频处理、字幕、代理工作流和多格式输出能力,并可与 After Effects、Audition、Photoshop 及 Frame.io 协同

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理工具,可在 Windows 上完成照片修饰、选区抠图、图层合成、文字排版、绘画及生成式编辑。软件采用订阅授权,由 Creative Cloud 管理安装、更新与许

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。

Adobe Bridge 是 Adobe 推出的创意资产管理工具,可集中预览、分类和查找照片、视频、PDF及多种设计文件,并支持元数据、关键词、评级、批量重命名和格式导出。它可与 Photoshop、Illustrator 等应用衔接,

Adobe Lightroom Classic 是面向 Windows 桌面摄影工作流的照片管理与无损编辑工具,可通过目录集中整理大型图库,并完成 RAW 显影、局部蒙版、批量调整、打印和多格式导出。它强调本地文件管理与精细控制,

Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,

Adobe After Effects 是面向动态图形、动画与影视视觉特效制作的专业工具,可完成关键帧动画、图层合成、遮罩跟踪、抠像、文字动画和二维三维元素整合。Windows 版通过 Adobe Creative Cloud 安装及更新,

Adobe Media Encoder 是 Adobe 面向视频与音频制作流程提供的专业编码和转码工具,可批量处理媒体文件、创建代理、套用输出预设并监控文件夹自动执行任务。它与 Premiere、After Effects、Audition