


Java大数据开发学习路线:Hadoop、Spark与Flink核心技术栈解析
针对Java开发者的实用大数据技术路线解析,深入梳理Hadoop生态存储与资源调度、Spark离线计算与内存模型、Flink低延迟流处理的核心技术要点及递进学习方法。
掌握大数据工程开发并不需要同时精通所有的开源项目,核心在于以Java为基本底色,搞清分布式系统在数据持久化、分布式协作与数据流动计算这三个层面的演进逻辑。本文围绕Hadoop的底座价值、Spark的内存加速模型与Flink的有状态流计算展开,结合清晰的代码示例、状态演化图与避坑要点,提供一条不走弯路的渐进学习路径。
一、整体技术栈梯次演进与学习步骤
很多初学者容易陷入一种误区:认为Flink出来之后Hadoop就过时了,可以直接跳过HDFS与YARN去学实时计算。但事实是,任何流计算的数据源沉淀、检查点物理存储以及数仓归宿,依然离不开HDFS或兼容的分布式对象存储。YARN与Kubernetes同样承担着集群资源分配的基础职能。
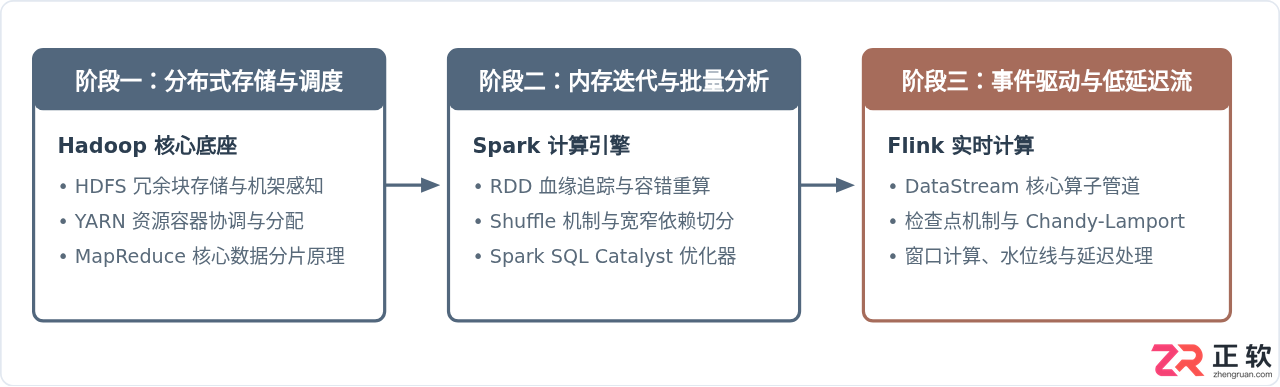
理性的技术掌握顺序应当严格遵循系统的输入、处理与产出规律:以Hadoop确立“数据切片与分布式调度”认知,借助Spark掌握“大规模离线批量聚合与内存管道计算”,最后通过Flink攻破“无界流、精确一次容错与窗口状态管理”。
二、Hadoop:分布式系统的物理基石
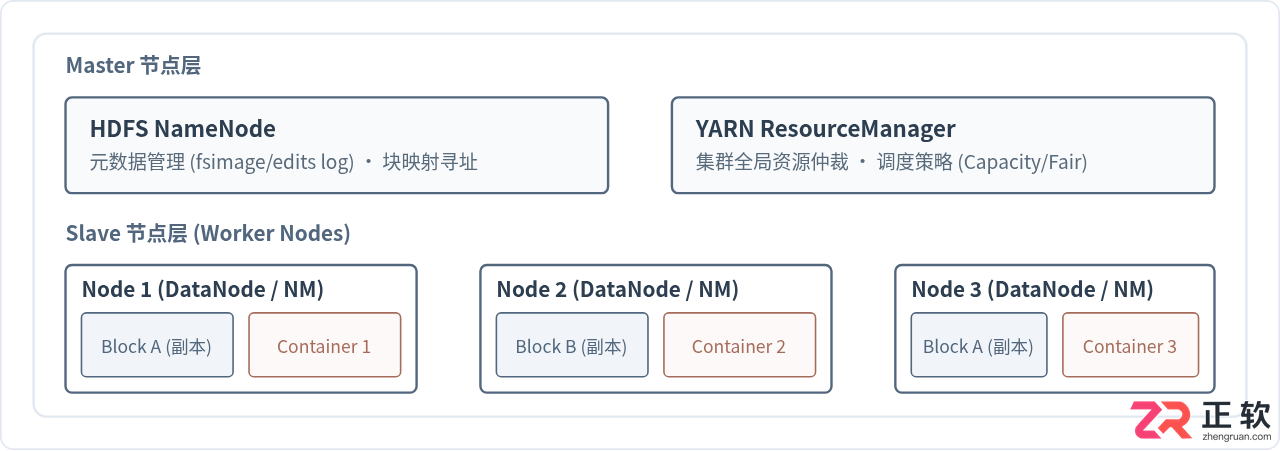
在生产环境中直接手写原生 MapReduce 作业的场景已经很少,但在学习期,理解 HDFS 如何把大文件切分成块(Block)并在多个节点冗余,以及 YARN 如何从物理节点上划出包含内存与 CPU 的容器(Container),是理解整个分布式计算的起点。
1. 核心架构拆解
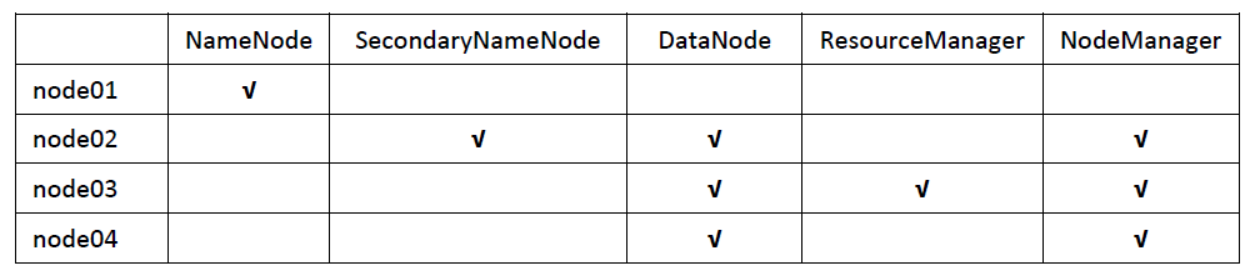
HDFS 的核心在于主从架构与数据块抽象。NameNode 仅在内存中维护命名空间与 Block 到 DataNode 的映射关系,实际数据按照 128MB(默认)的物理块离散写入 DataNode。YARN 的 ResourceManager 负责接洽集群作业申请,通过 NodeManager 分配的 Container 完成进程级隔离与执行。
2. Java 操作 HDFS 示例
在实际工程中,大数据服务通常通过 hadoop-client 依赖以编程方式直接读写集群数据。以下是一个典型的文件上传与流式写入示例:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;

import java.io.IOException;
import java.net.URI;
import java.nio.charset.StandardCharsets;

public class HdfsClientDemo {
    public static void main(String[] args) throws IOException, InterruptedException {
        Configuration configuration = new Configuration();
        // 设置副本数,生产环境下通常为3
        configuration.set("dfs.replication", "2");

        URI hdfsUri = URI.create("hdfs://namenode-host:9000");
        String clusterUser = "hdfs";

        // 获取分布式文件系统句柄
        try (FileSystem fs = FileSystem.get(hdfsUri, configuration, clusterUser)) {
            Path targetPath = new Path("/user/data/input/sample.txt");

            // 写入文本内容并输出
            try (FSDataOutputStream outStream = fs.create(targetPath, true)) {
                String payload = "Hadoop,Spark,Flink - BigData Stack\n";
                outStream.write(payload.getBytes(StandardCharsets.UTF_8));
                outStream.hflush();
            }
            System.out.println("Path written successfully: " + targetPath.toString());
        }
    }
}三、Spark:内存计算与离线数仓骨干
Hadoop 的 MapReduce 每一步中间计算都需要将结果落盘回写 HDFS,造成极其严重的磁盘 I/O 开销。Spark 的核心突破在于提出了 RDD(弹性分布式数据集),并在此基础上构建出基于内存管线(Pipeline)的任务执行图(DAG)。
1. 算子依赖与 Shuffle 原理
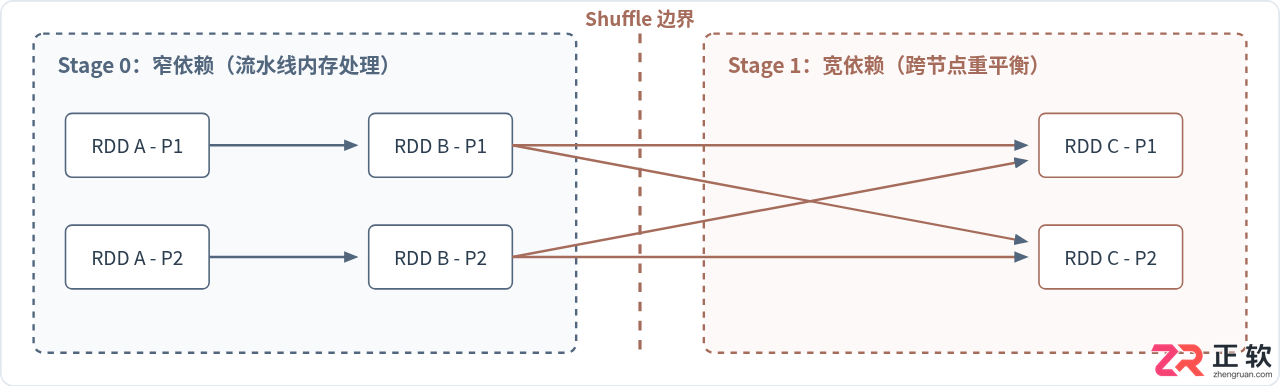
理解 Spark 优化的核心在于分清窄依赖(Narrow Dependency)与宽依赖(Wide Dependency):
- 窄依赖:每个父 RDD 的分区最多只能被一个子 RDD 分区使用(例如
map、filter)。各个分区可以直接在同一物理节点的内存中以流水线方式串行执行,无需网络传输。 - 宽依赖:子 RDD 的每个分区依赖多个父 RDD 的分区(例如
reduceByKey、groupByKey、join)。这必然引发 Shuffle 过程:数据必须按照 Hash 规则跨网络重新分发到不同节点,极其消耗网络与本地磁盘。
2. Java 开发 Spark 离线计算作业
虽然 Scala 是 Spark 原生语言,但在大型工程协作中,Java 依然是业务平台与后端系统融合的首选。以下展示如何通过 Java 构建一个结构化的 Dataset 分析作业:
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Row;
import org.apache.spark.sql.SparkSession;
import static org.apache.spark.sql.functions.*;

public class SparkAnalysisJob {
    public static void main(String[] args) {
        // 创建 SparkSession 入口
        SparkSession spark = SparkSession.builder()
                .appName("LogMetricAggregateJob")
                .master("local[*]") // 生产环境提交至 YARN 或 K8s 时需去除该配置
                .getOrCreate();

        // 延迟加载 HDFS 结构化数据
        Dataset logDataset = spark.read()
                .option("header", "true")
                .option("inferSchema", "true")
                .csv("hdfs://namenode-host:9000/user/data/input/access_log.csv");

        // 过滤状态码并根据用户 ID 分组聚合
        Dataset aggregatedData = logDataset
                .filter(col("status_code").equalTo(200))
                .groupBy("user_id")
                .agg(count("url").alias("visit_count"), max("response_time").alias("max_latency"))
                .orderBy(col("visit_count").desc())
                .limit(100);

        // 输出执行计划,可用于分析 Catalyst 优化与 Physical Plan
        aggregatedData.explain();

        // 最终 Action 操作:将聚合数据以 Parquet 列存落盘
        aggregatedData.write()
                .mode("overwrite")
                .parquet("hdfs://namenode-host:9000/user/data/output/user_daily_summary");

        spark.stop();
    }
}
四、Flink:真正低延迟的有状态流计算
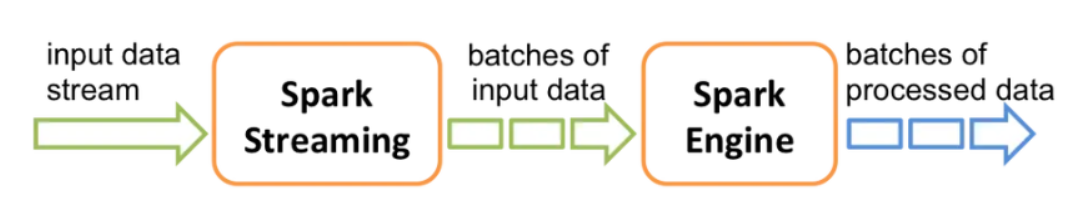
虽然 Spark 拥有结构化流(Structured Streaming),但其底层机制本质上是“微批(Micro-batching)”,延迟通常在百毫秒到秒级。而 Flink 采用原生事件驱动(Event-driven)架构,单条数据到达即可立即触发计算,天然具备亚秒甚至毫秒级的极低延迟。
1. 核心技术壁垒:状态(State)与检查点(Checkpoint)
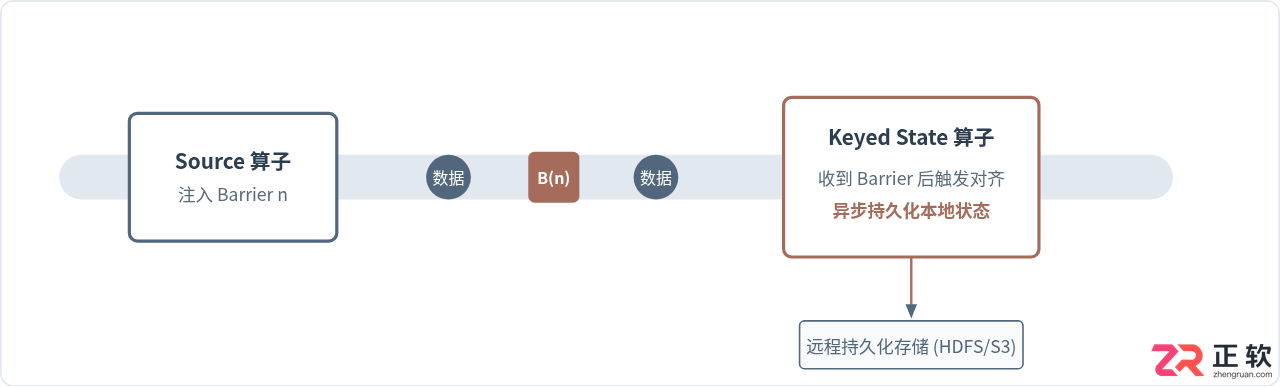
任何非平凡的流计算都是“有状态的”,例如实时累加 UV、时间窗口统计等。Flink 的设计精髓就在于它把状态保存在算子本地内存中(或 RocksDB),并通过 Chandy-Lamport 算法派生的 Checkpoint Barrier 机制,在不中断实时数据流的前提下定期对分布式状态做快照,从而确保在发生硬件崩溃时能够实现严格的精确一次(Exactly-Once)语义。
2. Java 开发有状态流计算示例
下面是一个使用 Java 构建的典型 Flink 任务,实现了滚动窗口聚合与检查点容错配置:
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.streaming.api.CheckpointingMode;

public class FlinkStreamingMetricJob {
    public static void main(String[] args) throws Exception {
        final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 核心容错配置:每 5000 毫秒启动一次 Checkpoint
        env.enableCheckpointing(5000);
        env.getCheckpointConfig().setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);
        env.getCheckpointConfig().setMinPauseBetweenCheckpoints(1000);
        env.getCheckpointConfig().setCheckpointTimeout(60000);

        // 模拟监听本地 Socket 端口输入 (可替换为 KafkaSource)
        DataStream textStream = env.socketTextStream("localhost", 9999);

        DataStream> aggregatedStream = textStream
                .filter(line -> line != null && !line.trim().isEmpty())
                .map(new MapFunction>() {
                    @Override
                    public Tuple2 map(String value) {
                        return new Tuple2<>(value.trim(), 1);
                    }
                })
                .keyBy(value -> value.f0) // 根据事件 Key 进行数据路由
                .window(TumblingProcessingTimeWindows.of(Time.seconds(10))) // 10秒滚动窗口
                .sum(1); // 对数量字段递增聚合

        aggregatedStream.print();

        // 触发流作业执行
        env.execute("Flink-Production-Metric-Job");
    }
}
五、三大引擎特性对比与选型维度
在实际系统设计中,并非用某一个框架通吃所有场景。业务通常会将它们组合使用:用 Hadoop 沉淀历史底池,用 Spark 做定期离线大批量的 ETL 与机器学习特征生成,用 Flink 支撑风控预警、秒级大屏和实时特征推送。
| 技术栈 | 主要处理模型 | 端到端延迟 | 核心存储依赖 | 典型业务场景 |
|---|---|---|---|---|
| Hadoop (MapReduce) | 磁盘级批处理 | 小时级 / 天级 | HDFS 本地磁盘 | 冷数据全量备份、超大历史归档全量扫描 |
| Apache Spark | 基于 RDD 的内存微批 / 离线批处理 | 百毫秒到分钟级 | HDFS / 兼容对象存储 | 离线数据仓库分层构建、全量指标统计、机器学习训练 |
| Apache Flink | 事件驱动的原生无界流 | 毫秒级 | 本地内存/RocksDB + 外部分布式快照存储 | 交易反欺诈风控拦截、实时大屏指标计算、实时日志告警 |
六、针对 Java 工程师的学习落地建议
具备传统 Spring Boot 或企业级后端开发背景的 Java 工程师,在切入大数据技术栈时应着重注意以下三点思维模式的转换:
- 从“集中式面向对象”转向“分布式无状态函数”:大数据框架中的闭包(如
map、flatMap传入的 Lambda 表达式)会被序列化并通过网络分发到各节点执行。要时刻警惕在闭包外部初始化不可序列化的对象(如未被特殊修饰的数据库连接池)。 - 内存意识必须覆盖堆外(Off-Heap):无论 Spark 还是 Flink,为了规避 JVM GC 导致的长时间暂停(Stop-The-World),大量核心数据结构都在堆外内存中直接管理。调优不仅要看
-Xmx,更要关注执行框架的托管内存与 Off-Heap 配置。 - 验证必须结合执行计划:学习任何复杂的 API 调用时,不要仅停留在“代码能跑出结果”。务必养成打印并阅读物理执行计划的习惯(如 Spark 的
explain()或 Flink Web UI 的 DAG 图),观察数据切片是否倾斜,判断 Shuffle 是否可以被规避。










火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,