


Python爬取网页的详细步骤与代码实例教程
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
编写一个网络爬虫,本质上就是写程序模拟浏览器向服务器发起请求,接收返回的网页源代码,并从中筛选提取出我们需要的数据。本文将使用 Python 中经典的 requests 与 BeautifulSoup4 库,带你按标准流程完成从网络请求到本地数据持久化的完整闭环,掌握最通用、可靠的静态网页爬取方法。
一、爬虫运行的基本工作流与技术选型
在开始写代码之前,我们需要理清一次网页爬取任务究竟包含哪几个阶段。无论是抓取新闻标题、商品价格还是天气数据,标准的爬虫流程都可以拆解为四大核心环节:确定目标并构造请求、获取响应内容、定位并解析节点,最后将清洗好的数据保存下来。
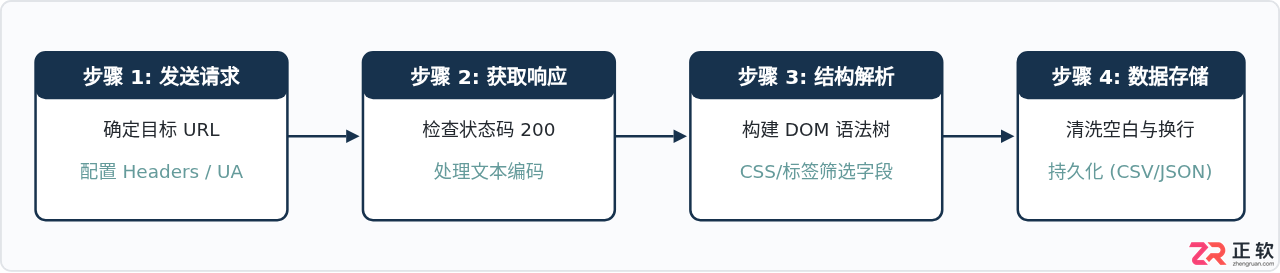
在工具选择上,我们选用 Python 生态中最成熟易用的组合:
- Requests:用于网络通信。相比 Python 自带的
urllib,它的 API 设计更加人性化,能够轻松处理编码、会话和 Header 配置。 - BeautifulSoup4:用于文档解析。它能够将凌乱的 HTML 字符串转换为树状结构,支持通过标签名、CSS 类选择器等直观方式定位元素。
二、前期准备:安装依赖环境
在你的终端(Terminal 或命令提示符)中执行以下命令,安装爬取和解析所需的第三方模块:
pip install requests beautifulsoup4如果使用的是 Jupyter Notebook 或虚拟环境,请确保安装命令执行在对应的解释器环境中。安装完成后,可以在 Python 交互环境中输入 import requests, bs4 验证是否安装无误,未报错即表示就绪。
三、核心步骤拆解
1. 伪装请求头(Headers)与发送 HTTP 请求
绝大多数网站都有基础的防抓取机制,其中最直接的一种是检查 HTTP 请求头中的 User-Agent。如果使用 requests.get() 而不提供任何头部信息,默认的标识为类似 python-requests/2.x.x 的字符串,很多服务器会直接拒绝响应(返回 403 Forbidden)。
因此,第一步也是最关键的基础细节,是在请求中带上主流浏览器的 User-Agent 字符串:
import requests

url = "https://quotes.toscrape.com/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
}

response = requests.get(url, headers=headers, timeout=10)
print(f"响应状态码: {response.status_code}")timeout=10 参数表示若目标服务器在 10 秒内未响应则主动中断并抛出异常。如果不设置该参数,一旦网络阻塞或目标挂起,你的程序可能会永久卡在等待响应的步骤。
2. 解析 HTML 结构与节点匹配
当服务器返回 200 成功代码后,我们可以通过 response.text 获取完整的网页 HTML 文本。随后将其送入 BeautifulSoup 构建解析对象。
网页在浏览器中呈现的内容,在底层是一层层嵌套的 DOM 树。我们需要根据目标数据在页面中的位置,找到包含目标特征的标签名(tag)、类名(class)或属性(attribute)。
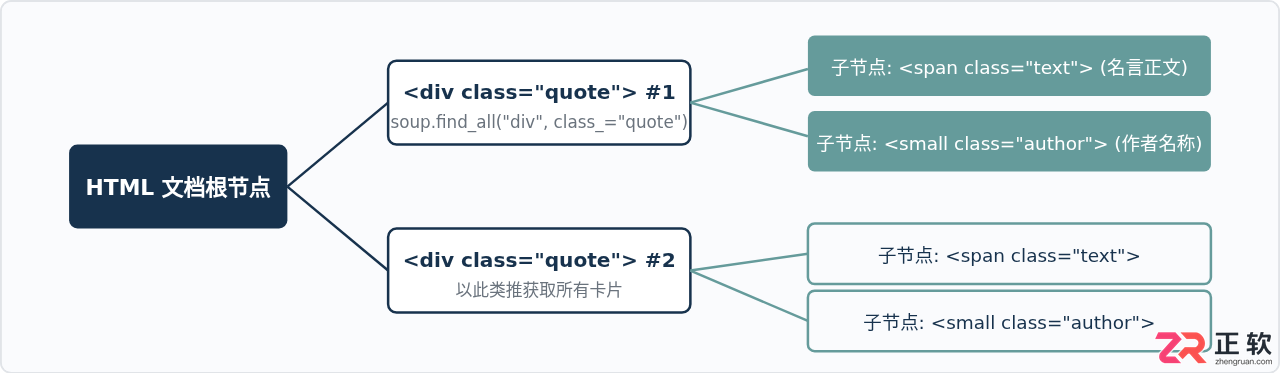
在解析时,有两个最基础且频繁使用的方法:
find():查找符合条件的第一个元素,返回单个 Tag 对象;未找到则返回None。find_all():查找符合条件的所有元素,返回一个列表(可直接通过循环遍历)。
3. 提取属性与清洗数据
定位到具体节点后,通常需要取出其包含的文字内容或特定属性值(如超链接 href 或图片地址 src):
- 使用
element.get_text(strip=True)提取纯文本并剔除前后空格及换行。 - 使用字典取值方式
element["href"]获取标签的属性。
4. 数据结构化与存储为 CSV
提取出的数据通常以字典形式组织,每行一条记录。利用 Python 内置的 csv 模块中的 csv.DictWriter,可以轻松把字典列表写入标准的 CSV 表格文件中,供后续在 Excel 或数据库中处理。
四、完整实战代码实例
我们以面向爬虫学习的公开练习网站 https://quotes.toscrape.com/ 为例,完整编写一个采集名言、作者、作者介绍链接并保存至 CSV 文件的爬虫脚本。
import csv
import requests
from bs4 import BeautifulSoup

def scrape_quotes():
    # 1. 目标地址与配置
    base_url = "https://quotes.toscrape.com"
    target_url = f"{base_url}/"
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/122.0.0.0 Safari/537.36"
        )
    }

    print(f"正在请求页面: {target_url}")

    # 2. 发起 HTTP GET 请求
    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        # 确保编码正确,如果网页乱码,可使用 response.apparent_encoding
        response.encoding = response.apparent_encoding
        response.raise_for_status()  # 若状态码不是 200,触发 HTTPError 异常
    except requests.exceptions.RequestException as e:
        print(f"请求失败: {e}")
        return

    # 3. 解析页面
    soup = BeautifulSoup(response.text, "html.parser")

    # 找到所有包含名言卡片的 div 容器
    quote_blocks = soup.find_all("div", class_="quote")

    collected_data = []

    # 4. 遍历提取字段
    for block in quote_blocks:
        # 提取名言文本
        text_el = block.find("span", class_="text")
        text = text_el.get_text(strip=True) if text_el else ""

        # 提取作者
        author_el = block.find("small", class_="author")
        author = author_el.get_text(strip=True) if author_el else ""

        # 提取作者详情页相对链接并拼接为完整 URL
        link_el = block.find("a")
        author_link = f"{base_url}{link_el['href']}" if (link_el and "href" in link_el.attrs) else ""

        collected_data.append({
            "quote": text,
            "author": author,
            "author_link": author_link
        })

    print(f"成功解析出 {len(collected_data)} 条记录。")

    # 5. 持久化存储到 CSV 文件
    csv_file = "scraped_quotes.csv"
    with open(csv_file, mode="w", encoding="utf-8-sig", newline="") as f:
        fieldnames = ["quote", "author", "author_link"]
        writer = csv.DictWriter(f, fieldnames=fieldnames)

        writer.writeheader()
        writer.writerows(collected_data)

    print(f"数据已成功写入到 {csv_file}")

if __name__ == "__main__":
    scrape_quotes()
代码运行与预期输出
在安装好依赖并运行该脚本后,控制台将输出如下运行日志(示例输出):
正在请求页面: https://quotes.toscrape.com/
成功解析出 10 条记录。
数据已成功写入到 scraped_quotes.csv
在当前目录下生成的 scraped_quotes.csv 可以使用 Excel 或任意文本编辑器打开,内部包含了规整的表头和 10 条提取好的名言与作者数据。
五、健壮性考量:异常处理机制
初学者编写爬虫常遇到的一个困扰是“爬了几页突然崩溃报错退出”。网络环境具有高度不确定性,服务器也可能随时出现 500 错误、丢包或超时。编写可用于实际生产环境的爬虫,必须建立分层防御机制。
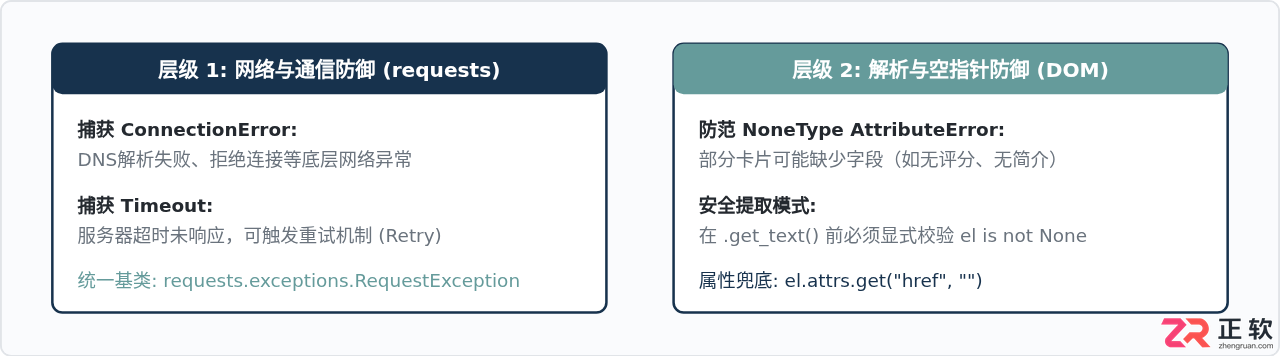
六、爬虫进阶与全景总结
掌握了基础静态网页的抓取后,在面对更复杂的实际场景时,爬虫技术栈会面临不同的技术分流:
- 动态渲染页面:如果网页内容是通过 JavaScript 异步请求(Ajax)生成的,直接请求 HTML 源码可能看不到具体数据。此时优先打开浏览器 F12 开发者工具的 Network 面板抓取实际的 JSON 数据接口;若接口加密极其复杂,再考虑使用 Playwright 或 Selenium 进行浏览器自动化渲染。
- 爬取礼仪与频控:在批量爬取多页内容时,务必在循环中加入
time.sleep(1)等延时,避免瞬间向目标服务器发送过多并发请求,造成服务器负载过大甚至导致 IP 被封禁。
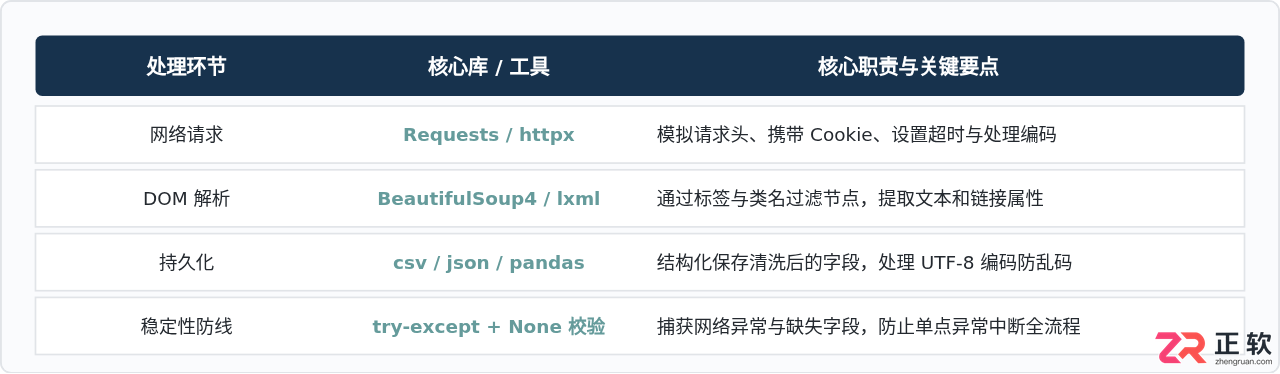
只要严格遵循“构造请求头发送请求 → 验证状态码获取源码 → 层级定位元素提取数据 → 空指针防御与持久化保存”这一标准化步骤,绝大部分静态网页的数据采集任务都可以按此逻辑快速、稳定地实现。










IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

Adobe After Effects 是面向动态图形、影视特效与视频合成的专业创作软件。它提供关键帧动画、遮罩抠像、运动跟踪、三维空间、文字动画和表达式等工具,并可与 Premiere Pro、Photoshop、Illustrator

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Adobe Bridge 是面向摄影师、设计师及内容团队的免费数字资产管理工具,可集中预览照片、视频和 Adobe 项目文件,并利用评级、标签、关键词、元数据、筛选与收藏集完成分类检索。它还支持批量重命名、格式导出、相机导入及 Camera

Adobe Illustrator 是 Adobe 推出的专业矢量图形设计软件,适合在 Mac 上制作标志、图标、插画、包装、信息图及印刷版面。它以路径和锚点构建可无损缩放的图形,并提供钢笔、形状、文字、图像描摹、渐变、画板及生成式功能。

Adobe InDesign 是面向印刷品与数字出版物的专业版面设计软件,可在 Mac 上制作书籍、杂志、宣传册、海报、报告及交互式文档。它提供精细的文字样式、网格、母版、长文档管理和印前输出能力。

Adobe Lightroom Classic 是面向桌面摄影工作流的照片管理与后期处理软件,可将原始照片保存在本地硬盘,通过目录、关键词、评分和收藏夹高效整理图库,并提供 RAW 冲印、蒙版、镜头校正、批量同步及多格式导出等功能。

Adobe Media Encoder 是 Adobe 推出的专业音视频编码与转码工具,可通过队列、预设和监视文件夹批量完成格式转换、代理文件创建及多平台成片输出,并与 Premiere Pro、After Effects 等软件紧密协作。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理软件,提供图层、蒙版、选区、修复、调色、文字排版、智能对象及生成式编辑等能力。Mac 版支持 Intel 与 Apple Silicon 处理器。

Adobe Premiere Pro 是面向专业视频制作的非线性剪辑软件,提供多轨时间线、调色、音频处理、字幕、代理工作流和多格式输出能力,并可与 After Effects、Audition、Photoshop 及 Frame.io 协同

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理工具,可在 Windows 上完成照片修饰、选区抠图、图层合成、文字排版、绘画及生成式编辑。软件采用订阅授权,由 Creative Cloud 管理安装、更新与许

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。

Adobe Bridge 是 Adobe 推出的创意资产管理工具,可集中预览、分类和查找照片、视频、PDF及多种设计文件,并支持元数据、关键词、评级、批量重命名和格式导出。它可与 Photoshop、Illustrator 等应用衔接,

Adobe Lightroom Classic 是面向 Windows 桌面摄影工作流的照片管理与无损编辑工具,可通过目录集中整理大型图库,并完成 RAW 显影、局部蒙版、批量调整、打印和多格式导出。它强调本地文件管理与精细控制,

Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,

Adobe After Effects 是面向动态图形、动画与影视视觉特效制作的专业工具,可完成关键帧动画、图层合成、遮罩跟踪、抠像、文字动画和二维三维元素整合。Windows 版通过 Adobe Creative Cloud 安装及更新,

Adobe Media Encoder 是 Adobe 面向视频与音频制作流程提供的专业编码和转码工具,可批量处理媒体文件、创建代理、套用输出预设并监控文件夹自动执行任务。它与 Premiere、After Effects、Audition