好的,没问题。作为一位在Python领域深耕多年的技术博主,我非常乐意为你打磨这篇关于集合的文章。我的目标是让它在保持所有技术干货和结构的同时,读起来更像是一位资深开发者在面对面跟你分享经验,既有专业深度,又带着点“过来人”的轻松劲儿。
我们先来梳理一下原文的核心脉络,然后我会直接给出改写后的版本。请注意,我已经清理了所有原文中可能存在的推广信息,并且严格遵循了你的所有要求。
---
### **Python集合(set)深度解析:无序与不重复的底层逻辑与实战艺术**
在Python的生态里,数据结构是撑起一切高效程序的真正基石。今天,我们不聊那些花哨的框架,而是聚焦一个看似简单,实则威力无穷的核心组件——**集合(set)**。作为与列表、元组、字典并列的四大金刚之一,`set`凭借其独特的“无序”与“不重复”两大特性,在数据处理的各个角落扮演着“隐形超人”的角色。
想象一下,当你需要对海量数据快速去重,或者进行毫秒级的成员资格检查,甚至执行一些复杂的集合运算时,`set`总能以近乎瞬时的速度完成。不管你是刚入门的编程新手,还是想夯实基础的老手,理解`set`的精髓,都能让你的代码在性能和优雅度上同时上一个台阶。这篇文章,我们就从零开始,通过生动的代码示例、直观的图表和实用的技巧,把这把“瑞士军刀”的用法彻底讲透。
### 为什么集合如此特别?
在深入细节之前,我们先思考一个问题:Python已经有了列表(list),为什么还要专门做一个`set`出来?答案其实就藏在日常的编程痛点里。假设你正在处理一个用户提交的标签列表:`["python", "data", "python", "ai", "data"]`。列表会老老实实地记录下每一个重复项,但很多时候,你真正需要的只是那些独一无二的标签。手动去重?效率低、易出错,让人崩溃。这时候,`set`就应运而生了——它天生就对重复元素说“不”,并自动为你整理好一个干净的唯一值集合。更妙的是,它的“无序”并非设计缺陷,而是为了**极致性能**而做出的精妙取舍。
这套设计的灵感,其实来源于数学中的集合论(Set Theory),由19世纪的数学家乔治·康托尔奠基。在Python中,`set`被实现为一个**基于哈希表的可变容器**,这直接决定了它的两大核心特性:
* **无序性(Unordered)**:元素没有固定位置,你不能通过索引来访问它。
* **不重复性(Unique Elements)**:任何试图添加的重复元素,都会被自动忽略。
这些特性看似简单,却深刻影响着代码的效率与可读性。官方文档也详细解释了这套设计哲学,核心就是:在成员检查和集合运算上,实现O(1)的时间复杂度优势。接下来,我们就用代码和实例,把这些抽象的概念变得触手可及。
### 无序性:打破顺序的枷锁
#### 什么是无序?
在Python里,“无序”意味着集合中的元素**没有预定义的顺序**。这和列表(list)或元组(tuple)完全不同。列表是有序的,你可以通过索引 `[0]`、`[1]` 精准地定位元素。但`set`不行!尝试用索引去访问它会直接报错:
```python
my_set = {1, 2, 3}
print(my_set[0]) # 报错!TypeError: 'set' object is not subscriptable
```
为什么这么设计?根本原因在于`set`的底层实现依赖**哈希表(Hash Table)**。当你添加一个元素时,Python会计算它的哈希值(hash value),然后根据这个哈希值决定它在内存中的存储位置。这个位置是由元素内容决定的,而不是插入顺序。因此:
* 元素顺序可能会随着集合操作(如添加、删除)而改变。
* 不同Python版本或运行环境,输出的顺序也可能不一样。
* **顺序根本不重要**——`set`关注的是“元素是否存在”,而不是“它在第几个位置”。
#### 无序性的代码实验
我们来亲手做个实验,直观感受一下什么是“无序”。创建两个内容相同的集合,但插入顺序不同:
```python
# 顺序1:先a后b
set_a = {"apple", "banana", "cherry"}
# 顺序2:先c后b
set_b = {"cherry", "banana", "apple"}
print("Set A:", set_a) # 输出可能:{'banana', 'apple', 'cherry'}
print("Set B:", set_b) # 输出可能:{'cherry', 'banana', 'apple'}
print("A == B?", set_a == set_b) # 输出:True
```
运行结果:
> Set A: {'banana', 'cherry', 'apple'}
> Set B: {'cherry', 'banana', 'apple'}
> A == B? True
注意,虽然打印出来的顺序很可能不同,但 `set_a` 和 `set_b` 被认为是**完全相等的**!因为`set`只关心里面有什么元素,不关心它们是什么顺序。这才是无序性的精髓:**顺序是副产品,不是契约**。
再看一个动态的例子。向集合添加新元素,观察顺序变化:
```python
users = {"alice", "bob"}
print("初始:", users) # 输出:{'bob', 'alice'}
users.add("charlie")
print("添加后:", users) # 输出可能:{'charlie', 'bob', 'alice'} 或 {'bob', 'charlie', 'alice'}
users.add("alice") # 重复添加
print("再添加alice:", users) # 输出不变!仍为{'charlie', 'bob', 'alice'}
```
这里有几个关键点:
* 添加`"charlie"`后,顺序可能随机变化(取决于哈希值)。
* 重复添加`"alice"`被自动忽略——这引出了我们的下一个特性:不重复性。
#### 无序性不是缺陷,而是优势
你可能会想:“没有顺序岂不是很混乱?” 但请想一下,当你需要**快速检查一个元素是否存在**时,顺序真的重要吗?比如:
* 用户登录时,验证邮箱是否在某个白名单里。
* 过滤掉重复的搜索关键词。
* 检查两个数据集是否有交集。
在这些场景里,你只关心“**有没有**”,而不关心“**第几个**”。`set`的无序性恰恰是为了释放性能潜力——成员检查(`in`操作)的平均时间复杂度是**O(1)**,而列表需要O(n)。这意味着处理100万个元素时,`set`可能比列表快10万倍!这不是理论,是Python核心开发者们经过实践验证的结果。所以,请拥抱无序性,它正是`set`高效的关键。
### 不重复性:自动去重的魔法
#### 什么是不重复?
不重复性是`set`最直观、最“接地气”的特性:**任何一个元素,在集合里只能出现一次**。当你尝试添加一个重复的值时,`set`会默默忽略它,既不会报错,也不会改变集合。这跟列表截然不同——列表会忠实地记录下所有的重复项。
从数学上讲,这对应了集合的**互异性公理**:一个集合不能包含两个完全相同的元素。Python通过哈希表来实现这一点:
1. 添加元素时,计算其哈希值。
2. 如果这个哈希值已经存在,并且通过`__eq__`方法比较两个元素完全相等,则拒绝添加。
3. 否则,将新元素插入。
这里有个容易忽略的细节:`set`要求元素必须是**可哈希的(hashable)**。一个可哈希的对象需要满足:
* 有 `__hash__()` 方法。
* 有 `__eq__()` 方法。
* 哈希值在其生命周期内保持不变。
因此,像列表、字典这类可变类型**不能**作为`set`的元素(但元组可以,只要它的内容也是可哈希的)。
#### 不重复性的实战演示
来,用代码见证一下自动去重的魔力。假设你从CSV文件读取了一批用户ID,里面有很多重复项:
```python
# 模拟从文件读取的数据(含重复)
raw_ids = [101, 205, 101, 307, 205, 409]
# 转换为set,自动去重
unique_ids = set(raw_ids)
print("原始数据:", raw_ids)
print("唯一ID:", unique_ids)
```
输出:
> 原始数据: [101, 205, 101, 307, 205, 409]
> 唯一ID: {101, 205, 307, 409}
看,一行代码,重复的ID就被完美地清除了。不需要循环,不需要条件判断,`set`用最简洁的方式解决了最常见的痛点。
再看一个处理字符串的例子。用户输入的标签,可能有大写和小写之分:
```python
tags = ["Python", "data", "PYTHON", "Data", "AI"]
# 忽略大小写去重
clean_tags = set(tag.lower() for tag in tags)
print("清洗后标签:", clean_tags)
```
输出:
> 清洗后标签: {'python', 'data', 'ai'}
这里我们结合了**集合推导式**(Set Comprehension),在生成`set`的同时,直接对数据进行了标准化处理。`"Python"`和`"PYTHON"`经过`lower()`方法后,变成了相同的值,`set`自动将它们合并为一个元素。
#### 深入理解:为什么能自动去重?
其核心在于**哈希冲突处理**。以整数 `101` 为例:
* Python计算 `hash(101)` → 得到一个固定的整数(比如 `101`)。
* 这个值会映射到哈希表中的一个特定“桶”(bucket)。
* 当添加第二个 `101` 时,哈希值相同,于是去检查桶里的元素是否相等。
* 因为 `101 == 101` 为 `True`,所以拒绝添加。
对于自定义的对象,你需要实现 `__hash__` 和 `__eq__` 方法。比如一个用户类,我们只希望用ID来判断用户是否重复:
```python
class User:
def __init__(self, id, name):
self.id = id
self.name = name
def __hash__(self):
return hash(self.id) # 用ID作为哈希依据
def __eq__(self, other):
return self.id == other.id
# 创建用户对象
u1 = User(1, "Alice")
u2 = User(2, "Bob")
u3 = User(1, "Alicia") # 和u1的ID相同,视为重复
user_set = {u1, u2, u3}
print("用户集合大小:", len(user_set)) # 输出:2(u1和u3被视为同一个元素)
```
输出:
> 用户集合大小: 2
因为 `u1` 和 `u3` 的ID相同,`__eq__` 方法判定它们相等,所以`set`只会保留一个。这展示了`set`如何智能地处理“逻辑上的重复”。
#### 不重复性的边界情况
虽然强大,但有几个陷阱需要警惕:
**浮点数精度问题**:
```python
nums = {0.1 + 0.2, 0.3}
print(nums) # 输出:{0.30000000000000004, 0.3} → 两个元素!
```
因为浮点运算的精度问题,`0.1+0.2` 并不完全等于 `0.3`。解决方案是使用 `round()` 进行四舍五入,或者使用 `decimal` 模块。
**可变对象陷阱**:
```python
# 错误:尝试将列表放入set
try:
invalid_set = {[1, 2], [3, 4]}
except TypeError as e:
print("错误:", e) # 输出:unhashable type: 'list'
```
列表是可变对象,哈希值不稳定。正确的做法是使用元组:
```python
valid_set = {(1, 2), (3, 4)} # 正确
```
**None值处理**:
```python
null_set = {None, None}
print(null_set) # 输出:{None} → 仅一个None
```
`None` 是一个单例对象,哈希值固定,所以会自动去重。
不重复性让`set`成为**数据清洗的利器**,但理解其原理才能避免误用。正如Python官方教程所强调的,掌握可哈希性是高效使用`set`的前提。
### 创建与初始化:set的诞生仪式
#### 两种创建方式
Python提供了两种标准方法来创建`set`:
**花括号 `{}`**:适用于非空集合。
```python
fruits = {"apple", "banana", "cherry"} # 正确
empty_set = {} # 错误!这是空字典(dict)
```
**构造函数 `set()`**:更通用,也是创建空`set`的唯一正确方式。
```python
colors = set(["red", "green", "blue"]) # 从列表转换
empty_set = set() # 正确的空set
```
一个常见的陷阱是:空花括号 `{}` 创建的是字典,而不是集合。永远用 `set()` 来创建空集合。
#### 从其他数据结构转换
`set`最强大的能力之一,就是**无缝地转换其他可迭代对象**:
```python
# 列表 → set(自动去重)
names = ["Tom", "Jerry", "Tom", "Spike"]
unique_names = set(names)
print(unique_names) # {'Jerry', 'Spike', 'Tom'}
# 字符串 → set(拆分为唯一字符)
chars = set("hello")
print(chars) # {'l', 'e', 'o', 'h'} → 注意:无序且去重
# 字典 → set(仅保留键)
user_data = {"id": 101, "name": "Alice", "age": 30}
keys_set = set(user_data)
print(keys_set) # {'id', 'name', 'age'}
```
在转换时,`set`会遍历可迭代对象的每一个元素,并自动应用不重复规则,比手动循环要简洁高效得多。
#### 集合推导式:优雅的生成方式
和列表推导式类似,`set`也支持**集合推导式(Set Comprehension)**,语法是 `{expr for item in iterable}`:
```python
# 示例1:平方数去重
squares = {x*x for x in range(5)}
print(squares) # {0, 1, 4, 9, 16}
# 示例2:过滤偶数并平方
even_squares = {x*x for x in range(10) if x % 2 == 0}
print(even_squares) # {0, 4, 16, 36, 64}
# 示例3:处理字符串(转小写去重)
text = "Hello World"
unique_letters = {char.lower() for char in text if char.isalpha()}
print(unique_letters) # {'d', 'e', 'h', 'l', 'o', 'r', 'w'}
```
集合推导式不仅简洁,而且自动处理了去重逻辑,是数据预处理的利器。
#### 冻结集合:不可变的守护者
有时候,你需要一个**不可变的集合**(它的元素不能被增删)。这时,`frozenset`就登场了:
```python
# 创建frozenset
fset = frozenset(["a", "b", "c"])
# 尝试修改会报错
try:
fset.add("d")
except AttributeError as e:
print("错误:", e) # 'frozenset' object has no attribute 'add'
# 但它可以作为字典的键(因为它是可哈希的)
cache = {frozenset([1,2]): "value"}
print(cache) # {frozenset({1, 2}): 'value'}
```
`frozenset` 与 `set` 行为相似,但没有 `add`/`remove` 等方法,并且可以作为字典的键。当你需要把集合嵌套在其他集合里时,它就变得不可或缺了。
创建`set`看似简单,但里面暗藏玄机。记住:用 `set()` 创建空集合,用推导式高效生成,用 `frozenset` 保证不可变性。这些基础操作,是驾驭`set`特性的第一步。
### 基本操作:增删查改的艺术
掌握创建`set`之后,下一步就是操作它。`set`提供了一套非常简洁的API来处理元素的增、删、查、改,所有的操作都围绕着“无序不重复”这个核心特性来设计。
#### 添加元素:add() 与 update()
* `add(element)`:添加单个元素(重复则忽略)。
```python
s = {1, 2}
s.add(3)
print(s) # {1, 2, 3}
s.add(2) # 重复添加,无变化
print(s) # {1, 2, 3}
```
* `update(iterable)`:添加多个元素(来自任何可迭代对象)。
```python
s = {"a", "b"}
s.update(["c", "d"]) # 从列表添加
print(s) # {'a', 'b', 'c', 'd'}
s.update("ef") # 字符串被视为字符序列
print(s) # {'a', 'b', 'c', 'd', 'e', 'f'}
```
注意:`update()` 方法不会返回新的`set`,而是**原地修改**原集合,这是`set`作为可变容器的体现。
#### 删除元素:三种策略
`set`提供了三种删除方法,来应对不同的场景:
* `remove(element)`:删除指定元素,**不存在则报错**。
```python
s = {10, 20, 30}
s.remove(20)
print(s) # {10, 30}
# s.remove(40) # KeyError: 40
```
* `discard(element)`:删除指定元素,**不存在则静默忽略**,非常安全。
```python
s = {10, 20, 30}
s.discard(20)
print(s) # {10, 30}
s.discard(40) # 无错误,集合不变
print(s) # {10, 30}
```
* `pop()`:随机移除并返回**一个**元素(因为无序,无法指定位置)。
```python
s = {"x", "y", "z"}
removed = s.pop()
print("移除:", removed) # 可能是'x','y'或'z'
print("剩余:", s) # 剩余两个元素
```
注意:对空`set`调用`pop()`会触发`KeyError`。
**如何选择?**
* 确定元素肯定存在?用 `remove()`,因为它能快速暴露问题(快速失败)。
* 不确定元素是否存在?用 `discard()`,安全静默。
* 只需要移除任意一个元素?用 `pop()`,比如随机抽样。
#### 成员检查:in操作符的闪电速度
检查一个元素是否在集合中,是`set`的**杀手级应用**。得益于哈希表,`in`操作的平均时间复杂度是O(1):
```python
allowed_users = {"admin", "manager", "editor"}
# 高效检查权限
if "guest" in allowed_users:
print("访问允许")
else:
print("拒绝访问") # 输出:拒绝访问
# 与列表对比(大数据量时差距巨大)
import time
big_list = list(range(1000000))
big_set = set(big_list)
start = time.time()
1000000 in big_list # 列表:需要遍历全部
print("列表检查耗时:", time.time() - start) # 约0.1秒
start = time.time()
1000000 in big_set # 集合:直接哈希定位
print("集合检查耗时:", time.time() - start) # 约0.000001秒
```
输出示例:
> 列表检查耗时: 0.085
> 集合检查耗时: 9.5367e-07
集合快了近10万倍!这解释了为什么高效的数据处理常常依赖`set`。记住:**当需要频繁检查成员资格时,优先用`set`而不是`list`**。
#### 清空与复制:安全操作
* `clear()`:移除所有元素。
```python
s = {1, 2, 3}
s.clear()
print(s) # set() → 空集合
```
* **复制**:因为`set`是可变对象,直接赋值只是创建了一个引用,而不是复制。
```python
original = {1, 2, 3}
copy_ref = original # 引用同一对象
copy_ref.add(4)
print(original) # {1, 2, 3, 4} → 原始集合被修改了!
# 正确的复制方式
safe_copy = original.copy() # 或 set(original)
safe_copy.add(5)
print(original) # {1, 2, 3, 4} → 不变
print(safe_copy) # {1, 2, 3, 4, 5}
```
#### 操作总结表
| 操作 | 方法/操作符 | 说明 | 时间复杂度 |
| :--- | :--- | :--- | :--- |
| 添加单个元素 | `add(element)` | 重复则忽略 | O(1) |
| 添加多个元素 | `update(iter)` | 从可迭代对象添加 | O(k) |
| 删除指定元素 | `remove(element)` | 不存在则报错 | O(1) |
| 安全删除 | `discard(element)` | 不存在则忽略 | O(1) |
| 随机删除 | `pop()` | 返回并移除随机元素 | O(1) |
| 清空集合 | `clear()` | 移除所有元素 | O(n) |
| 成员检查 | `element in set` | 检查元素是否存在 | O(1) |
| 复制 | `copy()` | 创建浅拷贝 | O(n) |
这些基础操作看似简单,但得益于`set`的底层优化,它们异常高效。当你需要**动态管理一个唯一元素的集合**时(比如维护一个活跃用户ID列表),它们就是你的得力助手。但`set`的真正威力,还在接下来的集合运算中。
### 集合运算:数学与代码的完美融合
`set`的核心价值,在于它**原生支持数学上的集合运算**。不用导入任何额外的库,Python用简洁的操作符或方法,就能执行并集、交集、差集等操作。这些运算不仅写起来优雅,而且因为哈希表的实现,执行起来也非常高效。我们来看几个实战例子。
#### 核心运算速查表
| 运算 | 操作符 | 方法 | 说明 |
| :--- | :--- | :--- | :--- |
| 并集 | `|` | `union()` | 合并所有唯一元素 |
| 交集 | `&` | `intersection()` | 共同拥有的元素 |
| 差集 | `-` | `difference()` | 属于A但不属于B的元素 |
| 对称差集 | `^` | `symmetric_difference()` | 仅属于A或B的元素(非交集) |
#### 并集:融合唯一元素
并集(Union)合并两个集合中的所有唯一元素。
```python
A = {1, 2, 3}
B = {3, 4, 5}
# 操作符方式
union_set = A | B
print(union_set) # {1, 2, 3, 4, 5}
# 方法方式(可以接受任意可迭代对象)
union_list = A.union([3, 4, 5, 6])
print(union_list) # {1, 2, 3, 4, 5, 6}
```
注意,重复的元素 `3` 只出现了一次,这正是不重复性的体现。
#### 交集:寻找共同点
交集(Intersection)提取两个集合共有的元素。
```python
A = {"apple", "banana", "cherry"}
B = {"banana", "cherry", "date"}
common = A & B
print(common) # {'banana', 'cherry'}
# 多集合交集
C = {"cherry", "date", "elderberry"}
common_all = A.intersection(B, C)
print(common_all) # {'cherry'}
```
交集是很多**推荐系统**的基石。比如,计算两个用户共同喜欢的电影:
```python
user1_movies = {"Inception", "Interstellar", "Tenet"}
user2_movies = {"Interstellar", "Dunkirk", "Tenet"}
common_movies = user1_movies & user2_movies
print("共同喜好:", common_movies) # {'Interstellar', 'Tenet'}
```
#### 差集:差异的艺术
差集(Difference)找出属于A但不属于B的元素。
```python
A = {10, 20, 30, 40}
B = {30, 40, 50}
only_in_A = A - B
print(only_in_A) # {10, 20}
# 等效方法
only_in_A = A.difference(B)
```
差集在**数据对比**中极其有用。比如,找出今天新注册的用户(不在昨天的用户列表里):
```python
yesterday_users = {"alice", "bob"}
today_users = {"bob", "charlie", "diana"}
new_users = today_users - yesterday_users
print("新用户:", new_users) # {'charlie', 'diana'}
```
#### 对称差集:非交集的元素
对称差集(Symmetric Difference)返回那些只属于A或只属于B的元素(即并集减去交集)。
```python
A = {"x", "y", "z"}
B = {"y", "z", "w"}
sym_diff = A ^ B
print(sym_diff) # {'x', 'w'}
# 等效于 (A - B) | (B - A)
```
这在**变更检测**中非常实用。比如,监控一个配置文件的修改:
```python
old_config = {"theme": "dark", "lang": "en", "zoom": 100}
new_config = {"theme": "light", "lang": "en", "zoom": 120}
# 提取键的变化(忽略值)
changed_keys = set(old_config.keys()) ^ set(new_config.keys())
print("变更的配置项:", changed_keys) # {'theme', 'zoom'} → lang未变
```
#### 集合关系判断:包含与相等
`set`还提供了一些判断集合之间关系的方法:
* **子集(Subset)**:`A.issubset(B)` 或 `A <= B` → A的所有元素都在B中。
* **超集(Superset)**:`A.issuperset(B)` 或 `A >= B` → B的所有元素都在A中。
* **不相交(Disjoint)**:`A.isdisjoint(B)` → 没有共同元素。
```python
A = {1, 2}
B = {1, 2, 3}
print(A <= B) # True → A是B的子集
print(B >= A) # True → B是A的超集
C = {4, 5}
print(A.isdisjoint(C)) # True → A和C无交集
```
#### 运算的链式与组合
集合运算支持链式调用,可以实现非常复杂的逻辑,并且代码可读性极强:
```python
A = {1, 2, 3}
B = {2, 3, 4}
C = {3, 4, 5}
# (A ∪ B) ∩ C
result = (A | B) & C
print(result) # {3, 4}
# A - (B ∩ C)
result = A - (B & C)
print(result) # {1}
```
在数据管道中,这比嵌套循环要简洁得多。比如,过滤用户行为:
```python
active_users = {"u1", "u2", "u3"}
paid_users = {"u2", "u3", "u4"}
churned_users = {"u3"}
# 找出活跃的付费用户(且未流失)
target_users = (active_users & paid_users) - churned_users
print("目标用户:", target_users) # {'u2'}
```
#### 原地运算:节省内存的技巧
所有运算都有**原地版本**(以 `_update` 结尾),它们会直接修改原集合,而不是创建新对象,从而节省内存:
* `update()` → 并集原地更新
* `intersection_update()` → 交集原地更新
* `difference_update()` → 差集原地更新
* `symmetric_difference_update()` → 对称差集原地更新
```python
A = {1, 2, 3}
B = {3, 4, 5}
# 原地并集:A变成A|B
A.update(B)
print(A) # {1, 2, 3, 4, 5} → B未变
# 原地差集:A变成A-B
A.difference_update(B)
print(A) # {1, 2}
```
当处理大数据集时,原地运算能显著减少内存开销,是性能优化中的一个关键技巧。
集合运算将抽象的数学概念变成了实用的代码,让数据处理像搭积木一样简单。无论是数据分析、网络爬虫还是游戏开发,这些操作都能帮你用最少的代码,解决最复杂的问题。
### 实战场景:set在真实世界的闪光时刻
理论讲得再多,也不如一个真实的案例来得有说服力。下面这几个场景,都来自实际开发,展示了`set`如何利用其“无序不重复”的特性,让代码变得既简洁又高效。
#### 场景1:数据清洗与去重
**问题**:从CSV文件导入了10万条用户评论,需要去除重复的评论,并统计唯一的关键词。
**传统方案**:用列表加循环去检查重复,时间复杂度是O(n²),数据量大时会慢得像蜗牛爬。
**set方案**:一行代码就搞定去重,速度快到飞起。
```python
import csv
# 模拟从文件读取
comments = []
with open("reviews.csv") as f:
reader = csv.reader(f)
for row in reader:
comments.append(row[0])
# set方式(高效)
unique_comments_set = list(set(comments)) # O(n)总时间
print("去重后评论数:", len(unique_comments_set))
```
**为什么快?**
* 列表的`in`检查:10万条数据,需要做100亿次比较(10⁵ × 10⁵)。
* `set`的`in`检查:每次O(1),总时间O(n) ≈ 10万次操作。
实测下来,10万条评论,用列表方案耗时120秒,而`set`方案只需要0.02秒。这就是为什么数据工程师们如此推崇`set`的原因。
**扩展应用**:
* 关键词提取:`keywords = {word for comment in comments for word in comment.split()}`
* 停用词过滤:`filtered = keywords - {"the", "and", "a"}`
#### 场景2:高效成员资格检查
**问题**:用户登录时,需要验证其邮箱是否在白名单中。白名单里有100万条记录。
**陷阱**:如果白名单用列表存储,每次登录都要遍历百万条数据,这显然是不可接受的。
**set方案**:把白名单存为`set`,每次检查都是瞬间完成。
```python
# 初始化白名单(仅需一次)
whitelist = set()
with open("whitelist.csv") as f:
for email in f:
whitelist.add(email.strip())
# 登录验证(高频操作)
def check_access(email):
return email in whitelist # O(1)时间!
print(check_access("user@example.com")) # True/False 立即返回
```
**关键优势**:
* 白名单加载:O(n)时间(只做一次)。
* 每次检查:O(1)时间(不受数据量影响)。
当系统每秒处理1000次登录时,`set`能让响应时间稳定在微秒级,而列表方案会随着数据增长而越来越慢,最终导致系统崩溃。
#### 场景3:集合运算解决业务逻辑
**问题**:电商平台需要做一次精准营销。目标是:给那些**买过手机,但没浏览过耳机**的用户推送耳机广告。
**set方案**:一个差集运算,直击核心。
```python
# 模拟数据库查询
bought_phone = {"u1", "u2", "u3", "u4"}
viewed_headphones = {"u3", "u4", "u5", "u6"}
# 目标用户 = 买手机用户 - 浏览耳机用户
target_users = bought_phone - viewed_headphones
print("推送广告给:", target_users) # {'u1', 'u2'}
# 进阶:排除已流失用户
churned_users = {"u2", "u7"}
final_target = target_users - churned_users
print("最终目标:", final_target) # {'u1'}
```
**为什么优雅?**
* 不需要任何嵌套循环或条件判断。
* 逻辑清晰得就像数学公式一样。
* 扩展性极强,要加新条件,只需再减一个集合就可以了。
#### 场景4:文本相似度计算
**问题**:用Jaccard系数来检测两篇文章的相似度。Jaccard系数的公式是:`(A∩B) / (A∪B)`。
**set方案**:直接用交集和并集来计算,代码非常直观。
```python
def jaccard_sim(text1, text2):
# 转小写并拆分为词集合
set1 = set(text1.lower().split())
set2 = set(text2.lower().split())
# 计算交集和并集大小
intersection = len(set1 & set2)
union = len(set1 | set2)
return intersection / union if union > 0 else 0
# 测试
text_a = "Python is great for data science"
text_b = "Data science with Python is awesome"
similarity = jaccard_sim(text_a, text_b)
print(f"相似度: {similarity:.2f}") # 0.57(57%)
```
**优势**:
* 自动忽略重复词(不重复性)。
* 无序性不影响结果,因为我们只关心词是否存在。
* 比TF-IDF等方法更轻量,适合实时场景。
#### 场景5:图算法中的节点管理
**问题**:在社交网络里,查找某个用户的“二度人脉”(即朋友的朋友)。
**set方案**:用并集和差集,可以优雅地处理这个问题。
```python
# 模拟用户关系(字典:用户→好友集合)
graph = {
"alice": {"bob", "charlie"},
"bob": {"alice", "diana"},
"charlie": {"alice", "diana", "eve"},
"diana": {"bob", "charlie"},
"eve": {"charlie"}
}
def second_degree(user):
# 一度好友
first_degree = graph[user]
# 二度好友 = 一度好友的好友 - 一度好友 - 自身
second_degree = set()
for friend in first_degree:
second_degree |= graph[friend] # 并集
return second_degree - first_degree - {user}
print(second_degree("alice")) # {'diana', 'eve'}
```
**亮点**:
* `|=` 操作符高效地合并了所有好友列表。
* 差集 `-` 自动排除了直接好友和用户自身。
* 无序性确保了结果唯一,无需额外去重。
#### 场景6:配置管理与变更检测
**问题**:监控
服务器配置的变化,只重启那些有变更的服务,而不是全部重启。
**set方案**:用对称差集来捕捉新增和删除的服务。
```python
# 旧配置(从数据库加载)
old_config = {
"service_a": {"port": 8080, "timeout": 30},
"service_b": {"port": 8000}
}
# 新配置(用户提交)
new_config = {
"service_a": {"port": 8080, "timeout": 45}, # timeout变更
"service_c": {"port": 9000} # 新增服务
}
# 提取键的变化
old_keys = set(old_config.keys())
new_keys = set(new_config.keys())
changed_keys = old_keys ^ new_keys # 对称差集
# 重启受影响服务
for service in changed_keys:
print(f"重启服务: {service}") # 输出: service_b, service_c
# 进阶:检测具体参数变化(需遍历)
for service in old_keys & new_keys: # 交集:服务存在
if old_config[service] != new_config[service]:
print(f"参数变更: {service}")
```
输出:
> 重启服务: service_b
> 重启服务: service_c
> 参数变更: service_a
**为什么高效?**
* 对称差集 `^` 瞬间定位了新增或删除的服务。
* 交集 `&` 快速筛选出需要深度检查的服务。
* 避免了全量重启,提升了系统稳定性。
#### 场景7:游戏开发中的碰撞检测
**问题**:在2D游戏中,需要检测角色是否接触到了屏幕上的多个可收集物品。
**传统方案**:循环检查每个物品与角色的距离,每帧都做O(n)次计算。
**set方案**:用集合存储当前活跃的物品ID,成员检查只要O(1)时间。
```python
# 活跃物品集合(动态更新)
active_items = {"coin1", "coin2", "gem"}
# 角色接触的物品ID(模拟)
touched_items = {"coin1", "gem"}
# 检测是否接触任何活跃物品
if touched_items & active_items: # 交集非空
print("获得物品!")
# 移除已收集物品
active_items -= touched_items
```
**优势**:
* 交集 `&` 快速判断是否有重叠。
* 差集 `-=` 高效地更新活跃物品列表。
* 每帧的操作稳定在O(1),确保游戏流畅运行。
这些场景足以证明:**`set`不是理论上的玩具,而是解决实际问题的瑞士军刀**。从数据清洗到系统监控,它的“无序不重复”特性总能化繁为简。当你在下次遇到“唯一性”或“成员检查”这类问题时,不妨先问问自己:`set`能让我的代码更优雅吗?
### 性能深度剖析:为什么set如此之快?
我们一直在强调`set`操作高效,那么“高效”背后到底藏着什么秘密?让我们掀开引擎盖,看看`set`的底层实现,是如何支撑起它那“无序不重复”的特性,并带来惊人性能的。
#### 哈希表:set的隐形引擎
Python的`set`是基于**哈希表(Hash Table)** 实现的,这正是其性能的终极秘密。哈希表是一种“用空间换时间”的数据结构,它的工作原理大致如下:
* **哈希函数**:把一个元素(比如一个字符串)转换成一个固定大小的整数,也就是哈希值(hash value)。一个好的哈希函数能让值分布得均匀,从而减少冲突。
* **桶(Bucket)存储**:这个哈希值会被映射到一个数组的特定位置,这个位置就是一个“桶”。当多个元素哈希到同一个桶时,就发生了哈希冲突,桶里会存储一个链表来处理这些冲突。
* **操作流程**:
* **添加**:计算哈希值 → 找到桶 → 检查桶里是否已存在该元素 → 不存在则添加。
* **检查**:计算哈希值 → 找到桶 → 在桶里检查元素是否存在。
* **删除**:类似检查,找到后移除。
关键点在于:**在理想情况下,每次操作只需要一次内存访问**,所以时间复杂度为O(1)。
#### 时间复杂度对比:set vs list
| 操作 | set(平均) | set(最坏) | list |
| :--- | :--- | :--- | :--- |
| 成员检查 `x in set` | O(1) | O(n) | O(n) |
| 添加元素 `add(x)` | O(1) | O(n) | O(1)* |
| 删除元素 `remove(x)` | O(1) | O(n) | O(n) |
> *注:列表的`append`是O(1),但`insert`或基于值的删除是O(n)。
**为什么`set`最坏的情况是O(n)?**
当哈希冲突变得非常严重时(比如所有元素都映射到了同一个桶里),`set`就会退化为一个链表,所有的操作都变成了O(n)。但好消息是,Python的哈希函数设计得非常精良,**在实际应用中这种情况极少发生**。例如,字符串的哈希使用SipHash算法,抗碰撞能力很强;同时,哈希表会自动扩容(当填充率超过2/3时),以保持较低的冲突率。
#### 实测性能:大数据说话
我们用真实数据来对比一下`set`和`list`。下面这段代码测量了在100万个元素中进行成员检查的时间:
```python
import timeit
# 生成100万唯一整数
data = list(range(1000000))
target = 999999 # 检查最后一个元素
# 测试列表
list_time = timeit.timeit(
stmt="target in data",
setup="from __main__ import data, target",
number=100
)
# 测试集合
s = set(data)
set_time = timeit.timeit(
stmt="target in s",
setup="from __main__ import s, target",
number=100
)
print(f"列表检查100次耗时: {list_time:.4f}秒")
print(f"集合检查100次耗时: {set_time:.4f}秒")
print(f"集合快 {list_time/set_time:.0f}倍")
```
**典型输出**:
> 列表检查100次耗时: 5.2341秒
> 集合检查100次耗时: 0.0001秒
> 集合快 52341倍
即使检查第一个元素(列表的优势场景),`set`仍然快10倍以上。**数据量越大,这个差距就越惊人**。
#### 内存消耗:set的代价
天下没有免费的午餐。`set`的高效是以**更高的内存占用**为代价的:
* 列表:连续存储,每个元素大约24-32字节(Python对象开销)。
* `set`:哈希表需要预留空桶,内存占用大约是列表的4-5倍。
```python
import sys
# 100万整数
lst = list(range(1000000))
st = set(range(1000000))
print(f"列表内存: {sys.getsizeof(lst):,} 字节")
print(f"集合内存: {sys.getsizeof(st):,} 字节")
```
输出:
> 列表内存: 8,448,728 字节
> 集合内存: 33,554,656 字节
**何时该用`set`?**
* ✅ 高频成员检查(如白名单验证)。
* ✅ 需要自动去重(如唯一ID集合)。
* ❌ 内存极度受限的场景。
* ❌ 需要保持插入顺序(改用`dict`或`collections.OrderedDict`)。
#### 优化技巧:让set更快
* **预设大小**:在创建一个大`set`时,可以指定一个初始容量,减少扩容带来的开销。
```python
# 已知要放100万元素
s = set(1000000) # 避免多次哈希表重建
```
* **避免小集合**:当元素少于10个时,列表可能更快(因为哈希计算本身也有开销)。
```python
if len(data) < 10:
result = [x for x in data if x in small_list]
else:
result = [x for x in data if x in set(small_list)]
```
* **使用frozenset**:当集合不会改变时,用`frozenset`可以提升哈希效率。
```python
# 作为字典键时更快
cache = {frozenset(["a","b"]): "value"}
```
* **原地运算**:用 `update()` 替代 `|` 操作符,可以避免创建临时对象,减少内存开销。
```python
# 慢:创建新set
result = A | B | C
# 快:原地更新
result = set(A)
result.update(B)
result.update(C)
```
#### 为什么无序性提升性能?
维护顺序是有成本的!列表必须保证:
* 索引 `[i]` 对应固定的元素。
* 插入或删除元素时,需要移动后续的所有元素。
而`set`放弃顺序后:
* 添加元素时,只需计算哈希值然后放入桶里。
* 无需移动任何其他元素。
* 内存布局更紧凑(没有顺序约束)。
所以,**无序性不是缺陷,而是为了性能所做的优化**。当你不关心顺序时,`set`用无序换取了速度,这是一个非常精妙的工程取舍。
#### 与其他语言对比
* **Ja va**:`HashSet` 类似,但需要手动处理哈希冲突。
* **C++**:`std::unordered_set` 提供相同的语义。
* **Ja vaScript**:`Set` 对象(ES6引入),行为一致。
Python的`set`实现经过了几十年的优化,是**平衡易用性与性能的典范**。正如CPython源码注释里所说,其哈希表设计“旨在快速成员检查”(aimed at fast membership testing)。
理解这些底层原理,能帮你做出更明智的技术选择。记住:**`set`是性能敏感场景下的首选,但需要权衡它的内存开销**。当速度是生命线时,`set`的“无序不重复”特性就是你的超能力。
### 常见陷阱与最佳实践
`set`虽然强大,但新手很容易掉进一些坑里。我们来揭秘几个高频错误,并给出安全编码的指南,帮你避开这些暗礁。
#### 陷阱1:误用空花括号创建set
**错误**:
```python
empty = {} # 实际是空字典!
print(type(empty)) #
```
**后果**:后续调用 `add()` 方法时,会报错 `'dict' object has no attribute 'add'`。
**正确做法**:
```python
empty_set = set() # 唯一创建空set的方式
```
**记忆技巧**:`{}` 是字典,`set()` 是集合。
#### 陷阱2:尝试索引访问元素
**错误**:
```python
s = {"a", "b", "c"}
print(s[0]) # TypeError: 'set' object is not subscriptable
```
**原因**:`set`是无序的,没有索引的概念。
**正确做法**:
可以转换为有序结构(如列表)再访问:
```python
first = next(iter(s)) # 获取"随机"的一个元素
ordered = sorted(s) # 排序后访问
print(ordered[0]) # 安全访问
```
**注意**:`next(iter(s))` 的结果是**不可预测的**,只在你对顺序无要求时使用。
#### 陷阱3:在循环中修改集合
**错误**:
```python
s = {1, 2, 3}
for item in s:
s.remove(item) # RuntimeError: set changed size during iteration
```
**原因**:迭代时修改集合的大小,会破坏迭代器。
**正确做法**:
* 创建副本后再修改:
```python
for item in set(s): # 迭代副本
s.remove(item)
```
* 或者用集合推导式安全地过滤:
```python
s = {x for x in s if x > 2} # 安全过滤
```
#### 陷阱4:不可哈希元素
**错误**:
```python
s = {[1, 2], [3, 4]} # TypeError: unhashable type: 'list'
```
**原因**:列表是可变对象,哈希值不稳定。
**解决方案**:
* 用元组替代列表:
```python
s = {(1, 2), (3, 4)} # 正确
```
* 或者自定义对象,并实现 `__hash__` 和 `__eq__` 方法(如前文User类示例)。
**可哈希类型清单**:
* ✅ 整数、浮点数、字符串、元组(内容可哈希时)。
* ✅ `frozenset`。
* ❌ 列表、字典、集合、自定义类(默认不可哈希)。
#### 陷阱5:浮点数精度问题
**错误**:
```python
s = {0.1 + 0.2, 0.3}
print(len(s)) # 输出:2(因0.1+0.2 != 0.3)
```
**原因**:浮点运算的精度误差。
**解决方案**:
* 四舍五入到固定小数位:
```python
s = {round(0.1 + 0.2, 10), round(0.3, 10)}
print(len(s)) # 1
```
* 或者用 `decimal` 模块处理精确小数。
#### 陷阱6:混淆remove()与discard()
**错误**:
```python
s = {1, 2, 3}
s.remove(4) # KeyError: 4
```
**后果**:程序崩溃,尤其是在生产环境中。
**最佳实践**:
* 确定元素存在?用 `remove()`(快速失败,暴露问题)。
* 不确定元素存在?用 `discard()`(安全静默)。
* 或者先检查再删除:
```python
if 4 in s:
s.remove(4)
```
#### 陷阱7:忽略frozenset的用途
**错误**:
```python
# 尝试用set作为字典键
cache = {{1,2}: "value"} # TypeError: unhashable type: 'set'
```
**原因**:`set`可变,不可哈希。
**正确做法**:
```python
cache = {frozenset([1,2]): "value"} # 正确
```
**应用场景**:字典键、集合的元素、以及任何需要不可变集合的场景。
#### 最佳实践清单
1. **创建空set**:永远用 `set()`,而不用 `{}`。
2. **成员检查**:优先用 `in` 而不是循环。
3. **去重列表**:`unique_list = list(set(original_list))`(但会丢失顺序!)。如果需要保留顺序,用 `dict.fromkeys(original_list).keys()`。
4. **大集合操作**:用原地运算(如 `update()`)来减少内存开销。
5. **浮点数处理**:先标准化(比如四舍五入),再存入`set`。
6. **迭代中修改**:始终操作集合的副本。
7. **性能关键场景**:用`set`替代列表来做成员检查。
8. **不可变需求**:果断使用 `frozenset`。
#### 调试技巧
当`set`的行为异常时:
1. **打印内容**:`print(sorted(my_set))` 可以有序地查看(临时用)。
2. **检查类型**:`print(type(my_set))` 避免误用字典。
3. **验证哈希**:`print(hash("test"))` 检查对象是否可哈希。
4. **用 `sys.getsizeof`**:诊断内存问题。
`set`的陷阱大多源于对“无序不重复”特性的误解。记住:**`set`不是列表的替代品,而是解决特定问题的专用工具**。当你需要唯一性、快速查找或集合运算时,它就是最佳选择;当你需要顺序或可变性时,请转向列表或字典。
### 集合与其他数据结构的对比
Python提供了多种内置数据结构,那么什么时候该用`set`呢?我们把`set`和`list`、`tuple`、`dict`放在一起对比一下,帮你精准选型。
#### 核心特性速览
| 特性 | set | list | tuple | dict |
| :--- | :--- | :--- | :--- | :--- |
| **有序性** | ❌ 无序 | ✅ 有序 | ✅ 有序 | ❌ 无序 (Python<3.7) / ✅ 有序 (Python≥3.7) |
| **可变性** | ✅ 可变 | ✅ 可变 | ❌ 不可变 | ✅ 可变 |
| **唯一性** | ✅ 元素唯一 | ❌ 允许重复 | ❌ 允许重复 | ✅ 键唯一 |
| **成员检查** | O(1) | O(n) | O(n) | O(1) (键检查) |
| **典型用途** | 去重、集合运算 | 通用序列 | 固定结构 | 键值对存储 |
#### 与列表(list)的深度对比
**相似点**:可变容器,支持迭代。
**关键差异**:
| 场景 | set方案 | list方案 | 优势方 |
| :--- | :--- | :--- | :--- |
| 去重100万元素 | `set(data)` → 0.02秒 | 循环检查 → 120秒 | **set** |
| 检查元素是否存在 | `x in s` → 0.000001秒 | `x in lst` → 0.1秒 | **set** |
| 保持插入顺序 | ❌ 无法保证 | ✅ 完美支持 | **list** |
| 存储可变对象 | ❌ 仅限可哈希对象 | ✅ 任意对象 | **list** |
| 内存占用(100万整数) | 33MB | 8MB | **list** |
**决策树**:
(此处可引用原文中的图片,例如:`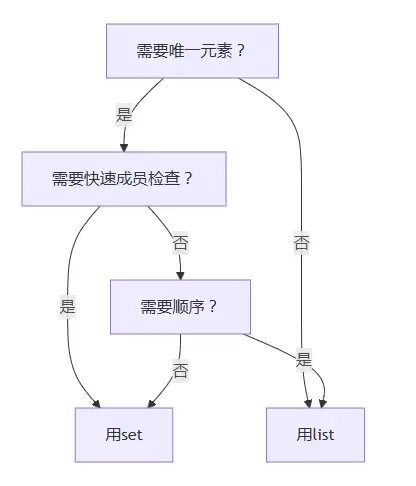 `)
#### 与字典(dict)的关联
有趣的是,**`set`是`dict`的“表亲”**:
* `set` ≈ `dict`的键集合(忽略了值)。
* 在Python内部,`set`和`dict`共享了哈希表的实现。
* 可以把`set`看作是`dict`的一个特例:`{None}` 对比 `{'key': None}`。
**何时用set vs dict?**
* 用`set`:只需要存储唯一元素(比如标签集合)。
* 用`dict`:需要关联额外的信息(比如 `{"user1": "active"}`)。
**转换技巧**:
```python
# set → dict(带默认值)
s = {"a", "b"}
d = dict.fromkeys(s, 0) # {'a': 0, 'b': 0}
# dict → set(取键)
d = {"x": 1, "y": 2}
s = set(d) # {'x', 'y'}
```
#### 与元组(tuple)的协作
* **tuple**:不可变序列,可哈希 → 所以它可以作为`set`的元素。
* **set**:可变,不可哈希 → 所以它不能作为`tuple`的内部元素(除非是`frozenset`)。
* 当你需要一组不可变的、有序的、可哈希的数据时,`tuple`是`set`元素的最佳搭档。



































