


Python自动化实现对多个Excel工作簿中的工作表进行分类汇总
针对多个Excel工作簿中结构统一的工作表,利用Python结合pandas和xlwings实现自动化分类汇总。脚本扫描文件夹,遍历每个工作簿内的所有工作表,读取数据后按指定字段分组汇总,结果写回原表右侧区域,并跳过临时文件和空表,有效提升办公效率。
1. 问题背景:文件夹里一堆报表,手工汇总真的很低效
这篇文章整理的是《超简单:用 Python 让 Excel 飞起来》第6章案例03:对多个工作簿中的工作表分别进行分类汇总。这个案例很典型,也很贴近真实办公场景:一个文件夹里有很多 Excel 文件,每个文件里又有多张工作表,领导希望你按“销售区域”汇总“销售利润”。
要是靠手动来做,流程无非是:开一个文件,切一张表,做一次汇总,复制结果,关掉,再开下一个……重复循环。数量少还好,一旦文件多起来,这就不是办公技能,而是一种纯粹的体力活。
更麻烦的是,慢还不是最可怕的,手动操作极其容易出错——漏了某个文件、选错了区域、金额列被当成文本、临时文件混进来……各种防不胜防。这时候,Python的价值就很明确了:把重复动作抽象成一条固定流程,让脚本去稳定执行。
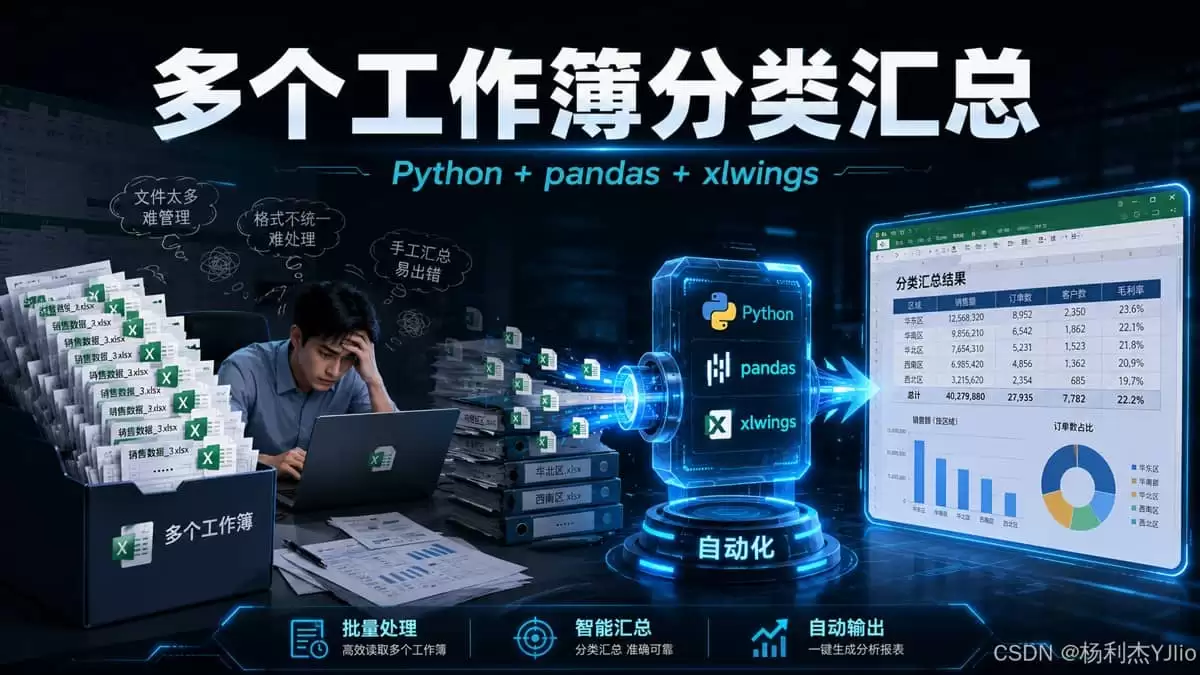
从这张流程图上可以看得很清楚:左侧是大量待处理的 Excel 工作簿,中间是 Python + pandas + xlwings 组成的自动化链路,右侧是最终生成的汇总结果。换句话说,本文要讲的不是某个单点函数,而是一个能直接迁移到真实办公场景的批量处理框架。
2. 适用场景:什么时候适合用这个脚本
这个案例适用于几类典型的场景。只要你的工作表结构比较统一,就可以直接套用这个思路。
- 一个文件夹里有多个 .xlsx 工作簿;
- 每个工作簿里有多张工作表;
- 每张工作表都有相同或相近的表头结构;
- 需要按某个字段分组,比如“销售区域”“客户名称”“部门”“产品类型”;
- 需要对某个数值字段求和,比如“销售利润”“销售额”“数量”“成本”;
- 希望把汇总结果写回原工作表右侧区域,方便查看和复核。
建议先别急着上正式数据。在测试文件夹里复制 2~3 个样例文件,试跑一遍,确认结果没问题后,再处理正式报表。
有个很重要的原则:别直接在原始报表上跑批量覆盖脚本。批量操作确实快,但错起来也快。最好保留原始文件,把处理结果输出到一个新文件夹。这样就算脚本有 bug,原始数据也安然无恙。
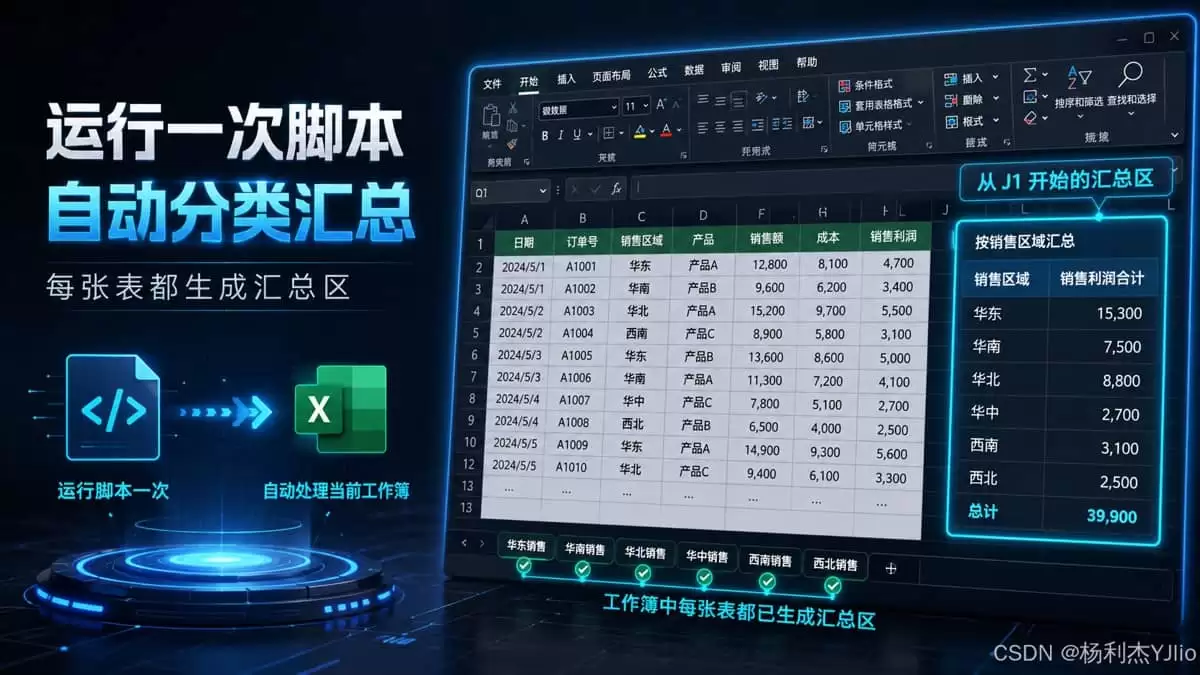
从这张效果图可以看到,汇总区从 J1 开始写入,原始明细数据仍然完整保留在左侧。这种布局有两个好处:第一,不破坏原始数据;第二,打开任意一张工作表,都能直接看到当前表的分类汇总结果,非常直观。
3. 核心原理:把“重复劳动”拆成一条批处理流水线
手工汇总看起来步骤不少,但拆开之后,其实只有一条固定的流水线:扫描文件夹 → 打开工作簿 → 遍历工作表 → 读取数据 → 分组汇总 → 写回保存。
这个过程中,三个库各司其职:
- os:负责文件系统层面的操作,比如扫描文件夹、拼接路径、判断扩展名;
- xlwings:负责打开 Excel、访问工作簿和工作表、把结果写回 Excel;
- pandas:负责把表格数据变成 DataFrame,然后用 groupby() 做分类汇总。

从这张流程图可以看出,脚本不是直接“汇总一张表”,而是逐层处理:先处理文件夹,再处理工作簿,再处理工作表。只要这条流程搭好,后面无论是分类汇总、批量筛选、批量排序,还是批量拆分,都只是替换中间的数据处理逻辑——框架是通用的。
4. 操作前准备:环境、目录和数据字段
4.1 安装依赖
这个案例主要依赖 pandas 和 xlwings。如果本机没有安装,先在命令行里执行:
pip install pandas xlwings
补充一点:xlwings 在 Windows 环境下通常依赖本机已经安装的 Microsoft Excel,因为它是通过 Excel 应用来自动化操作的。
4.2 建议目录结构
为了降低误操作风险,建议把原始报表和输出结果分开放:
项目目录
├─ 销售表
│ ├─ 销售数据_1.xlsx
│ ├─ 销售数据_2.xlsx
│ └─ 销售数据_3.xlsx
└─ 输出结果
原始文件原封不动,处理后的工作簿另存到“输出结果”文件夹。这样就算脚本逻辑写错了,也不会破坏原始数据。
4.3 字段要求
本文示例默认每张工作表中至少包含两个字段:销售区域和销售利润。
如果你的实际字段名是“地区”“利润”“销售金额”,直接在代码里修改对应的参数即可,不要硬改源数据的字段名。
5. 完整代码:批量处理多个工作簿中的所有工作表
下面这份代码是续航战用的版本,不光是展示 groupby() 怎么用,还重点考虑了真实办公中容易踩坑的地方:跳过 ~$ 临时文件、跳过空表、校验字段、清洗金额、另存输出、最终退出 Excel。
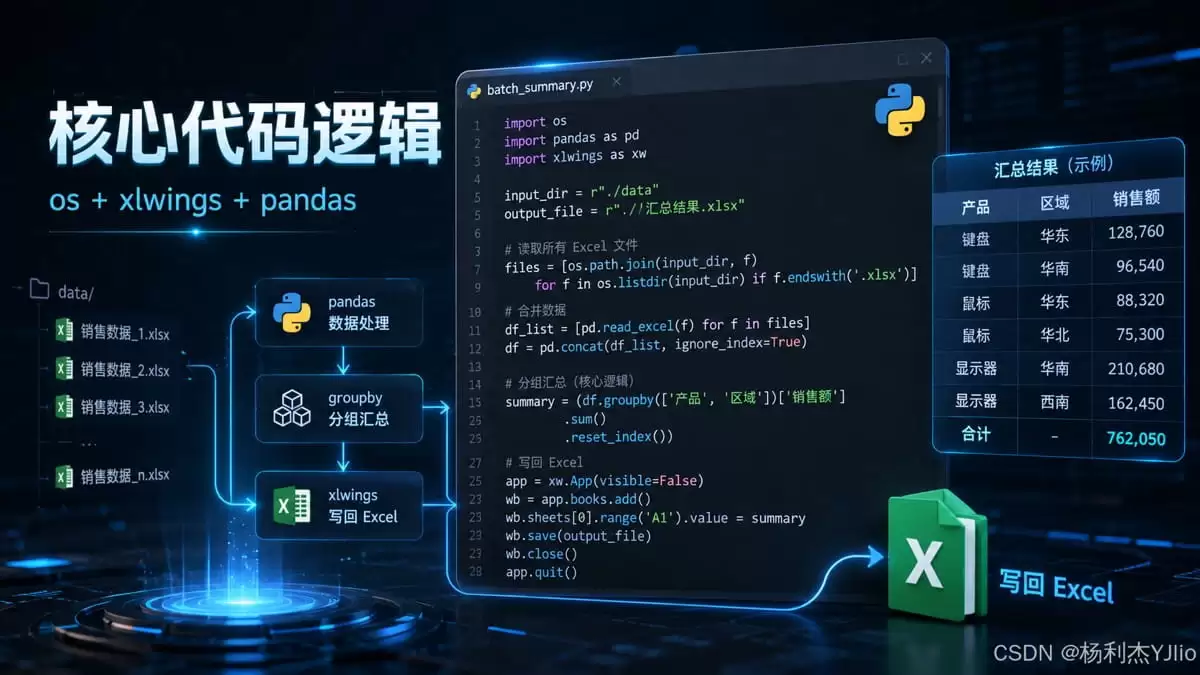
从这张图中可以清晰地看到代码架构:os 负责扫描文件,pandas 负责数据处理和分组汇总,xlwings 负责写回 Excel。这不是一段孤立的脚本,而是一条完整的数据通道——理解这种结构比单纯复制粘贴代码重要得多。
import os
import pandas as pd
import xlwings as xw


def clean_to_number(series: pd.Series) -> pd.Series:
    """
    将可能带有货币符号、逗号、空格、文本前缀的金额列清洗为数值。
    例如:
    ¥12,345.67 -> 12345.67
    profit: 6543.21 -> 6543.21
    """
    series = series.astype(str).str.strip()
    series = series.str.replace(",", "", regex=False)
    series = series.str.replace(r"[¥¥$ ]", "", regex=True)
    series = series.str.replace(r"[^0-9.-]", "", regex=True)
    return pd.to_numeric(series, errors="coerce")


def summarize_one_sheet(
    df: pd.DataFrame,
    group_col: str = "销售区域",
    value_col: str = "销售利润"
) -> pd.DataFrame:
    """
    对单张工作表数据进行分类汇总。
    按 group_col 分组,对 value_col 求和。
    """
    if group_col not in df.columns:
        raise KeyError(f"缺少分组列:{group_col}")

    if value_col not in df.columns:
        raise KeyError(f"缺少汇总列:{value_col}")

    temp = df.copy()

    # 先清洗成数值,再汇总,避免字符串求和或排序错误
    temp[value_col] = clean_to_number(temp[value_col]).fillna(0)

    result = (
        temp.groupby(group_col, dropna=False)[value_col]
        .sum()
        .reset_index()
        .rename(columns={
            group_col: "销售区域",
            value_col: "销售利润汇总"
        })
        .sort_values("销售利润汇总", ascending=False)
    )

    return result


def batch_summary_workbooks(
    input_folder: str,
    output_folder: str,
    group_col: str = "销售区域",
    value_col: str = "销售利润",
    start_cell: str = "A1",
    write_cell: str = "J1"
) -> None:
    """
    批量处理多个工作簿中的所有工作表:
    1. 扫描 input_folder 下的 Excel 文件
    2. 遍历每个工作簿中的所有工作表
    3. 读取表格数据为 DataFrame
    4. 按指定字段分类汇总
    5. 将结果写回每张工作表的 write_cell 位置
    6. 保存到 output_folder
    """
    os.makedirs(output_folder, exist_ok=True)

    app = xw.App(visible=False, add_book=False)
    app.display_alerts = False
    app.screen_updating = False

    try:
        for file_name in os.listdir(input_folder):
            # 跳过 Excel 临时文件和非 xlsx 文件
            if file_name.startswith("~$"):
                continue

            if not file_name.lower().endswith(".xlsx"):
                continue

            input_path = os.path.join(input_folder, file_name)
            output_path = os.path.join(output_folder, file_name)

            print(f"n[OPEN] 正在处理工作簿:{input_path}")

            wb = app.books.open(input_path)
            success_count = 0
            skip_count = 0

            try:
                for sht in wb.sheets:
                    try:
                        rng = sht.range(start_cell).expand("table")

                        if rng.value is None:
                            print(f"  [SKIP] {sht.name}:空表")
                            skip_count += 1
                            continue

                        df = rng.options(pd.DataFrame, header=1, index=False).value

                        if df is None or df.empty:
                            print(f"  [SKIP] {sht.name}:无有效数据")
                            skip_count += 1
                            continue

                        summary_df = summarize_one_sheet(
                            df,
                            group_col=group_col,
                            value_col=value_col
                        )

                        # 清理旧汇总区,避免上一次结果残留
                        sht.range(write_cell).resize(100, 3).clear_contents()

                        # 写回汇总结果,不写入 DataFrame 索引
                        sht.range(write_cell).options(index=False).value = summary_df
                        sht.autofit()

                        print(f"  [OK] {sht.name}:已汇总到 {write_cell}")
                        success_count += 1

                    except Exception as e:
                        print(f"  [SKIP] {sht.name}:{e}")
                        skip_count += 1

                wb.sa ve(output_path)
                print(f"[DONE] 已保存:{output_path},成功 {success_count} 张表,跳过 {skip_count} 张表")

            finally:
                wb.close()

    finally:
        app.quit()
        print("n[ALL DONE] 所有工作簿处理完成")


if __name__ == "__main__":
    batch_summary_workbooks(
        input_folder=r"销售表",
        output_folder=r"输出结果",
        group_col="销售区域",
        value_col="销售利润",
        start_cell="A1",
        write_cell="J1"
    )
6. 关键判断:为什么必须先清洗数值再分类汇总
很多新手写分类汇总代码时,会直接来这么一句:
df.groupby("销售区域")["销售利润"].sum()
这句在干净数据里没毛病,但真实 Excel 报表有几个是干净的?销售利润列很可能长这样:
¥12,345.67
$8,765.50
9,100元
profit: 6,543.21
4321
这些内容人眼看着像数字,但程序读进来大概率是字符串。如果不先清洗,pandas 的求和结果就很不可信,甚至直接报错。
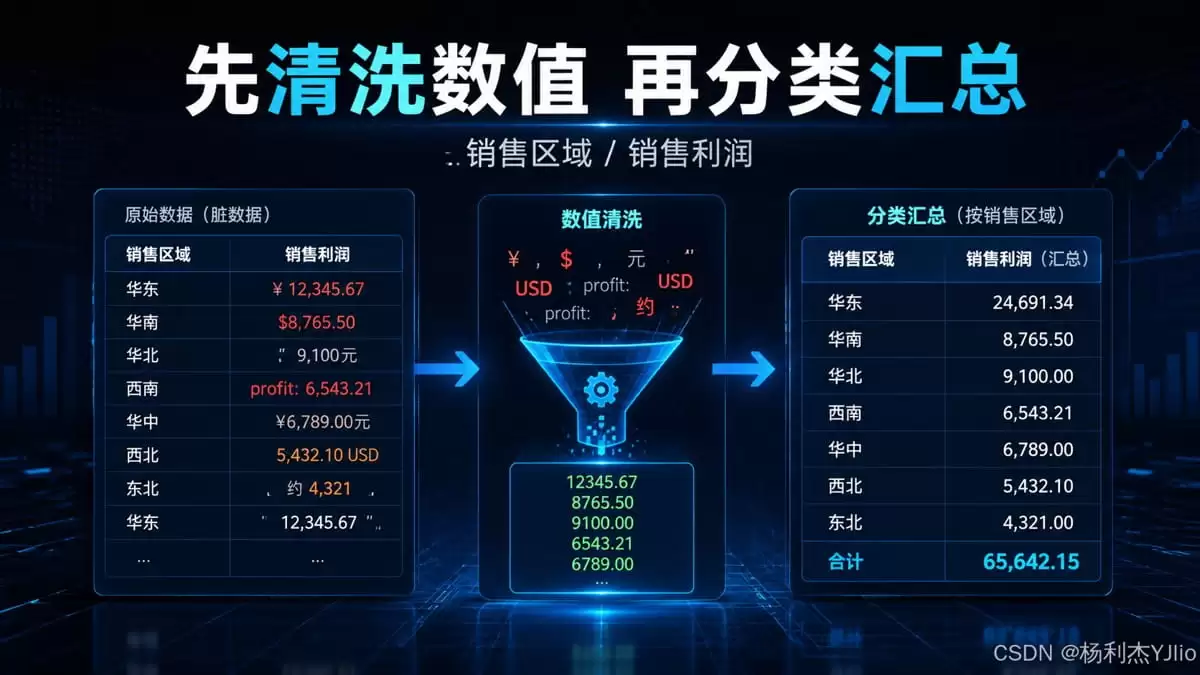
从这张图上可以看得很清楚:左侧是带符号、带文本、格式不统一的脏数据,中间经过数值清洗,右侧才能得到可信的分类汇总结果。这一步是整篇文章里最关键的技术判断——不是所有看起来像数字的单元格,进到Python里就真的是数值。
建议:只要是财务、销售、金额、数量类字段,在做汇总前都先统一做数值转换。多写几行清洗代码,比后面返工查错省时间得多。
7. 运行效果验证:怎么判断脚本真的成功了
脚本跑完,不能只看控制台没有报错。真正的验证至少要过三层。
7.1 验证输出文件是否生成
先确认 输出结果 文件夹中是否生成了对应的 Excel 文件。
输出结果
├─ 销售数据_1.xlsx
├─ 销售数据_2.xlsx
└─ 销售数据_3.xlsx
如果文件数量和输入文件数量一致,说明工作簿层面的批处理基本正常。
7.2 验证每张工作表是否写入汇总区
打开任意输出文件,切换到不同工作表,查看 J1 起始位置是否出现两列汇总结果:
销售区域 销售利润汇总
华东 24691.34
华南 8765.50
华北 9100.00
如果每张表都有独立的汇总区,说明遍历和写回逻辑都正常。
7.3 抽样核对汇总金额
建议随机选一张表,用 Excel 透视表或者筛选求和,抽一两个区域的销售利润核对一下。脚本结果和手动核对一致,才算真正可信。
“脚本跑完了”只代表流程执行完成,不代表数据一定正确——这个观念很重要。
8. 常见问题与踩坑记录
8.1 为什么脚本会跳过某些工作表?
常见原因有三个:空表、表头不在 A1、缺少指定字段。代码里已经做了异常捕获,所以不会因为一张表异常就导致整个批处理停下来。
如果你的真实表头从 A2 或 B3 开始,记得把 start_cell="A1" 改成实际表头的位置。
8.2 为什么要跳过~$开头的文件?
~$ 开头的文件通常是 Excel 打开时生成的临时锁定文件,并不是真正的数据文件。批处理时如果不跳过,很容易出现打开失败、权限错误、内容异常等问题。
这种临时文件不该参与数据处理。
8.3 为什么推荐输出到新文件夹,而不是直接覆盖原文件?
因为分类汇总属于批量写操作,写错一处可能影响很多文件。输出到新文件夹后,可以先对比检查,确认无误再替换原始文件。
这本质上就是把“处理”和“确认”拆成两步,降低批量误操作的风险。
8.4 为什么 Excel 有时会残留进程?
如果脚本在运行中途异常退出,而没有执行 app.quit(),Excel 进程就可能残留在后台。本文代码用了 try/finally,就是为了保证无论中途是否报错,最后都尽量退出 Excel。
写 xlwings 脚本时,finally 收尾不是可选项,是基本规范。
9. 总结提升:这不是一个脚本,而是一套办公自动化套路
这一节想强调的核心,不是记住某一行代码,而是理解一套可以复用的办公自动化套路:先定位文件,再定位工作簿,再定位工作表,最后把数据读入 DataFrame 进行处理。
这套思路可以继续扩展:
- 按“客户名称”分类汇总销售额;
- 按“部门”统计费用;
- 按“产品类型”汇总订单数量;
- 把每个工作簿的汇总结果再合并成一张总表;
- 把汇总结果自动生成图表或日报。
Python 办公自动化真正有价值的点,不是替你点几下鼠标,而是把重复规则沉淀成稳定流程。
最后再啰嗦一句:批量处理脚本一定要先用样例数据验证,再处理正式数据。尤其是涉及覆盖保存、金额汇总、财务报表、资产台账这类数据时,别拿原始文件直接试错——代价可能会比较大。











正软商城本月促销专区,汇集办公、设计、安全、影音、系统工具及AI软件等正版软件优惠活动,提供限时折扣、特价授权和优惠购买信息,活动库存及价格以页面实时展示为准。

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
