


基于Python实现高效PDF数据抽取工具
基于Python的PDF数据抽取工具,利用PyPDF2、PDFMiner和tabula-py库,高效提取表格与键值对信息,通过错误处理与数据验证保障质量,支持命令行与图形界面,兼具高准确率与可扩展性。
在处理日常文档时,PDF文件因其格式固定、跨平台兼容性好而备受青睐。但问题来了——你想从这些“铁板一块”的文件里高效提取出表格、键值对等结构化数据,该怎么办?
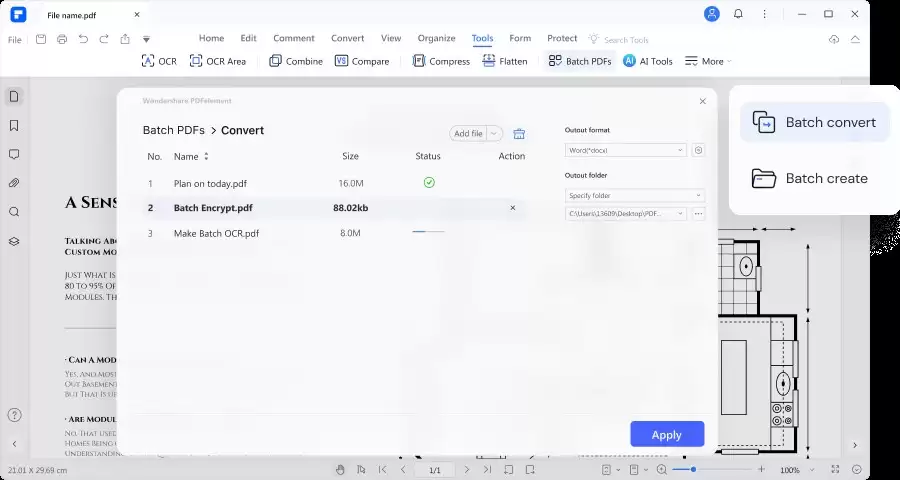
这正是我们接下来要聊的话题。一个集成了表格和键值对信息抽取能力的PDF数据提取工具,堪称数据处理的利器。而Python,凭借其丰富的库生态,正是打造这把利器的绝佳平台。
1. Python PDF数据提取工具
概述
信息技术飞速发展,自动化处理日常文档成了提升效率的关键。PDF格式因其稳定性和跨平台兼容性而被广泛使用。然而,这些优点在数据提取时可能变成一道坎。为了解决这个痛点,Python凭借其强大的库生态系统,成为解决PDF数据提取问题的首选方案。
为什么要用Python
Python之所以能成为数据分析和处理领域的首选语言,其实一点也不意外。原因很朴实:
- 易用性:语法简洁明了,无论你是刚入门的新手还是经验丰富的老手,都能迅速上手。
- 丰富的库:Python拥有大量专门用于处理PDF文件的第三方库,比如PyPDF2、PDFMiner和tabula-py,各有所长。
- 强大的社区支持:遇到问题时,你几乎总能从社区中找到现成的解决方案或思路。
数据提取工具的组成
一个完整的Python PDF数据提取工具,通常包含几个核心部分:
- PDF解析库:负责将PDF文件中的文本、图像、表格等数据“挖”出来。
- 数据处理逻辑:对解析出的数据进行清洗、转换等一系列加工。
- 错误处理机制:确保整个提取过程稳定可靠,不至于遇到一个小问题就崩溃。
接下来,我们就把镜头聚焦到表格和键值对这两种最常见的信息抽取场景上。
2. 表格与键值对信息抽取
2.1 表格数据抽取技术
2.1.1 表格数据的定义与特性
在数据抽取任务中,表格数据是结构化信息的典型代表。它们通常由清晰的列标题和若干行数据组成,行列交叉处是单元格。表格数据的最大特点是高度格式化,这让你在视觉上能一眼认出它,而在信息抽取时,也意味着它遵循着某种可预测的模式。
2.1.2 利用PDF解析库提取表格数据
利用PDF解析库来提取表格,是常用的方法。比如PyPDF2和PDFMiner,它们能解析PDF文档,并从中提取表格信息。来看具体怎么干:
- 加载PDF文档。
- 逐页遍历,寻找可能包含表格的区域。
- 利用库提供的功能检测表格位置。
- 抽取表格内容,并以CSV、Pandas DataFrame等结构化形式输出。
以PDFMiner为例,它的extract_tables函数就能直接搞定:
from pdfminer.high_level import extract_tables

# 打开PDF文件
with open('example.pdf', 'rb') as fp:
    # 提取所有表格
    tables = extract_tables(fp)

# 表格数据通常是列表的列表结构,直接打印或做后续处理
for table in tables:
    print(table)
这段代码输出的就是二维列表形式的表格数据,每个子列表代表一行,里面的元素就是单元格内容。
2.1.3 表格数据抽取的常见问题
实际操作中真会这么顺利吗?恐怕没那么简单。由于PDF格式的多样性,表格抽取过程中会遇到不少麻烦:
- 表格可能嵌套在文本块中,导致识别困难。
- 合并单元格或大小不一的单元格,会让解析逻辑变得复杂。
- 表格的视觉样式,有时会和数据的逻辑结构不完全匹配。
解决这些问题,通常需要你对PDF解析库进行一些定制,或者在提取数据后,做进一步的后处理来清洁和格式化数据。
2.2 键值对信息抽取技术
2.2.1 键值对数据的定义与特性
键值对是另一种常见的数据存储方式,可以理解为“属性-值”的映射。这种结构简洁、灵活,非常适合表示像“姓名:张三”、“年龄:30”这样的关联数据。
2.2.2 利用正则表达式进行键值对抽取
很多时候,键值对数据就藏在非结构化的文本中。这时候,正则表达式就是你的最佳搭档。你可以定义一套匹配规则,从复杂的文本里快速、准确地锁定目标。
import re

text = "Name: John Doe, Age: 30, City: New York"

# 匹配键值对,假设键值对用逗号分隔,键与值用冒号分隔
pattern = re.compile(r'(w+):s*(w+)')
matches = pattern.findall(text)

# 输出匹配结果
for key, value in matches:
    print(f'{key}: {value}')
2.2.3 键值对抽取的准确性优化
正则表达式虽然强大,但对数据格式非常敏感。想要提高抽取准确性,还需要做一些优化:
- 数据预处理:清洗文本,去除不必要的字符和空格。
- 严格定义键:在编写正则时,尽量精确地描述键的模式。
- 后处理验证:对抽出的键值对进行格式和逻辑校验。
- 引入机器学习:对于格式极其多变的文本,可以考虑用机器学习模型来识别和抽取。
3. 多库集成优势:PyPDF2、PDFMiner、tabula-py
选对库是成功的一半。咱们来看看Python生态里三个应用广泛的PDF处理库,它们各自有什么特长。
3.1 PyPDF2库的应用与特性
3.1.1 PyPDF2简介及其在数据抽取中的作用
PyPDF2是个轻量级的库,擅长做合并、拆分、加密、解密这类PDF操作,也能提取一些简单的文本。因为上手简单,处理不太复杂的PDF文件时,它往往是首选。
import PyPDF2

with open('example.pdf', 'rb') as file:
    reader = PyPDF2.PdfFileReader(file)
    num_pages = reader.numPages
    page = reader.getPage(0)
    text = page.extractText()
    print(text)
需要注意的是,extractText()方法对于复杂布局的提取效果可能不太理想。
3.1.2 PyPDF2的文本抽取与图片抽取
除了文本,PyPDF2也能尝试提取图片。
# 继续上述代码,提取第一页中的图片
images = page.extractImages()
if images:
    for image in images:
        img_data = image["data"]
        with open('image.png', 'wb') as img_file:
            img_file.write(img_data)
3.2 PDFMiner库的应用与特性
3.2.1 PDFMiner架构概述
如果说PyPDF2是“轻骑兵”,那PDFMiner就是“重装步兵”。它功能更强大,目标是提供更详尽的文本和布局信息。它将PDF文档解析成文本块、行、字体等更原始的对象,让你对文档布局有更深入的理解。
3.2.2 PDFMiner中的文本布局分析
PDFMiner能分析布局结构,定位更精确。
from pdfminer.high_level import extract_text

text = extract_text('example.pdf')
print(text)
对于复杂的文档格式,PDFMiner通常能提供比PyPDF2更精确的文本抽取。
3.2.3 PDFMiner的高级使用技巧
PDFMiner还有不少高级功能,比如提取字体信息、绘制文本布局图等,能帮你更深入地了解PDF内部结构,实现复杂的数据抽取需求。
3.3 tabula-py库的应用与特性
3.3.1 tabula-py简介与安装
tabula-py是Ja va工具Tabula的Python封装,它的强项非常明确——专门用于抽取PDF中的表格数据。如果你经常和PDF表格打交道,tabula-py绝对是个好帮手。
3.3.2 利用tabula-py抽取表格数据
在表格抽取方面,tabula-py的优势是压倒性的。
import tabula

tables = tabula.read_pdf('example.pdf', pages='all')
for index, table in enumerate(tables):
    print(f"Table {index}:")
    print(table)
更妙的是,它会把每个表格直接转换成Pandas DataFrame,后续的数据处理和分析就变得非常方便。
3.3.3 tabula-py与其他库的对比分析
简单来说,如果你要处理的是密集的表格数据,tabula-py是首选。当然,它的缺点是依赖Ja va环境,而且处理非表格内容的能力有限。对比下来,PyPDF2和PDFMiner更适合作为通用的解析工具。
下一章,我们聊聊在数据抽取这个“战场”上,如何做好“防守”——也就是错误处理和数据验证。
4. 错误处理与数据验证机制
4.1 错误处理机制
数据抽取过程中,错误处理是保证程序稳定和数据质量的“定心丸”。了解常见的错误类型和原因,才能设计出更健壮的处理策略。
4.1.1 常见错误类型与原因分析
错误大致可以分为三类:
- 解析错误:发生在PDF解析阶段,通常由文件损坏、加密或解析库的局限性导致。
- 逻辑错误:编程逻辑出的岔子,比如数据类型不匹配、索引越界等。
- 输入/输出(I/O)错误:文件不存在、权限不足、磁盘空间不够等读写问题。
4.1.2 设计鲁棒的错误处理策略
设计错误处理策略时,可以遵循几个原则:
- 异常捕获:用try-except语句块捕获可能的异常,防止程序直接崩溃。
- 错误记录:把错误的时间、类型和上下文信息记下来,方便事后追踪。
- 用户友好的错误提示:给用户清晰易懂的错误信息,而不是一堆看不懂的技术堆栈。
- 优雅的错误恢复:在可能的情况下,让程序从错误中恢复并继续执行。
代码实例与逻辑分析
import logging

def extract_data(pdf_path):
    try:
        with open(pdf_path, 'rb') as file:
            # 使用PDF解析库提取数据
            pass
    except IOError as e:
        logging.error(f"I/O Error: {e}")
    except Exception as e:
        logging.error(f"An error occurred: {e}")

logging.basicConfig(level=logging.ERROR)

pdf_path = 'path/to/your/pdffile.pdf'
extract_data(pdf_path)
这个例子展示了用try-except结构来捕获和处理不同错误,并用日志记录,让程序能“优雅”地处理问题。
4.2 数据验证机制
数据验证是检验数据正确性、一致性和完整性的最后一道防线。
4.2.1 数据完整性的基本概念
数据完整性就是指数据的准确性和一致性,确保它在存储、传输或处理过程中没被改坏、弄丢。
4.2.2 数据验证的方法与实践
常用的验证方法包括:
- 范围验证:检查数据值是否在设定的范围内。
- 格式验证:检查数据是否符合特定格式(如邮箱、电话号码)。
- 一致性验证:确保数据项之间的逻辑关系正确。
- 完整性验证:检查数据项是否有缺失。
实践中可以用Python的断言、条件判断,或者使用cerberus这样的专业验证库。
4.2.3 验证机制在数据抽取中的重要性
没有验证,抽出来的数据质量就难以保证。一个有效的验证机制能:
- 提高数据抽取的准确性。
- 保证数据的高质量输出。
- 减少后续数据清洗的麻烦。
代码实例与逻辑分析
def validate_email(email):
    email_regex = r'(^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+.[a-zA-Z0-9-.]+$)'
    return re.match(email_regex, email) is not None

def validate_data(data):
    if not isinstance(data, dict):
        raise ValueError("Data must be a dictionary")
    email = data.get('email')
    if email:
        if not validate_email(email):
            raise ValueError("Invalid email format")
    return True

data_to_validate = {'email': 'example@example.com'}
try:
    validate_data(data_to_validate)
    print("Data is valid.")
except ValueError as ve:
    print(f"Data validation error: {ve}")
这段代码演示了如何用正则和异常来验证数据格式,确保数据的有效性。
5. CLI与GUI交互方式
5.1 命令行界面(CLI)的实现
CLI效率高,是自动化处理和批处理任务的好搭档。
5.1.1 CLI设计原则与用户交互
好的CLI设计要简洁、易用、一致。提供清晰的帮助信息,让哪怕技术不熟的同事也能照着命令用。
5.1.2 Python实现CLI的方法与案例
Python里实现CLI,最流行的方法是用argparse模块。
import argparse

def parse_args():
    parser = argparse.ArgumentParser(description='PDF Data Extractor CLI')
    parser.add_argument('input_file', type=str, help='PDF file to extract data from')
    parser.add_argument('--output', '-o', type=str, help='Output file (default: stdout)')
    return parser.parse_args()

def main():
    args = parse_args()
    input_file = args.input_file
    output_file = args.output
    # 数据提取逻辑
    # ...

if __name__ == '__main__':
    main()
用户调用时只需输入命令:python data_extractor.py example.pdf -o output.txt
5.2 图形用户界面(GUI)的设计与实现
GUI更直观,对于需要交互式操作或处理复杂功能的场景更友好。
5.2.1 GUI框架的选用与布局设计
Python的GUI框架很多,比如Tkinter、PyQt、wxPython。布局设计上,最重要的是易用,让用户能快速找到功能。
用Tkinter举个例子:
import tkinter as tk
from tkinter import filedialog, messagebox

def select_pdf():
    input_file = filedialog.askopenfilename(title="Select PDF File")
    print("Selected file:", input_file)
    # 数据提取逻辑
    # ...

def main():
    root = tk.Tk()
    root.title('PDF Data Extractor')
    select_button = tk.Button(root, text="Select PDF", command=select_pdf)
    select_button.pack()
    root.mainloop()

if __name__ == '__main__':
    main()
5.2.2 Python实现GUI的实践案例
一个典型的PDF数据提取器GUI可以包含:选择文件、配置选项(提取文本还是表格)、执行提取、展示结果、保存数据等步骤。
5.2.3 CLI与GUI的协同工作方式
一个好的工具可以同时支持CLI和GUI,让用户根据场景选择。例如,在CLI中可以直接输入命令启动GUI应用。CLI适合自动化,GUI适合手动操作,两者协同能极大地提升工具的易用性。
6. 数据完整性、一致性和合规性考量
6.1 数据完整性的保障措施
数据完整性的重要性
数据完整性,简单说就是数据要准确、一致。在PDF数据提取中,数据不准确可能导致报告错误、决策失误,甚至违反合规要求。保障完整性,关键在于防止数据重复、确保数据有效,并且在生命周期内保持不变。
实现数据完整性的技术手段
具体手段包括:
- 数据校验:用哈希算法对比提取前后的数据,确保没有丢失或篡改。
- 数据格式化:确保数据格式统一、规范。
- 事务处理:在涉及多个操作时,保证数据的一致性。
- 备份与恢复:定期备份,出了问题能迅速恢复。
import hashlib

def data_integrity_check(original_data, extracted_data):
    original_hash = hashlib.md5(original_data.encode('utf-8')).hexdigest()
    extracted_hash = hashlib.md5(extracted_data.encode('utf-8')).hexdigest()
    return original_hash == extracted_hash

original_pdf_data = "原始PDF文件中的文本数据"
extracted_pdf_data = "提取后的PDF文件中的文本数据"

if data_integrity_check(original_pdf_data, extracted_pdf_data):
    print("数据完整性检查通过")
else:
    print("数据完整性检查失败")
6.2 数据一致性的维护策略
数据一致性的基本概念
数据一致性指数据在多个副本或多个系统间保持一致。在PDF数据提取中,这常见于处理多个表单、报告或数据集。
多数据源情况下的一致性维护
维护策略包括:
- 版本控制:跟踪数据变化,确保用的是最新版本。
- 数据同步:在多个系统或数据库间同步数据。
- 合并冲突解决:当多个地方对数据做了修改时,要解决冲突。
class PDFSyncConflictResolver:
    def resolve_conflict(self, user_version, server_version):
        return user_version

resolver = PDFSyncConflictResolver()
user_pdf_version = "用户更新的PDF数据"
server_pdf_version = "服务器上的PDF数据"
resolved_version = resolver.resolve_conflict(user_pdf_version, server_pdf_version)
print(f"冲突解决后使用的版本是:{resolved_version}")
6.3 数据合规性与安全标准
数据合规性的法律法规要求
数据合规性涉及遵守GDPR、HIPAA等数据保护法规。这些法规可能要求保护个人数据、确保数据安全,以及在适当时候删除数据。
针对PDF数据合规性的实践指南
针对PDF数据,需要关注:
- 数据访问控制:确保只有授权用户能访问敏感文档。
- 数据加密:对敏感数据进行加密存储和传输。
- 日志记录与审计:记录所有访问和修改活动。
from Crypto.Cipher import AES
from Crypto.Random import get_random_bytes

key = get_random_bytes(16)

def encrypt_pdf_data(plain_text):
    cipher = AES.new(key, AES.MODE_EAX)
    ciphertext, tag = cipher.encrypt_and_digest(plain_text.encode('utf-8'))
    return cipher.nonce, tag, ciphertext

def decrypt_pdf_data(nonce, tag, encrypted_data):
    cipher = AES.new(key, AES.MODE_EAX, nonce=nonce)
    decrypted_data = cipher.decrypt_and_verify(encrypted_data, tag).decode('utf-8')
    return decrypted_data

pdf_content = "敏感PDF文件内容"
nonce, tag, encrypted_pdf = encrypt_pdf_data(pdf_content)
decrypted_pdf = decrypt_pdf_data(nonce, tag, encrypted_pdf)
print(f"解密后的PDF内容是:{decrypted_pdf}")
以上这些知识和技能,是构建一个可靠PDF数据提取工具的基础。
7. 性能优化与扩展策略
数据量一大,任何系统都会遇到性能瓶颈。为了确保工具的高效运行和可持续发展,性能优化和扩展规划就变得至关重要。
7.1 性能优化实践
7.1.1 分析性能瓶颈
优化的第一步是找到瓶颈。Python的cProfile或line_profiler这类工具能帮你分析代码的耗时分布。
import cProfile

def process_pdf(file_path):
    # 处理PDF文件的代码
    pass

cProfile.run('process_pdf("large_file.pdf")')
根据分析结果,你才能知道到底是哪段代码拖了后腿。
7.1.2 优化代码逻辑
找到瓶颈后,可以考虑:
- 换用更快的PDF解析库(比如PyMuPDF可能比PyPDF2快不少)。
- 对关键代码用Cython或Numba加速。
- 处理大文件时,用多线程或异步IO来提升效率。
7.1.3 硬件加速
对于计算密集型任务,可以考虑硬件加速。比如,用pdf2image库将PDF页面转为图像后,利用GPU并行处理。
from pdf2image import convert_from_path

images = convert_from_path("large_file.pdf", thread_count=8)
7.2 扩展策略规划
7.2.1 模块化设计
从一开始就采用模块化设计,把不同功能解耦,这样未来增加新功能或更新技术时,影响范围最小。
7.2.2 使用微服务架构
如果需求再复杂些,可以考虑将工具转型为微服务架构。把PDF解析、数据抽取等各功能抽象成独立服务,通过API通信,系统扩展和维护会更灵活。
7.2.3 技术堆栈的开放性
选择技术堆栈时,优先考虑那些社区活跃、文档齐全、生命力强的技术。这样在未来出现更好的替代方案时,你能快速跟上。
以上就是关于如何用Python打造一个高效PDF数据抽取工具的全景式梳理。这些理论与实践,对于任何需要从PDF中提取数据的专业人士来说,都算是非常关键的考量。


















Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Xcode 是苹果面向 Mac 提供的官方集成开发环境,将代码编辑、项目构建、SwiftUI 实时预览、设备模拟、自动化测试、断点调试、性能分析和应用分发整合在同一套工作流中,适合开发与维护 iPhone、iPad、Mac、Apple Wa

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

Visual Studio Code 是微软提供的免费代码编辑器,支持 macOS,并为 Intel 与 Apple 芯片 Mac 提供适配版本。软件集代码编辑、调试、Git 源代码管理、集成终端和扩展市场于一体。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Pro Tools 是 Avid 推出的专业数字音频工作站,覆盖多轨录音、无损剪辑、MIDI 编曲、插件处理、自动化混音及声音与画面同步等工作。它拥有 Intro、Artist、Studio 和 Ultimate 等方案。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

Visual Studio Code 是微软推出的免费代码编辑器,Windows 版集成智能补全、代码导航、调试、终端和版本控制,并可通过扩展添加语言、格式化及远程开发能力。它启动较快、配置灵活,

REAPER 是 Cockos 推出的数字音频工作站,适用于录音、MIDI 编曲、音频编辑、混音、母带制作及声音设计。软件安装包小巧,支持多轨录制、灵活路由、自动化、第三方插件和脚本扩展,并提供完整功能的 60 天免费评估期。

Adobe Audition 是面向播客、影视后期、广播与音乐制作的专业音频工作站,提供波形编辑、多轨混音、频谱分析、录音、降噪修复和效果处理等功能。Windows 版通过 Adobe Creative Cloud 安装和管理,

Pro Tools 是 Avid 推出的专业数字音频工作站,提供多轨录音、音频剪辑、MIDI编曲、插件处理、自动化混音及影视声音制作能力。它适合音乐人、录音师、制作人和音频后期团队使用,并提供免费入门版、订阅方案及永久授权选择。