


Python Pandas数据分析的使用完整教学
Pandas数据分析涵盖数据接入、诊断、清洗、转换、时序分析与性能优化。高效读取CSV与Parquet,实施数据质量诊断及缺失值、异常值处理,利用query、groupby、merge等完成数据重塑与关联,通过resample、rolling进行时序分析,并采用PyArrow后端与CoW机制提升性能。
一、数据接入层:高效I/O与现代数据格式
企业的数据源往往是百家争鸣——CSV、Excel、SQL数据库、数据湖里的Parquet文件,不一而足。而分析的起点,就是“如何把数据快速且省内存地读进来”。这看似基础,实则藏着不少门道。
1.1 传统格式的“避坑”读取
不少新手一上来就直接用read_csv()读个大文件,结果内存撑爆、类型推断错误,场面一度尴尬。更专业的做法是:精准控制读取的列、预先指定数据类型,并顺手把时间列解析好。
import pandas as pd
import numpy as np

# 专业做法:精准控制列、类型与分块
dtypes = {
    'order_id': 'int32',
    'user_id': 'int32',
    'status': 'category',  # 低基数枚举字段使用 category
    'amount': 'float32'
}

df = pd.read_csv(
    'huge_orders.csv',
    usecols=['order_id', 'user_id', 'status', 'amount', 'order_time'],
    dtype=dtypes,
    parse_dates=['order_time']
)
1.2 超大文件的分块处理 (Chunking)
当CSV文件大到几十个GB,单机内存吃不消时,就轮到 chunksize 登场了,它能让你像流水线一样处理数据。
chunk_iter = pd.read_csv('billion_rows.csv', chunksize=100_000)
total_revenue = 0

for chunk in chunk_iter:
    # 在每个 chunk 上进行聚合操作,最后合并结果
    total_revenue += chunk['amount'].sum()
1.3 拥抱现代数据湖格式:Parquet
一个非常中肯的建议:如果团队内部有大量数据需要流转,请果断放弃CSV,全面转向Parquet。它天生就是列式存储,压缩率高得惊人,而且能完美保留数据类型,省去你反复做类型转换的麻烦。
# 写入 Parquet (使用 pyarrow 引擎)
df.to_parquet('orders_clean.parquet', engine='pyarrow', compression='snappy')

# 读取 Parquet (Pandas 2.0+ 推荐开启 PyArrow 后端)
df_arrow = pd.read_parquet('orders_clean.parquet', dtype_backend='pyarrow')
二、数据诊断层:快速探索与质量评估 (EDA)
拿到数据后,千万别急着建模或画图。先按捺住躁动的心,给数据来个“全身体检”——这能让你对后续工作的难度和方向心中有数。
2.1 一键生成数据质量诊断报告
def diagnose_dataframe(df: pd.DataFrame) -> pd.DataFrame:
    """数据质量诊断函数"""
    diag = pd.DataFrame({
        'Dtype': df.dtypes,
        'Non_Null': df.count(),
        'Null_Count': df.isnull().sum(),
        'Null_Rate(%)': (df.isnull().sum() / len(df) * 100).round(2),
        'Unique_Count': df.nunique(),
        'Memory_MB': df.memory_usage(deep=True) / (1024**2)
    })
    return diag.sort_values('Null_Rate(%)', ascending=False)

# 调用
diagnose_dataframe(df)
2.2 数值与分布的快速概览
只看均值、中位数、最大最小值远远不够。更推荐关注一下尾部分布,比如95分位和99分位,这能让你发现那些藏在“长尾”里的极端值。
# 查看数值型统计量,并调整显示精度
pd.set_option('display.float_format', lambda x: '%.2f' % x)
print(df.describe(percentiles=[.05, .25, .5, .75, .95, .99])) # 关注长尾分布

# 查看类别型字段的基数和Top频率
print(df.describe(include=['category', 'object']))
三、数据清洗层:脏数据处理方案
如果数据科学家的大部分时间都花在了哪?答案是数据清洗,占了约70%。我们的目标是采用向量化、自动化的方式来搞定这些“脏活累活”。
3.1 缺失值的高级处理
遇到缺失值,不要无脑丢一句dropna()。背后的业务逻辑才是决定处理方式的关键:退款金额缺失可能意味着没退款,那就填0;某个用户的评分数据缺失,用他历史评分的均值来补,是不是比全局均值更合理?
# 1. 业务规则填充:例如“退款金额”缺失代表未退款,填0
df['refund_amount'] = df['refund_amount'].fillna(0)

# 2. 分组填充:用该用户的历史均值填充缺失的评分
df['user_score'] = df.groupby('user_id')['user_score'].transform(
    lambda x: x.fillna(x.mean())
)

# 3. 时间序列插值:对于连续的传感器/财务数据,使用线性或样条插值
df['daily_revenue'] = df['daily_revenue'].interpolate(method='spline', order=2)
3.2 异常值检测与截断 (Winsorization)
在计算均值或训练模型前,必须跟“羊毛党”或“测试订单”产生的极端值做个了断。用基于IQR的“盖帽法”截断,是个成熟且有效的做法。
def clip_outliers_iqr(series: pd.Series, factor=1.5) -> pd.Series:
    """基于 IQR 的异常值截断(盖帽法)"""
    Q1 = series.quantile(0.25)
    Q3 = series.quantile(0.75)
    IQR = Q3 - Q1
    lower_bound = Q1 - factor * IQR
    upper_bound = Q3 + factor * IQR
    return series.clip(lower=lower_bound, upper=upper_bound)

df['amount_clean'] = clip_outliers_iqr(df['amount'])
3.3 字符串的向量化正则提取
从杂乱的备注、地址或描述文本中提取出结构化的信息,是数据分析师的家常便饭。这个场景下,向量化的.str.extract() 比逐行用 apply 调用正则表达式,快了不止一个数量级。
# 假设 df['remark'] 包含类似 "使用优惠券:VIP2026, 免邮" 的文本
# ✅ 向量化做法:
df['coupon_code'] = df['remark'].str.extract(r'优惠券:([A-Z0-9]+)')

# 清理隐藏字符并统一小写
df['city'] = df['city'].str.strip().str.lower().str.replace(r's+', ' ', regex=True)
四、数据转换层:重塑、聚合与多表关联
如果说Pandas有它的“灵魂区域”,那非数据转换层莫属。它决定了你能否将一滩“明细数据”成功转化为桌面上的“业务洞察”。
4.1 优雅的条件筛选:query()
query() 是很多Pandas高手的最爱。它不仅写起来像SQL一样自然,更重要的是,在处理大数据框时,底层用 numexpr 来加速,内存效率远高于传统的布尔索引。
# 筛选:高价值、已完成、特定城市的订单
target_cities = ['北京', '上海', '广州', '深圳']

# 使用 @ 引用外部变量
df_filtered = df.query(
    "amount > 1000 and status == 'completed' and city in @target_cities"
)
4.2 分组聚合的终极形态:命名聚合
Pandas 0.25之后引入的命名聚合,可是一项伟大的发明。它让 groupby 加 agg 的代码可读性直接拉满,输出的宽表结构也一目了然。
user_stats = df.groupby('user_id').agg(
    total_orders=('order_id', 'count'),
    total_spend=('amount', 'sum'),
    a vg_spend=('amount', 'mean'),
    first_order=('order_time', 'min'),
    last_order=('order_time', 'max')
).reset_index()

# 计算 RFM 模型中的时间间隔特征
user_stats['recency_days'] = (pd.Timestamp('2026-05-27') - user_stats['last_order']).dt.days
4.3 数据重塑:长宽表转换
melt 和 pivot_table 就像是两把反方向的钥匙,专门用来解决数据展示和分析时的格式难题。
# 宽转长:将 Jan, Feb, Mar 三列销售额转为一列
df_long = pd.melt(
    df_wide,
    id_vars=['store_id', 'region'],
    value_vars=['Jan_Sales', 'Feb_Sales', 'Mar_Sales'],
    var_name='month',
    value_name='sales'
)

# 长转宽:生成 地区 x 月份 的交叉报表
report = pd.pivot_table(
    df_long,
    values='sales',
    index='region',
    columns='month',
    aggfunc='sum',
    fill_value=0,
    margins=True # 添加总计行/列
)
4.4 多表关联的“防爆”
在大规模数据分析中,merge 操作后数据行数“爆炸式”翻倍,从而引发内存溢出或结果异常,是最常见的生产事故之一。一个安全的小习惯是:务必使用 validate 参数来护体。
# ✅ 务必使用 validate 参数验证关联键的唯一性
# 'm:1' 表示左表多对一右表,如果右表 key 不唯一,直接报错拦截!
df_final = pd.merge(
    orders,
    users,
    on='user_id',
    how='left',
    validate='m:1',
    suffixes=('_order', '_user')
)
五、时序分析层:商业时间序列处理
在电商、金融、SaaS等行业中,时间序列就是数据的灵魂。处理得好,你能从中听出业务的“心跳”。
5.1 时间重采样 (Resample)
将一笔笔不规则的交易流水,聚合为标准的日、周、月报表,是构建任何业务看板的第一步。
# 确保索引是 DatetimeIndex
df_time = df.set_index('order_time')

# 按日重采样,计算每日总GMV和订单数
daily_report = df_time.resample('D').agg(
    gmv=('amount', 'sum'),
    orders=('order_id', 'count')
).fillna(0) # 补齐没有交易的日期
5.2 滑动窗口与滞后特征 (Rolling & Shift)
移动平均、同比、环比——这些业务分析中最常见的指标,都建立在对 rolling 和 shift 的熟练运用上。
# 1. 7日移动平均 GMV
daily_report['gmv_ma7'] = daily_report['gmv'].rolling(window=7).mean()

# 2. 计算日环比增长率 (今日 / 昨日 - 1)
daily_report['gmv_dod'] = daily_report['gmv'].pct_change(periods=1)

# 3. 计算周同比 (今日 / 7天前 - 1)
daily_report['gmv_wow'] = daily_report['gmv'].pct_change(periods=7)
六、性能优化层:突破Pandas内存与速度瓶颈
当数据量超过500万行,很多Pandas操作就会开始变得“慢吞吞”。别急,掌握下面几个核心技巧,你的代码有望提速10倍到100倍。
6.1 拥抱Pandas 2.x的PyArrow后端
可以说,这是Pandas历史上一次里程碑式的更新。 PyArrow后端带来的零拷贝读取、更低的内存占用,以及对原生缺失值的支持,让曾经的瓶颈变成了坦途。
# 开启全局 PyArrow 后端 (Pandas 2.0+)
pd.options.mode.dtype_backend = "pyarrow"

# 或者在读取时指定
df = pd.read_csv('data.csv', engine='pyarrow', dtype_backend='pyarrow')
# 此时字符串不再是低效的 object,而是 string[pyarrow],内存直降 70%!
6.2 Copy-on-Write (CoW) 机制
Pandas 2.2开始默认开启的CoW机制,彻底解决了“链式赋值警告(SettingWithCopyWarning)”这个老大难问题,也避免了隐式的内存复制。
# 开启 CoW
pd.options.mode.copy_on_write = True

# 现在,切片操作是懒加载的(视图),只有当你真正修改切片数据时,才会发生内存拷贝。
subset = df[df['amount'] > 100]
subset['new_col'] = 1  # 安全,不会触发警告,也不会意外修改原 df
6.3 消灭apply,走向向量化
apply 本质上是一个披着函数外衣的 for 循环,性能低下。数据分析的世界里,向量化才是王道。
# 场景:根据金额划分等级 (低、中、高)

# ❌ 极慢的 apply
def get_level(x):
    if x < 100: return 'Low'
    elif x < 1000: return 'Mid'
    else: return 'High'
df['level'] = df['amount'].apply(get_level)

# ✅ 向量化方案 1:np.select (推荐,逻辑清晰)
conditions = [df['amount'] < 100, df['amount'] < 1000]
choices = ['Low', 'Mid']
df['level'] = np.select(conditions, choices, default='High')

# ✅ 向量化方案 2:pd.cut (适用于连续数值分箱)
df['level_bin'] = pd.cut(df['amount'], bins=[0, 100, 1000, np.inf], labels=['Low', 'Mid', 'High'])
七、工程实践层:链式编程与代码规范
在实际项目中,代码的可读性和可维护性与运行效率同等重要。推荐使用链式操作(Method Chaining),让代码像一条清晰的生产流水线。
7.1 链式操作与pipe函数
将多个步骤“串联”起来,不仅能让数据处理逻辑一目了然,也方便你随时插入或调整某一步操作。
def drop_outliers(df: pd.DataFrame, col: str) -> pd.DataFrame:
    """自定义清洗管道"""
    limit = df[col].quantile(0.99)
    return df[df[col] <= limit]

# 一气呵成的数据流水线
final_df = (
    pd.read_csv('raw_data.csv', parse_dates=['time'])
    .query("status == 'success'")
    .assign(
        # 在链中直接创建新列
        revenue = lambda x: x['price'] * x['qty'],
        year_month = lambda x: x['time'].dt.to_period('M')
    )
    .pipe(drop_outliers, col='revenue')  # 接入自定义函数
    .groupby('year_month')
    .agg(total_rev=('revenue', 'sum'))
    .reset_index()
)
7.2 代码规范Checklist
- 禁止使用
inplace=True:它并不能节省内存,还会破坏链式编程,且在CoW机制下已逐渐被淘汰。 - 警惕
object类型:数据读进来后,第一件事就是把字符串转成string或category,大整数降级为int32,别犹豫。 - 隔离业务逻辑:把复杂的
groupby或清洗逻辑封装成独立的函数,用pipe调用。这样做的好处是便于单元测试,也方便同事理解。 - 大表关联前先聚合:这是一个铁律。永远不要拿两张千万级的明细表直接
merge,先在子表做groupby聚合,缩到合适的粒度之后再进行关联。





AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

Beamer 4是面向macOS的本地视频投屏工具,可将Mac中的影片投放到Apple TV、Chromecast及兼容设备,支持常见格式、多类字幕、环绕声、播放列表和电视遥控操作。
Boom 3D macOS版是一款系统级音效增强工具,可为音乐、电影、游戏和流媒体提供3D虚拟环绕声、31段均衡器、音量增强及应用独立音量控制,并支持本地播放器与多种音频输出设备。
Boris FX macOS版是一套面向剪辑、合成、调色及动态图形工作的专业后期工具,涵盖视觉特效、平面与三维跟踪、转描、画面修复、粒子动画和音频清理,可配合多种主流宿主软件使用。
Capto 是面向 macOS 的屏幕截图、高清录屏与媒体编辑工具,支持区域及整屏捕获、网页长截图、双音轨处理、图片和视频标注、素材分类与多渠道分享,适合教师、学生、内容创作者及需要制作演示教程的用户。
Cursor Crane 是一款仅面向 macOS 的键盘操控效率工具,可通过提示标签、网格、文字查找和窗口模式完成点击、滚动、定位与切换,并支持屏幕内容提取、脚本及工作流扩展。
Deep Freeze 冰点还原 macOS版通过冻结系统配置,让受保护的Mac在重新启动后回到预设状态,并提供解冻空间、维护计划、密码保护及Apple Remote Desktop管理能力。
Focusky macOS版是一款面向教学课件、商务汇报、产品展示和动画宣传内容的演示制作工具。它通过无限画布、路径编排、缩放旋转转场及多媒体编辑,将传统逐页幻灯片转化为更具空间感的动态演示。
Folder Colorizer 2 macOS版是一款直观的文件夹外观定制工具,可更换颜色,添加表情、贴纸及图片背景,并支持批量处理、智能推荐和恢复默认样式,帮助用户更快辨认工作、学习与生活资料。
StarUML 7 Windows版是一款面向软件工程、系统分析与架构设计的专业建模工具,支持UML 2、ERD、流程图、数据流图和C4模型等,可用于需求梳理、系统设计、模型验证、文档发布及代码生成。
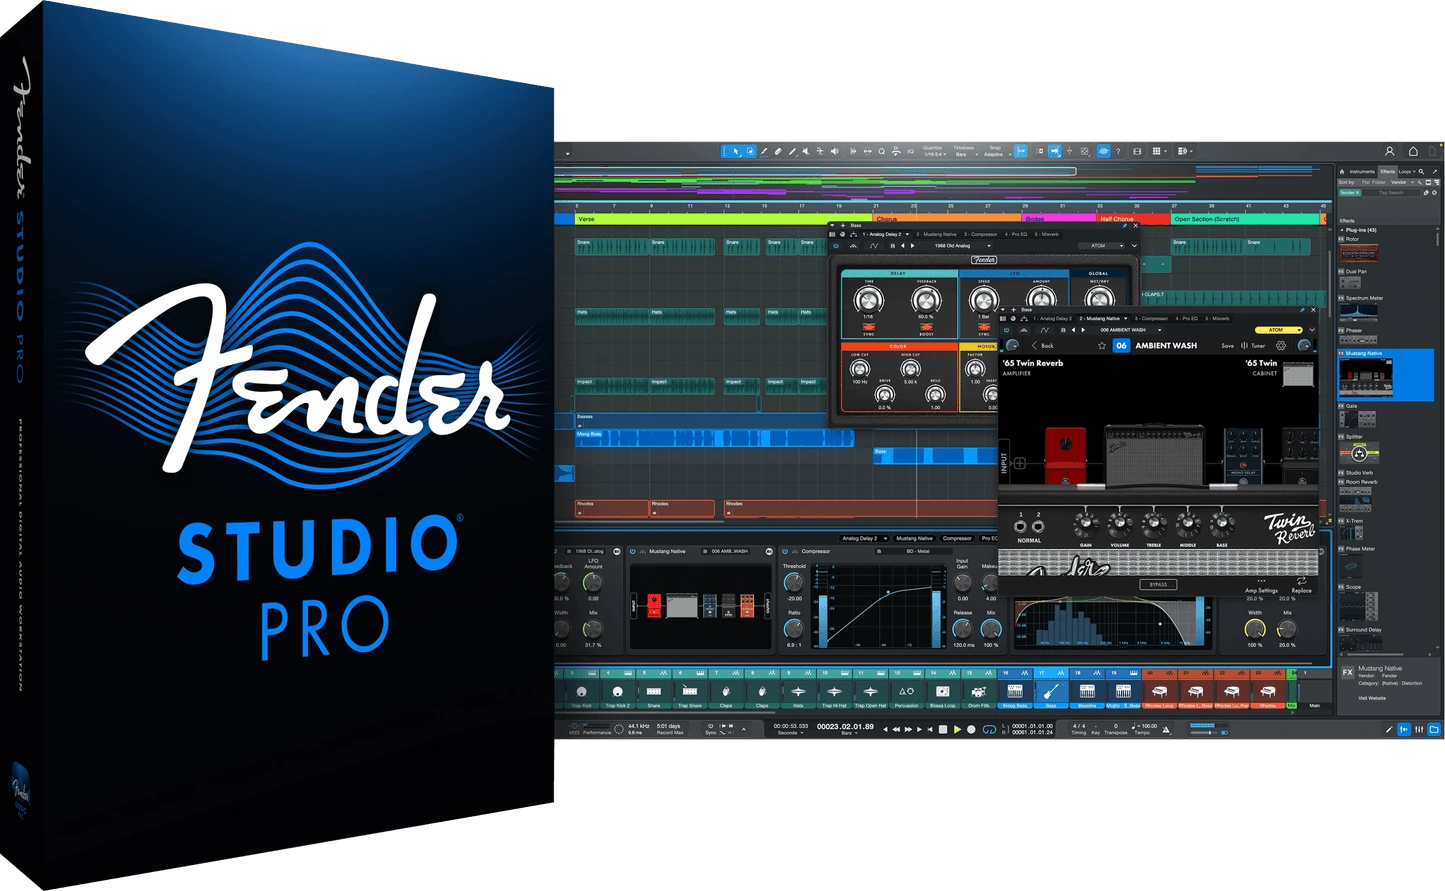
Fender Studio Pro(原Studio One)Windows版是一套专业数字音频工作站,可完成录音、编曲、混音、母带处理与现场演出。 新版本延续Studio One的核心工作流,并加入Fender音箱与效果建模、智能创作和更现代的制作界面。
think-cell Windows版是一款集成于Microsoft PowerPoint和Excel的商业演示增强插件,提供瀑布图、甘特图、Mekko图、数据联动、自动标注及智能排版功能,适合咨询、金融、项目管理和企业汇报场景。
TotalFX Windows版是一套面向剪辑师与内容创作者的视频后期插件合集,将动态字幕、转场、稳定、绿幕抠像、滤镜及色彩校正等能力整合到常用非线性编辑软件中,适合宣传片、短视频、栏目包装和影视项目制作。

UltraEdit Windows版是一款面向开发者、数据人员和系统管理员的专业编辑器,支持文本、源代码、十六进制及超大文件处理,并提供多光标、列模式、正则搜索、脚本自动化和FTP远程编辑等工具。
Xmanager Windows版是一款面向开发、运维及科研人员的PC X服务器,可连接Linux或UNIX主机,在Windows中运行完整远程桌面或单个X应用,并集中管理XDMCP、SSH、RDP与VNC会话。
作曲大师 Windows版是一款面向简谱录入、曲谱排版、播放试听和音乐教学的中文制谱工具。麦软网所列简谱标准版支持最多16个声部,并提供曲库下载等实用功能,适合制作普通歌谱、课堂谱例及练习资料。
失易得 Windows 版是一款面向误删除、误格式化、分区丢失及回收站清空等情况的数据恢复工具,可扫描电脑硬盘、移动硬盘、U盘和存储卡,并通过预览、筛选和深度扫描帮助用户判断文件是否值得恢复。
AppScan Windows版是一款面向Web应用和API的动态应用安全测试工具,可自动探索站点、执行漏洞测试、按风险级别整理问题,并提供验证信息、修复建议与合规报告,适合安全测试、开发整改及上线前审计。
JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,
PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,
PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,