


Python中Word文档目录创建、更新、提取与删除操作详解
在报告、手册、方案书、技术文档这些长篇大论的Word文档里,目录基本上是个标配。对需要自动生成或者批量更新的场景来说,手动去插入或刷新目录,效率确实够呛,还容易漏掉几页。 这时候要是能用Python自动搞定目录的创建、更新、提取和删除,那就省事多了。 这篇就从几个核心操作讲起,把如何用Python在
在报告、手册、方案书、技术文档这些长篇大论的Word文档里,目录基本上是个标配。对需要自动生成或者批量更新的场景来说,手动去插入或刷新目录,效率确实够呛,还容易漏掉几页。
这时候要是能用Python自动搞定目录的创建、更新、提取和删除,那就省事多了。
这篇就从几个核心操作讲起,把如何用Python在Word文档里玩转目录这件事捋清楚。
Word 目录的工作原理
先说个核心判断:Word的目录远没有看起来那么神秘,它本质上依赖于标题样式来生成。比如我们常用的“标题1”、“标题2”、“标题3”这类内置样式。
插入目录时,Word会扫描文档中应用了这些样式的段落,然后根据它们的层级关系生成对应的条目和页码。
这也就意味着,如果想让生成的目录准确、完整,一定要确保那些需要出现在目录里的段落,用的是真正的Word标题样式。单纯把字号调大、加个粗,Word根本不会把它们识别成目录条目。这一点在实际项目中经常踩坑,得留个心眼。
环境准备
要用Python处理Word目录,比较顺手的一个库是 Free Spire.Doc for Python。它最大的好处是:不需要安装Microsoft Word就能直接创建和编辑Word文档,在服务端或者没有Office的环境下跑起来很省心。
安装方式也简单,在终端跑这条命令就行:
pip install spire.doc.free
需要注意的是,这个库要求Python版本在3.7及以上,跑之前可以先确认一下系统的Python版本。
使用 Python 创建带目录的 Word 文档
在文档里插入目录,主要靠 AppendTOC() 这个方法。它接受两个参数:
lowerLevel:目录包含的起始标题级别upperLevel:目录包含的结束标题级别
举个例子,AppendTOC(1, 3) 的意思就是:目录里会包含“标题1”到“标题3”的所有层级。
下面这段代码演示了从零开始创建一个新文档、添加几个中文标题、插入目录,最后保存为 .docx 文件的过程:
from spire.doc import *

# 创建一个新的 Word 文档
doc = Document()

# 设置中文字体
chinese_font = "Microsoft YaHei"

# 添加一个节
section = doc.AddSection()
section.PageSetup.Margins.All = 72

# 添加目录标题
toc_title = section.AddParagraph()
title_text = toc_title.AppendText("目录")
title_text.CharacterFormat.FontName = chinese_font
title_text.CharacterFormat.FontSize = 16
title_text.CharacterFormat.Bold = True

# 插入目录,包含“标题 1”到“标题 3”
toc_paragraph = section.AddParagraph()
toc_paragraph.AppendTOC(1, 3)

# 在目录后添加分页符,使正文从新的一页开始
toc_paragraph.AppendBreak(BreakType.PageBreak)

# 添加一级标题
paragraph = section.AddParagraph()
paragraph.ApplyStyle(BuiltinStyle.Heading1)
text = paragraph.AppendText("1. 引言")
text.CharacterFormat.FontName = chinese_font

# 添加正文内容
paragraph = section.AddParagraph()
text = paragraph.AppendText("本节介绍文档的编写目的、适用场景和背景信息。")
text.CharacterFormat.FontName = chinese_font

# 添加二级标题
paragraph = section.AddParagraph()
paragraph.ApplyStyle(BuiltinStyle.Heading2)
text = paragraph.AppendText("1.1 项目背景")
text.CharacterFormat.FontName = chinese_font

paragraph = section.AddParagraph()
text = paragraph.AppendText("本小节进一步说明项目背景、业务需求以及文档结构。")
text.CharacterFormat.FontName = chinese_font

# 添加另一个一级标题
paragraph = section.AddParagraph()
paragraph.ApplyStyle(BuiltinStyle.Heading1)
text = paragraph.AppendText("2. 实现方案")
text.CharacterFormat.FontName = chinese_font

paragraph = section.AddParagraph()
text = paragraph.AppendText("本节介绍文档处理流程、核心逻辑和实现方式。")
text.CharacterFormat.FontName = chinese_font

# 添加另一个二级标题
paragraph = section.AddParagraph()
paragraph.ApplyStyle(BuiltinStyle.Heading2)
text = paragraph.AppendText("2.1 处理逻辑")
text.CharacterFormat.FontName = chinese_font

paragraph = section.AddParagraph()
text = paragraph.AppendText("本小节说明程序如何识别标题、插入目录并更新目录内容。")
text.CharacterFormat.FontName = chinese_font

# 添加三级标题
paragraph = section.AddParagraph()
paragraph.ApplyStyle(BuiltinStyle.Heading3)
text = paragraph.AppendText("2.1.1 处理步骤")
text.CharacterFormat.FontName = chinese_font

# 更新目录
doc.UpdateTableOfContents()

# 保存文档
doc.Sa veToFile("带目录的Word文档.docx", FileFormat.Docx2016)

# 关闭文档
doc.Close()
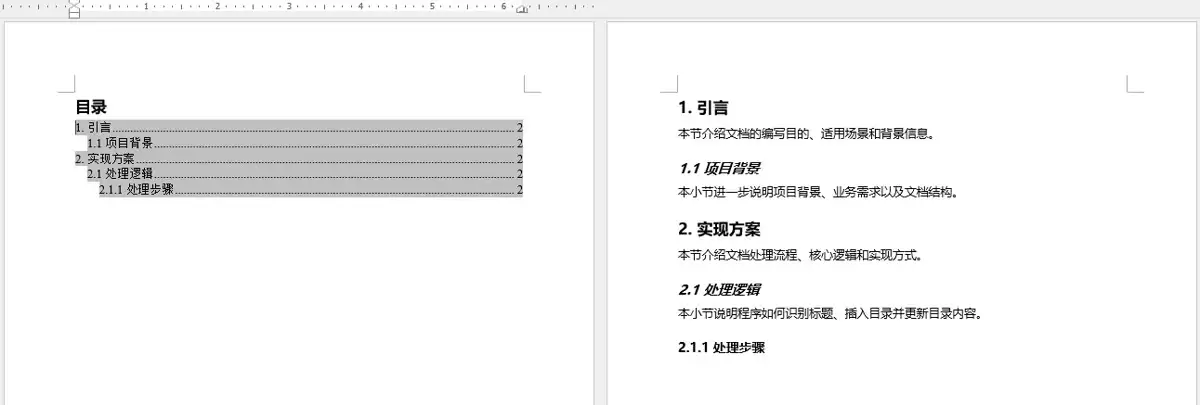
注意代码里那个“目录”标题,它只手动设置了字体、字号和加粗,并没有应用“标题1”样式。为什么这么处理?因为如果“目录”本身也被设为标题样式,它就会被扫描进目录里,导致目录条目里最终出现一个“目录”的条目,很尴尬。所以用小技巧避开它。
使用 Python 向现有 Word 文档插入目录
很多场景下,文档已经写好,只是在开头缺一个目录。这时候可以加载现有文档,在第一节的开头插入目录标题和目录字段,然后调用更新方法刷新一下:
from spire.doc import *

# 加载现有 Word 文档
doc = Document()
doc.LoadFromFile("示例文档.docx")

# 设置中文字体
chinese_font = "Microsoft YaHei"

# 获取第一个节
section = doc.Sections[0]

# 在节的开头添加目录标题
title_paragraph = Paragraph(doc)
title_text = title_paragraph.AppendText("目录")
title_text.CharacterFormat.FontName = chinese_font
title_text.CharacterFormat.FontSize = 16
title_text.CharacterFormat.Bold = True
section.Paragraphs.Insert(0, title_paragraph)

# 在标题下方添加目录字段
toc_paragraph = Paragraph(doc)
toc_paragraph.AppendTOC(1, 3)
section.Paragraphs.Insert(1, toc_paragraph)

# 在目录后添加分页符
toc_paragraph.AppendBreak(BreakType.PageBreak)

# 更新目录
doc.UpdateTableOfContents()

# 保存结果文档
doc.Sa veToFile("插入目录后的文档.docx", FileFormat.Docx2016)

# 关闭文档
doc.Close()
这个示例是将目录直接插到了第一节的开头。如果文档里有封面、前言或其他前置内容,可以灵活调整插入位置,或者单独给目录建一个新节。
唯一要确认的是:原文档里的标题必须用的是真正的Word标题样式,不然最后生成的目录很可能是个空的。
使用 Python 更新 Word 目录
当文档内容变了——比如标题改了一个词、段落顺序调整了——目录上的条目和页码也得跟着刷新。
下面示例演示了加载一个已有目录的文档、修改其中一个标题、然后刷新目录的过程:
from spire.doc import *

# 加载一个已经包含目录的 Word 文档
doc = Document()
doc.LoadFromFile("带目录的Word文档.docx")

# 修改目录中对应的标题文本
doc.Replace("1. 引言", "1. 更新后的引言", True, True)

# 更新目录
doc.UpdateTableOfContents()

# 保存更新后的文档
doc.Sa veToFile("更新目录后的文档.docx", FileFormat.Docx2016)

# 关闭文档
doc.Close()
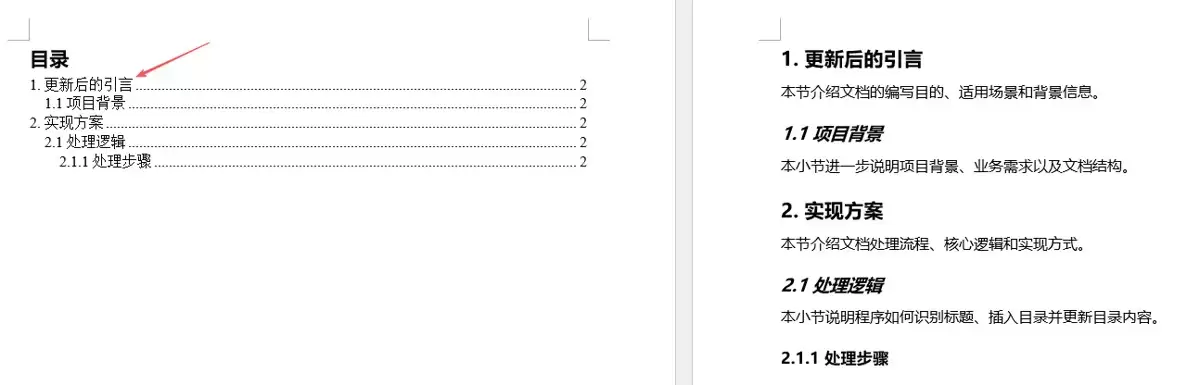
一句话总结:但凡文档内容、标题文本或标题位置有变动,记得调一次 UpdateTableOfContents(),这能保证目录跟正文始终同步。
使用 Python 提取 Word 目录条目
有时候我们需要把目录内容单独捞出来,比如生成摘要、做版本对比或者人工审阅。Word里面的目录有两种常见形态:
- 存放在
StructureDocumentTag里的目录段落(比如手动添加的目录) - 以普通段落形式存在、但使用了 TOC 样式的目录(比如编程方式插入的那种)
下面这段代码会同时处理这两类情况:提取目录条目,并根据目录级别添加缩进,最后保存到文本文件里:
import re
from spire.doc import *

# 创建 Document 对象
doc = Document()

# 加载包含目录的 Word 文档
doc.LoadFromFile("带目录的Word文档.docx")

# 用于存储提取到的目录条目
toc_entries = []

def get_toc_level(paragraph):
    """
    根据段落样式名称获取目录级别。
    例如:TOC1、TOC2、TOC3、TOC 1、TOC 2。
    """
    style_name = paragraph.StyleName

    if style_name is None:
        return None

    match = re.match(r"^TOCs*(d+)$", style_name.strip(), re.IGNORECASE)

    if match:
        return int(match.group(1))

    return None

def extract_toc_entry(paragraph):
    """
    从目录段落中提取文本。
    """
    level = get_toc_level(paragraph)

    if level is None:
        return

    text = paragraph.Text.strip()

    if not text:
        return

    # 根据目录级别添加缩进
    indent = "    " * (level - 1)
    toc_entries.append(indent + text)

# 遍历文档中的所有节
for s in range(doc.Sections.Count):
    section = doc.Sections.get_Item(s)
    body = section.Body

    # 遍历节正文中的所有子对象
    for i in range(body.ChildObjects.Count):
        obj = body.ChildObjects.get_Item(i)

        # 如果目录存储在 StructureDocumentTag 中
        if isinstance(obj, StructureDocumentTag):
            tag = obj

            # 遍历目录容器中的段落
            for j in range(tag.ChildObjects.Count):
                child_obj = tag.ChildObjects.get_Item(j)

                if isinstance(child_obj, Paragraph):
                    extract_toc_entry(child_obj)

        # 如果目录以普通段落和 TOC 样式存储
        elif isinstance(obj, Paragraph):
            paragraph = obj
            extract_toc_entry(paragraph)

# 将提取到的目录条目保存到文本文件
with open("提取的目录.txt", "w", encoding="utf-8") as file:
    for entry in toc_entries:
        file.write(entry + "n")

# 关闭文档
doc.Close()
提取出来的目录内容一般会带页码,格式类似这样:
1. 引言 2
1.1 项目背景 2
2. 实现方案 2
2.1 处理逻辑 2
2.1.1 处理步骤 2
保留层级结构,方便核对。如果只需要标题文本不要页码,可以把 extract_toc_entry() 中的这行代码:
text = paragraph.Text.strip()
替换成:
# 移除目录条目末尾的页码
text = re.sub(r"[t ]+d+s*$", "", paragraph.Text).strip()
这样输出的结果就会干净一些:
1. 引言
1.1 项目背景
2. 实现方案
2.1 处理逻辑
2.1.1 处理步骤
使用 Python 删除 Word 目录
删除目录和提取目录的思路差不多:先定位到目录内容,然后判断它的存储形式,再逐个删除。可能藏在 StructureDocumentTag 里,也可能是一堆用了 TOC 样式的普通段落。
下面的示例同时处理了这两种情况,并且顺手删掉了手动添加的“目录”标题:
import re
from spire.doc import *

# 创建 Document 对象
doc = Document()

# 加载包含目录的 Word 文档
doc.LoadFromFile("带目录的Word文档.docx")

# 匹配目录段落样式,例如 TOC1、TOC2、TOC3、TOC 1、TOC 2
toc_style_pattern = r"^TOCs*d+$"

def is_toc_paragraph(paragraph):
    """
    判断段落是否为目录条目。
    """
    style_name = paragraph.StyleName or ""
    return re.match(toc_style_pattern, style_name.strip(), re.IGNORECASE) is not None

def is_toc_title(paragraph):
    """
    判断段落是否为手动添加的目录标题。
    """
    title = paragraph.Text.strip().lower()
    return title in ("目录", "table of contents")

def contains_toc_paragraph(tag):
    """
    判断 StructureDocumentTag 中是否包含目录段落。
    """
    for i in range(tag.ChildObjects.Count):
        child_obj = tag.ChildObjects.get_Item(i)

        if isinstance(child_obj, Paragraph) and is_toc_paragraph(child_obj):
            return True

    return False

# 遍历文档中的所有节
for s in range(doc.Sections.Count):
    section = doc.Sections.get_Item(s)
    body = section.Body

    i = 0
    while i < body.ChildObjects.Count:
        obj = body.ChildObjects.get_Item(i)

        # 删除存储在 StructureDocumentTag 中的目录
        if isinstance(obj, StructureDocumentTag):
            tag = obj

            if contains_toc_paragraph(tag):
                body.ChildObjects.RemoveAt(i)
                continue

        # 删除目录条目或手动添加的目录标题
        elif isinstance(obj, Paragraph):
            paragraph = obj

            if is_toc_paragraph(paragraph) or is_toc_title(paragraph):
                body.ChildObjects.RemoveAt(i)
                continue

        i += 1

# 保存删除目录后的文档
doc.Sa veToFile("删除目录后的Word文档.docx", FileFormat.Docx2016)

# 关闭文档
doc.Close()
这段代码处理得比较细,会一并删掉所有的目录条目和手动添加的“目录”或“Table of Contents”标题,文档恢复成没有目录的状态。
常见问题与解决方法
1. 生成的目录为空
老问题:文档没有使用真正的Word标题样式。务必确保需要加入目录的段落应用了“标题1”“标题2”或“标题3”这类内置样式。
2. “目录”标题出现在目录条目中
前面也提到了,如果“目录”这个标题本身被设成了标题样式,它就会被当成一个条目加入目录。解决方法是手动设置其字体、字号、加粗,别让它套用任何标题样式。
3. 目录中的页码不正确
添加、删除或修改文档内容后,一定要记得调 UpdateTableOfContents() 刷新一下目录,否则页码还是旧的。
4. 部分标题没有出现在目录中
检查一下调用 AppendTOC() 时传入的级别范围。比如用了 AppendTOC(1, 2),那“标题3”就不会被包含进来。想包含三级标题,得用 AppendTOC(1, 3)。
5. 中文字体显示不正确
添加文本时可以显式设置一个支持中文的字体,像 text.CharacterFormat.FontName = "Microsoft YaHei"。如果在 Linux 或服务器环境跑,得确认系统里安装了相应的中文字体,否则可能显示成方框或乱码。也可以按实际环境换成宋体、Arial Unicode MS 等。
总结
这篇把创建、插入、更新、提取和删除Word目录的这些操作都过了一遍。有了这些方法,自动生成的报告、手册、方案书和技术文档在结构上能更清晰,读者导航起来也方便,维维护起来轻松不少。




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,