


PythonKeyError字典键不存在的异常原因及处理方法
引言 在Python编程的世界里,字典(Dictionary)绝对算得上是核心数据结构之一。它以键值对的形式组织数据,查找和访问效率都相当出色。但用过字典的人都知道,有个小问题经常跳出来捣乱——KeyError异常。当你试图访问一个不存在的键时,Python就会毫不留情地抛出这个异常。如果不提前做好
引言
在Python编程的世界里,字典(Dictionary)绝对算得上是核心数据结构之一。它以键值对的形式组织数据,查找和访问效率都相当出色。但用过字典的人都知道,有个小问题经常跳出来捣乱——KeyError异常。当你试图访问一个不存在的键时,Python就会毫不留情地抛出这个异常。如果不提前做好防护,程序很可能就此崩溃。
什么是KeyError异常?
KeyError是Python内置的异常类型,属于LookupError的子类。简单说,当你用方括号[]去取字典里某个键的值,而这个键压根不在里面时,Python就会抛出这个异常。
先看一个直观的例子:
# 创建一个简单的字典
student_grades = {
    'Alice': 95,
    'Bob': 87,
    'Charlie': 92
}

# 尝试访问存在的键
print(student_grades['Alice'])  # 输出: 95

# 尝试访问不存在的键
print(student_grades['Da vid'])  # 抛出KeyError异常
运行这段代码,你会看到类似这样的错误信息:
Traceback (most recent call last): File "example.py", line 11, inprint(student_grades['Da vid']) KeyError: 'Da vid'
错误信息很明确:键'Da vid'在字典里不存在,所以触发了KeyError。
KeyError异常的常见场景
1. 直接通过键访问字典元素
最典型的情况就是直接用方括号语法:
# 示例:用户信息字典
user_info = {
    'name': '张三',
    'age': 25,
    'email': 'zhangsan@example.com'
}

# 正常访问
print(user_info['name'])  # 输出: 张三

# 访问不存在的键
try:
    print(user_info['phone'])  # KeyError!
except KeyError as e:
    print(f"键 {e} 不存在")
2. 嵌套字典访问
处理嵌套数据结构时更容易踩坑:
# 嵌套字典示例
company_data = {
    'departments': {
        'engineering': {
            'employees': ['Alice', 'Bob'],
            'budget': 100000
        },
        'marketing': {
            'employees': ['Charlie', 'Da vid'],
            'budget': 50000
        }
    }
}

# 安全访问嵌套字典
def get_department_budget(data, dept_name):
    try:
        return data['departments'][dept_name]['budget']
    except KeyError as e:
        return f"无法获取{dept_name}部门的信息: 键缺失"

print(get_department_budget(company_data, 'engineering'))  # 100000
print(get_department_budget(company_data, 'sales'))       # 错误信息
3. JSON数据解析
从API获取JSON数据时,由于数据结构可能不完整,KeyError也是常客:
import json

# 模拟从API获取的JSON数据
json_string = '''
{
    "users": [
        {"id": 1, "name": "Alice", "email": "alice@example.com"},
        {"id": 2, "name": "Bob"}
    ]
}
'''

data = json.loads(json_string)

# 遍历用户数据
for user in data['users']:
    try:
        print(f"用户: {user['name']}, 邮箱: {user['email']}")
    except KeyError as e:
        print(f"用户 {user['name']} 缺少字段: {e}")
如何预防和处理KeyError异常?
使用get()方法
Python字典的get()方法简直就是救星:键不存在也不会抛异常,而是返回None或你指定的默认值。
student_scores = {
    '数学': 95,
    '英语': 87,
    '物理': 92
}

# 使用get()方法安全访问
math_score = student_scores.get('数学')
print(math_score)  # 95

# 访问不存在的键,返回None
chemistry_score = student_scores.get('化学')
print(chemistry_score)  # None

# 提供默认值
chemistry_score_with_default = student_scores.get('化学', 0)
print(chemistry_score_with_default)  # 0
使用in操作符检查键是否存在
另一种常见做法是在访问前先检查键是否存在于字典中:
product_inventory = {
    'iPhone': 50,
    'iPad': 30,
    'MacBook': 20
}

# 检查键是否存在
def check_inventory(product_name):
    if product_name in product_inventory:
        return f"{product_name} 库存: {product_inventory[product_name]} 台"
    else:
        return f"{product_name} 暂无库存信息"

print(check_inventory('iPhone'))   # iPhone 库存: 50 台
print(check_inventory('Samsung'))  # Samsung 暂无库存信息
使用setdefault()方法
当你希望确保某个键存在,并为它设置默认值时,setdefault()是个好帮手:
# 用户配置字典
user_config = {
    'theme': 'dark',
    'language': 'zh-CN'
}

# 确保所有必要的配置项都存在
user_config.setdefault('notifications', True)
user_config.setdefault('auto_sa ve', False)
user_config.setdefault('max_connections', 100)

print(user_config)
# {'theme': 'dark', 'language': 'zh-CN', 'notifications': True,
#  'auto_sa ve': False, 'max_connections': 100}
实际应用案例分析
光说理论还不够,我们看看实际项目中怎么用。
案例1:天气数据处理
假设要处理多个气象站的数据,但有的站点可能缺少某些字段:
weather_data = [
    {
        'station': '北京',
        'temperature': 25,
        'humidity': 60,
        'pressure': 1013
    },
    {
        'station': '上海',
        'temperature': 28,
        'humidity': 70
        # 缺少 pressure 数据
    },
    {
        'station': '广州',
        'temperature': 30,
        'pressure': 1010
        # 缺少 humidity 数据
    }
]

def analyze_weather(station_data):
    """分析单个气象站的数据"""
    station_name = station_data.get('station', '未知站点')

    temperature = station_data.get('temperature', 'N/A')
    humidity = station_data.get('humidity', 'N/A')
    pressure = station_data.get('pressure', 'N/A')

    return {
        'station': station_name,
        'temperature': temperature,
        'humidity': humidity,
        'pressure': pressure
    }

# 处理所有气象站数据
for data in weather_data:
    result = analyze_weather(data)
    print(f"站点: {result['station']}")
    print(f"温度: {result['temperature']}°C")
    print(f"湿度: {result['humidity']}%")
    print(f"气压: {result['pressure']} hPa")
    print("-" * 20)
案例2:用户权限管理系统
构建权限系统时,需要小心处理可能缺失的权限字段:
class PermissionManager:
    def __init__(self):
        self.user_permissions = {}

    def add_user(self, username, permissions=None):
        """添加用户及其权限"""
        if permissions is None:
            permissions = {}
        self.user_permissions[username] = permissions

    def check_permission(self, username, permission):
        """检查用户是否有特定权限"""
        try:
            user_perms = self.user_permissions[username]
            return user_perms.get(permission, False)
        except KeyError:
            return False

    def grant_permission(self, username, permission, value=True):
        """授予用户权限"""
        try:
            self.user_permissions[username][permission] = value
        except KeyError:
            # 如果用户不存在,创建新用户
            self.user_permissions[username] = {permission: value}

    def list_permissions(self, username):
        """列出用户的所有权限"""
        try:
            return self.user_permissions[username]
        except KeyError:
            return {}

# 使用示例
pm = PermissionManager()

# 添加用户
pm.add_user('admin', {'read': True, 'write': True, 'delete': True})
pm.add_user('editor', {'read': True, 'write': True})
pm.add_user('viewer')  # 无初始权限

# 检查权限
print(pm.check_permission('admin', 'delete'))     # True
print(pm.check_permission('editor', 'delete'))    # False
print(pm.check_permission('unknown', 'read'))     # False

# 授予权限
pm.grant_permission('viewer', 'read', True)
print(pm.check_permission('viewer', 'read'))      # True

# 列出权限
print(pm.list_permissions('admin'))
# {'read': True, 'write': True, 'delete': True}
高级技巧和最佳实践
使用collections.defaultdict
collections模块里的defaultdict是个大杀器:它自动为不存在的键提供默认值,省去了很多检查工作。
from collections import defaultdict

# 普通字典
regular_dict = {}
# regular_dict['missing_key'] += 1  # 这会引发KeyError

# defaultdict示例
counter = defaultdict(int)  # 默认值为0
counter['apple'] += 1
counter['banana'] += 1
counter['apple'] += 1

print(dict(counter))  # {'apple': 2, 'banana': 1}

# 更复杂的默认值
grouped_data = defaultdict(list)
grouped_data['fruits'].append('apple')
grouped_data['fruits'].append('banana')
grouped_data['vegetables'].append('carrot')

print(dict(grouped_data))
# {'fruits': ['apple', 'banana'], 'vegetables': ['carrot']}
使用try-except语句块
对于更复杂的逻辑,try-except依然是稳妥的选择:
def safe_nested_access(data, *keys):
    """
    安全地访问嵌套字典中的值
    """
    try:
        result = data
        for key in keys:
            result = result[key]
        return result
    except (KeyError, TypeError) as e:
        return None

# 测试数据
nested_data = {
    'level1': {
        'level2': {
            'level3': 'deep_value'
        }
    }
}

# 安全访问
print(safe_nested_access(nested_data, 'level1', 'level2', 'level3'))  # deep_value
print(safe_nested_access(nested_data, 'level1', 'missing', 'level3'))  # None
自定义异常处理装饰器
还可以用装饰器来自动处理KeyError,让代码更简洁:
def handle_key_error(default_return=None):
    """装饰器:自动处理KeyError异常"""
    def decorator(func):
        def wrapper(*args, **kwargs):
            try:
                return func(*args, **kwargs)
            except KeyError as e:
                print(f"警告:在函数 {func.__name__} 中发现键错误: {e}")
                return default_return
        return wrapper
    return decorator

@handle_key_error(default_return="数据不可用")
def get_user_profile(user_data, field):
    """获取用户资料字段"""
    return user_data[field]

# 测试
user = {'name': 'Alice', 'email': 'alice@example.com'}
print(get_user_profile(user, 'name'))     # Alice
print(get_user_profile(user, 'phone'))    # 警告信息 + 数据不可用
性能考虑和优化建议
处理大量数据时,不同方法的性能差异会很明显。做个基准测试看看:
import time
from collections import defaultdict

# 准备测试数据
test_keys = [f'key_{i}' for i in range(10000)]
existing_keys = test_keys[:5000]
missing_keys = test_keys[5000:]

# 方法1:使用in操作符检查
def method_in_operator(dictionary, keys):
    results = []
    for key in keys:
        if key in dictionary:
            results.append(dictionary[key])
        else:
            results.append(None)
    return results

# 方法2:使用get()方法
def method_get(dictionary, keys):
    return [dictionary.get(key) for key in keys]

# 方法3:使用try-except
def method_try_except(dictionary, keys):
    results = []
    for key in keys:
        try:
            results.append(dictionary[key])
        except KeyError:
            results.append(None)
    return results

# 方法4:使用defaultdict
def method_defaultdict(keys):
    dd = defaultdict(lambda: None)
    dd.update({f'key_{i}': f'value_{i}' for i in range(5000)})
    return [dd[key] for key in keys]

# 性能测试
normal_dict = {f'key_{i}': f'value_{i}' for i in range(5000)}

methods = [
    ('in操作符', lambda: method_in_operator(normal_dict, existing_keys + missing_keys)),
    ('get方法', lambda: method_get(normal_dict, existing_keys + missing_keys)),
    ('try-except', lambda: method_try_except(normal_dict, existing_keys + missing_keys)),
    ('defaultdict', lambda: method_defaultdict(existing_keys + missing_keys))
]

# 运行性能测试
for name, method in methods:
    start_time = time.time()
    result = method()
    end_time = time.time()
    print(f"{name}: {end_time - start_time:.4f} 秒")
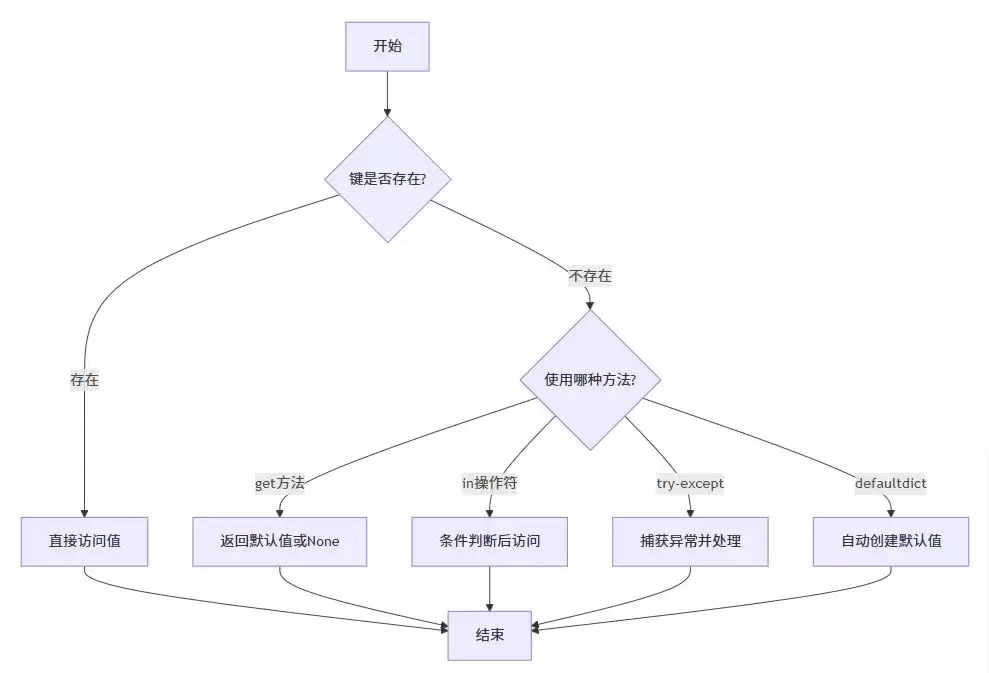
根据测试结果,几个关键结论:
- 对于已知存在的键,
try-except通常是最高效的方法 - 对于可能存在也可能不存在的键,
get()方法通常是最佳选择 in操作符在需要额外逻辑处理时很有用defaultdict在需要频繁创建新键的情况下表现优秀
调试和日志记录技巧
开发过程中,好的日志记录能帮你快速定位KeyError问题:
import logging
import traceback

# 配置日志
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)

def debug_dict_access(dictionary, key, context=""):
    """调试字典访问的辅助函数"""
    logger.info(f"尝试访问字典键: '{key}' ({context})")

    if key in dictionary:
        logger.info(f"键 '{key}' 存在,值为: {dictionary[key]}")
        return dictionary[key]
    else:
        a vailable_keys = list(dictionary.keys())
        logger.warning(f"键 '{key}' 不存在。可用键: {a vailable_keys[:10]}{'...' if len(a vailable_keys) > 10 else ''}")

        # 查找相似的键名(模糊匹配)
        similar_keys = [k for k in a vailable_keys if key.lower() in k.lower() or k.lower() in key.lower()]
        if similar_keys:
            logger.info(f"可能的相似键: {similar_keys}")

        raise KeyError(key)

# 使用示例
config = {
    'database_host': 'localhost',
    'database_port': 5432,
    'api_endpoint': 'https://api.example.com'
}

try:
    host = debug_dict_access(config, 'database_host', '数据库配置')
    port = debug_dict_access(config, 'database_port', '数据库配置')
    timeout = debug_dict_access(config, 'timeout', '连接配置')  # 这会引发异常
except KeyError as e:
    logger.error(f"配置错误: 缺少必需的配置项 {e}")
    logger.debug("完整的堆栈跟踪:n" + traceback.format_exc())
与其他异常的关系
KeyError并非孤立存在,它和Python其他异常有密切关系:
# KeyError与IndexError的区别
sample_list = [1, 2, 3]
sample_dict = {'a': 1, 'b': 2, 'c': 3}

try:
    # 这会引发IndexError
    print(sample_list[10])
except IndexError as e:
    print(f"索引错误: {e}")

try:
    # 这会引发KeyError
    print(sample_dict['d'])
except KeyError as e:
    print(f"键错误: {e}")

# 统一处理多种异常
def universal_accessor(container, key):
    """通用容器访问器"""
    try:
        return container[key]
    except (KeyError, IndexError) as e:
        return f"访问错误: {type(e).__name__} - {e}"
    except TypeError as e:
        return f"类型错误: {e}"

# 测试不同类型的数据结构
print(universal_accessor({'x': 1}, 'x'))        # 1
print(universal_accessor({'x': 1}, 'y'))        # 访问错误: KeyError - 'y'
print(universal_accessor([1, 2, 3], 1))         # 2
print(universal_accessor([1, 2, 3], 10))        # 访问错误: IndexError - list index out of range
print(universal_accessor("string", 2))          # r
print(universal_accessor(123, 0))               # 类型错误: 'int' object is not subscriptable
实际项目中的应用
来看一个更像真实项目的例子,展示如何在复杂系统中优雅地处理KeyError:
import json
from datetime import datetime
from typing import Dict, Any, Optional

class DataProcessor:
    """数据处理器类"""

    def __init__(self):
        self.processing_rules = {}
        self.error_log = []

    def load_processing_rules(self, rules_file: str) -> bool:
        """加载处理规则"""
        try:
            with open(rules_file, 'r', encoding='utf-8') as f:
                self.processing_rules = json.load(f)
            return True
        except FileNotFoundError:
            self._log_error(f"规则文件 {rules_file} 未找到")
            return False
        except json.JSONDecodeError as e:
            self._log_error(f"规则文件格式错误: {e}")
            return False
        except Exception as e:
            self._log_error(f"加载规则时发生未知错误: {e}")
            return False

    def process_data_item(self, item: Dict[str, Any]) -> Optional[Dict[str, Any]]:
        """处理单个数据项"""
        try:
            processed_item = {}

            # 获取基本字段
            processed_item['id'] = item['id']
            processed_item['timestamp'] = item.get('timestamp', datetime.now().isoformat())

            # 根据类型处理数据
            item_type = item.get('type')
            if not item_type:
                self._log_error(f"数据项 {item.get('id', 'unknown')} 缺少类型字段")
                return None

            # 应用对应的处理规则
            processing_rule = self.processing_rules.get(item_type)
            if not processing_rule:
                self._log_error(f"未找到类型 {item_type} 的处理规则")
                return None

            # 处理具体字段
            for field_name, field_config in processing_rule.items():
                try:
                    source_field = field_config.get('source', field_name)
                    field_value = item[source_field]

                    # 应用转换规则
                    transform_type = field_config.get('transform')
                    if transform_type == 'uppercase':
                        field_value = str(field_value).upper()
                    elif transform_type == 'lowercase':
                        field_value = str(field_value).lower()
                    elif transform_type == 'integer':
                        field_value = int(field_value)

                    processed_item[field_name] = field_value

                except KeyError:
                    default_value = field_config.get('default')
                    if default_value is not None:
                        processed_item[field_name] = default_value
                    elif field_config.get('required', False):
                        self._log_error(f"必需字段 {field_name} 在数据项 {item['id']} 中缺失")
                        return None

            return processed_item

        except KeyError as e:
            self._log_error(f"处理数据项时缺少必要字段: {e}")
            return None
        except Exception as e:
            self._log_error(f"处理数据项时发生未知错误: {e}")
            return None

    def _log_error(self, message: str):
        """记录错误信息"""
        error_entry = {
            'timestamp': datetime.now().isoformat(),
            'message': message
        }
        self.error_log.append(error_entry)
        print(f"错误: {message}")

    def get_error_summary(self) -> Dict[str, int]:
        """获取错误摘要"""
        summary = {}
        for error in self.error_log:
            message = error['message']
            error_type = message.split(':')[0] if ':' in message else 'Unknown'
            summary[error_type] = summary.get(error_type, 0) + 1
        return summary

# 使用示例
processor = DataProcessor()

# 模拟处理规则
sample_rules = {
    "user": {
        "username": {"source": "name", "transform": "lowercase"},
        "email": {"source": "email_address"},
        "age": {"source": "years_old", "transform": "integer", "default": 0},
        "status": {"source": "active_status", "default": "inactive", "required": True}
    },
    "product": {
        "name": {"source": "product_name"},
        "price": {"source": "cost", "transform": "integer"},
        "category": {"source": "type", "default": "general"}
    }
}

# 保存规则到文件
with open('processing_rules.json', 'w', encoding='utf-8') as f:
    json.dump(sample_rules, f, ensure_ascii=False, indent=2)

# 加载规则
processor.load_processing_rules('processing_rules.json')

# 测试数据
test_data = [
    {
        "id": "001",
        "type": "user",
        "name": "Alice Smith",
        "email_address": "alice@example.com",
        "years_old": "25",
        "active_status": "active"
    },
    {
        "id": "002",
        "type": "user",
        "name": "Bob Johnson",
        "email_address": "bob@example.com"
        # 缺少 years_old 和 active_status
    },
    {
        "id": "003",
        "type": "product",
        "product_name": "Laptop",
        "cost": "1200"
    }
]

# 处理数据
processed_results = []
for item in test_data:
    result = processor.process_data_item(item)
    if result:
        processed_results.append(result)

print("n处理结果:")
for result in processed_results:
    print(json.dumps(result, ensure_ascii=False, indent=2))

print("n错误摘要:")
error_summary = processor.get_error_summary()
for error_type, count in error_summary.items():
    print(f"{error_type}: {count}")
最佳实践总结
基于上面的讨论,整理出处理KeyError的几个核心原则:
1. 预防优于治疗
能用安全方法访问字典值就别直接硬来:
# 推荐:使用get()方法
value = my_dict.get('key', default_value)

# 不推荐:直接访问可能不存在的键
try:
    value = my_dict['key']
except KeyError:
    value = default_value
2. 合理使用defaultdict
需要自动创建默认值时,defaultdict是首选:
from collections import defaultdict

# 计数器场景
counter = defaultdict(int)
items = ['apple', 'banana', 'apple', 'cherry', 'banana', 'apple']
for item in items:
    counter[item] += 1

print(dict(counter))  # {'apple': 3, 'banana': 2, 'cherry': 1}
3. 提供有意义的默认值
用get()时,别随便返回None,给个合理的默认值:
# 更好的默认值
user_settings = {
    'theme': 'light',
    'notifications': True
}

# 提供有意义的默认值
theme = user_settings.get('theme', 'light')  # 而不是 None
notifications = user_settings.get('notifications', True)  # 而不是 None
max_retries = user_settings.get('max_retries', 3)  # 合理的默认重试次数
4. 记录和监控异常
建立日志机制来跟踪KeyError的发生:
import logging

logger = logging.getLogger(__name__)

def safe_dict_access(dictionary, key, context=""):
    """安全的字典访问,带日志记录"""
    try:
        return dictionary[key]
    except KeyError as e:
        logger.warning(f"字典访问失败 - 上下文: {context}, 键: {key}, 可用键: {list(dictionary.keys())}")
        raise  # 重新抛出异常让上层处理
结语
KeyError是Python开发中躲不开的坎,但完全可以用优雅的方式应对。理解它的成因,掌握各种预防和处理手段,再遵循上面提到的实践,你就能写出更健壮的代码。
优秀的程序员不光能解决问题,更能提前预防问题。操作字典时,永远要问自己:“这个键可能不存在吗?”提前想好应对方案,代码会变得更可靠。
随着你对Python的理解越来越深,处理这类问题会越来越得心应手。保持好奇心,多实践,你会发现自己写出的代码越来越优雅高效。




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。