


python08 - 操作文件和文件夹
Python操作文件和文件夹 在日常开发中,与文件和文件夹打交道是家常便饭。过去我们可能习惯使用os模块,但今天要介绍一个更精细、功能更强大的“升级版”工具——shutil模块。它能让你处理文件操作时更加得心应手。 好消息是,shutil是Python的内置模块,无需额外安装,开箱即用。 一:文件处
Python操作文件和文件夹
在日常开发中,与文件和文件夹打交道是家常便饭。过去我们可能习惯使用os模块,但今天要介绍一个更精细、功能更强大的“升级版”工具——shutil模块。它能让你处理文件操作时更加得心应手。
好消息是,
shutil是Python的内置模块,无需额外安装,开箱即用。
一:文件处理
1:文件的复制(shutil)
复制文件是基础操作,shutil.copy()方法就是为此而生。它的核心逻辑非常清晰:将源地址的文件复制到目标地址。
from shutil import copy
# 核心方法 -> 源地址赋值到目标地址
copy(src_path, dist_path)来看一个实际场景:如何批量复制一个文件夹下所有特定类型(比如.txt)的文件?
import os
from shutil import copy
'''
源地址文件夹,复制到目标文件夹
'''
def copy_files(src_dir, dest_dir):
    for file in os.listdir(src_dir):
        if file.endswith('.txt'):
            src_file = os.path.join(src_dir, file)
            dest_file = os.path.join(dest_dir, file)
            copy(src_file, dest_file)

if __name__ == '__main__':
    src_dir = 'C:/Users/user/Documents/txt'
    dest_dir = 'C:/Users/user/Documents/txt_copy'
    copy_files(src_dir, dest_dir)
? 这里有个细节值得注意:当目标路径指向一个已存在的文件时,copy操作就变成了文件内容的覆盖。如果想纯粹地复制文件内容,可以使用更直接的copyfile函数。
import os
from shutil import copyfile
'''
文件内容的复制
copyfile(src - 源文件路径, dst - 目标文件路径)
'''
def copy_file_content(src, dst):
    copyfile(src, dst)

if __name__ == '__main__':
    src = input("Enter the source file path: ")
    dst = input("Enter the destination file path: ")
    copy_file_content(src, dst)
    print("File content copied successfully!")
2:裁剪和变相重命名(shutil)
所谓“裁剪”,其实就是移动文件。它将文件从路径A移动到路径B。移动后,路径A下的原文件就消失了,只存在于路径B。
这个过程天然支持重命名功能。你可以将文件从A移动到B并改名,甚至可以在同一目录下移动并改名,这就巧妙地实现了文件的重命名。
from shutil import move
move(src, dist)下面的例子展示了如何批量移动.txt文件:
import os
from shutil import move

def move_files(src_dir, dest_dir):
    for filename in os.listdir(src_dir):
        if filename.endswith('.txt'):
            src_file = os.path.join(src_dir, filename)
            dest_file = os.path.join(dest_dir, filename)
            move(src_file, dest_file)

if __name__ == '__main__':
    src_dir = '/home/user/Documents/office/txt'
    dest_dir = '/home/user/Documents/office/txt_files'
    move_files(src_dir, dest_dir)
3:文件的删除(os)
删除单个文件,使用os模块的remove函数通常就足够了。
from os import remove

def remove_file(file_path):
    remove(file_path)

if __name__ == '__main__':
    remove_file("txt01.py")
4:文件的压缩和解压缩(shutil)
shutil同样简化了压缩和解压操作。make_archive用于压缩,unpack_archive用于解压。
# 如果只需要压缩可以使用这个
from shutil import make_archive
# 如果只需要解压可以使用这个
from shutil import unpack_archive
# 如果只需要压缩可以使用这个
from shutil import make_archive
# 如果只需要解压可以使用这个
from shutil import unpack_archive
# src_dir中的文件压缩到dest_dir中
def zip_files(src_dir, zip_path):
# 压缩src_dir中的文件到dest_dir中,format是zip
make_archive(zip_path, 'zip', src_dir)
def unzip_files(zip_path, unpack_dir):
# 解压src_dir中的文件到dest_dir中
unpack_archive(zip_path, unpack_dir)
if __name__ == '__main__':
zip_files('E:\code_project\python\office\\txt', 'E:\code_project\python\office\\my_zip')
print('压缩完成')
unzip_files('E:\code_project\python\office\\my_zip.zip', 'E:\code_project\python\office\\txt2')
print('解压完成')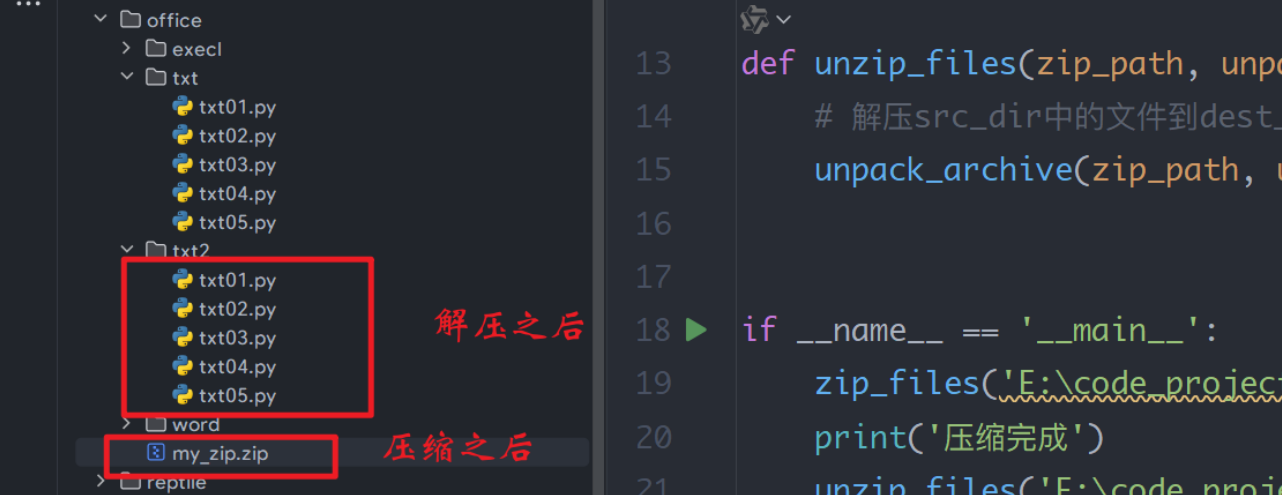
5:文件的查找(glob)
当需要快速定位文件时,glob模块是个利器。它支持通配符匹配,能帮你快速找到符合模式的文件。
import os
from glob import glob

def search_zip(base_path):
    # 搜索当前目录下所有zip文件
    # os.getcwd() -> 获取当前目录
    # /*.zip -> 搜索当前目录下所有zip文件
    search_path = base_path + "/*.zip"
    search_ans = glob(search_path)
    return search_ans

if __name__ == "__main__":
    base_path = 'E:\code_project\python\office'
    search_ans_of_office = search_zip(base_path)
    # ['E:\\code_project\\python\\office\\my_zip.zip']
    for ans in search_ans_of_office:
        print(ans)
    print("==========================================")
    # 注意是直接子节点就要有对应的文件,否则找不到
    # 例如将base_path范围扩大到上层目录,就没有了
    base_path = 'E:\code_project\python'
    search_ans_of_office = search_zip(base_path)
    # []
    for ans in search_ans_of_office:
        print(ans)
如果不使用通配符,而是明确知道文件名但不确定位置呢?这时可以结合递归进行深度查找。
final_result = []
# 通过名称递归查找文件到底在哪里
def search_by_name(base_path, name):
    search_path = base_path + "/*"
    search_ans = glob(search_path)
    for ans in search_ans:
        if os.path.isdir(ans):
            search_by_name(ans, name)
        else:
            if name in ans:
                final_result.append(ans)

if __name__ == "__main__":
    # 从base_path这个大文件中找到所有包含name的全路径结果
    base_path = "E:\code_project"
    name = "txt05.py"
    search_by_name(base_path, name)
    print(final_result)
更进一步,如果想查找包含特定内容的文件,就需要在判断为文件后,打开并读取内容进行匹配。
def search_all_by_content(base_path, content):
    search_path = base_path + "/*"
    search_ans = glob(search_path)
    for ans in search_ans:
        if os.path.isdir(ans):
            search_all_by_content(ans, content)
        else:
            with open(ans, 'r', encoding="utf-8") as f:
                # 读取文件内容
                con = f.read()
                if content in con:
                    final_result.append(ans)

if __name__ == "__main__":
    # 从base_path这个大文件中找到所有包含name的全路径结果
    base_path = "E:\code_project\python\office\\txt"
    content = "import os"
    search_all_by_content(base_path, content)
    print(final_result)
6:重复文件的清理(hashlib)
清理重复文件的原理很直观:利用hashlib计算文件的哈希值(如MD5),哈希值相同的文件即为重复文件,随后删除即可。
为了提升易用性,下面的示例结合了tkinter创建图形界面,在删除前进行二次确认。
import hashlib

def file_hash(file_path):
    hash_md5 = hashlib.md5()
    # 创建md5对象, 准备计算文件的md5
    with open(file_path, 'rb') as f:
        # 读取文件内容,每次读取4k,防止文件过大一次性加载到内存造成的性能等问题
        for chunk in iter(lambda: f.read(4096), b""):
            hash_md5.update(chunk)
    return hash_md5.hexdigest() # 返回文件的md5值
import hashlib
import os
import tkinter as tk
from tkinter import messagebox
def file_hash(file_path):
hash_md5 = hashlib.md5()
# 创建md5对象, 准备计算文件的md5
with open(file_path, 'rb') as f:
# 读取文件内容,每次读取4k,防止文件过大一次性加载到内存造成的性能等问题
for chunk in iter(lambda: f.read(4096), b""):
hash_md5.update(chunk)
return hash_md5.hexdigest() # 返回文件的md5值
def get_same_and_delete(base_path):
"""在指定目录下查找并确认删除重复文件"""
hashes = {}
duplicates = []
# 遍历指定目录及其所有子目录
# os.walk(base_path) -> 遍历指定目录及其所有子目录
# os.walk(directory) 是一个生成器函数,它会递归地遍历指定目录及其所有子目录
# 并返回一个三元组 (root, dirs, files)。具体来说,每次迭代时,os.walk 会返回以下内容:
# - root (str): 当前遍历到的目录路径。
# - dirs (list): 当前目录下的子目录列表(不包括子目录的子目录)。
# - files (list): 当前目录下的文件列表。
for dirpath, _, filenames in os.walk(base_path):
for filename in filenames:
filepath = os.path.join(dirpath, filename) # 获取文件的完整路径
try:
# 计算文件的md5值,如果之前有相同的md5值,说明该文件是重复的文件
file_hash_value = file_hash(filepath)
if file_hash_value in hashes:
# 此时找到了重复的文件,追加到重复文件列表中,一会进行删除询问
duplicates.append(filepath)
else:
# 否则将文件的md5值和文件路径添加到字典中
hashes[file_hash_value] = filepath
except Exception as e:
print(f"Error processing file {filepath}: {e}")
# 创建Tkinter根窗口
root = tk.Tk()
root.withdraw() # 隐藏主窗口
# 遍历重复文件列表,逐个确认是否删除
for dup in duplicates:
# 显示确认对话框
response = messagebox.askyesno("是否确认删除?", f"你要删除这个重复文件吗?:\n{dup}")
if response:
# 如果确定删除,则删除该文件,否则跳过删除
try:
os.remove(dup)
print(f"已经删除了重复文件: {dup}")
except Exception as e:
print(f"删除文件错误 {dup}: {e}")
else:
print(f"你跳过了该重复文件: {dup}")
root.destroy() # 销毁Tkinter根窗口
if __name__ == '__main__':
base_path = r"E:\code_project\python\office\txt"
get_same_and_delete(base_path)7:批量修改文件名称(shutil & glob)
批量重命名的核心思路很明确:首先确定需要修改的文件名特征,然后通过循环遍历,将目标字符串插入或替换到原文件名中,最后使用shutil.move完成重命名。
import shutil
import glob
import os

def update_name(base_path):
    result = glob.glob(base_path)
    for index, data in enumerate(result):
        if os.path.isdir(data):
            _path = os.path.join(data, '*') # 获取当前目录下所有文件
            update_name(_path) # 递归调用
        else:
            # 不是文件夹,是文件了
            path_list = os.path.split(data) # 单独把名字拿出来
            name = path_list[-1]
            # 生成一个新的名称
            new_name = '%s_%s' % (index, name)
            # 替换旧名称
            new_data = os.path.join(path_list[0], new_name)
            shutil.move(data, new_data)

if __name__ == '__main__':
    base_path = r'E:\code_project\python\office\txt2'
    update_name(base_path)
二:文件夹处理
1:文件夹的复制(shutil)
复制整个文件夹树,使用shutil.copytree()方法可以一键搞定。
from shutil import copytree

def copy_files(src_dir, dest_dir):
    copytree(src_dir, dest_dir)

if __name__ == '__main__':
    src_dir = 'C:/Users/user/Documents/txt'
    dest_dir = 'C:/Users/user/Documents/txt_copy'
    copy_files(src_dir, dest_dir)
2:文件夹的删除(shutil)
删除整个文件夹及其所有内容,shutil.rmtree()是你的不二之选。它比os.rmdir更强大,后者只能删除空目录。
import os.path
from shutil import rmtree

def remove_file(file_path):
    if os.path.isfile(file_path):
        os.remove(file_path)
        print(f"文件 {file_path} 已被删除")
    else:
        try:
            rmtree(file_path)
            print(f"文件夹 {file_path} 已被删除")
        except Exception as e:
            print(f"删除文件错误 {file_path}: {e}")
3:文件夹的裁剪和重命名(shutil)
文件夹的移动(裁剪)和重命名,使用的函数与文件操作完全一样——shutil.move(src, dist)。这个函数足够智能,能正确处理整个目录树的移动和更名。




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。