


Python爬取北京二手房数据,北漂买房分析及源码分享
作者徐麟本文经授权转自公众号数据森麟(ID:shujusenlin)房价高是北漂们一直关心的话题,本文就对北京的二手房数据进行了分析。本文主要分为两部分:Python爬取赶集网北京二手房数据,R对爬取的二手房房价做线性回归分析,适合刚刚接触Python&R的同学们学习参考。01Python爬取赶集网北京二手房数据入门爬虫一个月,所以对每一个网站都使用了Xpath、BeautifulSoup、正则三种方法分别爬取,用于练习巩固。数据来源如下:Xpath爬取:这里主要解决运用Xpath如何判断某些元素是
作者 徐麟
本文经授权转自公众号数据森麟(ID: shujusenlin)
房价高是北漂们一直关心的话题,本文就对北京的二手房数据进行了分析。
本文主要分为两部分:Python爬取赶集网北京二手房数据,R对爬取的二手房房价做线性回归分析,适合刚刚接触Python&R的同学们学习参考。
01
Python爬取赶集网北京二手房数据
入门爬虫一个月,所以对每一个网站都使用了Xpath、Beautiful Soup、正则三种方法分别爬取,用于练习巩固。数据来源如下:
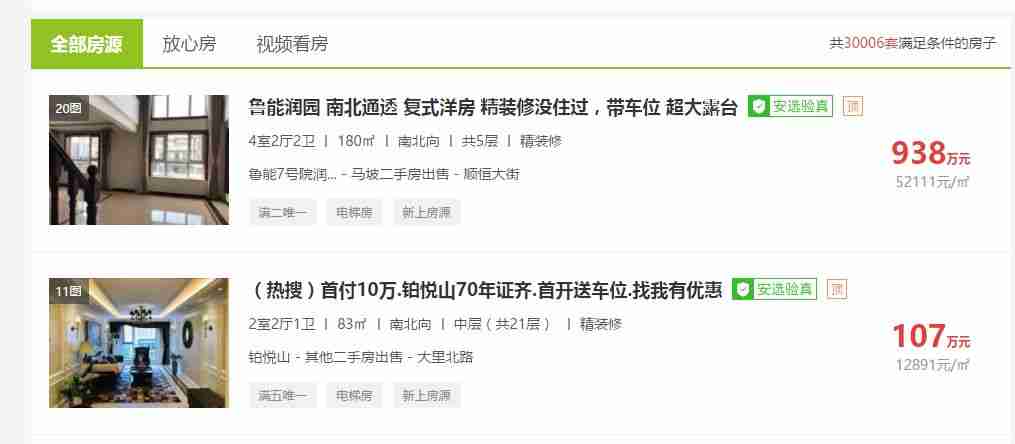
Xpath爬取:
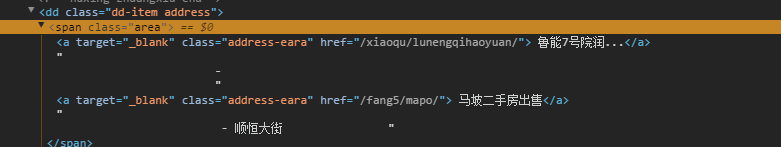
这里主要解决运用Xpath如何判断某些元素是否存在的问题,比如如果房屋没有装修信息,不加上判断,某些元素不存在就会导致爬取中断。
代码语言:javascript代码运行次数:0运行复制import requestsfrom lxml import etreefrom requests.exceptions import RequestExceptionimport multiprocessingimport timeheaders = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}def get_one_page(url): try: response = requests.get(url, headers=headers) if response.status_code == 200: return response.text return None except RequestException: return Nonedef parse_one_page(content): try: selector = etree.HTML(content) ALL = selector.xpath('//*[@id="f_mew_list"]/div[6]/div[1]/div[3]/div[1]/div') for div in ALL: yield { 'Name': div.xpath('dl/dd[1]/a/text()')[0], 'Type': div.xpath('dl/dd[2]/span[1]/text()')[0], 'Area': div.xpath('dl/dd[2]/span[3]/text()')[0], 'Towards': div.xpath('dl/dd[2]/span[5]/text()')[0], 'Floor': div.xpath('dl/dd[2]/span[7]/text()')[0].strip().replace('\n', ""), 'Decorate': div.xpath('dl/dd[2]/span[9]/text()')[0], #地址需要特殊处理一下 'Address': div.xpath('dl/dd[3]//text()')[1]+div.xpath('dl/dd[3]//text()')[3].replace('\n','')+div.xpath('dl/dd[3]//text()')[4].strip(), 'TotalPrice': div.xpath('dl/dd[5]/div[1]/span[1]/text()')[0] + div.xpath('dl/dd[5]/div[1]/span[2]/text()')[0], 'Price': div.xpath('dl/dd[5]/div[2]/text()')[0] } if div['Name','Type','Area','Towards','Floor','Decorate','Address','TotalPrice','Price'] == None:##这里加上判断,如果其中一个元素为空,则输出None return None except Exception: return Nonedef main(): for i in range(1, 500):#这里设置爬取500页数据,在数据范围内,大家可以自设置爬取的量 url = 'http://bj.ganji.com/fang5/o{}/'.format(i) content = get_one_page(url) print('第{}页抓取完毕'.format(i)) for div in parse_one_page(content): print(div)if __name__ == '__main__': main()Beautiful Soup爬取:
代码语言:javascript代码运行次数:0运行复制import requestsimport refrom requests.exceptions import RequestExceptionfrom bs4 import BeautifulSoupimport csvimport timeheaders = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}def get_one_page(url): try: response = requests.get(url,headers = headers) if response.status_code == 200: return response.text return None except RequestException: return Nonedef parse_one_page(content): try: soup = BeautifulSoup(content,'html.parser') items = soup.find('div',class_=re.compile('js-tips-list')) for div in items.find_all('div',class_=re.compile('ershoufang-list')): yield { 'Name':div.find('a',class_=re.compile('js-title')).text, 'Type': div.find('dd', class_=re.compile('size')).contents[1].text,#tag的 .contents 属性可以将tag的子节点以列表的方式输出 'Area':div.find('dd',class_=re.compile('size')).contents[5].text, 'Towards':div.find('dd',class_=re.compile('size')).contents[9].text, 'Floor':div.find('dd',class_=re.compile('size')).contents[13].text.replace('\n',''), 'Decorate':div.find('dd',class_=re.compile('size')).contents[17].text, 'Address':div.find('span',class_=re.compile('area')).text.strip().replace(' ','').replace('\n',''), 'TotalPrice':div.find('span',class_=re.compile('js-price')).text+div.find('span',class_=re.compile('yue')).text, 'Price':div.find('div',class_=re.compile('time')).text } #有一些二手房信息缺少部分信息,如:缺少装修信息,或者缺少楼层信息,这时候需要加个判断,不然爬取就会中断。 if div['Name', 'Type', 'Area', 'Towards', 'Floor', 'Decorate', 'Address', 'TotalPrice', 'Price'] == None: return None except Exception: return Nonedef main(): for i in range(1,50): url = 'http://bj.ganji.com/fang5/o{}/'.format(i) content = get_one_page(url) print('第{}页抓取完毕'.format(i)) for div in parse_one_page(content): print(div) with open('Data.csv', 'a', newline='') as f: # Data.csv 文件存储的路径,如果默认路径就直接写文件名即可。 fieldnames = ['Name', 'Type', 'Area', 'Towards', 'Floor', 'Decorate', 'Address', 'TotalPrice', 'Price'] writer = csv.DictWriter(f, fieldnames=fieldnames) writer.writeheader() for item in parse_one_page(content): writer.writerow(item) time.sleep(3)#设置爬取频率,一开始我就是爬取的太猛,导致网页需要验证。if __name__=='__main__': main()正则爬取:我研究了好久,还是没有解决。
这一过程中容易遇见的问题有:
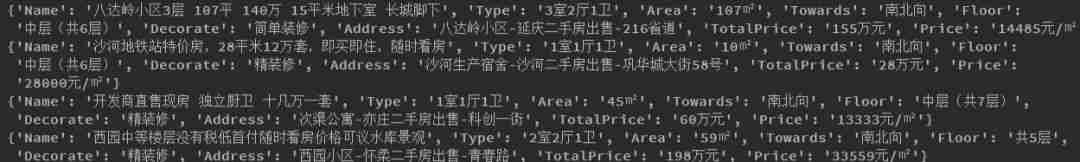
有一些房屋缺少部分信息,如缺少装修信息,这个时候需要加一个判断,如果不加判断,爬取就会自动终止(我在这里跌了很大的坑)。Data.csv知识点存储文件路径默认是工作目录,关于Python中如何查看工作目录:代码语言:javascript代码运行次数:0运行复制import os #查看pyhton 的默认工作目录print(os.getcwd())#修改时工作目录os.chdir('e:\\workpython')print(os.getcwd())#输出工作目录e:\workpythonPycharm中打印如下:
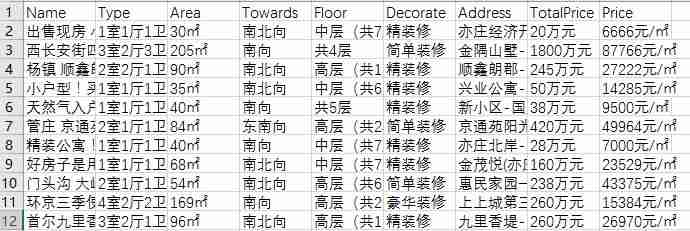
将字典循环直接写入CSV效果如下:
02
R对爬取的二手房房价做一般线性回归分析
下面我们用R对抓取的赶集网北京二手房数据做一些简单的分析。
数据的说明
数据清洗
代码语言:javascript代码运行次数:0运行复制data<-read.csv("E://Data For R/RData/data.csv")DATA<-data[,-c(1,7)]#将Name和Address两列去掉DATA[sample(1:nrow(DATA),size=10),]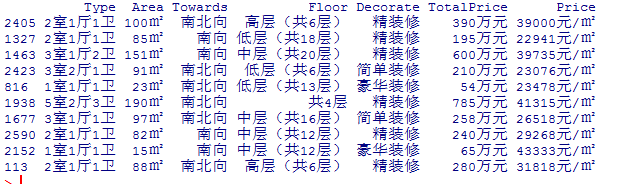
#在爬取的时候加入了判断,所以不知道爬取的数据中是否存在缺失值,这里检查一下colSums(is.na(DATA))
#这里将Type的卧室客厅和卫生间分为三个不同的列##这里需要注意,有一些房屋没有客厅如:1室1卫这时候需要单独处理,还有一些没有厕所信息。library(tidyr)library(stringr)DATA=separate(data=DATA,col=Type,into = c("Bedrooms","Halls"),sep="室")DATA=separate(data=DATA,col=Halls,into = c("Halls","Toilet"),sep="厅")##将卫生间后面的汉字去掉DATA$Toilet<-str_replace(DATA$Toilet,"卫","")###如图六,将Halls中带有汉字去掉,因为有一些房屋信息没有客厅,如:1室1厅,在分成卧室和客厅时,会将卫生间分到客厅一列。DATA$Halls<-str_replace(DATA$Halls,"卫","")##取出没有客厅信息的数据,这些数据被separate到Halls列newdata<-DATA[which(DATA$Toilet %in% NA),2]newdata##将没有客厅的房屋信息Halls列填充为0DATA[which(DATA$Toilet %in% NA),2]<-0DATA[which(DATA$Toilet %in% NA),3]<-newdatacolSums(DATA=="") Bedrooms Halls Toilet Area Towards Floor Decorate 0 0 2 0 0 0 0 TotalPrice Price 0 0 ##发现有2个厕所没有信息,将其填写为0。DATA$Toilet[DATA$Toilet == ""]<-0
##这里将Area后的㎡去掉DATA$Area<-str_replace(DATA$Area,"㎡","")##查看Towards的类型table(DATA$Towards)Towards 北向 东北向 东南向 东西向 东向 南北向 南向 西北向 51 25 23 50 65 32 1901 678 38 西南向 西向 28 26 ##将Floor信息带括号的全部去除DATA$Floor<-str_replace(DATA$Floor,"[(].*[)]","")##正则表达式#查看Floor的类别信息 低层 地下 高层 共1层 共2层 共3层 共4层 共5层 中层 632 32 790 36 61 101 68 130 1016 #分别将TotalPrice和Price后面的万元、元/㎡去掉DATA$TotalPrice<-str_replace(DATA$TotalPrice,"万元","")DATA$Price<-str_replace(DATA$Price,"元/㎡","")head(DATA)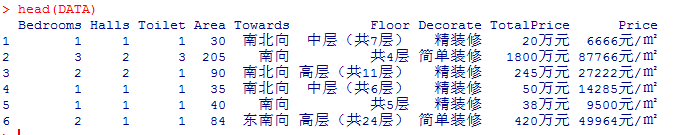
##将数据转换格式DATA$Bedrooms<-as.factor(DATA$Bedrooms)DATA$Halls<-as.factor(DATA$Halls)DATA$Toilet<-as.factor(DATA$Toilet)DATA$Area<-as.numeric(DATA$Area)DATA$TotalPrice<-as.numeric(DATA$TotalPrice)DATA$Price<-as.numeric(DATA$Price)DATA$Towards<-as.factor(DATA$Towards)DATA$Decorate<-as.factor(DATA$Decorate)str(DATA)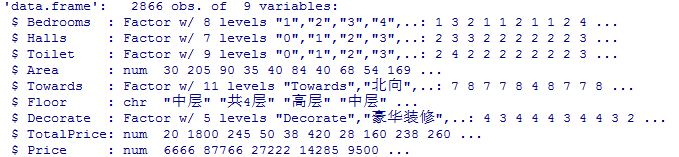


















Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Xcode 是苹果面向 Mac 提供的官方集成开发环境,将代码编辑、项目构建、SwiftUI 实时预览、设备模拟、自动化测试、断点调试、性能分析和应用分发整合在同一套工作流中,适合开发与维护 iPhone、iPad、Mac、Apple Wa

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

Visual Studio Code 是微软提供的免费代码编辑器,支持 macOS,并为 Intel 与 Apple 芯片 Mac 提供适配版本。软件集代码编辑、调试、Git 源代码管理、集成终端和扩展市场于一体。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Pro Tools 是 Avid 推出的专业数字音频工作站,覆盖多轨录音、无损剪辑、MIDI 编曲、插件处理、自动化混音及声音与画面同步等工作。它拥有 Intro、Artist、Studio 和 Ultimate 等方案。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

Visual Studio Code 是微软推出的免费代码编辑器,Windows 版集成智能补全、代码导航、调试、终端和版本控制,并可通过扩展添加语言、格式化及远程开发能力。它启动较快、配置灵活,

REAPER 是 Cockos 推出的数字音频工作站,适用于录音、MIDI 编曲、音频编辑、混音、母带制作及声音设计。软件安装包小巧,支持多轨录制、灵活路由、自动化、第三方插件和脚本扩展,并提供完整功能的 60 天免费评估期。

Adobe Audition 是面向播客、影视后期、广播与音乐制作的专业音频工作站,提供波形编辑、多轨混音、频谱分析、录音、降噪修复和效果处理等功能。Windows 版通过 Adobe Creative Cloud 安装和管理,

Pro Tools 是 Avid 推出的专业数字音频工作站,提供多轨录音、音频剪辑、MIDI编曲、插件处理、自动化混音及影视声音制作能力。它适合音乐人、录音师、制作人和音频后期团队使用,并提供免费入门版、订阅方案及永久授权选择。