


Python中如何实现列表去重?
方式##1.新建列表,如果新列表中不存在,则添加到新列表。defunique(data):new_list=[]foritemindata:ifitemnotinnew_list:new_list.append(item)returnnew_list#testdata=['a','a',1,1,2,2,'b','b',2,1]start_time=time.time()print("new_list+notindata:",unique(da
方式
## 1. 新建列表,如果新列表中不存在,则添加到新列表。 def unique(data): new_list = [] for item in data: if item not in new_list: new_list.append(item) return new_list # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("new_list + not in data:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") # result $ python -V Python 2.7.16 $ python unique.py ('for list + not in. data:', ['a', 1, 2, 'b']) time:0.0441074371338 ms ## 2. 新建列表。根据下标判断是否存在新列表中,如果新列表中不存在则添加到新列表。 def unique(data): new_list = [] for i in range(len(data)): if data[i] not in new_list: new_list.append(data[i]) return new_list ## 2.1 新建列表,使用列表推导来去重。是前一种的简写。 def unique(data): new_list = [] [new_list.append(i) for i in data if not i in new_list] return new_list # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("for range + not in. data:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 3. 通过index找不到该项,则追加到新列表中。index找不到会报错,因此放在异常处理里。 def unique(data): new_list = [] for i in range(len(data)): item = data[i] try: if (new_list.index(item) < 0): print('new_list:', new_list) except ValueError: new_list.append(item) return new_list # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("list index + except:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 4. 新建列表,两个循环。如果内循环与外循环项相同,且下标相同就添加到新列表,其余忽略 def unique(data): new_list = [] for i in range(len(data)): j = 0 while j <= i: if data[i] == data[j]: if i == j: new_list.append(data[i]) break j += 1 return new_list # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("new list + for. new_list:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 5. 在原有列表上移除重复项目。自后往前遍历,逐个与前面项比较,如果值相同且下标相同,则移除当前项。 def unique(data): l = len(data) while (l > 0): l -= 1 i = l while i > 0: i -= 1 if data[i] == data[l]: del data[l] break return data # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("one list while. last -> first result. data:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 6. 在原有列表上移除重复项目。自前往后遍历,逐个与后面项比较,如果值相同且下标相同,则移除当前项。 def unique(data): l = len(data) i = 0 while i < l: j = i + 1 while j < l: if data[i] == data[j]: del data[j] l -= 1 i -= 1 break j += 1 i += 1 return data # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("one list while. first -> last result. data:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 7. 新建列表。遍历列表,利用index比较出现的位置,如果出现在第一次的位置则追加到新数组。 def unique(data): new_list = [] for i in range(len(data)): if i == data.index(data[i]): new_list.append(data[i]) return new_list # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("for range + index. data:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 8. 利用字典属性唯一性来实现去重复。 def unique(data): obj = {} for item in data: obj[item] = item return obj.values() # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("list + dict:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 或者直接通过dict.fromkeys来实现 print("dict fromkeys:", dict.fromkeys(data).keys()) ## 9. 利用filter函数,即把不符合条件的过滤掉。这里filter不支持下标,因此需要借助外部列表存储不重复项 def uniq(item): i = data.index(item) if (item not in new_list): new_list.append(item) return True return False def unique(item): if obj.get(item) == None: obj[item] = item return True return False # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() new_list = [] print('filter + list + not in: ', filter(uniq, data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 10. 利用字典结合过滤来实现去重复。 def unique(item): if obj.get(item) == None: obj[item] = item return True return False # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() obj = {} print("filter + dict + get:", filter(unique, data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 11. 利用map来实现去重复。与map与filter类似,是一个高阶函数。可以针对其中项逐个修改操作。 ## 与filter不同map会保留原有项目,并不会删除,因此值可以改为None,然后再过滤掉。 def unique(item): if item not in new_list: new_list.append(item) return item return None # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] new_list = [] start_time = time.time() print("list from Map:", filter(lambda item: item != None, map(unique, data))) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 12. 利用set数据结构里key的唯一性来去重复 data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] print("from Set:", list(set(data))) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 13. 提前排序,从后向前遍历,将当前项与前一项对比,如果重复则移除当前项 def unique(data): data.sort() l = len(data) while (l > 0): l -= 1 if (data[l] == data[l - 1]): data.remove(data[l]) return data # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("sort + remove:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 14. 提前排序,自前往后遍历,将当前项与后一项对比,如果重复则移除当前项 def unique(data): """ in python 3: TypeError: '<' not supported between instances of 'int' and 'str' need to keep the same Type of member in List """ data.sort() l = len(data) - 1 i = 0 while i < l: if (data[i] == data[i + 1]): del data[i] i -= 1 l -= 1 i += 1 return data # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("sort+del ASE:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 15. 利用reduce函数来去重复。reduce具有累计的作用,判断如果不在累计结果中出现,则追加到结果中。 import functools def unique(data): new_list = [] def foo(result, item): if isinstance(result, list) == False: result = [result] return result if item in result else result + [item] return functools.reduce(foo, data) # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("functools.reduce:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 16. 利用递归调用来去重复。递归自后往前逐个调用,当长度为1时终止。 ## 当后一项与前任一项相同说明有重复,则删除当前项。相当于利用自我调用来替换循环 def recursion_unique(data, len): if (len <= 1): return data l = len last = l - 1 is_repeat = False while (l > 1): l -= 1 if (data[last] == data[l - 1]): is_repeat = True break if (is_repeat): del data[last] return recursion_unique(data, len - 1) # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("recursion_unique:", recursion_unique(data, len(data))) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 17. 利用递归调用来去重复的另外一种方式。递归自后往前逐个调用,当长度为1时终止。 ## 与上一个递归不同,这里将不重复的项目作为结果拼接起来 def recursion_unique_new(data, len): if (len <= 1): return data l = len last = l - 1 is_repeat = False while (l > 1): l -= 1 if (data[last] == data[l - 1]): is_repeat = True break if (is_repeat): del data[last:] result = [] else: result = [data[last]] return recursion_unique_new(data, len - 1) + result # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("recursion_unique_new:", recursion_unique_new(data, len(data))) print("time:" + str((time.time() - start_time) * 1000) + " ms") ## 18. 利用numpy lib库. 需提前安装 `pip install numpy` import numpy as np def unique(data): res = np.array(data) return list(np.unique(res)) # test data = ['a', 'a', 1, 1, 2, 2, 'b', 'b', 2, 1] start_time = time.time() print("import numpy as np.unique:", unique(data)) print("time:" + str((time.time() - start_time) * 1000) + " ms")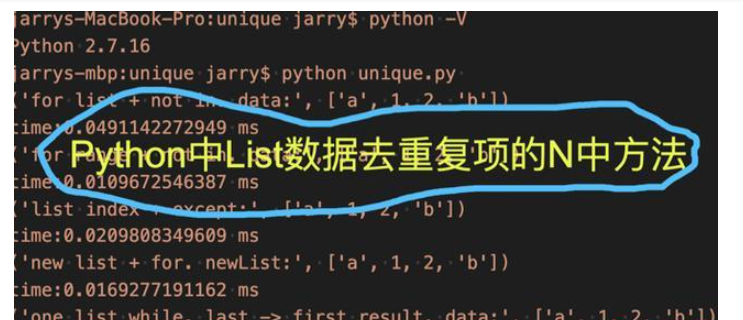




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。