


Python内存管理器中的池化技术实现
前言Python中一切皆对象,这些对象的内存都是在运行时动态地在堆中进行分配的,就连Python虚拟机使用的栈也是在堆上模拟的。既然一切皆对象,那么在Python程序运行过程中对象的创建和释放就很频繁了,而每次都用malloc()和free()去向操作系统申请内存或释放内存就会对性能造成影响,毕竟这些函数最终都要发生系统调用引起上下文的切换。其实核心就是池化技术,一次性向操作系统申请一批连续的内存空间,每次需要创建对象的时候就在这批空间内找到空闲的内存块进行分配,对象释放的时候就将对应的内存块标记为空闲,
前言
Python 中一切皆对象,这些对象的内存都是在运行时动态地在堆中进行分配的,就连 Python 虚拟机使用的栈也是在堆上模拟的。既然一切皆对象,那么在 Python 程序运行过程中对象的创建和释放就很频繁了,而每次都用 malloc() 和 free() 去向操作系统申请内存或释放内存就会对性能造成影响,毕竟这些函数最终都要发生系统调用引起上下文的切换。
其实核心就是池化技术,一次性向操作系统申请一批连续的内存空间,每次需要创建对象的时候就在这批空间内找到空闲的内存块进行分配,对象释放的时候就将对应的内存块标记为空闲,这样就避免了每次都向操作系统申请和释放内存,只要程序中总的对象内存空间稳定,Python 向操作系统申请和释放内存的频率就会很低。这种方案是不是很熟悉,数据库连接池也是类似的思路。一般后端应用程序也是提前跟数据库建立多个连接,每次执行 SQL 的时候就从中找一个可用的连接与数据库进行交互,SQL 完成的时候就将连接交还给连接池,如果某个连接长时间未被使用,连接池就会将其释放掉。本质上,这些都是用空间换时间,消耗一些不算太大的内存,降低诸如内存申请和 TCP 建立连接等耗时操作的频率,提高程序整体的运行速度。
内存层次结构
Python 内存管理器对内存进行了分层,从大到小分别为 arena、pool 和 block。arena 是内存管理器直接调用 malloc() 或 calloc() 向操作系统申请的一大块内存,Python 中对象的创建和释放都是在 arena 中进行分配和回收。在 arena 内部又分成了多个 pool,每个 pool 内又分成了多个大小相等的 block,每次分配内存的时候都是从某个 pool 中选择一块可用的 block 返回。每个 pool 内的 block 的大小是相等的,不同 pool 的 block 大小可以不等。
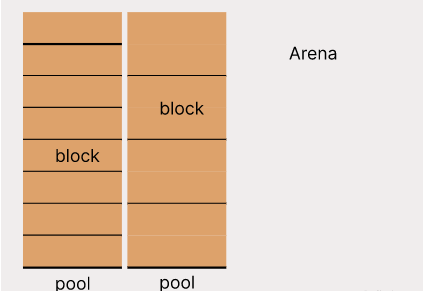
arena、pool 和 block 的大小在 32 位机器和 64 位机器上有所不同,block 的大小必须是 ALIGNMENT 的倍数,并且最大为 512 字节,下表列出了不同机器上各种内存的大小。
| 32 位机器 | 64 位机器 | |
|---|---|---|
| arena size | 256 KB | 1 MB |
| pool size | 4 KB | 16 KB |
| ALIGNMENT | 8 B | 16 B |
以 64 位机器为例,所有可能的 block 的大小为 16、32、48 … 496、512,每个大小都对应一个分级(size class),从小到大依次为0、1、2 … 30、31。每次分配内存的时候就是找到一个不小于请求大小的最小的空闲 block。对 block 的大小进行分级是为了适应不同大小的内存请求,减少内存碎片的产生,提高 arena 的利用率。
内存管理逻辑
了解了 arena、pool 和 block 的概念后就可以描述内存分配的逻辑了,假如需要的内存大小为 n 字节
如果 n > 512,回退为 malloc(),因为 block 最大为 512 字节
否则计算出不小于 n 的最小的 block size,比如 n=105,在 64 位机器上最小的 block size 为 112
找到对应 2 中 block size 的 pool,从中分配一个 block。如果没有可用的 pool 就从可用的 arena 中分配一个 pool,如果没有可用的 arena 就用 malloc() 向操作系统申请一块新的 arena
释放内存的逻辑如下
先判断要释放的内存是不是由 Python 内存管理器分配的,如果不是直接返回
找到要释放的内存对应的 block 和 pool,并将 block 归还给 pool,留给下次分配使用
如果释放的 block 所在的 arena 中除了自己之外其他的都是空闲的,那么在 block 归还之后整个 arena 都是空闲的,就可以将 arena 用 free() 释放掉还给操作系统
Python 中的对象一般都不大,并且生命周期很短,所以 arena 一旦申请之后,对象的分配和释放大部分情况下都是在 arena 中进行的,提高了效率。
上文已经将 Python 内存管理器的核心逻辑描述清楚了,只不过有一些细节的问题还没解决,比如内存分配的时候怎么根据 block size 找到对应的 pool,这些 pool 之间怎么关联起来的,内存释放的时候又是怎么判断要释放的内存是不是 Python 内存管理器分配的,等等。下面结合源码将内存分配和释放的逻辑详细展开。
先介绍 arena 和 pool 的内存布局和对应的数据结构,然后再具体分析 pymalloc_alloc() 和 pymalloc_free() 的逻辑,以 64 位机器为例介绍。
内存布局及对应的数据结构
Arena
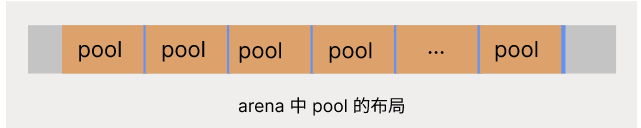
arena 为 1 MB,pool 为 16 KB,pool 在 arena 中是相邻的,一个 arena 中最多有 1 MB / 16 KB = 64 个 pool。Python 内存管理器会将 arena 中第一个 pool 的首地址跟 POOL_SIZE 对齐,这样每个 pool 的首地址都是 POOL_SIZE 的整数倍,给定任意内存地址都可以很方便的计算出其所在 pool 的首地址,这个特性在内存释放的时候会用到。POOL_SIZE 在 32 位机器上是 4 KB,在 64 位机器上是 16 KB,这样做还有另外一个好处就是让每个 pool 正好落在一个或多个物理页中,提高了访存效率。上图中的灰色内存块就是为了对齐而丢弃掉的,如果 malloc() 分配的内存首地址恰好对齐了,那么 pool 的数量就是 64,否则就是 63。当然 arena 不是一开始就将全部的 pool 都划分出来,而是在没有可用的 pool 的时候才会去新划分一个,当所有的 pool 全部划分之后布局如上图所示。
每个 arena 都由结构体 struct arena_object 来表示,但不是所有 struct arena_object 都有对应的 arena,因为 arena 释放之后对应的 struct arena_object 还保留着,这些没有对应 arena 的 struct arena_object 存放在单链表 unused_arena_objects 中,在下次分配 arena 时可以拿来使用。如果 struct arena_object 有对应的 arena,并且 arena 中有可以分配的 pool,那么 struct arena_object 会存放在 usable_arenas 这个双向链表中,同时,所有的 struct arena_object 无论有没有对应的 arena 都存在数组 arenas 中。usable_arenas 中 arena 是按照其包含的空闲 pool 的数量从小到大排序的,这么排序是为了让已经使用了更多内存的 arena 在下次分配 pool 的时候优先被使用,那么在释放内存的时候排在后面的那些拥有更多空闲内存的 arena 就有更大可能变成完全空闲状态,从而被释放掉将其内存空间归还给操作系统,降低整体的内存消耗。
struct arena_object 的结构及各字段含义如下
struct arena_object {
    uintptr_t address; // 指向 arena 的起始地址,如果当前 arena_object 没有对应的 arena 内存则 address = 0
    block* pool_address; // pool 需要初始化之后才能使用,pool_address 指向的地址可以用来初始化一个 pool 用于分配
    int nfreepools; // arena 中目前可以用来分配的 pool 的数量
    uint ntotalpools; // arena 中 pool 的总数量,64 或 63
    struct pool_header* freepools; // arena 中可以分配的 pool 构成一个单链表,freepools 指针是单链表的第一个节点
    struct arena_object* nextarena; // 在 usable_arenas 或 unused_arena_objects 指向下一个节点
    struct arena_object* prevarena; // 在 usable_arenas 中指向上一个节点
}
Pool
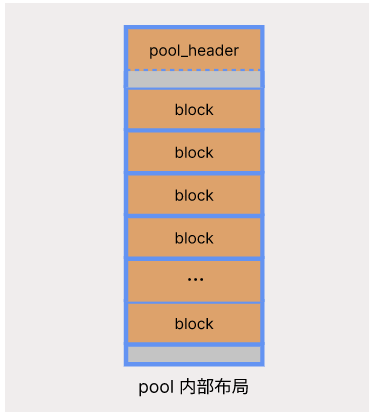
pool 的内部等分成多个大小相等的 block,与 arena 一样,也有一个数据结构 struct pool_header 用来表示 pool。与 arena 不同的是,struct pool_header 位于 pool 的内部,在最开始的一段内存中,紧接之后的是第一个 block,为了让每个 block 的地址都能对齐机器访问内存的步长,可能需要在 struct pool_header 和第一个 block 之间做一些 padding,图中灰色部分所示。这部分 padding 不一定存在,在 64 位机器上 sizeof(struct pool_header) 为 48 字节,本来就已经对齐了,后面就直接跟第一个 block,中间没有 padding。即使如此,pool 最后的一小块内存也可能用不上,上图中下面的灰色部分所示,因为每个 pool 中 block 大小是相等的,假设 block 为 64 字节,一个 pool 中可以分出 255 个 block,前面 48 字节存储 struct pool_header,后面 16 字节用不上,当然如果 block 大小为 48 字节或 16 字节那么整个 pool 就会被完全利用上。同 arena 一样,pool 一开始不是把所有的 block 全部划分出来,而是在没有可用 block 的时候才回去新划分一个,在所有的 block 全部划分之后 pool 的布局如上图所示。
接下来看看 struct pool_header 的结构
struct pool_header {
    union { block *_padding;
            uint count; } ref; // 当前 pool 中已经使用的 block 数量,共用体中只有 count 字段有意义,_padding 是为了让 ref 字段占 8 个字节,这个特性在 usedpools 初始化的时候有用
    block *freeblock; // pool 中可用来进行分配的 block 单链表的头指针
    struct pool_header *nextpool; // 在 arena_object.freepools 或 usedpools 中指向下一个 pool
    struct pool_header *prevpool; // 在 usedpools 中指向上一个 pool
    uint arenaindex; // pool 所在 arena 在 arenas 数组中的索引
    uint szidx; // pool 中 block 大小的分级
    uint nextoffset; // 需要新的 block 可以从 nextoffset 处分配
    uint maxnextoffset; // nextoffset 最大有效值
};

typedef struct pool_header *poolp;
每个 pool 一旦被分配之后一定会处于 full、empty 和 used 这 3 种状态中的一种。
full 所有的 block 都分配了
empty 所有的 block 都是空闲的,都可用于分配,所有处于 empty 状态的 pool 都在其所在 arena_object 的 freepools 字段表示的单链表中
used 有已分配的 block,也有空闲的 block,所有处于 used 状态的 pool 都在全局数组 usedpools 中某个元素指向的双向循环链表中
usedpools 是内存分配最常访问的数据结构,分配内存时先计算申请的内存大小对应的 block 分级 i,usedpools[i+i] 指向的就是属于分级 i 的所有处于 used 状态的 pool 构成的双向循环链表的头结点,如果链表不空就从头结点中选择一个空闲 block 分配。接下来分析一下为什么 usedpools[i+i] 指向的就是属于分级 i 的 pool 所在的链表。
usedpools 的原始定义如下
#define PTA(x)  ((poolp )((uint8_t *)&(usedpools[2*(x)]) - 2*sizeof(block *)))
#define PT(x)   PTA(x), PTA(x)
static poolp usedpools[2 * ((NB_SMALL_SIZE_CLASSES + 7) / 8) * 8] = {
    PT(0), PT(1), PT(2), PT(3), PT(4), PT(5), PT(6), PT(7),
    …
}
将宏定义稍微展开一下
static poolp usedpools[64] = {
    PTA(0), PTA(0), PTA(1), PTA(1), PTA(2), PTA(2), PTA(3), PTA(3),
    PTA(4), PTA(4), PTA(5), PTA(5), PTA(6), PTA(6), PTA(7), PTA(7),
    …
}
PTA(x) 表示数组 usedpools 中第 2*x 个元素的地址减去两个指针的大小也就是 16 字节(64 位机器),假设数组 usedpools 首地址为 1000,则数组初始化的值如下图所示
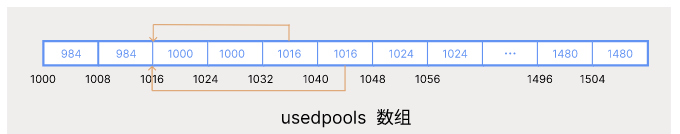
假设 i = 2,则 usedpools[i+i] = usedpools[4] = 1016,数组元素的类型为 poolp 也就是 struct pool_header *,如果认为 1016 存储的是 struct pool_header,那么 usedpools[4] 和 usedpools[5] 的值也就是地址 1032 和 1040 存储的值,分别是字段 nextpool 和 prevpool 的值,可以得到
usedpools[4]->prevpool = usedpools[4]->nextpool = usedpools[4] = 1016
将 usedpools[4] 用指针 p 表示就有 p->prevpool = p->nextpool = p,那么 p 就是双向循环链表的哨兵节点,初始化的时候哨兵节点的前后指针都指向自己,表示当前链表为空。
虽然 usedpools 的定义非常绕,但是这样定义有个好处就是省去了哨兵节点的数据域,只保留前后指针,可以说是将节省内存做到了极致。
下面分别看看源码是怎么实现内存分配和释放的逻辑的,下文中的源码基于 Python 3.10.4。另外说明一下,源码中有比本文详细的多注释说明,有兴趣的读者可以直接看源码,本文为了代码不至于过长会对代码做简化处理并且省略掉了大部分注释。
内存分配
内存分配的主逻辑在函数 pymalloc_alloc 中,简化后代码如下
static inline void*
pymalloc_alloc(void *ctx, size_t nbytes)
{
    // 计算请求的内存大小 ntybes 所对应的内存分级 size
    uint size = (uint)(nbytes - 1) >> ALIGNMENT_SHIFT;
    // 找到属于内存分级 size 的 pool 所在的双向循环链表的头指针 pool
    poolp pool = usedpools[size + size];
    block *bp;
    // pool != pool->nextpool,说明 pool 不是哨兵节点,是真正的 pool
    if (LIKELY(pool != pool->nextpool)) {
        ++pool->ref.count;
        // 将 pool->freeblock 指向的 block 分配给 bp,因为 pool 是从 usedpools 中取的,
        // 根据 usedpools 的定义,pool->freeblock 指向的一定是空闲的 block
        bp = pool->freeblock;
        // 如果将 bp 分配之后 pool->freeblock 为空,需要从 pool 中划分一个空闲 block
        // 到 pool->freeblock 链表中留下次分配使用
        if (UNLIKELY((pool->freeblock = *(block **)bp) == NULL)) {
            pymalloc_pool_extend(pool, size);
        }
    }
    // 如果没有对应内存分级的可用 pool,就从 arena 中分配一个 pool 之后再从中分配 block
    else {
        bp = allocate_from_new_pool(size);
    }

    return (void *)bp;
}
主体逻辑还是比较清晰的,代码中注释都做了说明,不过还是要解释一下下面的这个判断语句。
if (UNLIKELY((pool->freeblock = *(block **)bp) == NULL))
前文已经介绍过 pool->freeblock 表示 pool 中可用来进行分配的 block 所在单链表的头指针,类型为 block*,但是 block 的定义为 typedef uint8_t block;,并不是一个结构体,所以没有指针域,那么是怎么实现单链表的呢。考虑到 pool->freeblock 的实际含义,只需要把空闲 block 用单链表串起来就可以了,不需要数据域,Python 内存管理器把空闲 block 内存的起始 8 字节(64 位机器)当做虚拟的 next 指针,指向下一个空闲 block,具体是通过 *(block **)bp 实现的。首先用 (block **) 将 bp 转换成 block 的二级指针,然后用 * 解引用,将 bp 指向内存的首地址内容转换成 (block *) 类型,表示下一个 block 的地址,不得不说,C 语言真的是可以为所欲为。再来看一下上面判断语句,首先将 bp 的下一个空闲 block 地址赋值给 pool->freeblock,如果是 NULL 证明没有更多空闲 block,需要调用 pymalloc_pool_extend 扩充。
pymalloc_pool_extend 的源码简化后如下
static void
pymalloc_pool_extend(poolp pool, uint size)
{
    // 如果 pool 还有更多空间,就划分一个空闲 block 放到 pool->freeblock 中
    if (UNLIKELY(pool->nextoffset <= pool->maxnextoffset)) {
        pool->freeblock = (block*)pool + pool->nextoffset;
        pool->nextoffset += INDEX2SIZE(size);
        // pool->freeblock 只有一个 block,需要将虚拟的 next 指针置为 NULL
        *(block **)(pool->freeblock) = NULL;
        return;
    }

    // 如果没有更多空间,需要将 pool 从 usedpools[size+size] 中移除
    poolp next;
    next = pool->nextpool;
    pool = pool->prevpool;
    next->prevpool = pool;
    pool->nextpool = next;

}
过程也很清晰,如果有更多空间就划分一个 block 到 pool->freeblock,如果没有更多空间就将 pool 从 usedpools[size+size] 中移除。pool->nextoffset 指向的是 pool 中从未被使用过内存的地址,分配 block 时候优先使用 pool->nextoffset 之前的空闲 block,这些空闲的 block 一般是之前分配过后来又被释放到 pool->freeblock 中的。这种复用空闲 block 的方式让 pool 更加经久耐用,如果每次都从 pool->nextoffset 划分一个新的 block,pool 很快就会被消耗完,变成 full 状态。
在 pymalloc_alloc 中如果没有可用 pool 就会调用 allocate_from_new_pool 先分配一个新的 pool,再从新的 pool 中分配 block,其源码简化后如下
static void*
allocate_from_new_pool(uint size)
{
    // 没有可用的 arena 就新申请一个
    if (UNLIKELY(usable_arenas == NULL)) {
        usable_arenas = new_arena();
        if (usable_arenas == NULL) {
            return NULL;
        }
        // 将新的 arena 作为 usable_arenas 链表的头结点
        usable_arenas->nextarena = usable_arenas->prevarena = NULL;
        nfp2lasta[usable_arenas->nfreepools] = usable_arenas;
    }

    // 如果有可用 arena 就从中分配一个空闲 pool,并调整当前 arena 在 usable_arenas 中的位置,使 usable_arenas 按空闲 pool 的数量从小到大排序
    if (nfp2lasta[usable_arenas->nfreepools] == usable_arenas) {
        nfp2lasta[usable_arenas->nfreepools] = NULL;
    }
    if (usable_arenas->nfreepools > 1) {
        nfp2lasta[usable_arenas->nfreepools - 1] = usable_arenas;
    }

    // 执行到这里,usable_arenas->freepools 就是当前需要的可用 pool
    poolp pool = usable_arenas->freepools;
    // 更新 freepools 链表和 nfreepools 计数
    if (LIKELY(pool != NULL)) {
        usable_arenas->freepools = pool->nextpool;
        usable_arenas->nfreepools--;
        // 分配之后,如果 arena 中没有空闲 pool,需要更新 usable_arenas 链表
        if (UNLIKELY(usable_arenas->nfreepools == 0)) {
            usable_arenas = usable_arenas->nextarena;
            if (usable_arenas != NULL) {
                usable_arenas->prevarena = NULL;
            }
        }
    }
    // 如果当前 arena 中没有可用 pool,就重新划分一个
    else {
        pool = (poolp)usable_arenas->pool_address;
        pool->arenaindex = (uint)(usable_arenas - arenas);
        pool->szidx = DUMMY_SIZE_IDX;
        usable_arenas->pool_address += POOL_SIZE;
        --usable_arenas->nfreepools;
        // 划分之后,如果 arena 中没有空闲 pool,需要更新 usable_arenas 链表
        if (usable_arenas->nfreepools == 0) {
            usable_arenas = usable_arenas->nextarena;
            if (usable_arenas != NULL) {
                usable_arenas->prevarena = NULL;
            }
        }
    }

    // 执行到这里,变量 pool 就是找到的可用 pool,将其置为链表 usedpools[size+size] 的头节点
    block *bp;
    poolp next = usedpools[size + size];
    pool->nextpool = next;
    pool->prevpool = next;
    next->nextpool = pool;
    next->prevpool = pool;
    pool->ref.count = 1;
    // 如果 pool 的内存分级跟请求的一致,直接从中分配一个 block 返回
    // 证明这个 pool 之前被使用之后又释放到 freepools 中了
    // 并且当时使用的时候内存分级也是 size
    if (pool->szidx == size) {
        bp = pool->freeblock;
        pool->freeblock = *(block **)bp;
        return bp;
    }

    // 执行到这里,说明 pool 是 arena 新划分的,需要对其进行初始化
    // 然后分配 block 返回
    pool->szidx = size;
    size = INDEX2SIZE(size);
    bp = (block *)pool + POOL_OVERHEAD;
    pool->nextoffset = POOL_OVERHEAD + (size << 1);
    pool->maxnextoffset = POOL_SIZE - size;
    pool->freeblock = bp + size;
    *(block **)(pool->freeblock) = NULL;
    return bp;
}
这段代码比较长,归纳一下做了下面 3 件事
如果没有可用的 arena 就重新申请一个
从可用的 arena 中分配一个新的 pool
从分配的 pool 中分配空闲的 block
首先是 arena 的申请,申请流程在函数 new_arena() 中,申请完之后将对应的 arena_object 置为 双线链表 usable_arenas 的头结点,并且前后指针都置为 NULL,因为只有在没有可用 arena 的时候才回去调用 new_arena(),所以申请之后系统里只有一个可用 arena。另外还有一个操作如下
nfp2lasta[usable_arenas->nfreepools] = usable_arenas;
nfp2lasta 是一个数组,nfp2lasta[i] 表示的是在 usable_arenas 链表中,空闲 pool 的数量为 i 的所有 arena 中最后一个 arena。前文已经说明 usable_arenas 是按照 arena 中空闲 pool 的数量从小到大排序的,为了维护 usable_arenas 的有序性,在插入或删除一个 arena 的时候需要找到对应的位置,时间复杂度为 O(N),为了避免线性搜索,Python 3.8 引入了 nfp2lasta,将时间复杂度降为常量级别。
有了可用的 arena 就可以从中分配 pool 了,分配 pool 之后 arena->nfreepools 就会减少,需要更新 nfp2lasta,由于使用的是链表 usable_arenas 的头结点,并且是减少其空闲 pool 数量,所以整个链表依然有序。接下来优先复用 arena->freepools 中空闲的 pool,如果没有就从 arena->pool_address 指向的未使用内存处新划分一个 pool,这点跟 pool 中复用空闲 block 的策略是一样的。
分配了可用的 pool,先将其置为链表 usedpools[size+size] 的头结点,然后从中分配 block,如果 pool 不是从新分配的 arena 获得的,那么 pool 就是之前初始化使用之后释放掉的,如果 pool 的分级恰好就是请求的内存分级那么直接从 pool->freeblock 分配 block,否则需要将 pool 重新初始化,当然如果 pool 来自新分配的 arena 也要进行初始化。初始化的时候,先将第一个 block 的地址进行内存对齐,然后将 pool->freeblock 指向第 2 个 block 留下次分配使用(第 1 个 block 本次要返回),将 pool->nextoffset 指向第 3 个 block,在下次划分新的 block 时使用。
内存释放
内存释放的主逻辑在 pymalloc_free 函数中,代码简化后如下
static inline int
pymalloc_free(void *ctx, void *p)
{
    // 假设 p 是 pool 分配的,计算 p 所在 pool 的首地址
    poolp pool = POOL_ADDR(p);
    // 如果 p 不是内存管理器分配的直接返回
    if (UNLIKELY(!address_in_range(p, pool))) {
        return 0;
    }

    // 将 p 指向的 block 归还给 pool,置为 pool->freeblock 的头结点
    block *lastfree = pool->freeblock;
    *(block **)p = lastfree;
    pool->freeblock = (block *)p;
    pool->ref.count--;
    // 如果 pool 原来处于 full 状态,现在有一个空闲的 block 就变成了 used 状态
    // 需要将其作为头结点插到 usedpools[size+size] 中
    if (UNLIKELY(lastfree == NULL)) {
        insert_to_usedpool(pool);
        return 1;
    }

    if (LIKELY(pool->ref.count != 0)) {
        return 1;
    }

    // 如果 block 释放之后,其所在 pool 所有的 block 都是空闲状态,
    // 将 pool 从 usedpools[size+size] 中移到 arena->freepools
    insert_to_freepool(pool);
    return 1;
}
pymalloc_free 函数的逻辑也很清晰
计算地址 p 所在 pool 首地址,前文介绍过每个 pool 首地址都是 POOL_SIZE 的整数倍,所以将 p 的低位置 0 就得到了 pool 的地址
address_in_range(p, pool) 判断 p 是否是由 pool 分配的,如果不是直接返回
将 p 指向的 block 释放掉,被
pool->freeblock回收如果 pool 开始为 full 状态,那么回收 block 之后就是 used 状态,调用函数
insert_to_usedpool(pool)将其置为usedpools[size+size]的头结点。这里的策略跟 usable_arenas 一样,优先使用快满的 pool,让比较空闲的 pool 有较高的概率被释放掉。如果 pool 回收 block 之后变成 empty 状态,需要调用
insert_to_freepool(pool)将 pool 也释放掉
address_in_range 函数如下
address_in_range(void *p, poolp pool)
{
    uint arenaindex = *((volatile uint *)&pool->arenaindex);
    return arenaindex < maxarenas &&
        (uintptr_t)p - arenas[arenaindex].address < ARENA_SIZE &&
        arenas[arenaindex].address != 0;
}
这段逻辑能在常量时间内判断出 p 是否由 pool 分配,但是存在一个可能出问题的地方,毕竟这里的 pool 是在假设 p 是由 pool 分配的前提下计算出来的,有可能 pool 指向的地址可能还没被初始化,pool->arenaindex 操作可能会出错。Python 3.10 在这个 commit 中利用基数树来判断任意一个地址 p 是不是由内存管理器分配的,避免了可能出现的内存访问错误。
insert_to_usedpool 函数中只是简单的指针操作就不展开了,insert_to_freepool 稍微复杂一点,下面再展开一下
static void
insert_to_freepool(poolp pool)
{
    poolp next = pool->nextpool;
    poolp prev = pool->prevpool;
    next->prevpool = prev;
    prev->nextpool = next;
    // 将 pool 置为 ao->freepools 头结点
    struct arena_object *ao = &arenas[pool->arenaindex];
    pool->nextpool = ao->freepools;
    ao->freepools = pool;
    uint nf = ao->nfreepools;
    struct arena_object* lastnf = nfp2lasta[nf];
    // 如果 arena 是排在最后的包含 nf 个空闲 pool 的 arena,
    // 需要将 nfp2lasta[nf] 置为 arena 的前驱结点或 NULL
    if (lastnf == ao) { /* it is the rightmost */
        struct arena_object* p = ao->prevarena;
        nfp2lasta[nf] = (p != NULL && p->nfreepools == nf) ? p : NULL;
    }
    ao->nfreepools = ++nf;

    // 如果 pool 释放后 arena 变成完全空闲状态,并且系统中还有其他可用 arena,
    // 需要将 arena 从 usable_arenas 中移除并调用 free() 函数将其释放归还给操作系统
    if (nf == ao->ntotalpools && ao->nextarena != NULL) {
        if (ao->prevarena == NULL) {
            usable_arenas = ao->nextarena;
        }
        else {
            ao->prevarena->nextarena = ao->nextarena;
        }
        if (ao->nextarena != NULL) {
            ao->nextarena->prevarena = ao->prevarena;
        }
        ao->nextarena = unused_arena_objects;
        unused_arena_objects = ao;
        arena_map_mark_used(ao->address, 0);
        _PyObject_Arena.free(_PyObject_Arena.ctx, (void *)ao->address, ARENA_SIZE);
        ao->address = 0;
        --narenas_currently_allocated;
        return;
    }
    // 如果 pool 释放后 arena 从满变成可用,需要将其置为 usable_arenas 头结点,
    // 因为 arena 空闲 pool 数量为 1,作为头结点不会破坏 usable_arenas 有序性
    if (nf == 1) {
        ao->nextarena = usable_arenas;
        ao->prevarena = NULL;
        if (usable_arenas)
            usable_arenas->prevarena = ao;
        usable_arenas = ao;
        if (nfp2lasta[1] == NULL) {
            nfp2lasta[1] = ao;
        }
        return;
    }

    if (nfp2lasta[nf] == NULL) {
        nfp2lasta[nf] = ao;
    }
    // 如果 arena 本来就是包含 lastnf 个空闲 pool 的最后一个,现在空闲 pool 数量加 1,
    // 整个 usable_arenas 还是有序的
    if (ao == lastnf) {
        return;
    }

    // arena->nfreepools 的增加导致 usable_arenas 失序,
    // 重新调整 arena 在 usable_arenas 的位置
    if (ao->prevarena != NULL) {
        ao->prevarena->nextarena = ao->nextarena;
    }
    else {
        usable_arenas = ao->nextarena;
    }
    ao->nextarena->prevarena = ao->prevarena;
    ao->prevarena = lastnf;
    ao->nextarena = lastnf->nextarena;
    if (ao->nextarena != NULL) {
        ao->nextarena->prevarena = ao;
    }
    lastnf->nextarena = ao;
}
首先将这个空闲的 pool 置为 ao->freepools 的头结点,这样可以保证最后释放的 pool 会最先被使用,提高访存效率,因为之前释放的 pool 可能被置换出了物理内存。然后根据不同情况更新 nfp2lasta,便于后续维护 usable_arenas 的有序性。接着根据 pool 释放前后其所在 arena 状态的变化做不同操作。
如果 arena 由可用状态变成空闲状态,并且系统中还有其他可用 arena,就调用 free() 将 arena 释放掉归还给操作系统。如果系统中仅有这一个空闲 arena 就不释放,避免内存抖动。
如果 arena 由不可用状态(所有 pool 都分配了)变成可用状态,将其置为 usable_arenas 的头结点。
如果 pool 释放前后 arena 都是可用状态,也就是一直都在 usable_arenas 链表中,如果其可用 pool 数量的增加导致 usable_arenas 链表失序,需要移动 arena 到合适位置来保持 usable_arenas 的有序性。




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。