


使用Python编写诗歌接龙程序的简单指南
诗歌语料库 首先,我们利用Python爬虫来爬取诗歌,制作语料库。爬取的页面如下:爬取的诗歌由于本文主要为试了展示该项目的思路,因此,只爬取了该页面中的唐诗三百首、古诗三百、宋词三百、宋词精选,一共大约1100多首诗歌。为了加速爬虫,采用并发实现爬虫,并保存到poem.txt文件。完整的Python程序如下:importreimportrequestsfrombs4importBeautifulSoupfromconcurrent.futuresimportThreadPoolExecutor,wait
诗歌语料库
首先,我们利用Python爬虫来爬取诗歌,制作语料库。爬取的页面如下:
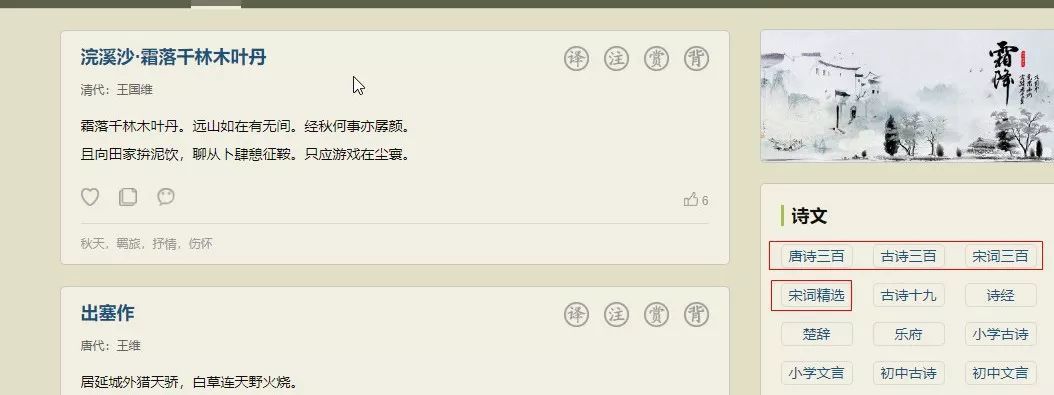
爬取的诗歌
由于本文主要为试了展示该项目的思路,因此,只爬取了该页面中的唐诗三百首、古诗三百、宋词三百、宋词精选,一共大约1100多首诗歌。为了加速爬虫,采用并发实现爬虫,并保存到poem.txt文件。完整的Python程序如下:
import re
import requests
from bs4 import BeautifulSoup
from concurrent.futures import ThreadPoolExecutor, wait, ALL_COMPLETED

# 爬取的诗歌网址
urls = ['https://so.gushiwen.org/gushi/tangshi.aspx',
       'https://so.gushiwen.org/gushi/sanbai.aspx',
       'https://so.gushiwen.org/gushi/songsan.aspx',
       'https://so.gushiwen.org/gushi/songci.aspx'
       ]

poem_links = []
# 诗歌的网址
for url in urls:
   # 请求头部
   headers = {: 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.87 Safari/537.36'}
   req = requests.get(url, headers=headers)

   soup = BeautifulSoup(req.text, "lxml")
   content = soup.find_all('div', class_="sons")[0]
   links = content.find_all('a')

   for link in links:
       poem_links.append('https://so.gushiwen.org'+link['href'])

poem_list = []
# 爬取诗歌页面
def get_poem(url):
   #url = 'https://so.gushiwen.org/shiwenv_45c396367f59.aspx'
   # 请求头部
   headers = {: 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.87 Safari/537.36'}
   req = requests.get(url, headers=headers)
   soup = BeautifulSoup(req.text, "lxml")
   poem = soup.find('div', class_='contson').text.strip()
   poem = poem.replace(' ', '')
   poem = re.sub(re.compile(r"([sS]*?)"), '', poem)
   poem = re.sub(re.compile(r"([sS]*?)"), '', poem)
   poem = re.sub(re.compile(r"。([sS]*?)"), '', poem)
   poem = poem.replace('!', '!').replace('?', '?')
   poem_list.append(poem)

# 利用并发爬取
executor = ThreadPoolExecutor(max_workers=10)  # 可以自己调整max_workers,即线程的个数
# submit()的参数: 第一个为函数, 之后为该函数的传入参数,允许有多个
future_tasks = [executor.submit(get_poem, url) for url in poem_links]
# 等待所有的线程完成,才进入后续的执行
wait(future_tasks, return_when=ALL_COMPLETED)

# 将爬取的诗句写入txt文件
poems = list(set(poem_list))
poems = sorted(poems, key=lambda x:len(x))
for poem in poems:
   poem = poem.replace('《','').replace('》','')
              .replace(':', '').replace('“', '')
   print(poem)
   with open('F://poem.txt', 'a') as f:
       f.write(poem)
       f.write('
')
该程序爬取了1100多首诗歌,并将诗歌保存至poem.txt文件,形成我们的诗歌语料库。当然,这些诗歌并不能直接使用,需要清理数据,比如有些诗歌标点不规范,有些并不是诗歌,只是诗歌的序等等,这个过程需要人工操作,虽然稍显麻烦,但为了后面的诗歌分句效果,也是值得的。
诗歌分句
有了诗歌语料库,我们需要对诗歌进行分句,分句的标准为:按照结尾为。?!进行分句,这可以用正则表达式实现。之后,将分句好的诗歌写成字典:键(key)为该句首字的拼音,值(value)为该拼音对应的诗句,并将字典保存为pickle文件。完整的Python代码如下:
import re
import pickle
from xpinyin import Pinyin
from collections import defaultdict

def main():
   with open('F://poem.txt', 'r') as f:
       poems = f.readlines()

   sents = []
   for poem in poems:
       parts = re.findall(r'[sS]*?[。?!]', poem.strip())
       for part in parts:
           if len(part) >= 5:
               sents.append(part)

   poem_dict = defaultdict(list)
   for sent in sents:
       print(part)
       head = Pinyin().get_pinyin(sent, tone_marks='marks', splitter=' ').split()[0]
       poem_dict[head].append(sent)

   with open('./poemDict.pk', 'wb') as f:
       pickle.dump(poem_dict, f)

main()
我们可以看一下该pickle文件(poemDict.pk)的内容:
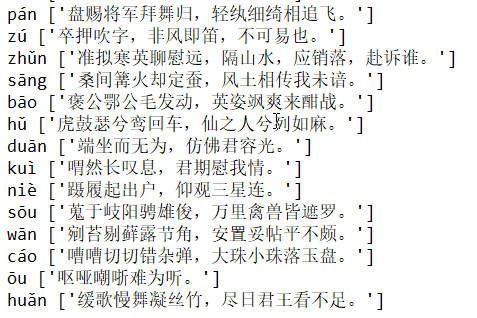
pickle文件的内容(部分)
当然,一个拼音可以对应多个诗歌。
诗歌接龙
读取pickle文件,编写程序,以exe文件形式运行该程序。 为了能够在编译形成exe文件的时候不出错,我们需要改写xpinyin模块的init.py文件,将该文件的全部代码复制至mypinyin.py,并将代码中的下面这句代码
data_path = os.path.join(os.path.dirname(os.path.abspath(__file__)),
                            'Mandarin.dat')
改写为
data_path = os.path.join(os.getcwd(), 'Mandarin.dat')
这样我们就完成了mypinyin.py文件。 接下来,我们需要编写诗歌接龙的代码(Poem_Jielong.py),完整代码如下:
import pickle
from mypinyin import Pinyin
import random
import ctypes

STD_INPUT_HANDLE = -10
STD_OUTPUT_HANDLE = -11
STD_ERROR_HANDLE = -12

FOREGROUND_DARKWHITE = 0x07  # 暗白色
FOREGROUND_BLUE = 0x09  # 蓝色
FOREGROUND_GREEN = 0x0a  # 绿色
FOREGROUND_SKYBLUE = 0x0b  # 天蓝色
FOREGROUND_RED = 0x0c  # 红色
FOREGROUND_PINK = 0x0d  # 粉红色
FOREGROUND_YELLOW = 0x0e  # 黄色
FOREGROUND_WHITE = 0x0f  # 白色

std_out_handle = ctypes.windll.kernel32.GetStdHandle(STD_OUTPUT_HANDLE)

# 设置CMD文字颜色
def set_cmd_text_color(color, handle=std_out_handle):
   Bool = ctypes.windll.kernel32.SetConsoleTextAttribute(handle, color)
   return Bool

# 重置文字颜色为暗白色
def resetColor():
   set_cmd_text_color(FOREGROUND_DARKWHITE)

# 在CMD中以指定颜色输出文字
def cprint(mess, color):
   color_dict = {
                 : FOREGROUND_BLUE,
                 : FOREGROUND_GREEN,
                 : FOREGROUND_SKYBLUE,
                 : FOREGROUND_RED,
                 : FOREGROUND_PINK,
                 : FOREGROUND_YELLOW,
                 : FOREGROUND_WHITE
                }
   set_cmd_text_color(color_dict[color])
   print(mess)
   resetColor()

color_list = ['蓝色','绿色','天蓝色','红色','粉红色','黄色','白色']

# 获取字典
with open('./poemDict.pk', 'rb') as f:
   poem_dict = pickle.load(f)

#for key, value in poem_dict.items():
   #print(key, value)

MODE = str(input('Choose MODE(1 for 人工接龙, 2 for 机器接龙): '))

while True:
   try:
       if MODE == '1':
           enter = str(input('
请输入一句诗或一个字开始:'))
           while enter != 'exit':
               test = Pinyin().get_pinyin(enter, tone_marks='marks', splitter=' ')
               tail = test.split()[-1]
               if tail not in poem_dict.keys():
                   cprint('无法接这句诗。
', '红色')
                   MODE = 0
                   break
               else:
                   cprint('
机器回复:%s'%random.sample(poem_dict[tail], 1)[0], random.sample(color_list, 1)[0])
                   enter = str(input('你的回复:'))[:-1]

           MODE = 0

       if MODE == '2':
           enter = input('
请输入一句诗或一个字开始:')

           for i in range(10):
               test = Pinyin().get_pinyin(enter, tone_marks='marks', splitter=' ')
               tail = test.split()[-1]
               if tail not in poem_dict.keys():
                   cprint('------>无法接下去了啦...', '红色')
                   MODE = 0
                   break
               else:
                   answer = random.sample(poem_dict[tail], 1)[0]
                   cprint('(%d)--> %s' % (i+1, answer), random.sample(color_list, 1)[0])
                   enter = answer[:-1]

           print('
(*****最多展示前10回接龙。*****)')
           MODE = 0

   except Exception as err:
       print(err)
   finally:
       if MODE not in ['1','2']:
           MODE = str(input('
Choose MODE(1 for 人工接龙, 2 for 机器接龙): '))
现在整个项目的结构如下(Mandarin.dat文件从xpinyin模块对应的文件夹下复制过来):
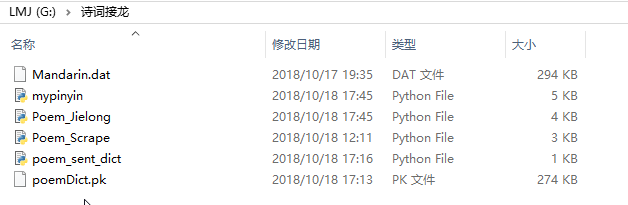
项目文件
切换至该文件夹,输入以下命令即可生成exe文件:
pyinstaller -F Poem_jielong.py
生成的exe文件为Poem_jielong.exe,位于该文件夹的dist文件夹下。为了能够让exe成功运行,需要将poemDict.pk和Mandarin.dat文件复制到dist文件夹下。
测试运行
运行Poem_jielong.exe文件,页面如下:
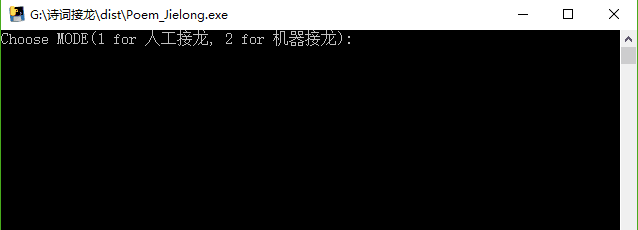
exe文件开始页面
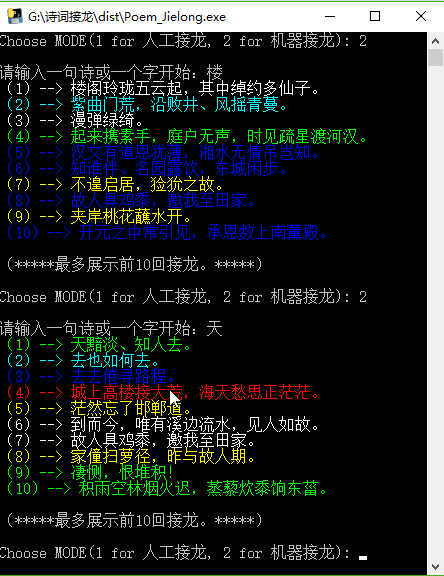
本项目的诗歌接龙有两种模式,一种为人工接龙,就是你先输入一句诗或一个字,然后就是计算机回复一句,你回复一句,负责诗歌接龙的规则;另一种模式为机器接龙,就是你先输入一句诗或一个字,机器会自动输出后面的接龙诗句(最多10个)。 先测试人工接龙模式:
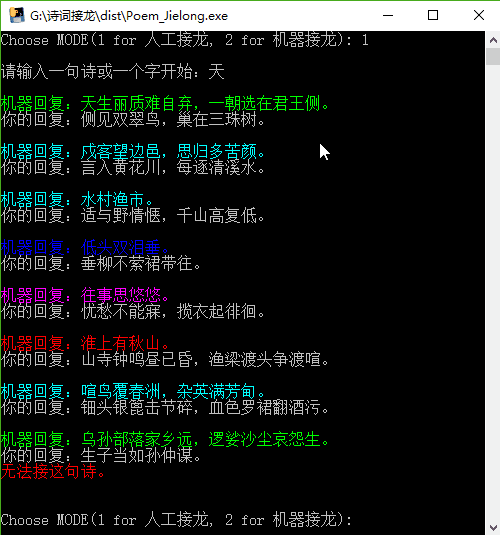
人工接龙
再测试机器接龙模式:




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。