


Linux下怎么用python实现语音识别功能
语音识别工作原理简介语音识别源于20世纪50年代早期在贝尔实验室所做的研究。早期语音识别系统仅能识别单个讲话者以及只有约十几个单词的词汇量。现代语音识别系统已经取得了很大进步,可以识别多个讲话者,并且拥有识别多种语言的庞大词汇表。语音识别的首要部分当然是语音。通过麦克风,语音便从物理声音被转换为电信号,然后通过模数转换器转换为数据。一旦被数字化,就可适用若干种模型,将音频转录为文本。大多数现代语音识别系统都依赖于隐马尔可夫模型(HMM)。其工作原理为:语音信号在非常短的时间尺度上(比如10毫秒)可被近似为
语音识别工作原理简介
语音识别源于 20 世纪 50 年代早期在贝尔实验室所做的研究。早期语音识别系统仅能识别单个讲话者以及只有约十几个单词的词汇量。现代语音识别系统已经取得了很大进步,可以识别多个讲话者,并且拥有识别多种语言的庞大词汇表。
语音识别的首要部分当然是语音。通过麦克风,语音便从物理声音被转换为电信号,然后通过模数转换器转换为数据。一旦被数字化,就可适用若干种模型,将音频转录为文本。
大多数现代语音识别系统都依赖于隐马尔可夫模型(HMM)。其工作原理为:语音信号在非常短的时间尺度上(比如 10 毫秒)可被近似为静止过程,即一个其统计特性不随时间变化的过程。
许多现代语音识别系统会在 HMM 识别之前使用神经网络,通过特征变换和降维的技术来简化语音信号。也可以使用语音活动检测器(VAD)将音频信号减少到可能仅包含语音的部分。
幸运的是,对于 Python 使用者而言,一些语音识别服务可通过 API 在线使用,且其中大部分也提供了 Python SDK。
选择合适的python语音识别包
PyPI中有一些现成的语音识别软件包。其中包括:
apiai
google-cloud-speech
pocketsphinx
SpeechRcognition
watson-developer-cloud
wit
一些软件包(如 wit 和 apiai )提供了一些超出基本语音识别的内置功能,如识别讲话者意图的自然语言处理功能。其他软件包,如谷歌云语音,则专注于语音向文本的转换。
其中,SpeechRecognition 就因便于使用脱颖而出。
识别语音需要输入音频,而在 SpeechRecognition 中检索音频输入是非常简单的,它无需构建访问麦克风和从头开始处理音频文件的脚本,只需几分钟即可自动完成检索并运行。
安装SpeechRecognition
SpeechRecognition 兼容 Python2.6 , 2.7 和 3.3+,但若在 Python 2 中使用还需要一些额外的安装步骤。大家可使用 pip 命令从终端安装 SpeechRecognition:pip3 install SpeechRecognition
安装完成后可以打开解释器窗口进行验证安装:

注:不要关闭此会话,在后几个步骤中你将要使用它。
若处理现有的音频文件,只需直接调用 SpeechRecognition ,注意具体的用例的一些依赖关系。同时注意,安装 PyAudio 包来获取麦克风输入
识别器类
SpeechRecognition 的核心就是识别器类。
Recognizer API 主要目是识别语音,每个 API 都有多种设置和功能来识别音频源的语音,这里我选择的是recognize_sphinx(): CMU Sphinx - requires installing PocketSphinx(支持离线的语音识别)
那么我们就需要通过pip命令来安装PocketSphinx,在安装过程中也容易出现一大串红色字体的错误。
音频文件的使用
下载相关的音频文件保存到特定的目录(直接保存到ubuntu桌面)
注意:
AudioFile 类可以通过音频文件的路径进行初始化,并提供用于读取和处理文件内容的上下文管理器界面。
SpeechRecognition 目前支持的文件类型有:
WAV: 必须是 PCM/LPCM 格式
AIFF
AIFF-CFLAC: 必须是初始 FLAC 格式;OGG-FLAC 格式不可用
英文的语音识别
在完成以上基础工作以后,就可以进行英文的语音识别了。
(1)打开终端
(2)进入语音测试文件所在目录(博主的是 桌面)
(3)打开python解释器
(4)按照下图输入相关命令
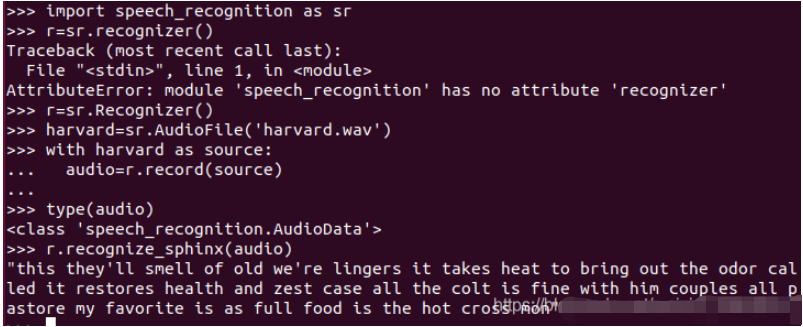
最后就可以看到语音转文字的内容(this they’ll smell …),其实效果还是很不错的!因为是英文,并且没有噪音。
噪音对语音识别的影响
噪声在现实世界中确实存在,所有录音都有一定程度的噪声,而未经处理的噪音可能会破坏语音识别应用程序的准确性。
通过尝试转录效果并不好,我们可以通过尝试调用 Recognizer 类的adjust_for_ambient_noise()命令。
麦克风的使用
若要使用 SpeechRecognizer 访问麦克风则必须安装 PyAudio 软件包。
如果使用的是基于 Debian的Linux(如 Ubuntu ),则可使用 apt 安装 PyAudio:sudo apt-get install python-pyaudio python3-pyaudio安装完成后可能仍需要启用 pip3 install pyaudio ,尤其是在虚拟情况下运行。
在安装完pyaudio的情况下可以通过python实现语音录入生成相关文件。
pocketsphinx的使用注意:
支持文件格式:wav
音频文件的解码要求:16KHZ,单声道
利用python实现录音并生成相关文件程序代码如下:
from pyaudio import PyAudio, paInt16
import numpy as np
import wave
class recoder:
     NUM_SAMPLES = 2000
     SAMPLING_RATE = 16000
     LEVEL = 500
     COUNT_NUM = 20
     SAVE_LENGTH = 8
     Voice_String = []
     def savewav(self,filename):
         wf = wave.open(filename, 'wb')
         wf.setnchannels(1)
         wf.setsampwidth(2)
         wf.setframerate(self.SAMPLING_RATE)
         wf.writeframes(np.array(self.Voice_String).tostring())
         wf.close()
     def recoder(self):
         pa = PyAudio()
         stream = pa.open(format=paInt16, channels=1, rate=self.SAMPLING_RATE, input=True,frames_per_buffer=self.NUM_SAMPLES)
         save_count = 0
         save_buffer = []
         while True:
            string_audio_data = stream.read(self.NUM_SAMPLES)
            audio_data = np.fromstring(string_audio_data, dtype=np.short)
            large_sample_count = np.sum(audio_data > self.LEVEL)
            print(np.max(audio_data))
            if large_sample_count > self.COUNT_NUM:
                save_count = self.SAVE_LENGTH
            else:
                save_count -= 1
            if save_count < 0:
                save_count = 0
            if save_count > 0:
                save_buffer.append(string_audio_data )
            else:
                if len(save_buffer) > 0:
                    self.Voice_String = save_buffer
                    save_buffer = []
                    print("Recode a piece of voice successfully!")
                    return True
		 else:
                    return False
if __name__ == "__main__":
    r = recoder()
    r.recoder()
    r.savewav("test.wav")
注意:在利用python解释器实现时一定要注意空格!!!
最后生成的文件就在Python解释器回话所在目录下,可以通过play来播放测试一下,如果没有安装play可以通过apt命令来安装。
中文的语音识别
在进行完以前的工作以后,我们对语音识别的流程大概有了一定的了解,但是作为一个中国人总得做一个中文的语音识别吧!
我们要在CMU Sphinx语音识别工具包里面下载对应的普通话升学和语言模型。
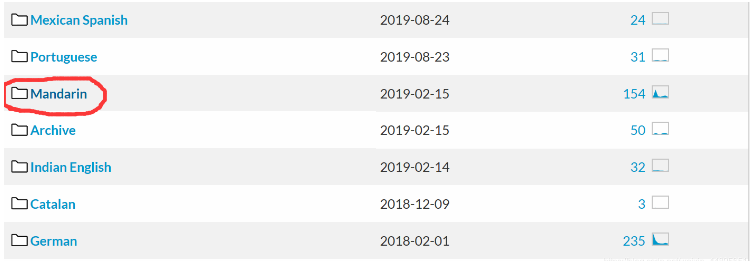
图片中标记的就是普通话!下载相关的语音识别工具包。
但是我们要把zh_broadcastnews_64000_utf8.DMP转化成language-model.lm.bin,再解压zh_broadcastnews_16k_ptm256_8000.tar.bz2得到zh_broadcastnews_ptm256_8000文件夹。
借鉴刚才那位博主的方法,在Ubuntu下找到speech_recognition文件夹。可能会有很多小伙伴找不到相关的文件夹,其实是在隐藏文件下。大家可以点击文件夹右上角的三条杠。如下图所示:

然后给显示隐藏文件打个勾,如下图所示:
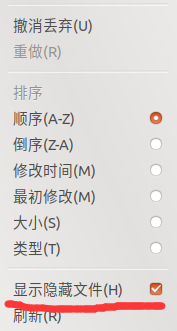
然后依次按照以下目录就可以找到啦:

然后把原来的en-US改名成en-US-bak,新建一个文件夹en-US,把解压出来的zh_broadcastnews_ptm256_8000改成acoustic-model,把chinese.lm.bin改成language-model.lm.bin,把pronounciation-dictionary.dic改后缀成dict,复制这三个文件到en-US里。同时把原来en-US文件目录下的LICENSE.txt复制到现在的文件夹下。
最终该文件夹下有以下文件:
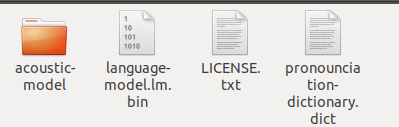
然后我们就可以通过麦克风录入一个语音文件文件(“test.wav”)
在该文件目录下打开python解释器输入以下内容:
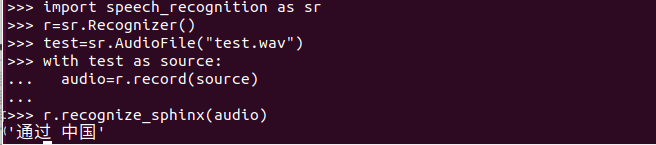
就看到了输出内容,但是我说的是两个中国,也测试了一下其他的发现识别效果很不好!!!
小范围中文识别
用官方提供的效果太差,几乎不能用!那么我看了很多文章以后就想到了一种优化方法,但是只适合小范围的识别!一些命令啥的应该没有问题,但是聊天什么的可能就效果不太好。
找到刚才复制的4个文件夹,有一个pronounciation-dictionary.dict的文件夹,打开以后是以下内容:
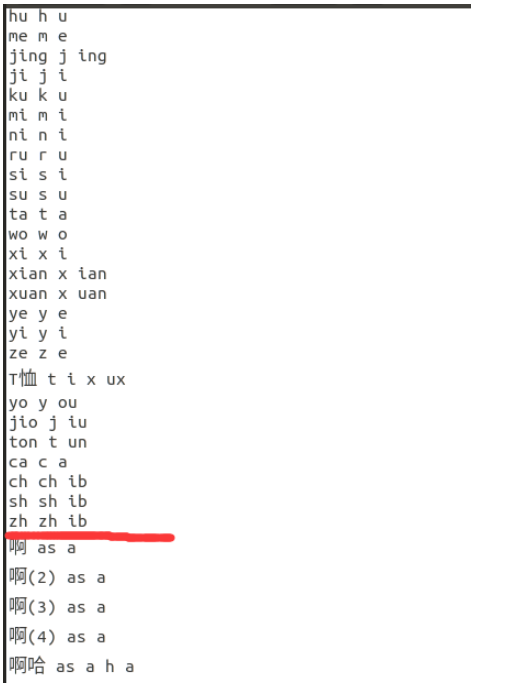
感觉这内容就是类似于一个字典,很多用词和平时交流的用词差距比较大。那么我们改成我们习惯的用词就可以啦! 抱着试一试的想法,结果还真的可以。识别效果真的不错!
我的做法是:
(1)把图片中红色标记以上的内容继续保留,红色以下的内容删除掉。当然处于保险考虑建议大家给该文件备份一下!
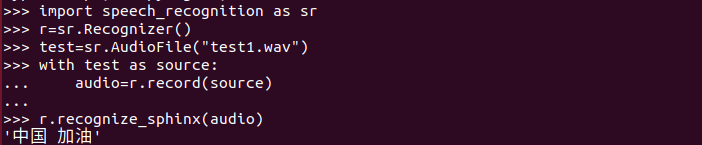
(2)给红色线以下输入自己想识别的内容!(按照规则输入,不同于拼音!!!)最近新型肺炎的情况不断的变好,听到最多的一句话就是“中国加油”那么今天的内容就是将“中国加油”实现语音转文字!希望能早日开学,哈哈哈哈。
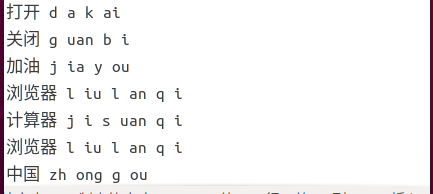
3)输入以下内容:
语音合成
语音合成个人的理解就是文字转语音。不过这句话中可以设置client = AipSpeech(APP_ID, API_KEY, SECRET_KEY) result = client.synthesis('你好百度', 'zh', 1, { 'vol': 5,'spd': 3,'pit':9,'per': 3})音量、声调、速度、男/女/萝莉/逍遥。










Adobe Acrobat Pro 是面向办公、法务、财务、教育及出版用户的专业PDF处理软件,可在Mac上创建、编辑、转换、合并和保护文档,并提供OCR文字识别、表单、批注、内容比较、敏感信息遮盖及电子签名功能。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

Adobe Illustrator 是 Adobe 推出的专业矢量图形设计软件,适合在 Mac 上制作标志、图标、插画、包装、信息图及印刷版面。它以路径和锚点构建可无损缩放的图形,并提供钢笔、形状、文字、图像描摹、渐变、画板及生成式功能。

Adobe InDesign 是面向印刷品与数字出版物的专业版面设计软件,可在 Mac 上制作书籍、杂志、宣传册、海报、报告及交互式文档。它提供精细的文字样式、网格、母版、长文档管理和印前输出能力。
Affinity Designer 的矢量设计能力现已整合进 Affinity by Canva,可在 Mac 上进行标志、图标、插画、界面原型及印刷品设计。个人用户使用免费 Canva 账户即可使用完整的矢量、像素和版面工具。
Archicad是Graphisoft推出的建筑信息模型设计软件,可在Mac上完成概念设计、参数化建模、图纸编制、工程量统计、渲染展示及团队协同。模型与平立剖面、明细表和布局保持关联,适合建筑师、室内设计师、BIM团队及相关专业学生使用。
AutoCAD LT是Autodesk推出的专业二维CAD设计与文档编制软件,Mac版本提供原生界面、多点触控及分屏查看体验。用户可精确创建和编辑DWG图形,完成图层管理、尺寸标注、表格、PDF参考、外部参照及打印输出。

AutoCAD for Mac 是 Autodesk 面向 macOS 提供的专业计算机辅助设计软件,支持精确的二维绘图、标注、布局输出以及实体、曲面和网格建模。软件采用适配 Mac 操作习惯的界面,可处理 DWG 图纸。
Autodesk Fusion 是面向产品设计与制造的一体化云连接平台,在 Mac 上提供参数化建模、自由曲面、装配、工程图、仿真、PCB 设计和 CAM 加工等工具。它适合机械工程师、工业设计师、创客及制造团队使用。
Autodesk Maya是一套面向影视动画、游戏开发和视觉特效制作的专业三维创作软件,集多边形与曲面建模、角色绑定、关键帧动画、动力学模拟、程序化特效及Arnold渲染于一体,并提供脚本、插件和开放式制作管线支持。
Blender是一款免费开源的综合三维创作软件,可在Mac上完成建模、数字雕刻、材质制作、角色绑定、动画、物理模拟、渲染、合成及视频剪辑。软件提供Cycles与Eevee渲染工具,并支持几何节点、蜡笔绘制和Python扩展。

AutoCAD 是 Autodesk 推出的专业计算机辅助设计软件,Windows 版支持精确二维绘图、三维实体与曲面建模、图纸标注、布局发布和任务自动化,并包含多套行业专业化工具组合,适用于建筑、机械、电气、工程建设及制造设计人员。

Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。

Figma 是面向产品设计与开发团队的云端协作平台,可在 Windows 桌面客户端中完成界面绘制、组件管理、交互原型、评论评审和开发交付。文件保存在云端,多名成员能够同步编辑并共享设计系统;官方同时提供免费 Starter 方案及按席位计

Affinity Designer 是面向矢量图形、数字插画和界面设计的专业创作工具,可在矢量、像素与导出工作区之间快速切换。它提供曲线编辑、形状构建、画板、排版、图层和专业色彩管理,并支持常见设计文件的导入及多种印刷、网页格式输出。
Cinema 4D是Maxon推出的专业三维创作软件,将建模、动画、MoGraph动态图形、粒子与动力学模拟、材质灯光及Redshift渲染整合在统一工作环境中,适用于广告包装、影视特效、产品和建筑可视化、游戏素材等制作场景。
Blender 是免费开源的三维创作套件,在 Windows 上提供建模、雕刻、材质、动画、物理模拟、合成、跟踪、视频剪辑及 Cycles、EEVEE 渲染工具。它适合个人创作者、学生和小型工作室,
Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
SketchUp Pro 是面向建筑、室内、景观、施工和产品设计等专业场景的三维建模工具,提供桌面建模、LayOut 二维文档、模型资源库、扩展程序及云端协作能力。其操作逻辑直观,适合从概念推敲、空间规划到图纸表达和方案汇报的完整工作流程。