


Python和Excel的完美结合:常用操作汇总(案例详析)
正文在以前,商业分析对应的英文单词是BusinessAnalysis,大家用的分析工具是Excel,后来数据量大了,Excel应付不过来了(Excel最大支持行数为1048576行),人们开始转向python和R这样的分析工具了,这时候商业分析对应的单词是BusinessAnalytics。其实python和Excel的使用准则一样,都是[Wedon'trepeatourselves],都是尽可能用更方便的操作替代机械操作和纯体力劳动。用python做数据分析,离不开著名的pandas包,经过了
正文
在以前,商业分析对应的英文单词是Business Analysis,大家用的分析工具是Excel,后来数据量大了,Excel应付不过来了(Excel最大支持行数为1048576行),人们开始转向python和R这样的分析工具了,这时候商业分析对应的单词是Business Analytics。
其实python和Excel的使用准则一样,都是[We don't repeat ourselves],都是尽可能用更方便的操作替代机械操作和纯体力劳动。
用python做数据分析,离不开著名的pandas包,经过了很多版本的迭代优化,pandas现在的生态圈已经相当完整了,官网还给出了它和其他分析工具的对比:
本文用的主要也是pandas,绘图用的库是plotly,实现的Excel的常用功能有:
- Python和Excel的交互
- vlookup函数
- 数据透视表
- 绘图
以后如果发掘了更多Excel的功能,会回来继续更新和补充。开始之前,首先按照惯例加载pandas包:
import numpy as np
import pandas as pd
pd.set_option('max_columns', 10)
pd.set_option('max_rows', 20)
pd.set_option('display.float_format', lambda x: '%.2f' % x) # 禁用科学计数法
Python和Excel的交互
pandas里最常用的和Excel I/O有关的四个函数是read_csv/ read_excel/ to_csv/ to_excel,它们都有特定的参数设置,可以定制想要的读取和导出效果。
比如说想要读取这样一张表的左上部分:
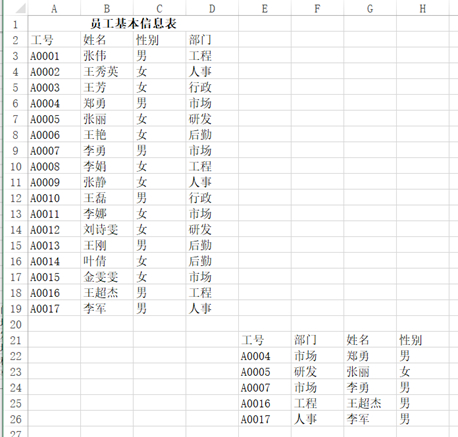
可以用pd.read_excel("test.xlsx", header=1, nrows=17, usecols=3),返回结果:
df
Out[]:
工号 姓名 性别部门
0 A0001 张伟男工程
1 A0002王秀英女人事
2 A0003 王芳女行政
3 A0004 郑勇男市场
4 A0005 张丽女研发
5 A0006 王艳女后勤
6 A0007 李勇男市场
7 A0008 李娟女工程
8 A0009 张静女人事
9 A0010 王磊男行政
10A0011 李娜女市场
11A0012刘诗雯女研发
12A0013 王刚男后勤
13A0014 叶倩女后勤
14A0015金雯雯女市场
15A0016王超杰男工程
16A0017 李军男人事
输出函数也同理,使用多少列,要不要index,标题怎么放,都可以控制。
vlookup函数
vlookup号称是Excel里的神器之一,用途很广泛,下面的例子来自豆瓣,VLOOKUP函数最常用的10种用法,你会几种?
案例一
问题:A3:B7单元格区域为字母等级查询表,表示60分以下为E级、60~69分为D级、70~79分为C级、80~89分为B级、90分以上为A级。D:G列为初二年级1班语文测验成绩表,如何根据语文成绩返回其字母等级?
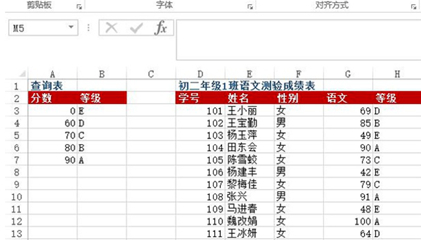
方法:在H3:H13单元格区域中输入=VLOOKUP(G3, $A$3:$B$7, 2)
python实现:
df = pd.read_excel("test.xlsx", sheet_name=0)
def grade_to_point(x):
 if x >= 90:
 return 'A'
 elif x >= 80:
 return 'B'
 elif x >= 70:
 return 'C'
 elif x >= 60:
 return 'D'
 else:
 return 'E'
df['等级'] = df['语文'].apply(grade_to_point)
df
Out[]:
学号 姓名 性别 语文 等级
0 101王小丽女 69D
1 102王宝勤男 85B
2 103杨玉萍女 49E
3 104田东会女 90A
4 105陈雪蛟女 73C
5 106杨建丰男 42E
6 107黎梅佳女 79C
7 108 张兴 男 91A
8 109马进春女 48E
9 110魏改娟女100A
10111王冰研女 64D
案例二
问题:在Sheet1里面如何查找折旧明细表中对应编号下的月折旧额?(跨表查询)。
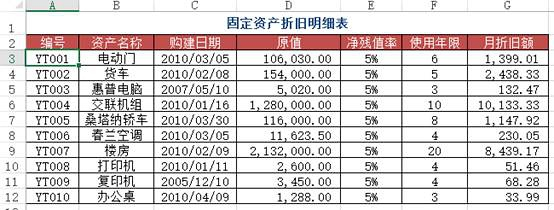
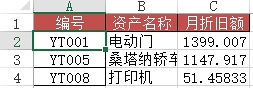
方法:在Sheet1里面的C2:C4单元格输入 =VLOOKUP(A2, 折旧明细表!A$2:$G$12, 7, 0)。
python实现:使用merge将两个表按照编号连接起来就行。
df1 = pd.read_excel("test.xlsx", sheet_name='折旧明细表')
df2 = pd.read_excel("test.xlsx", sheet_name=1) #题目里的sheet1
df2.merge(df1[['编号', '月折旧额']], how='left', on='编号')
Out[]:
 编号 资产名称月折旧额
0YT001电动门 1399
1YT005桑塔纳轿车1147
2YT008打印机51
案例三
问题:类似于案例二,但此时需要使用近似查找。
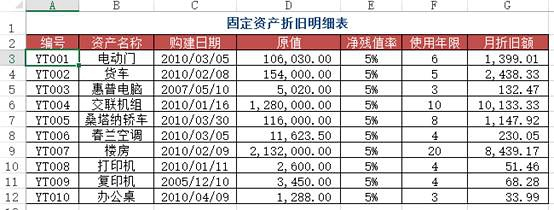
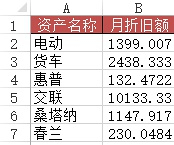
方法:在B2:B7区域中输入公式=VLOOKUP(A2&"*", 折旧明细表!$B$2:$G$12, 6, 0)。
python实现:这个比起上一个要麻烦一些,需要用到一些pandas的使用技巧。
df1 = pd.read_excel("test.xlsx", sheet_name='折旧明细表')
df3 = pd.read_excel("test.xlsx", sheet_name=3) #含有资产名称简写的表
df3['月折旧额'] = 0
for i in range(len(df3['资产名称'])):
 df3['月折旧额'][i] = df1[df1['资产名称'].map(lambda x:df3['资产名称'][i] in x)]['月折旧额']
df3
Out[]:
 资产名称 月折旧额
0 电动 1399
1 货车 2438
2 惠普132
3 交联10133
4桑塔纳 1147
5 春兰230
案例四
问题:在Excel中录入数据信息时,为了提高工作效率,用户希望通过输入数据的关键字后,自动显示该记录的其余信息,例如,输入员工工号自动显示该员工的姓名,输入物料号就能自动显示该物料的品名、单价等。
如图所示为某单位所有员工基本信息的数据源表,在“2010年3月员工请假统计表”工作表中,当在A列输入员工工号时,如何实现对应员工的姓名、身份证号、部门、职务、入职日期等信息的自动录入?另外,搜索公众号Linux就该这样学后台回复“git书籍”,获取一份惊喜礼包。
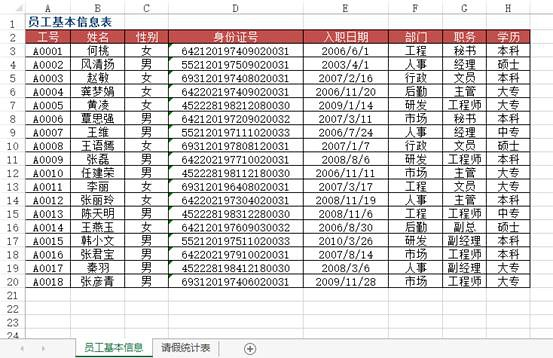
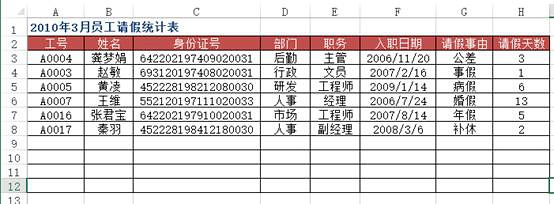
方法:使用VLOOKUP+MATCH函数,在“2010年3月员工请假统计表”工作表中选择B3:F8单元格区域,输入下列公式=IF($A3="","",VLOOKUP($A3,员工基本信息!$A:$H,MATCH(B$2,员工基本信息!$2:$2,0),0)),按下【Ctrl+Enter】组合键结束。
python实现:上面的Excel的方法用得很灵活,但是pandas的想法和操作更简单方便些。
df4 = pd.read_excel("test.xlsx", sheet_name='员工基本信息表')
df5 = pd.read_excel("test.xlsx", sheet_name='请假统计表')
df5.merge(df4[['工号', '姓名', '部门', '职务', '入职日期']], on='工号')
Out[]:
 工号 姓名部门 职务 入职日期
0A0004龚梦娟后勤 主管 2006-11-20
1A0003 赵敏行政 文员 2007-02-16
2A0005 黄凌研发工程师 2009-01-14
3A0007 王维人事 经理 2006-07-24
4A0016张君宝市场工程师 2007-08-14
5A0017 秦羽人事副经理 2008-03-06
案例五
问题:用VLOOKUP函数实现批量查找,VLOOKUP函数一般情况下只能查找一个,那么多项应该怎么查找呢?如下图,如何把张一的消费额全部列出?
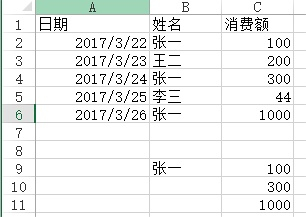
方法:在C9:C11单元格里面输入公式=VLOOKUP(B$9&ROW(A1),IF({1,0},$B$2:$B$6&COUNTIF(INDIRECT("b2:b"&ROW($2:$6)),B$9),$C$2:$C$6),2,),按SHIFT+CTRL+ENTER键结束。
python实现:vlookup函数有两个不足(或者算是特点吧),一个是被查找的值一定要在区域里的第一列,另一个是只能查找一个值,剩余的即便能匹配也不去查找了,这两点都能通过灵活应用if和indirect函数来解决,不过pandas能做得更直白一些。
df6 = pd.read_excel("test.xlsx", sheet_name='消费额')
df6[df6['姓名'] == '张一'][['姓名', '消费额']]
Out[]:
姓名 消费额
0张一 100
2张一 300
4张一1000
数据透视表
数据透视表是Excel的另一个神器,本质上是一系列的表格重组整合的过程。这里用的案例来自知乎,Excel数据透视表有什么用途:(https://www.zhihu.com/question/22484899/answer/39933218 )
问题:需要汇总各个区域,每个月的销售额与成本总计,并同时算出利润。
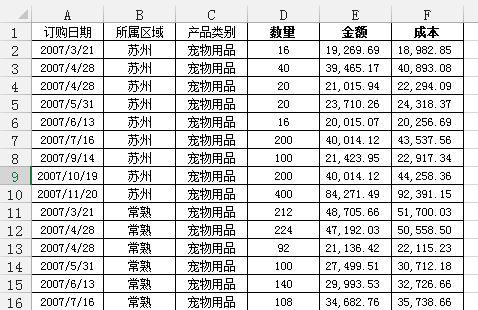
通过Excel的数据透视表的操作最终实现了下面这样的效果:
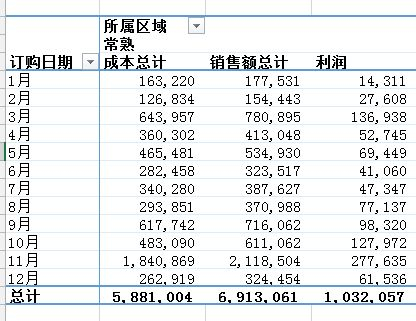
python实现:对于这样的分组的任务,首先想到的就是pandas的groupby,代码写起来也简单,思路就是把刚才Excel的点鼠标的操作反映到代码命令上:
df = pd.read_excel('test.xlsx', sheet_name='销售统计表')
df['订购月份'] = df['订购日期'].apply(lambda x:x.month)
df2 = df.groupby(['订购月份', '所属区域'])[['销售额', '成本']].agg('sum')
df2['利润'] = df2['销售额'] - df2['成本']
df2
Out[]:
销售额 成本利润
订购月份 所属区域
1南京134313.61 94967.8439345.77
常熟177531.47163220.0714311.40
无锡316418.09231822.2884595.81
昆山159183.35145403.3213780.03
苏州287253.99238812.0348441.96
2南京187129.13138530.4248598.71
常熟154442.74126834.3727608.37
无锡464012.20376134.9887877.22
昆山102324.46 86244.5216079.94
苏州105940.34 91419.5414520.80
...... ...
11 南京286329.88221687.1164642.77
常熟 2118503.54 1840868.53 277635.01
无锡633915.41536866.7797048.64
昆山351023.24342420.18 8603.06
苏州 1269351.39 1144809.83 124541.56
12 南京894522.06808959.3285562.74
常熟324454.49262918.8161535.68
无锡 1040127.19856816.72 183310.48
昆山 1096212.75951652.87 144559.87
苏州347939.30302154.2545785.05
[60 rows x 3 columns]
也可以使用pandas里的pivot_table函数来实现:
df3 = pd.pivot_table(df, values=['销售额', '成本'], index=['订购月份', '所属区域'] , aggfunc='sum')
df3['利润'] = df3['销售额'] - df3['成本']
df3
Out[]:
 成本销售额利润
订购月份 所属区域
1南京 94967.84134313.6139345.77
常熟163220.07177531.4714311.40
无锡231822.28316418.0984595.81
昆山145403.32159183.3513780.03
苏州238812.03287253.9948441.96
2南京138530.42187129.1348598.71
常熟126834.37154442.7427608.37
无锡376134.98464012.2087877.22
昆山 86244.52102324.4616079.94
苏州 91419.54105940.3414520.80
...... ...
11 南京221687.11286329.8864642.77
常熟 1840868.53 2118503.54 277635.01
无锡536866.77633915.4197048.64
昆山342420.18351023.24 8603.06
苏州 1144809.83 1269351.39 124541.56
12 南京808959.32894522.0685562.74
常熟262918.81324454.4961535.68
无锡856816.72 1040127.19 183310.48
昆山951652.87 1096212.75 144559.87
苏州302154.25347939.3045785.05
[60 rows x 3 columns]
pandas的pivot_table的参数index/ columns/ values和Excel里的参数是对应上的(当然,我这话说了等于没说,数据透视表里不就是行/列/值吗还能有啥。)
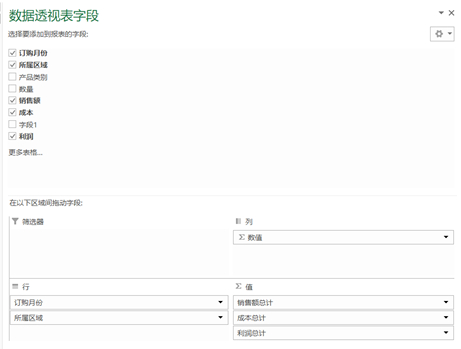
但是我个人还是更喜欢用groupby,因为它运算速度非常快。我在打kaggle比赛的时候,有一张表是贷款人的行为信息,大概有2700万行,用groupby算了几个聚合函数,几秒钟就完成了。
groupby的功能很全面,内置了很多aggregate函数,能够满足大部分的基本需求,如果你需要一些其他的函数,可以搭配使用apply和lambda。
不过pandas的官方文档说了,groupby之后用apply速度非常慢,aggregate内部做过优化,所以很快,apply是没有优化的,所以建议有问题先想想别的方法,实在不行的时候再用apply。
我打比赛的时候,为了生成一个新变量,用了groupby的apply,写了这么一句:ins['weight'] = ins[['SK_ID_PREV', 'DAYS_ENTRY_PAYMENT']].groupby('SK_ID_PREV').apply(lambda x: 1-abs(x)/x.sum().abs()).iloc[:,1],1000万行的数据,足足算了十多分钟,等得我心力交瘁。
绘图
因为Excel画出来的图能够交互,能够在图上进行一些简单操作,所以这里用的python的可视化库是plotly,案例就用我这个学期发展经济学课上的作业吧,当时的图都是用Excel画的,现在用python再画一遍。开始之前,首先加载plotly包。
import plotly.offline as off
import plotly.graph_objs as go
off.init_notebook_mode()
柱状图
当时用Excel画了很多的柱状图,其中的一幅图是:
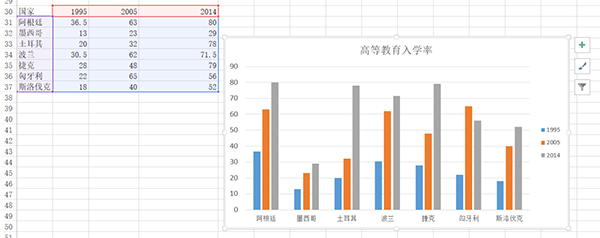
下面用plotly来画一下:
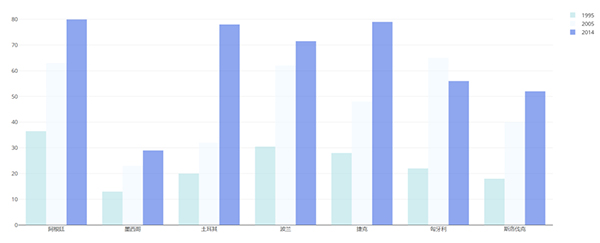
df = pd.read_excel("plot.xlsx", sheet_name='高等教育入学率')
trace1 = go.Bar(
 x=df['国家'],
 y=df[1995],
 name='1995',
 opacity=0.6,
 marker=dict(
 color='powderblue'
 )
 )
trace2 = go.Bar(
 x=df['国家'],
 y=df[2005],
 name='2005',
 opacity=0.6,
 marker=dict(
 color='aliceblue',
 )
 )
trace3 = go.Bar(
 x=df['国家'],
 y=df[2014],
 name='2014',
 opacity=0.6,
 marker=dict(
 color='royalblue'
 )
 )
layout = go.Layout(barmode='group')
data = [trace1, trace2, trace3]
fig = go.Figure(data, layout)
off.plot(fig)
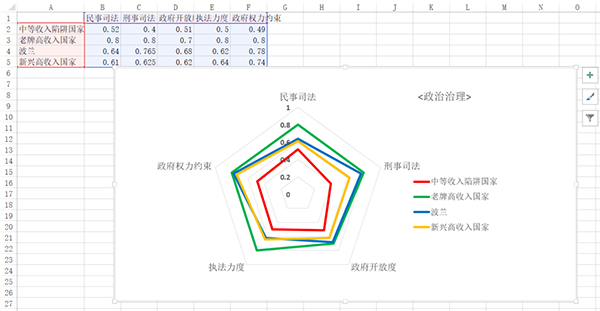
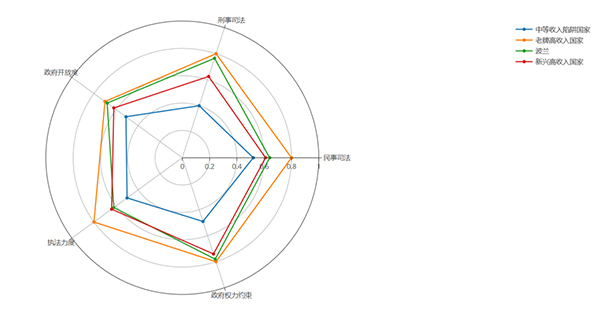
雷达图
用Excel画的:
用python画的:
df = pd.read_excel('plot.xlsx', sheet_name='政治治理')
theta = df.columns.tolist()
theta.append(theta[0])
names = df.index
df[''] = df.iloc[:,0]
df = np.array(df)
trace1 = go.Scatterpolar(
 r=df[0],
 theta=theta,
 name=names[0]
 )
trace2 = go.Scatterpolar(
 r=df[1],
 theta=theta,
 name=names[1]
 )
trace3 = go.Scatterpolar(
 r=df[2],
 theta=theta,
 name=names[2]
 )
trace4 = go.Scatterpolar(
 r=df[3],
 theta=theta,
 name=names[3]
 )
data = [trace1, trace2, trace3, trace4]
layout = go.Layout(
 polar=dict(
 radialaxis=dict(
 visible=True,
 range=[0,1]
 )
 ),
 showlegend=True
 )
fig = go.Figure(data, layout)
off.plot(fig)
画起来比Excel要麻烦得多。
总体而言,如果画简单基本的图形,用Excel是最方便的,如果要画高级一些的或者是需要更多定制化的图形,使用python更合适。


















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。