


如何使用Python批量处理PDF文件以输出特定关键词的出现次数
函数模块介绍具体的代码可见全部代码部分,这部分只介绍思路和相应的函数模块对文件进行批量重命名因为文件名是中文,且无关于最后的结果,所以批量命名为数字注意如果不是第一次运行,即已经命名完成,就在主函数内把这个函数注释掉就好了defrename():path='dealPdf'filelist=os.listdir(path)fori,filesinenumerate(filelist):Olddir=os.path.join(path,files)ifos.path.isdir(Olddir
函数模块介绍
具体的代码可见全部代码部分,这部分只介绍思路和相应的函数模块
对文件进行批量重命名
因为文件名是中文,且无关于最后的结果,所以批量命名为数字
注意如果不是第一次运行,即已经命名完成,就在主函数内把这个函数注释掉就好了
def rename():
    path='dealPdf'
    filelist=os.listdir(path)
    for i,files in enumerate(filelist):
        Olddir=os.path.join(path,files)
        if os.path.isdir(Olddir):
            continue
        Newdir=os.path.join(path,str(i+1)+'.pdf')
        os.rename(Olddir,Newdir)
将PDF转化为txt
PDF是无法直接进行文本分析的,所以需要将文字转成txt文件(PDF中图内的文字无法提取)
#将pdf文件转化成txt文件
def pdf_to_txt(dealPdf,index):
    # 不显示warning
    logging.propagate = False
    logging.getLogger().setLevel(logging.ERROR)
    pdf_filename = dealPdf
    device = PDFPageAggregator(PDFResourceManager(), laparams=LAParams())
    interpreter = PDFPageInterpreter(PDFResourceManager(), device)
    parser = PDFParser(open(pdf_filename, 'rb'))
    doc = PDFDocument(parser)


    txt_filename='dealTxt\\'+str(index)+'.txt'

    # 检测文档是否提供txt转换,不提供就忽略
    if not doc.is_extractable:
        raise PDFTextExtractionNotAllowed
    else:
        with open(txt_filename, 'w', encoding="utf-8") as fw:
            #print("num page:{}".format(len(list(doc.get_pages()))))
            for i,page in enumerate(PDFPage.create_pages(doc)):
                interpreter.process_page(page)
                # 接受该页面的LTPage对象
                layout = device.get_result()
                # 这里layout是一个LTPage对象 里面存放着 这个page解析出的各种对象
                # 一般包括LTTextBox, LTFigure, LTImage, LTTextBoxHorizontal 等等
                # 想要获取文本就获得对象的text属性,
                for x in layout:
                    if isinstance(x, LTTextBoxHorizontal):
                        results = x.get_text()
                        fw.write(results)
删除txt中的换行符
因为PDF导出的txt会用换行符换行,为了避免词语因此拆开,所以删除所有的换行符
#对txt文件的换行符进行删除
def delete_huanhangfu(dealTxt,index):
    outPutString=''
    outPutTxt='outPutTxt\\'+str(index)+'.txt'
    with open(dealTxt,'r',encoding="utf-8") as f:
        lines=f.readlines()
        for i in range(len(lines)):
            if lines[i].endswith('\n'):
                lines[i]=lines[i][:-1] #将字符串末尾的\n去掉
        for j in range(len(lines)):
            outPutString+=lines[j]
    with open(outPutTxt,'w',encoding="utf-8") as fw:
        fw.write(outPutString)
添加自定义词语
此处可以根据自己的需要自定义,传入的wordsByMyself是全局变量
分词与词频统计
调用jieba进行分词,读取通用词表去掉停用词(此步其实可以省略,对最终结果影响不大),将词语和出现次数合成为键值对,输出关键词出现次数
#分词并进行词频统计
def cut_and_count(outPutTxt):
    with open(outPutTxt,encoding='utf-8') as f:
        #step1:读取文档并调用jieba分词
        text=f.read()
        words=jieba.lcut(text)
        #step2:读取停用词表,去停用词
        stopwords = {}.fromkeys([ line.rstrip() for line in open('stopwords.txt',encoding='utf-8') ])
        finalwords = []
        for word in words:
            if word not in stopwords:
                if (word != "。" and word != ",") :
                    finalwords.append(word)


        #step3:统计特定关键词的出现次数
        valuelist=[0]*len(wordsByMyself)
        counts=dict(zip(wordsByMyself,valuelist))
        for word in finalwords:
            if len(word) == 1:#单个词不计算在内
                continue
            else:
                counts[word]=counts.get(word,0)+1#遍历所有词语,每出现一次其对应值加1
        for i in range(len(wordsByMyself)):
            if wordsByMyself[i] in counts:
                print(wordsByMyself[i]+':'+str(counts[wordsByMyself[i]]))
            else:
                print(wordsByMyself[i]+':0')
主函数
通过for循环进行批量操作
if __name__ == "__main__":
    #rename()
    for i in range(1,fileNum+1):
        pdf_to_txt('dealPdf\\'+str(i)+'.pdf',i)#将pdf文件转化成txt文件,传入文件路径
        delete_huanhangfu('dealTxt\\'+str(i)+'.txt',i)#对txt文件的换行符进行删除,防止词语因换行被拆分
        word_by_myself()#添加自定义词语
        print(f'----------result {i}----------')
        cut_and_count('outPutTxt\\'+str(i)+'.txt')#分词并进行词频统计,传入文件路径
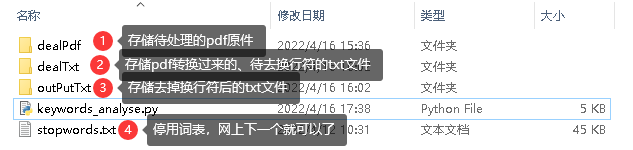
本地文件结构
全部代码
import jieba
import jieba.analyse
from pdfminer.pdfparser import PDFParser
from pdfminer.pdfdocument import PDFDocument
from pdfminer.pdfinterp import PDFResourceManager, PDFPageInterpreter
from pdfminer.converter import PDFPageAggregator
from pdfminer.layout import LTTextBoxHorizontal, LAParams
from pdfminer.pdfpage import PDFPage,PDFTextExtractionNotAllowed
import logging
import os

wordsByMyself=['社会责任','义务','上市','公司'] #自定义词语,全局变量
fileNum=16#存储总共待处理的文件数量

#重命名所有文件夹下的文件,适应处理需要
def rename():
    path='dealPdf'
    filelist=os.listdir(path)
    for i,files in enumerate(filelist):
        Olddir=os.path.join(path,files)
        if os.path.isdir(Olddir):
            continue
        Newdir=os.path.join(path,str(i+1)+'.pdf')
        os.rename(Olddir,Newdir)

#将pdf文件转化成txt文件
def pdf_to_txt(dealPdf,index):
    # 不显示warning
    logging.propagate = False
    logging.getLogger().setLevel(logging.ERROR)
    pdf_filename = dealPdf
    device = PDFPageAggregator(PDFResourceManager(), laparams=LAParams())
    interpreter = PDFPageInterpreter(PDFResourceManager(), device)
    parser = PDFParser(open(pdf_filename, 'rb'))
    doc = PDFDocument(parser)


    txt_filename='dealTxt\\'+str(index)+'.txt'

    # 检测文档是否提供txt转换,不提供就忽略
    if not doc.is_extractable:
        raise PDFTextExtractionNotAllowed
    else:
        with open(txt_filename, 'w', encoding="utf-8") as fw:
            #print("num page:{}".format(len(list(doc.get_pages()))))
            for i,page in enumerate(PDFPage.create_pages(doc)):
                interpreter.process_page(page)
                # 接受该页面的LTPage对象
                layout = device.get_result()
                # 这里layout是一个LTPage对象 里面存放着 这个page解析出的各种对象
                # 一般包括LTTextBox, LTFigure, LTImage, LTTextBoxHorizontal 等等
                # 想要获取文本就获得对象的text属性,
                for x in layout:
                    if isinstance(x, LTTextBoxHorizontal):
                        results = x.get_text()
                        fw.write(results)

#对txt文件的换行符进行删除
def delete_huanhangfu(dealTxt,index):
    outPutString=''
    outPutTxt='outPutTxt\\'+str(index)+'.txt'
    with open(dealTxt,'r',encoding="utf-8") as f:
        lines=f.readlines()
        for i in range(len(lines)):
            if lines[i].endswith('\n'):
                lines[i]=lines[i][:-1] #将字符串末尾的\n去掉
        for j in range(len(lines)):
            outPutString+=lines[j]
    with open(outPutTxt,'w',encoding="utf-8") as fw:
        fw.write(outPutString)

#添加自定义词语
def word_by_myself():
    for i in range(len(wordsByMyself)):
        jieba.add_word(wordsByMyself[i])

#分词并进行词频统计
def cut_and_count(outPutTxt):
    with open(outPutTxt,encoding='utf-8') as f:
        #step1:读取文档并调用jieba分词
        text=f.read()
        words=jieba.lcut(text)
        #step2:读取停用词表,去停用词
        stopwords = {}.fromkeys([ line.rstrip() for line in open('stopwords.txt',encoding='utf-8') ])
        finalwords = []
        for word in words:
            if word not in stopwords:
                if (word != "。" and word != ",") :
                    finalwords.append(word)


        #step3:统计特定关键词的出现次数
        valuelist=[0]*len(wordsByMyself)
        counts=dict(zip(wordsByMyself,valuelist))
        for word in finalwords:
            if len(word) == 1:#单个词不计算在内
                continue
            else:
                counts[word]=counts.get(word,0)+1#遍历所有词语,每出现一次其对应值加1
        for i in range(len(wordsByMyself)):
            if wordsByMyself[i] in counts:
                print(wordsByMyself[i]+':'+str(counts[wordsByMyself[i]]))
            else:
                print(wordsByMyself[i]+':0')

#主函数
if __name__ == "__main__":
    rename()
    for i in range(1,fileNum+1):
        pdf_to_txt('dealPdf\\'+str(i)+'.pdf',i)#将pdf文件转化成txt文件,传入文件路径
        delete_huanhangfu('dealTxt\\'+str(i)+'.txt',i)#对txt文件的换行符进行删除,防止词语因换行被拆分
        word_by_myself()#添加自定义词语
        print(f'----------result {i}----------')
        cut_and_count('outPutTxt\\'+str(i)+'.txt')#分词并进行词频统计,传入文件路径
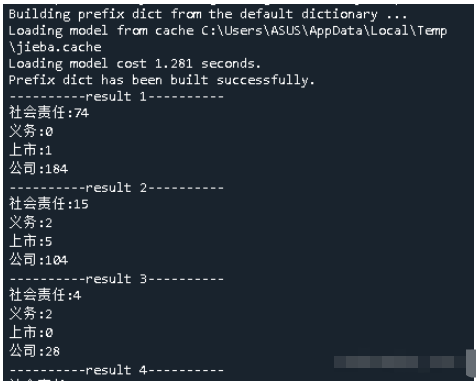
结果预览








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。