


Python虚拟机中字节的实现原理是什么
数据结构typedefstruct{PyObject_VAR_HEADPy_hash_tob_shash;charob_sval[1];/*Invariants:*ob_svalcontainsspacefor'ob_size+1'elements.*ob_sval[ob_size]==0.*ob_shashisthehashofthestringor-1ifnotcomputedyet.*/}PyBytesObject;typedefstruct{PyObjectob_base;Py_s
数据结构
typedef struct {
    PyObject_VAR_HEAD
    Py_hash_t ob_shash;
    char ob_sval[1];

    /* Invariants:
     *     ob_sval contains space for 'ob_size+1' elements.
     *     ob_sval[ob_size] == 0.
     *     ob_shash is the hash of the string or -1 if not computed yet.
     */
} PyBytesObject;

typedef struct {
    PyObject ob_base;
    Py_ssize_t ob_size; /* Number of items in variable part */
} PyVarObject;

typedef struct _object {
    Py_ssize_t ob_refcnt;
    struct _typeobject *ob_type;
} PyObject;
上面的数据结构用图示如下所示:
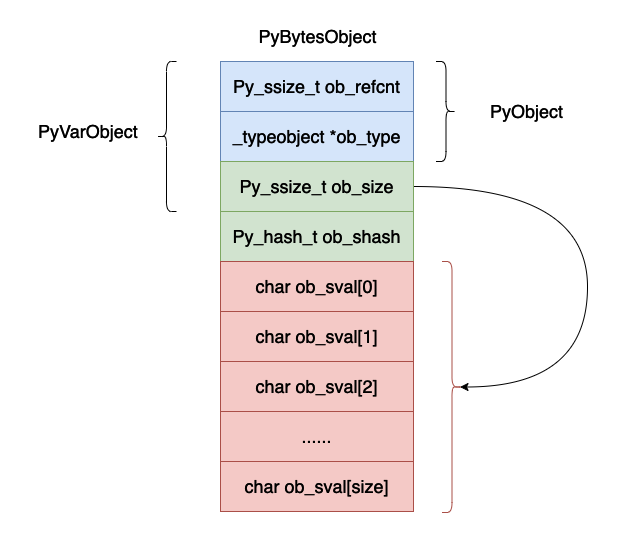
现在我们来解释一下上面的数据结构各个字段的含义:
ob_refcnt,这个还是对象的引用计数的个数,主要是在垃圾回收的时候有用。
ob_type,这个是对象的数据类型。
ob_size,表示这个对象当中字节的个数。
ob_shash,对象的哈希值,如果还没有计算,哈希值为 -1 。
ob_sval,一个数据存储一个字节的数据,需要注意的是 ob_sval[size] 一定等于 '\0' ,表示字符串的结尾。
可能你会有疑问上面的结构体当中并没有后面的那么多字节啊,数组只有一个字节的数据啊,这是因为在 cpython 的实现当中除了申请 PyBytesObject 大的小内存空间之外,还会在这个基础之上申请连续的额外的内存空间用于保存数据,在后续的源码分析当中可以看到这一点。
下面我们举几个例子来说明一下上面的布局:
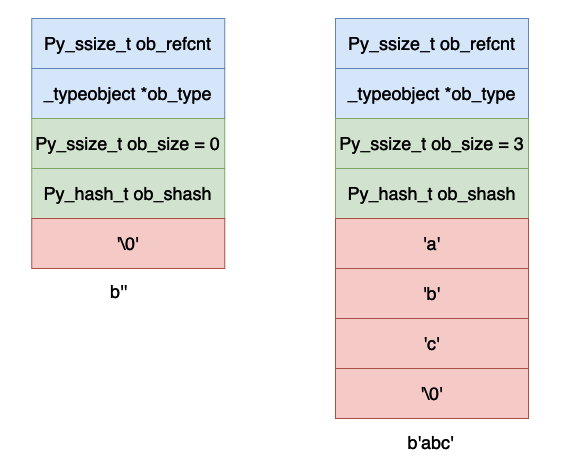
上面是空和字符串 abc 的字节表示。
创建字节对象
下面是在 cpython 当中通过字节数创建 PyBytesObject 对象的函数。下面的函数的主要功能是创建一个能够存储 size 个字节大小的数据的 PyBytesObject 对象,下面的函数最重要的一个步骤就是申请内存空间。
static PyObject *
_PyBytes_FromSize(Py_ssize_t size, int use_calloc)
{
    PyBytesObject *op;
    assert(size >= 0);

    if (size == 0 && (op = nullstring) != NULL) {
#ifdef COUNT_ALLOCS
        null_strings++;
#endif
        Py_INCREF(op);
        return (PyObject *)op;
    }

    if ((size_t)size > (size_t)PY_SSIZE_T_MAX - PyBytesObject_SIZE) {
        PyErr_SetString(PyExc_OverflowError,
                        "byte string is too large");
        return NULL;
    }

    /* Inline PyObject_NewVar */
    // PyBytesObject_SIZE + size 就是实际申请的内存空间的大小 PyBytesObject_SIZE 就是表示 PyBytesObject 各个字段占用的实际的内存空间大小
    if (use_calloc)
        op = (PyBytesObject *)PyObject_Calloc(1, PyBytesObject_SIZE + size);
    else
        op = (PyBytesObject *)PyObject_Malloc(PyBytesObject_SIZE + size);
    if (op == NULL)
        return PyErr_NoMemory();
    // 将对象的 ob_size 字段赋值成 size
    (void)PyObject_INIT_VAR(op, &PyBytes_Type, size);
    // 由于对象的哈希值还没有进行计算 因此现将哈希值赋值成 -1
    op->ob_shash = -1;
    if (!use_calloc)
        op->ob_sval[size] = '\0';
    /* empty byte string singleton */
    if (size == 0) {
        nullstring = op;
        Py_INCREF(op);
    }
    return (PyObject *) op;
}
我们可以使用一个写例子来看一下实际的 PyBytesObject 内存空间的大小。
>>> import sys
>>> a = b"hello world"
>>> sys.getsizeof(a)
44
>>>
上面的 44 = 32 + 11 + 1 。
其中 32 是 PyBytesObject 4 个字段所占用的内存空间,ob_refcnt、ob_type、ob_size和 ob_shash 各占 8 个字节。11 是表示字符串 "hello world" 占用 11 个字节,最后一个字节是 '\0' 。
查看字节长度
这个函数主要是返回 PyBytesObject 对象的字节长度,也就是直接返回 ob_size 的值。
static Py_ssize_t
bytes_length(PyBytesObject *a)
{
    // (((PyVarObject*)(ob))->ob_size)
    return Py_SIZE(a);
}
字节拼接
在 python 当中执行下面的代码就会执行字节拼接函数:
>>> b"abc" + b"edf"
下方就是具体的执行字节拼接的函数:
/* This is also used by PyBytes_Concat() */
static PyObject *
bytes_concat(PyObject *a, PyObject *b)
{
    Py_buffer va, vb;
    PyObject *result = NULL;

    va.len = -1;
    vb.len = -1;
    // Py_buffer 当中有一个指针字段 buf 可以用户保存 PyBytesObject 当中字节数据的首地址
    // PyObject_GetBuffer 函数的主要作用是将 对象 a 当中的字节数组赋值给 va 当中的 buf
    if (PyObject_GetBuffer(a, &va, PyBUF_SIMPLE) != 0 ||
        PyObject_GetBuffer(b, &vb, PyBUF_SIMPLE) != 0) {
        PyErr_Format(PyExc_TypeError, "can't concat %.100s to %.100s",
                     Py_TYPE(b)->tp_name, Py_TYPE(a)->tp_name);
        goto done;
    }

    /* Optimize end cases */
    if (va.len == 0 && PyBytes_CheckExact(b)) {
        result = b;
        Py_INCREF(result);
        goto done;
    }
    if (vb.len == 0 && PyBytes_CheckExact(a)) {
        result = a;
        Py_INCREF(result);
        goto done;
    }

    if (va.len > PY_SSIZE_T_MAX - vb.len) {
        PyErr_NoMemory();
        goto done;
    }
    result = PyBytes_FromStringAndSize(NULL, va.len + vb.len);
    // 下方就是将对象 a b 当中的字节数据拷贝到新的
    if (result != NULL) {
        // PyBytes_AS_STRING 宏定义在下方当中 主要就是使用 PyBytesObject 对象当中的
        // ob_sval 字段 也就是将 buf 数据(也就是 a 或者 b 当中的字节数据)拷贝到 ob_sval当中
        memcpy(PyBytes_AS_STRING(result), va.buf, va.len);
        memcpy(PyBytes_AS_STRING(result) + va.len, vb.buf, vb.len);
    }

  done:
    if (va.len != -1)
        PyBuffer_Release(&va);
    if (vb.len != -1)
        PyBuffer_Release(&vb);
    return result;
}
#define PyBytes_AS_STRING(op) (assert(PyBytes_Check(op)), \ (((PyBytesObject *)(op))->ob_sval))
我们修改一个这个函数,在其中加入一条打印语句,然后重新编译 python 执行结果如下所示:
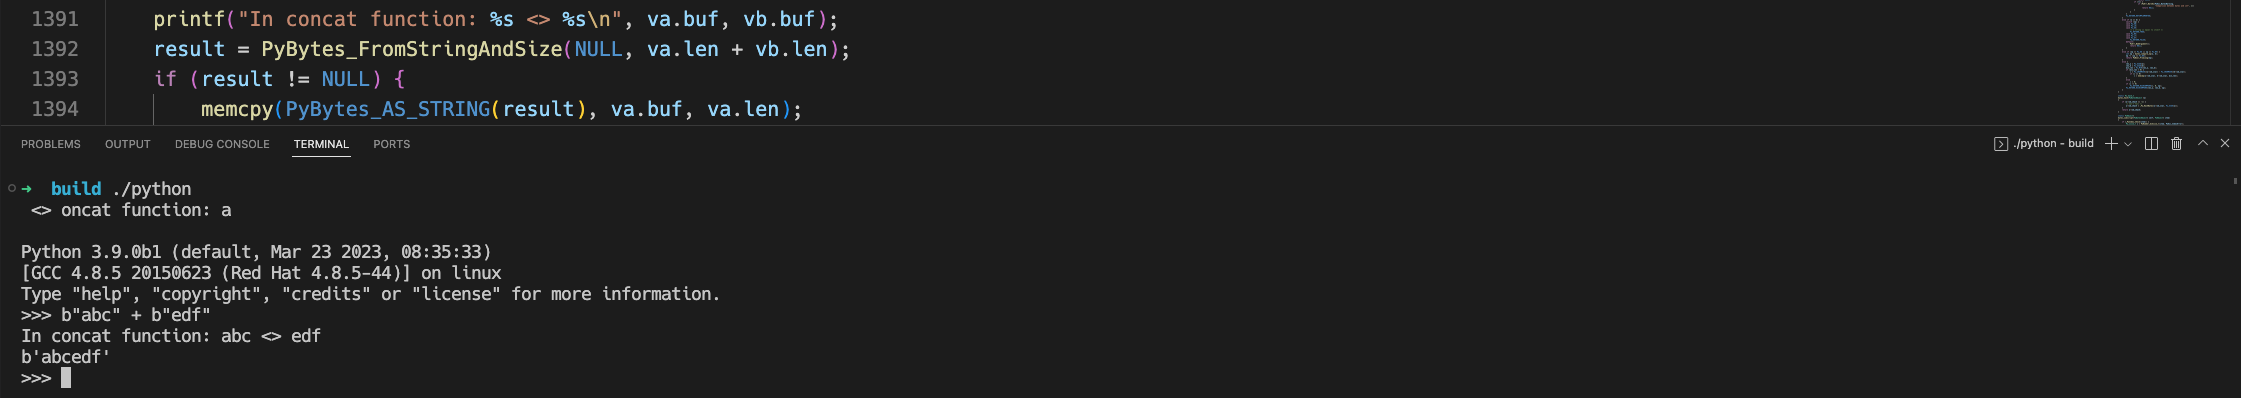
Python 3.9.0b1 (default, Mar 23 2023, 08:35:33)
[GCC 4.8.5 20150623 (Red Hat 4.8.5-44)] on linux
Type "help", "copyright", "credits" or "license" for more information.
>>> b"abc" + b"edf"
In concat function: abc <> edf
b'abcedf'
>>>
在上面的拼接函数当中会拷贝原来的两个字节对象,因此需要谨慎使用,一旦发生非常多的拷贝的话是非常耗费内存的。因此需要警惕使用循环内的内存拼接。比如对于 [b"a", b"b", b"c"] 来说,如果使用循环拼接的话,那么会将 b"a" 拷贝两次。
>>> res = b""
>>> for item in  [b"a", b"b", b"c"]:
...     res += item
...
>>> res
b'abc'
>>>
因为 b"a", b"b" 在拼接的时候会将他们分别拷贝一次,在进行 b"ab",b"c" 拼接的时候又会将 ab 和 c 拷贝一次,那么具体的拷贝情况如下所示:
"a" 拷贝了一次。
"b" 拷贝了一次。
"ab" 拷贝了一次。
"c" 拷贝了一次。
但是实际上我们的需求是只需要对 [b"a", b"b", b"c"] 当中的数据各拷贝一次,如果我们要实现这一点可以使用 b"".join([b"a", b"b", b"c"]),直接将 [b"a", b"b", b"c"] 作为参数传递,然后各自只拷贝一次,具体的实现代码如下所示,在这个例子当中 sep 就是空串 b"",iterable 就是 [b"a", b"b", b"c"] 。
Py_LOCAL_INLINE(PyObject *)
STRINGLIB(bytes_join)(PyObject *sep, PyObject *iterable)
{
    char *sepstr = STRINGLIB_STR(sep);
    const Py_ssize_t seplen = STRINGLIB_LEN(sep);
    PyObject *res = NULL;
    char *p;
    Py_ssize_t seqlen = 0;
    Py_ssize_t sz = 0;
    Py_ssize_t i, nbufs;
    PyObject *seq, *item;
    Py_buffer *buffers = NULL;
#define NB_STATIC_BUFFERS 10
    Py_buffer static_buffers[NB_STATIC_BUFFERS];

    seq = PySequence_Fast(iterable, "can only join an iterable");
    if (seq == NULL) {
        return NULL;
    }

    seqlen = PySequence_Fast_GET_SIZE(seq);
    if (seqlen == 0) {
        Py_DECREF(seq);
        return STRINGLIB_NEW(NULL, 0);
    }
#ifndef STRINGLIB_MUTABLE
    if (seqlen == 1) {
        item = PySequence_Fast_GET_ITEM(seq, 0);
        if (STRINGLIB_CHECK_EXACT(item)) {
            Py_INCREF(item);
            Py_DECREF(seq);
            return item;
        }
    }
#endif
    if (seqlen > NB_STATIC_BUFFERS) {
        buffers = PyMem_NEW(Py_buffer, seqlen);
        if (buffers == NULL) {
            Py_DECREF(seq);
            PyErr_NoMemory();
            return NULL;
        }
    }
    else {
        buffers = static_buffers;
    }

    /* Here is the general case.  Do a pre-pass to figure out the total
     * amount of space we'll need (sz), and see whether all arguments are
     * bytes-like.
     */
    for (i = 0, nbufs = 0; i < seqlen; i++) {
        Py_ssize_t itemlen;
        item = PySequence_Fast_GET_ITEM(seq, i);
        if (PyBytes_CheckExact(item)) {
            /* Fast path. */
            Py_INCREF(item);
            buffers[i].obj = item;
            buffers[i].buf = PyBytes_AS_STRING(item);
            buffers[i].len = PyBytes_GET_SIZE(item);
        }
        else if (PyObject_GetBuffer(item, &buffers[i], PyBUF_SIMPLE) != 0) {
            PyErr_Format(PyExc_TypeError,
                         "sequence item %zd: expected a bytes-like object, "
                         "%.80s found",
                         i, Py_TYPE(item)->tp_name);
            goto error;
        }
        nbufs = i + 1;  /* for error cleanup */
        itemlen = buffers[i].len;
        if (itemlen > PY_SSIZE_T_MAX - sz) {
            PyErr_SetString(PyExc_OverflowError,
                            "join() result is too long");
            goto error;
        }
        sz += itemlen;
        if (i != 0) {
            if (seplen > PY_SSIZE_T_MAX - sz) {
                PyErr_SetString(PyExc_OverflowError,
                                "join() result is too long");
                goto error;
            }
            sz += seplen;
        }
        if (seqlen != PySequence_Fast_GET_SIZE(seq)) {
            PyErr_SetString(PyExc_RuntimeError,
                            "sequence changed size during iteration");
            goto error;
        }
    }

    /* Allocate result space. */
    res = STRINGLIB_NEW(NULL, sz);
    if (res == NULL)
        goto error;

    /* Catenate everything. */
    p = STRINGLIB_STR(res);
    if (!seplen) {
        /* fast path */
        for (i = 0; i < nbufs; i++) {
            Py_ssize_t n = buffers[i].len;
            char *q = buffers[i].buf;
            Py_MEMCPY(p, q, n);
            p += n;
        }
        goto done;
    }
    // 具体的实现逻辑就是在这里
    for (i = 0; i < nbufs; i++) {
        Py_ssize_t n;
        char *q;
        if (i) {
            // 首先现将 sepstr 拷贝到新的数组里面但是在我们举的例子当中是空串 b""
            Py_MEMCPY(p, sepstr, seplen);
            p += seplen;
        }
        n = buffers[i].len;
        q = buffers[i].buf;
        // 然后将列表当中第 i 个 bytes 的数据拷贝到 p 当中 这样就是实现了我们所需要的效果
        Py_MEMCPY(p, q, n);
        p += n;
    }
    goto done;

error:
    res = NULL;
done:
    Py_DECREF(seq);
    for (i = 0; i < nbufs; i++)
        PyBuffer_Release(&buffers[i]);
    if (buffers != static_buffers)
        PyMem_FREE(buffers);
    return res;
}
单字节字符
在 cpython 的内部实现当中给单字节的字符做了一个小的缓冲池:
static PyBytesObject *characters[UCHAR_MAX + 1]; // UCHAR_MAX 在 64 位系统当中等于 255
当创建的 bytes 只有一个字符的时候就可以检查是否 characters 当中已经存在了,如果存在就直接返回这个已经创建好的 PyBytesObject 对象,否则再进行创建。新创建的 PyBytesObject 对象如果长度等于 1 的话也会被加入到这个数组当中。下面是 PyBytesObject 的另外一个创建函数:
PyObject *
PyBytes_FromStringAndSize(const char *str, Py_ssize_t size)
{
    PyBytesObject *op;
    if (size < 0) {
        PyErr_SetString(PyExc_SystemError,
            "Negative size passed to PyBytes_FromStringAndSize");
        return NULL;
    }
    // 如果创建长度等于 1 而且对象在 characters 当中存在的话那么就直接返回
    if (size == 1 && str != NULL &&
        (op = characters[*str & UCHAR_MAX]) != NULL)
    {
#ifdef COUNT_ALLOCS
        one_strings++;
#endif
        Py_INCREF(op);
        return (PyObject *)op;
    }

    op = (PyBytesObject *)_PyBytes_FromSize(size, 0);
    if (op == NULL)
        return NULL;
    if (str == NULL)
        return (PyObject *) op;

    Py_MEMCPY(op->ob_sval, str, size);
    /* share short strings */
    // 如果创建的对象的长度等于 1 那么久将这个对象保存到 characters 当中
    if (size == 1) {
        characters[*str & UCHAR_MAX] = op;
        Py_INCREF(op);
    }
    return (PyObject *) op;
}
我们可以使用下面的代码进行验证:
>>> a = b"a"
>>> b  =b"a"
>>> a == b
True
>>> a is b
True
>>> a = b"aa"
>>> b = b"aa"
>>> a == b
True
>>> a is b
False
从上面的代码可以知道,确实当我们创建的 bytes 的长度等于 1 的时候对象确实是同一个对象。




















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。