


Python时间序列数据操作的常用方法总结
时间序列数据是一种在一段时间内收集的数据类型,它通常用于金融、经济学和气象学等领域,经常通过分析来了解随着时间的推移的趋势和模式Pandas是Python中一个强大且流行的数据操作库,特别适合处理时间序列数据。它提供了一系列工具和函数可以轻松加载、操作和分析时间序列数据。在本文中,我们介绍时间序列数据的索引和切片、重新采样和滚动窗口计算以及其他有用的常见操作,这些都是使用Pandas操作时间序列数据的关键技术。数据类型Python在Python中,没有专门用于表示日期的内置数据类型。一般情况下都会使用da
时间序列数据是一种在一段时间内收集的数据类型,它通常用于金融、经济学和气象学等领域,经常通过分析来了解随着时间的推移的趋势和模式
Pandas是Python中一个强大且流行的数据操作库,特别适合处理时间序列数据。它提供了一系列工具和函数可以轻松加载、操作和分析时间序列数据。
在本文中,我们介绍时间序列数据的索引和切片、重新采样和滚动窗口计算以及其他有用的常见操作,这些都是使用Pandas操作时间序列数据的关键技术。
数据类型
Python
在Python中,没有专门用于表示日期的内置数据类型。一般情况下都会使用datetime模块提供的datetime对象进行日期时间的操作。
import datetime

t = datetime.datetime.now()
print(f"type: {type(t)} and t: {t}")
#type:  and t: 2022-12-26 14:20:51.278230
一般情况下我们都会使用字符串的形式存储日期和时间。所以在使用时我们需要将这些字符串进行转换成datetime对象。
一般情况下时间的字符串有以下格式:
- YYYY-MM-DD (e.g. 2022-01-01)
- YYYY/MM/DD (e.g. 2022/01/01)
- DD-MM-YYYY (e.g. 01-01-2022)
- DD/MM/YYYY (e.g. 01/01/2022)
- MM-DD-YYYY (e.g. 01-01-2022)
- MM/DD/YYYY (e.g. 01/01/2022)
- HH:MM:SS (e.g. 11:30:00)
- HH:MM:SS AM/PM (e.g. 11:30:00 AM)
- HH:MM AM/PM (e.g. 11:30 AM)
strptime 函数以字符串和格式字符串作为参数,返回一个datetime对象。
string = '2022-01-01 11:30:09'
t = datetime.datetime.strptime(string, "%Y-%m-%d %H:%M:%S")
print(f"type: {type(t)} and t: {t}")
#type:  and t: 2022-01-01 11:30:09
格式字符串如下:
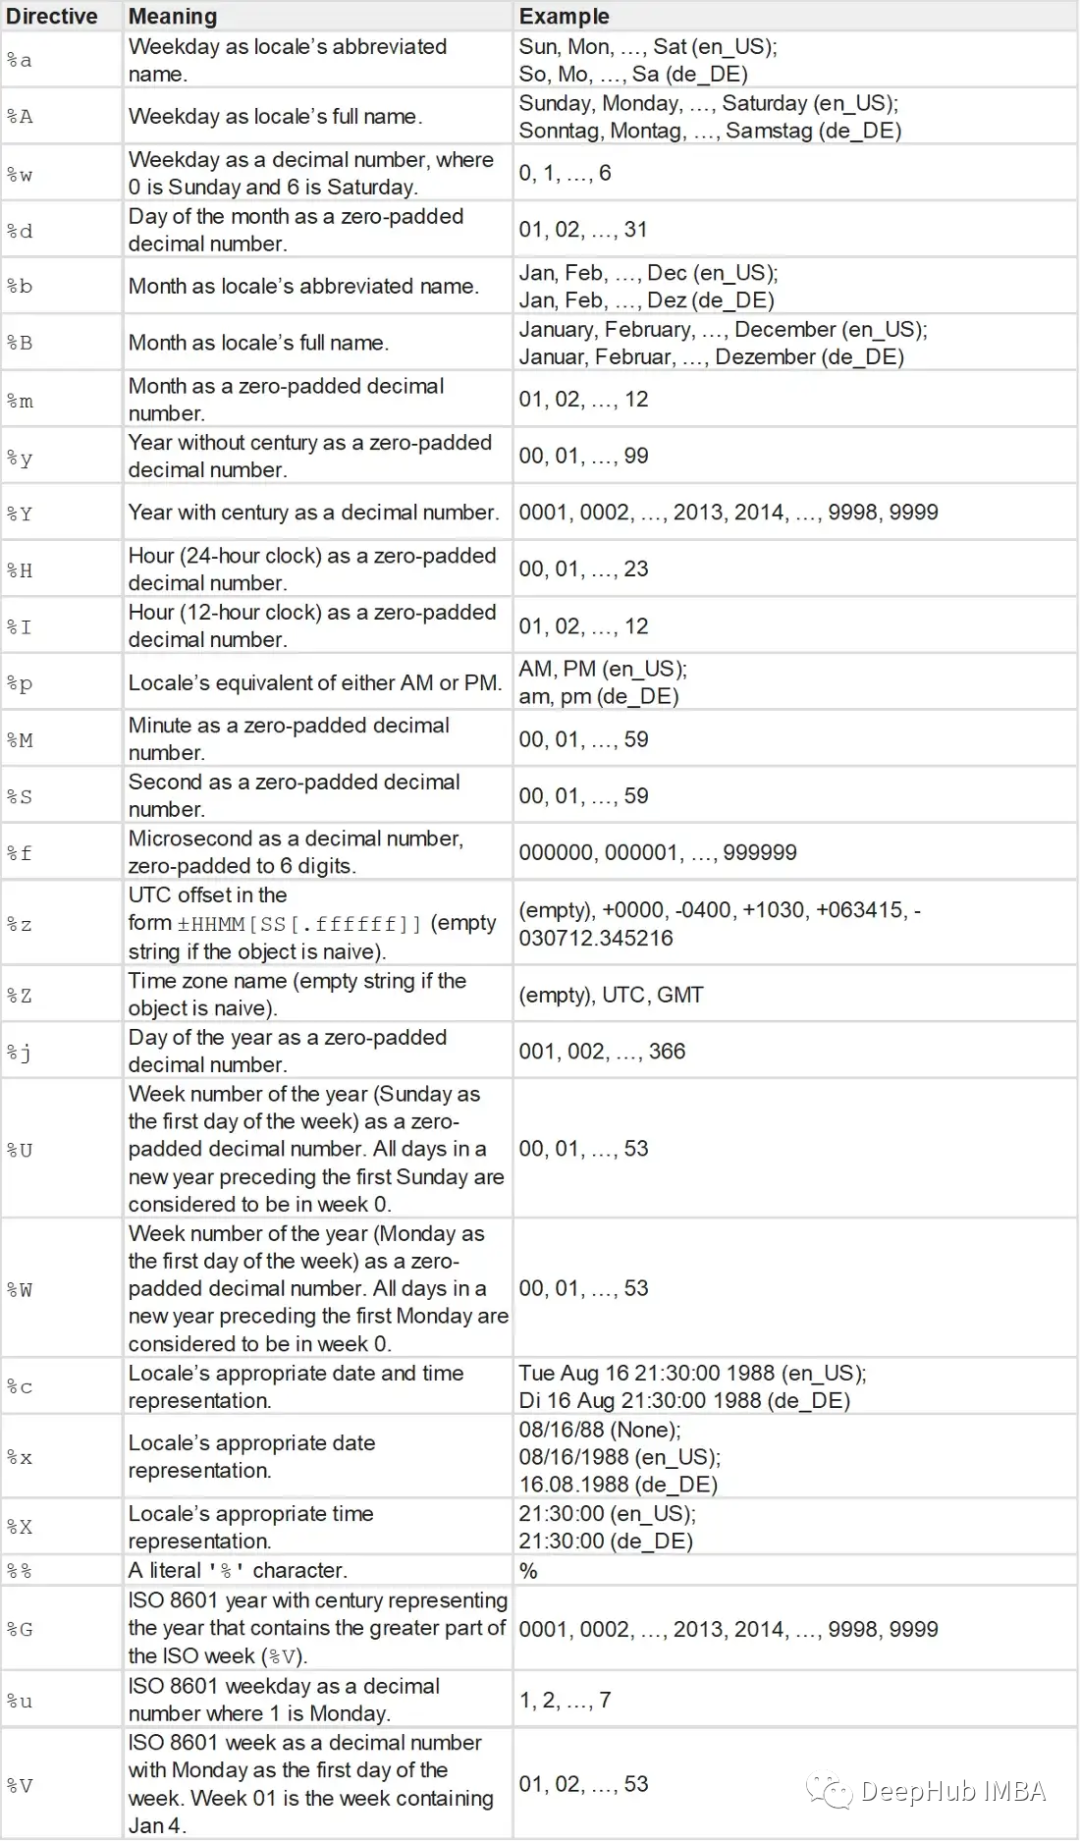
还可以使用strftime函数将datetime对象转换回特定格式的字符串表示。
t = datetime.datetime.now()
t_string = t.strftime("%m/%d/%Y, %H:%M:%S")
#12/26/2022, 14:38:47

t_string = t.strftime("%b/%d/%Y, %H:%M:%S")
#Dec/26/2022, 14:39:32
Unix时间(POSIX时间或epoch时间)是一种将时间表示为单个数值的系统。它表示自1970年1月1日星期四00:00:00协调世界时(UTC)以来经过的秒数。
Unix时间和时间戳通常可以互换使用。Unix时间是创建时间戳的标准版本。一般情况下使用整数或浮点数据类型用于存储时间戳和Unix时间。
我们可以使用time模块的mktime方法将datetime对象转换为Unix时间整数。也可以使用datetime模块的fromtimestamp方法。
#convert datetime to unix time
import time
from datetime import datetime

t = datetime.now()
unix_t = int(time.mktime(t.timetuple()))
#1672055277

#convert unix time to datetime
unix_t = 1672055277
t = datetime.fromtimestamp(unix_t)
#2022-12-26 14:47:57
使用dateutil模块来解析日期字符串获得datetime对象。
from dateutil import parser
date = parser.parse("29th of October, 1923")
#datetime.datetime(1923, 10, 29, 0, 0)
Pandas
Pandas提供了三种日期数据类型:
1、Timestamp或DatetimeIndex:它的功能类似于其他索引类型,但也具有用于时间序列操作的专门函数。
t = pd.to_datetime("29/10/1923", dayfirst=True)
#Timestamp('1923-10-29 00:00:00')

t = pd.Timestamp('2019-01-01', tz = 'Europe/Berlin')
#Timestamp('2019-01-01 00:00:00+0100', tz='Europe/Berlin')

t = pd.to_datetime(["04/23/1920", "10/29/1923"])
#DatetimeIndex(['1920-04-23', '1923-10-29'], dtype='datetime64[ns]', freq=None)
2、period或PeriodIndex:一个有开始和结束的时间间隔。它由固定的间隔组成。
t = pd.to_datetime(["04/23/1920", "10/29/1923"])
period = t.to_period("D")
#PeriodIndex(['1920-04-23', '1923-10-29'], dtype='period[D]')
3、Timedelta或TimedeltaIndex:两个日期之间的时间间隔。
delta = pd.TimedeltaIndex(data =['1 days 03:00:00',
 '2 days 09:05:01.000030'])
"""
TimedeltaIndex(['1 days 02:00:00', '1 days 06:05:01.000030'],
dtype='timedelta64[ns]', freq=None)
"""
在Pandas中,可以使用to_datetime方法将对象转换为datetime数据类型或进行任何其他转换。
import pandas as pd
df = pd.read_csv("dataset.txt")
df.head()

"""

date value
0 1991-07-01 3.526591
1 1991-08-01 3.180891
2 1991-09-01 3.252221
3 1991-10-01 3.611003
4 1991-11-01 3.565869
"""

df.info()

"""

RangeIndex: 204 entries, 0 to 203
Data columns (total 2 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 date 204 non-null object
1 value 204 non-null float64
dtypes: float64(1), object(1)
memory usage: 3.3+ KB
"""

# Convert to datetime
df["date"] = pd.to_datetime(df["date"], format = "%Y-%m-%d")

df.info()

"""

RangeIndex: 204 entries, 0 to 203
Data columns (total 2 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 date 204 non-null datetime64[ns]
1 value 204 non-null float64
dtypes: datetime64[ns](1), float64(1)
memory usage: 3.3 KB
"""

# Convert to Unix
df['unix_time'] = df['date'].apply(lambda x: x.timestamp())
df.head()
"""
date value unix_time
0 1991-07-01 3.526591 678326400.0
1 1991-08-01 3.180891 681004800.0
2 1991-09-01 3.252221 683683200.0
3 1991-10-01 3.611003 686275200.0
4 1991-11-01 3.565869 688953600.0
"""

df["date_converted_from_unix"] = pd.to_datetime(df["unix_time"], unit = "s")
df.head()
"""
date value unix_time date_converted_from_unix
0 1991-07-01 3.526591 678326400.0 1991-07-01
1 1991-08-01 3.180891 681004800.0 1991-08-01
2 1991-09-01 3.252221 683683200.0 1991-09-01
3 1991-10-01 3.611003 686275200.0 1991-10-01
4 1991-11-01 3.565869 688953600.0 1991-11-01
"""
我们还可以使用parse_dates参数在任何文件加载时直接声明日期列。
df = pd.read_csv("dataset.txt", parse_dates=["date"])
df.info()

"""

RangeIndex: 204 entries, 0 to 203
Data columns (total 2 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 date 204 non-null datetime64[ns]
1 value 204 non-null float64
dtypes: datetime64[ns](1), float64(1)
memory usage: 3.3 KB
"""
如果是单个时间序列的数据,最好将日期列作为数据集的索引。
df.set_index("date",inplace=True)

"""
Value
date
1991-07-01 3.526591
1991-08-01 3.180891
1991-09-01 3.252221
1991-10-01 3.611003
1991-11-01 3.565869
... ...
2008-02-01 21.654285
2008-03-01 18.264945
2008-04-01 23.107677
2008-05-01 22.912510
2008-06-01 19.431740
"""
Numpy也有自己的datetime类型np.Datetime64。特别是在大型数据集时,向量化是非常有用的,应该优先使用。
import numpy as np
arr_date = np.array('2000-01-01', dtype=np.datetime64)
arr_date
#array('2000-01-01', dtype='datetime64[D]')

#broadcasting
arr_date = arr_date + np.arange(30)
"""
array(['2000-01-01', '2000-01-02', '2000-01-03', '2000-01-04',
'2000-01-05', '2000-01-06', '2000-01-07', '2000-01-08',
'2000-01-09', '2000-01-10', '2000-01-11', '2000-01-12',
'2000-01-13', '2000-01-14', '2000-01-15', '2000-01-16',
'2000-01-17', '2000-01-18', '2000-01-19', '2000-01-20',
'2000-01-21', '2000-01-22', '2000-01-23', '2000-01-24',
'2000-01-25', '2000-01-26', '2000-01-27', '2000-01-28',
'2000-01-29', '2000-01-30'], dtype='datetime64[D]')
"""
有用的函数
下面列出的是一些可能对时间序列有用的函数。
df = pd.read_csv("dataset.txt", parse_dates=["date"])
df["date"].dt.day_name()

"""
0 Monday
1 Thursday
2 Sunday
3 Tuesday
4 Friday
...
199 Friday
200 Saturday
201 Tuesday
202 Thursday
203 Sunday
Name: date, Length: 204, dtype: object
"""
DataReader
Pandas_datareader是pandas库的一个辅助库。它提供了许多常见的金融时间序列数据。
#pip install pandas-datareader
from pandas_datareader import wb
#GDP per Capita From World Bank
df = wb.download(indicator='NY.GDP.PCAP.KD',
 country=['US', 'FR', 'GB', 'DK', 'NO'], start=1960, end=2019)

"""
NY.GDP.PCAP.KD
country year
Denmark 2019 57203.027794
2018 56563.488473
2017 55735.764901
2016 54556.068955
2015 53254.856370
... ...
United States 1964 21599.818705
1963 20701.269947
1962 20116.235124
1961 19253.547329
1960 19135.268182

[300 rows x 1 columns]
"""
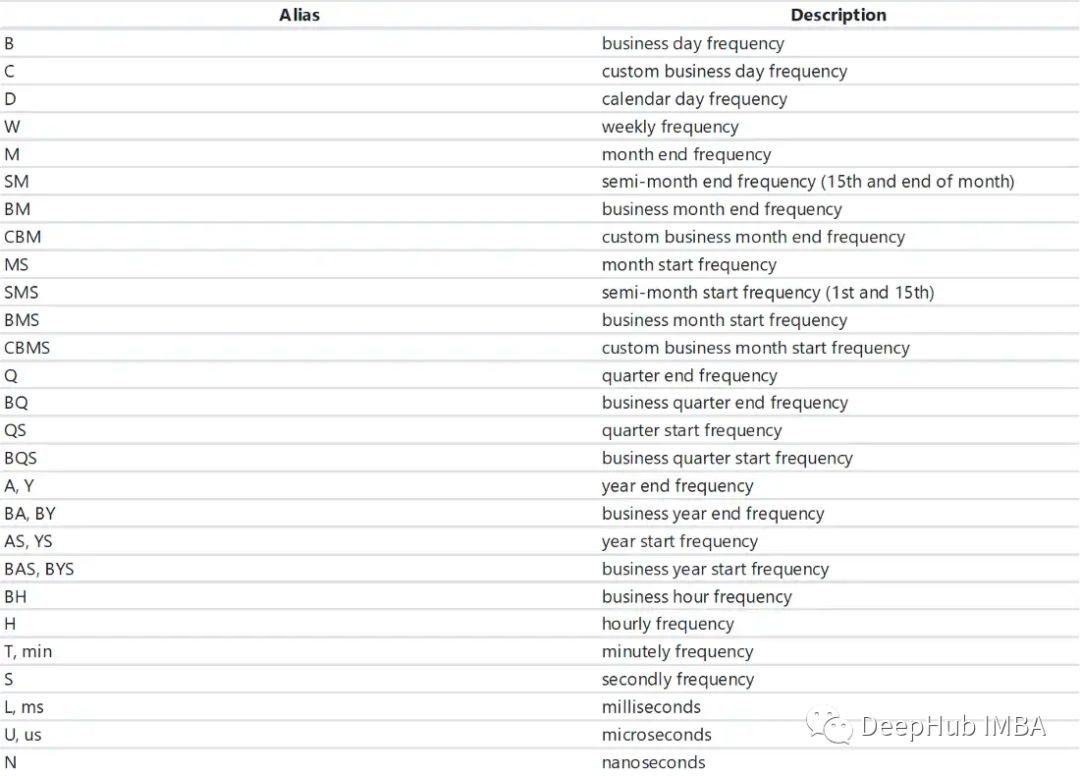
日期范围
我们可以使用pandas的date_range方法定义一个日期范围。
pd.date_range(start="2021-01-01", end="2022-01-01", freq="D")

"""
DatetimeIndex(['2021-01-01', '2021-01-02', '2021-01-03', '2021-01-04',
'2021-01-05', '2021-01-06', '2021-01-07', '2021-01-08',
'2021-01-09', '2021-01-10',
...
'2021-12-23', '2021-12-24', '2021-12-25', '2021-12-26',
'2021-12-27', '2021-12-28', '2021-12-29', '2021-12-30',
'2021-12-31', '2022-01-01'],
dtype='datetime64[ns]', length=366, freq='D')
"""

pd.date_range(start="2021-01-01", end="2022-01-01", freq="BM")

"""
DatetimeIndex(['2021-01-29', '2021-02-26', '2021-03-31', '2021-04-30',
'2021-05-31', '2021-06-30', '2021-07-30', '2021-08-31',
'2021-09-30', '2021-10-29', '2021-11-30', '2021-12-31'],
dtype='datetime64[ns]', freq='BM')
"""

fridays= pd.date_range('2022-11-01', '2022-12-31', freq="W-FRI")
"""
DatetimeIndex(['2022-11-04', '2022-11-11', '2022-11-18', '2022-11-25',
'2022-12-02', '2022-12-09', '2022-12-16', '2022-12-23',
'2022-12-30'],
dtype='datetime64[ns]', freq='W-FRI')
"""
我们可以使用timedelta_range方法创建一个时间序列。
t = pd.timedelta_range(0, periods=10, freq="H")

"""
TimedeltaIndex(['0 days 00:00:00', '0 days 01:00:00', '0 days 02:00:00',
'0 days 03:00:00', '0 days 04:00:00', '0 days 05:00:00',
'0 days 06:00:00', '0 days 07:00:00', '0 days 08:00:00',
'0 days 09:00:00'],
dtype='timedelta64[ns]', freq='H')
"""
格式化
我们dt.strftime方法改变日期列的格式。
df["new_date"] = df["date"].dt.strftime("%b %d, %Y")
df.head()
"""
date value new_date
0 1991-07-01 3.526591 Jul 01, 1991
1 1991-08-01 3.180891 Aug 01, 1991
2 1991-09-01 3.252221 Sep 01, 1991
3 1991-10-01 3.611003 Oct 01, 1991
4 1991-11-01 3.565869 Nov 01, 1991
"""
解析
解析datetime对象并获得日期的子对象。
df["year"] = df["date"].dt.year
df["month"] = df["date"].dt.month
df["day"] = df["date"].dt.day
df["calendar"] = df["date"].dt.date
df["hour"] = df["date"].dt.time
df.head()
"""
date value year month day calendar hour
0 1991-07-01 3.526591 1991 7 1 1991-07-01 00:00:00
1 1991-08-01 3.180891 1991 8 1 1991-08-01 00:00:00
2 1991-09-01 3.252221 1991 9 1 1991-09-01 00:00:00
3 1991-10-01 3.611003 1991 10 1 1991-10-01 00:00:00
4 1991-11-01 3.565869 1991 11 1 1991-11-01 00:00:00
"""
还可以重新组合它们。
df["date_joined"] = pd.to_datetime(df[["year","month","day"]])
print(df["date_joined"])
"""
0 1991-07-01
1 1991-08-01
2 1991-09-01
3 1991-10-01
4 1991-11-01
...
199 2008-02-01
200 2008-03-01
201 2008-04-01
202 2008-05-01
203 2008-06-01
Name: date_joined, Length: 204, dtype: datetime64[ns]
过滤查询
使用loc方法来过滤DataFrame。
df = df.loc["2021-01-01":"2021-01-10"]
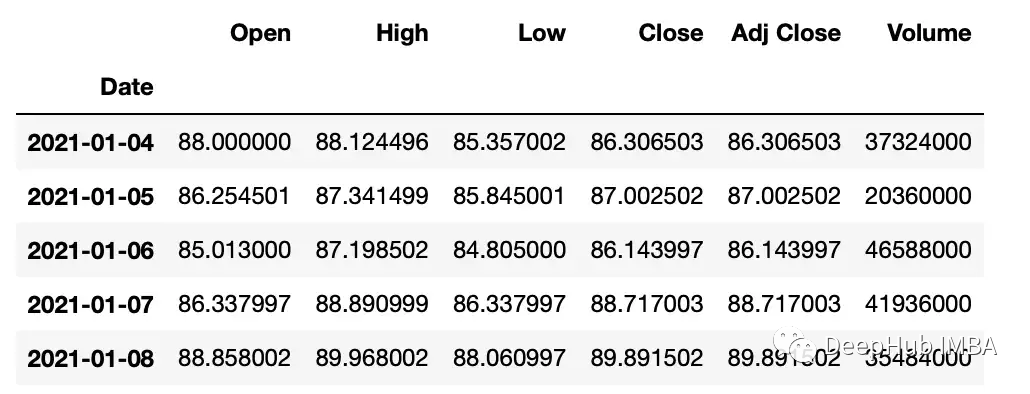
truncate 可以查询两个时间间隔中的数据
df_truncated = df.truncate('2021-01-05', '2022-01-10')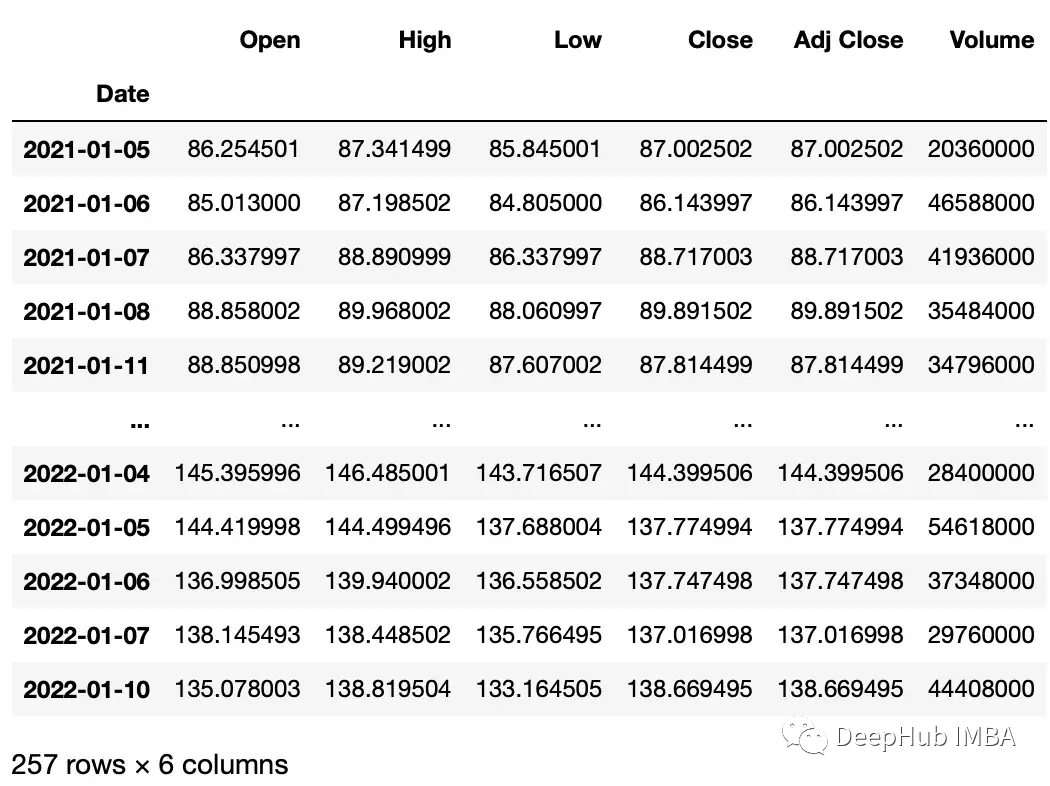
常见数据操作
下面就是对时间序列数据集中的值执行操作。我们使用yfinance库创建一个用于示例的股票数据集。
#get google stock price data
import yfinance as yf
start_date = '2020-01-01'
end_date = '2023-01-01'
ticker = 'GOOGL'
df = yf.download(ticker, start_date, end_date)
df.head()

"""
Date Open High Low Close Adj Close Volume
2020-01-02 67.420502 68.433998 67.324501 68.433998 68.433998 27278000
2020-01-03 67.400002 68.687500 67.365997 68.075996 68.075996 23408000
2020-01-06 67.581497 69.916000 67.550003 69.890503 69.890503 46768000
2020-01-07 70.023003 70.175003 69.578003 69.755501 69.755501 34330000
2020-01-08 69.740997 70.592499 69.631500 70.251999 70.251999 35314000
"""
计算差值
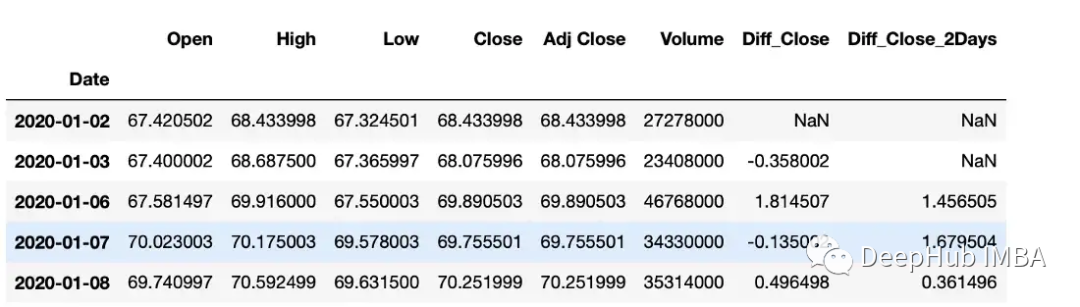
diff函数可以计算一个元素与另一个元素之间的插值。
#subtract that day's value from the previous day
df["Diff_Close"] = df["Close"].diff()
#Subtract that day's value from the day's value 2 days ago
df["Diff_Close_2Days"] = df["Close"].diff(periods=2)
累计总数
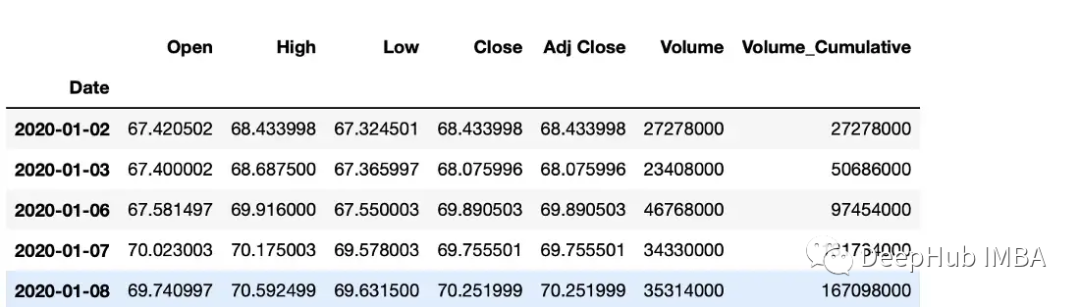
df["Volume_Cumulative"] = df["Volume"].cumsum()
滚动窗口计算
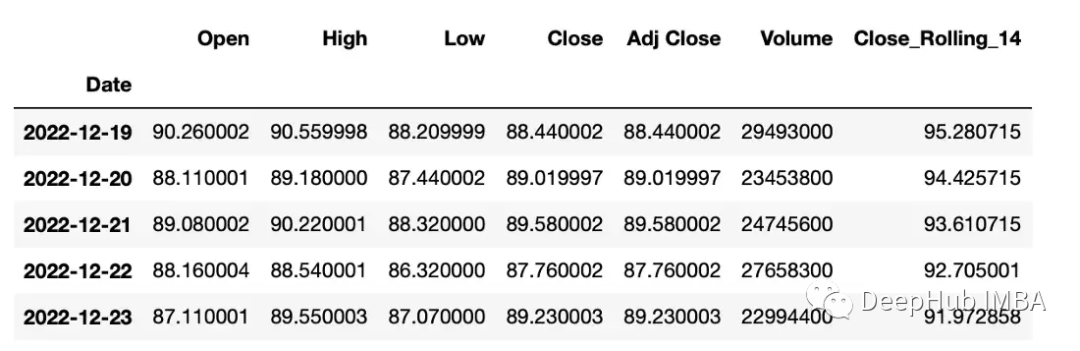
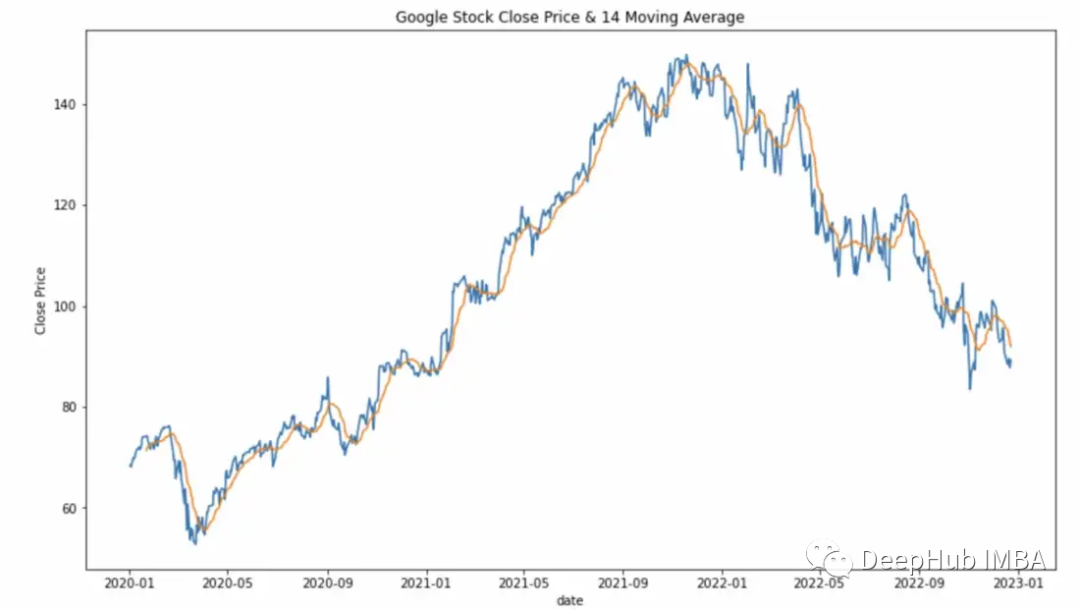
滚动窗口计算(移动平均线)。
df["Close_Rolling_14"] = df["Close"].rolling(14).mean()
df.tail()
可以对我们计算的移动平均线进行可视化
常用的参数:
- center:决定滚动窗口是否应以当前观测值为中心。
- min_periods:窗口中产生结果所需的最小观测次数。
s = pd.Series([1, 2, 3, 4, 5])

#the rolling window will be centered on each observation
rolling_mean = s.rolling(window=3, center=True).mean()
"""
0 NaN
1 2.0
2 3.0
3 4.0
4 NaN
dtype: float64
Explanation:
first window: [na 1 2] = na
second window: [1 2 3] = 2
"""

# the rolling window will not be centered,
#and will instead be anchored to the left side of the window
rolling_mean = s.rolling(window=3, center=False).mean()
"""
0 NaN
1 NaN
2 2.0
3 3.0
4 4.0
dtype: float64
Explanation:
first window: [na na 1] = na
second window: [na 1 2] = na
third window: [1 2 3] = 2
"""
平移
Pandas有两个方法,shift()和tshift(),它们可以指定倍数移动数据或时间序列的索引。Shift()移位数据,而tshift()移位索引。
#shift the data
df_shifted = df.shift(5,axis=0)
df_shifted.head(10)

#shift the indexes
df_tshifted = df.tshift(periods = 4, freq = 'D')
df_tshifted.head(10)
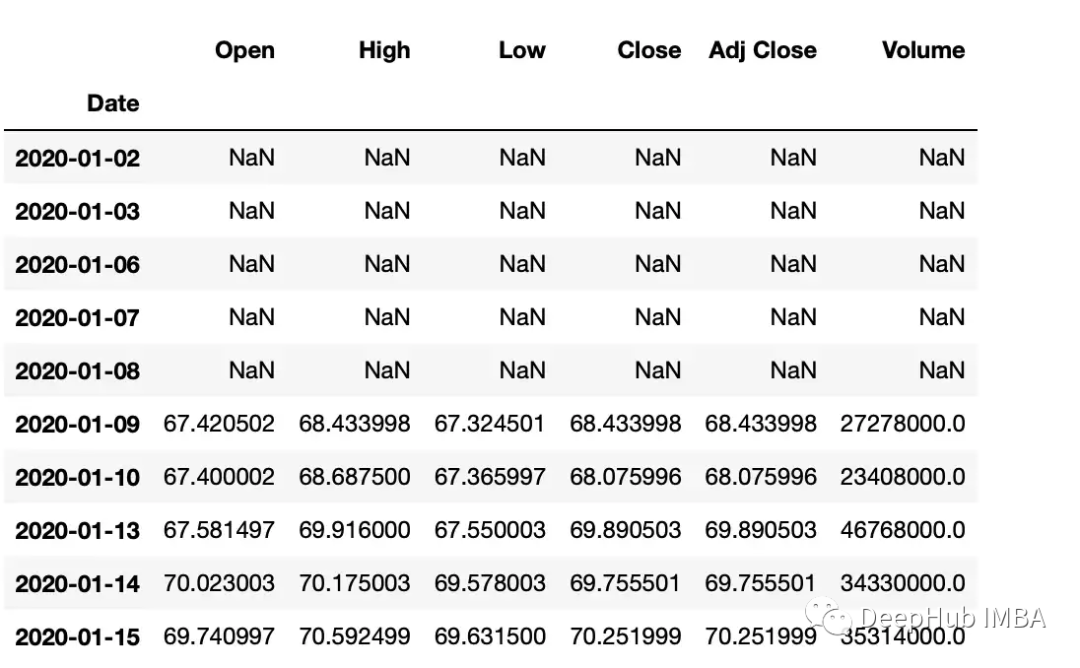
df_shifted
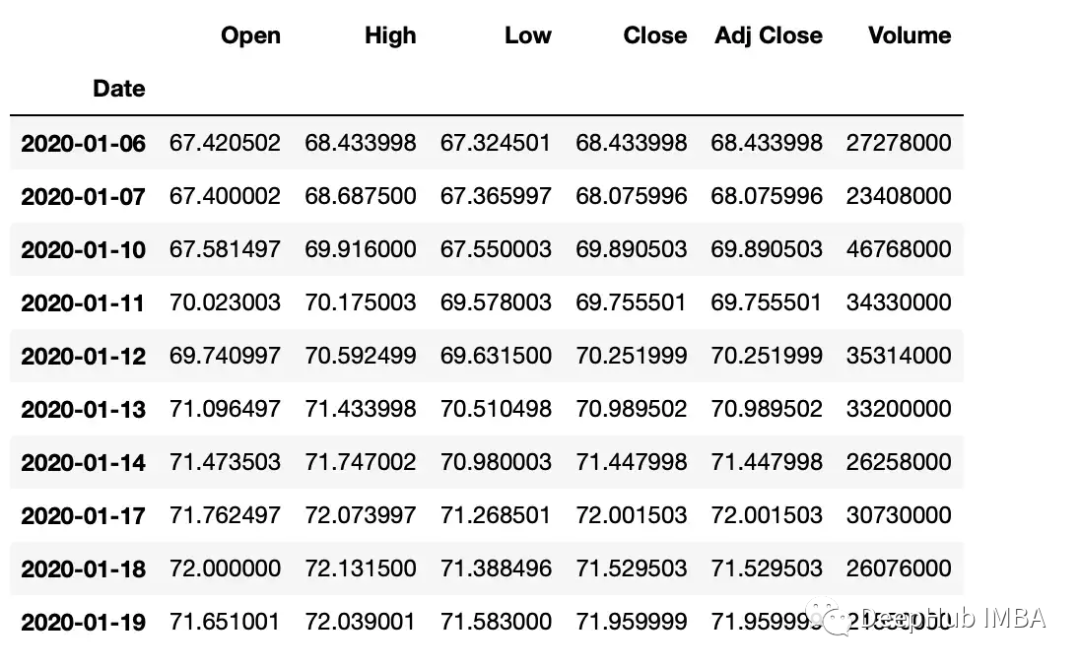
df_tshifted
时间间隔转换
在 Pandas 中,操 to_period 函数允许将日期转换为特定的时间间隔。可以获取具有许多不同间隔或周期的日期
df["Period"] = df["Date"].dt.to_period('W')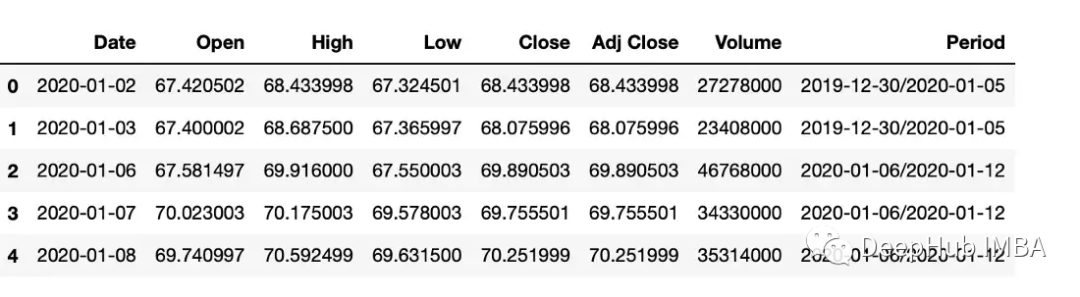
频率
Asfreq方法用于将时间序列转换为指定的频率。
monthly_data = df.asfreq('M', method='ffill')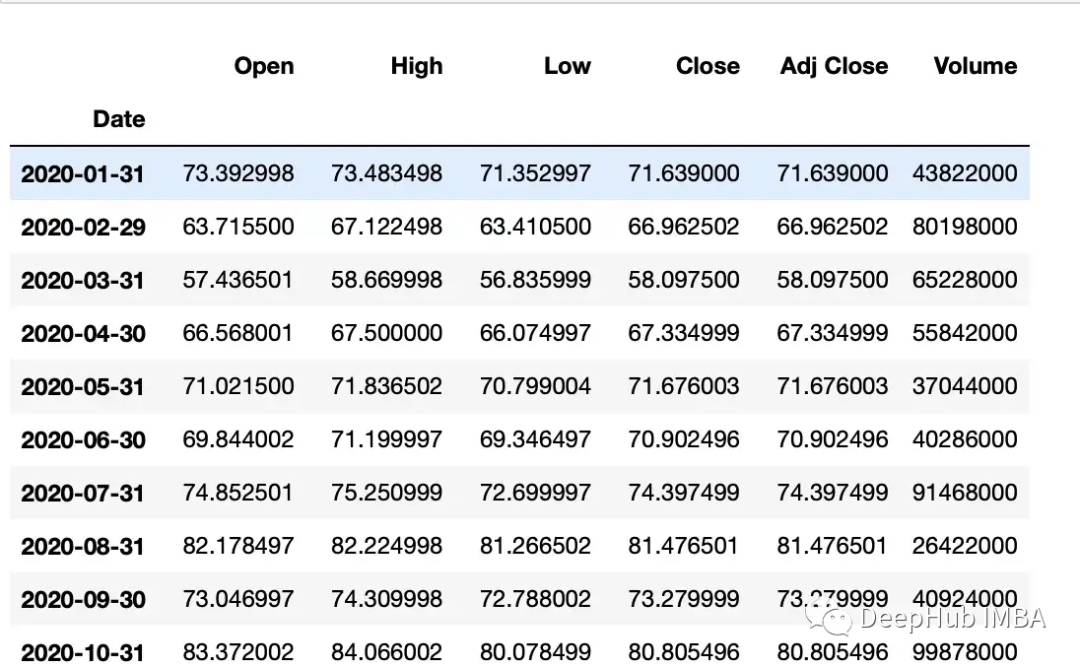
常用参数:
freq:数据应该转换到的频率。这可以使用字符串别名(例如,'M'表示月,'H'表示小时)或pandas偏移量对象来指定。
method:如何在转换频率时填充缺失值。这可以是'ffill'(向前填充)或'bfill'(向后填充)之类的字符串。
采样
resample可以改变时间序列频率并重新采样。我们可以进行上采样(到更高的频率)或下采样(到更低的频率)。因为我们正在改变频率,所以我们需要使用一个聚合函数(比如均值、最大值等)。
resample方法的参数:
rule:数据重新采样的频率。这可以使用字符串别名(例如,'M'表示月,'H'表示小时)或pandas偏移量对象来指定。
#down sample
monthly_data = df.resample('M').mean()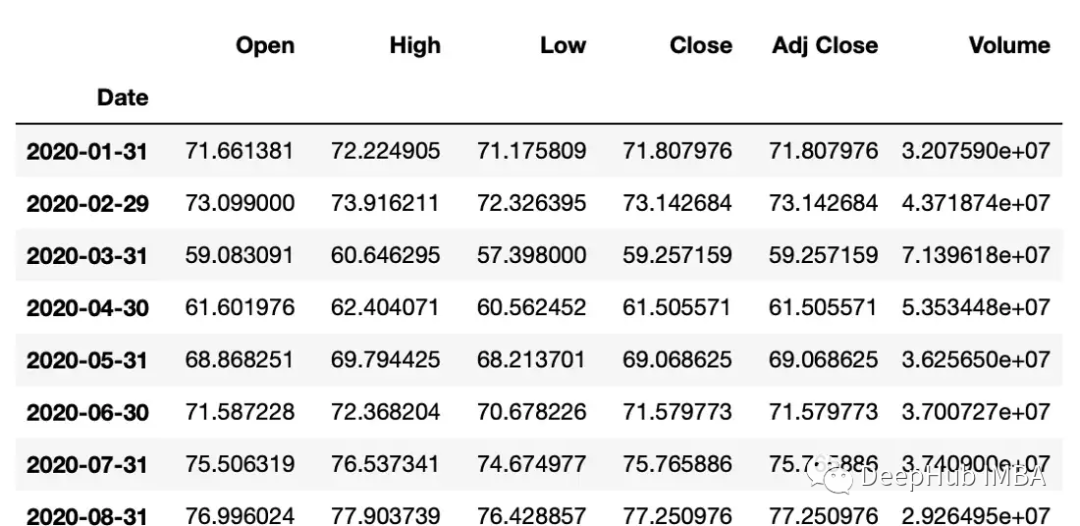
#up sample
minute_data = data.resample('T').ffill()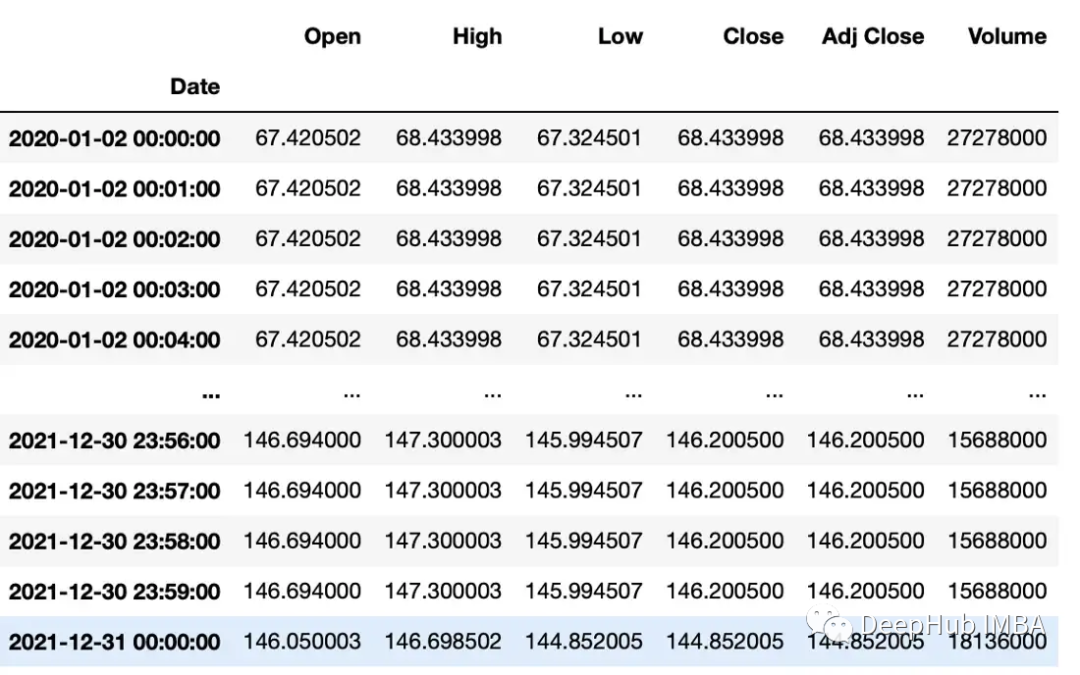
百分比变化
使用pct_change方法来计算日期之间的变化百分比。
df["PCT"] = df["Close"].pct_change(periods=2)
print(df["PCT"])
"""
Date
2020-01-02 NaN
2020-01-03 NaN
2020-01-06 0.021283
2020-01-07 0.024671
2020-01-08 0.005172
...
2022-12-19 -0.026634
2022-12-20 -0.013738
2022-12-21 0.012890
2022-12-22 -0.014154
2022-12-23 -0.003907
Name: PCT, Length: 752, dtype: float64
"""
总结
在Pandas和NumPy等库的帮助下,可以对时间序列数据执行广泛的操作,包括过滤、聚合和转换。本文介绍的是一些在工作中经常遇到的常见操作,希望对你有所帮助。


















Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Xcode 是苹果面向 Mac 提供的官方集成开发环境,将代码编辑、项目构建、SwiftUI 实时预览、设备模拟、自动化测试、断点调试、性能分析和应用分发整合在同一套工作流中,适合开发与维护 iPhone、iPad、Mac、Apple Wa

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

Visual Studio Code 是微软提供的免费代码编辑器,支持 macOS,并为 Intel 与 Apple 芯片 Mac 提供适配版本。软件集代码编辑、调试、Git 源代码管理、集成终端和扩展市场于一体。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Pro Tools 是 Avid 推出的专业数字音频工作站,覆盖多轨录音、无损剪辑、MIDI 编曲、插件处理、自动化混音及声音与画面同步等工作。它拥有 Intro、Artist、Studio 和 Ultimate 等方案。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

Visual Studio Code 是微软推出的免费代码编辑器,Windows 版集成智能补全、代码导航、调试、终端和版本控制,并可通过扩展添加语言、格式化及远程开发能力。它启动较快、配置灵活,

REAPER 是 Cockos 推出的数字音频工作站,适用于录音、MIDI 编曲、音频编辑、混音、母带制作及声音设计。软件安装包小巧,支持多轨录制、灵活路由、自动化、第三方插件和脚本扩展,并提供完整功能的 60 天免费评估期。

Adobe Audition 是面向播客、影视后期、广播与音乐制作的专业音频工作站,提供波形编辑、多轨混音、频谱分析、录音、降噪修复和效果处理等功能。Windows 版通过 Adobe Creative Cloud 安装和管理,

Pro Tools 是 Avid 推出的专业数字音频工作站,提供多轨录音、音频剪辑、MIDI编曲、插件处理、自动化混音及影视声音制作能力。它适合音乐人、录音师、制作人和音频后期团队使用,并提供免费入门版、订阅方案及永久授权选择。