


怎么使用Java爬取漫画
爬取结果程序运行效果获取的文件目录信息文件的总信息注:这里有一个小问题,获取的文件可能有的没有后缀名,但是可以以图片的方式打开观看,具体原因我也不知道,因为不影响,也就不去管它了。(或者自己使用代码,给文件重命名。)网站结构分析这里以一部漫画为例,首先看上面的编号,那个编号表示漫画的目录页。这是很重要的,在这一页有漫画的目录。然后依次点击目录中的章节,可以看到每一章的漫画信息。这里这个分页很奇怪,因为每一章节的页数不是一样的,但是它确实直接可以选择的,说明这个应该是提前加载或者异步加载的(我其实不会前端的
爬取结果
程序运行效果
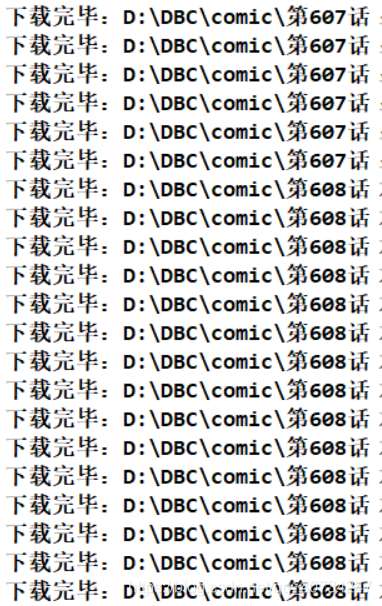
获取的文件目录信息
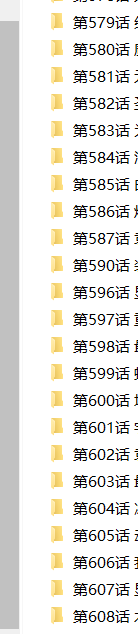
文件的总信息
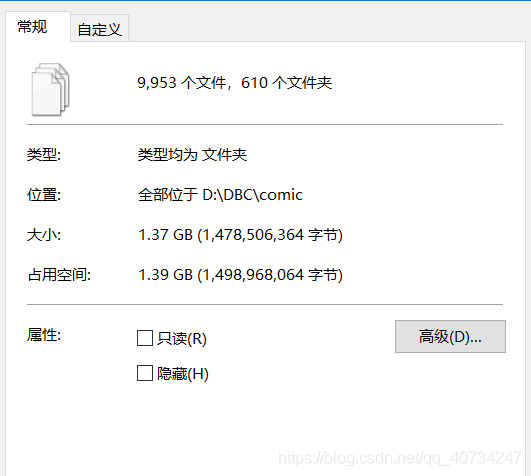
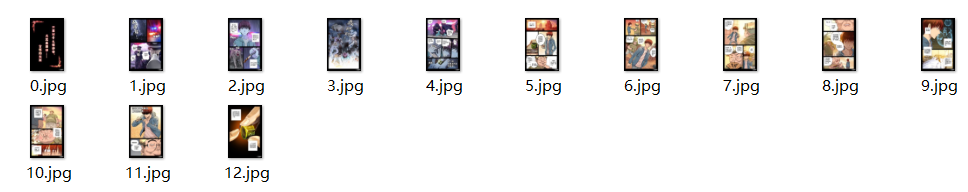
注: 这里有一个小问题,获取的文件可能有的没有后缀名,但是可以以图片的方式打开观看,具体原因我也不知道,因为不影响,也就不去管它了。(或者自己使用代码,给文件重命名。)
网站结构分析
这里以一部漫画为例,首先看上面的编号,那个编号表示漫画的目录页。这是很重要的,在这一页有漫画的目录。然后依次点击目录中的章节,可以看到每一章的漫画信息。
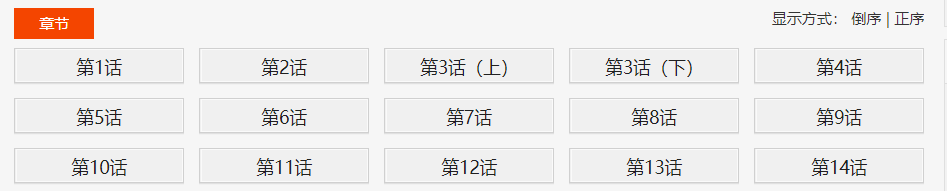

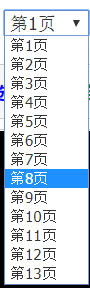
这里这个分页很奇怪,因为每一章节的页数不是一样的,但是它确实直接可以选择的,说明这个应该是提前加载或者异步加载的(我其实不会前端的知识,只是听说了一些。)后来通过查看源(我用眼睛发现的)发现确实是提前加载所有漫画页的链接。不是异步加载的。
这里我点击漫画图片获取图片的地址,然后再和自己发现的链接比对一下,就看出来了,然后拼接一下 url,就获取到所有的链接了。
在相应的章节页中,使用浏览器的查看源,就可以发现这样一段脚本了。经过分析,脚本中的数组里面的信息,就是对应的每一页漫画的信息。

上面的截图是一个大概的结构信息,所以获取流程是: 目录页–>章节页–>漫画页
对于这里,获取到这段脚本作为字符串,然后以 “[” 和 “]” 获取字串,然后使用 fastjson 将其转化为一个 List 集合。
// 获取的script 无法直接解析,必须先将 page url 取出来,
// 这里以 [ ] 为界限,分割字符串。
String pageUrls = script.data();
int start = pageUrls.indexOf("[");
int end = pageUrls.indexOf("]") + 1;
String urls = pageUrls.substring(start, end);
//json 转 集合,这个可以总结一下,不熟悉。
List urlList = JSONArray.parseArray(urls, String.class);
这里强调一点:Element对象的 text 方法是获取可见信息,而 data 方法是获取不可见信息。脚本信息是不可直接看见的,所以我使用 data 方法获取它。所谓可见和不可见大概就是网页上可以显示和通过查看源可以获取的信息的意思。比如转义字符,通过t ext 获取就变成转义的字符了。
代码部分
HttpClientUtil 类
使用HttpClient连接池来管理连接,但是我没有使用多线程,因为我只有一个ip地址,万一被封了,很麻烦。当线程的时间还是可以 接受的,毕竟一部漫画,大概也就是十来分钟吧。(以600话为例)
package com.comic;

import org.apache.http.client.config.RequestConfig;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.impl.client.HttpClients;
import org.apache.http.impl.conn.PoolingHttpClientConnectionManager;

public class HttpClientUtil {
	private static final int TIME_OUT = 10 * 1000;
	private static PoolingHttpClientConnectionManager pcm;   //HttpClient 连接池管理类
	private static RequestConfig requestConfig;

	static {
		requestConfig = RequestConfig.custom()
				.setConnectionRequestTimeout(TIME_OUT)
				.setConnectTimeout(TIME_OUT)
				.setSocketTimeout(TIME_OUT).build();

		pcm = new PoolingHttpClientConnectionManager();
		pcm.setMaxTotal(50);
		pcm.setDefaultMaxPerRoute(10);  //这里可能用不到这个东西。
	}

	public static CloseableHttpClient getHttpClient() {
		return HttpClients.custom()
				.setConnectionManager(pcm)
				.setDefaultRequestConfig(requestConfig)
				.build();
	}
}
ComicSpider 类
最重要的一个类,用来解析HTML页面获取链接数据。 注意:这里的 DIR_PATH 是硬编码路径,所以你想要测试,还请自己创建相关目录。
package com.comic;

import java.io.File;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.util.List;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.stream.Collectors;

import org.apache.http.HttpEntity;
import org.apache.http.client.ClientProtocolException;
import org.apache.http.client.config.CookieSpecs;
import org.apache.http.client.config.RequestConfig;
import org.apache.http.client.methods.CloseableHttpResponse;
import org.apache.http.client.methods.HttpGet;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.impl.client.HttpClients;
import org.apache.http.util.EntityUtils;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;

import com.alibaba.fastjson.JSONArray;

public class ComicSpider {
	private static final String DIR_PATH = "D:/DBC/comic/";
	private String url;
	private String root;
	private CloseableHttpClient httpClient;

	public ComicSpider(String url, String root) {
		this.url = url;
		// 这里不做非空校验,或者使用下面这个。
		// Objects.requireNonNull(root);
		if (root.charAt(root.length()-1) == '/') {
			root = root.substring(0, root.length()-1);
		}

		this.root = root;
		this.httpClient = HttpClients.createDefault();
	}

	public void start() {
		try {
			String html = this.getHtml(url);    //获取漫画主页数据
			List chapterList = this.mapChapters(html);  //解析数据,得到各话的地址
			this.download(chapterList);   //依次下载各话。
		} catch (IOException e) {
			e.printStackTrace();
		}
	}

	/**
	 * 从url中获取原始的网页数据
	 * @throws IOException
	 * @throws ClientProtocolException
	 * */
	private String getHtml(String url) throws ClientProtocolException, IOException {
		HttpGet get = new HttpGet(url);
		//下面这两句,是因为总是报一个 Invalid cookie header,然后我在网上找到的解决方法。(去掉的话,不影响使用)。
		RequestConfig defaultConfig = RequestConfig.custom().setCookieSpec(CookieSpecs.STANDARD).build();
		get.setConfig(defaultConfig);
		//因为是初学,而且我这里只是请求一次数据即可,这里就简单设置一下 UA
		get.setHeader("User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3100.0 Safari/537.36");
		HttpEntity entity = null;
		String html = null;
		try (CloseableHttpResponse response = httpClient.execute(get)) {
			int statusCode = response.getStatusLine().getStatusCode();
			if (statusCode == 200) {
				entity = response.getEntity();
				if (entity != null) {
					html = EntityUtils.toString(entity, "UTF-8");
				}
			}
		}
		return html;
	}


	//获取章节名 链接地址
	private List mapChapters(String html) {
		Document doc = Jsoup.parse(html, "UTF-8");
		Elements name_urls = doc.select("#chapter-list-1 > li > a");
		/* 不采用直接返回map的方式,封装一下。
		return name_urls.stream()
				.collect(Collectors.toMap(Element::text,
						name_url->root+name_url.attr("href")));
		 */
		return name_urls.stream()
				.map(name_url->new Chapter(name_url.text(),
						root+name_url.attr("href")))
				.collect(Collectors.toList());
	}

	/**
	 * 依次下载对应的章节
	 * 我使用当线程来下载,这种网站,多线程一般容易引起一些问题。
	 * 方法说明:
	 * 使用循环迭代的方法,以 name 创建文件夹,然后依次下载漫画。
	 * */
	public void download(List chapterList) {
		chapterList.forEach(chapter->{
			//按照章节创建文件夹,每一个章节一个文件夹存放。
			File dir = new File(DIR_PATH, chapter.getName());
			if (!dir.exists()) {
				if (!dir.mkdir()) {
					try {
						throw new FileNotFoundException("无法创建指定文件夹"+dir);
					} catch (FileNotFoundException e) {
						e.printStackTrace();
					}
				}

				//开始按照章节下载
				try {
					List urlList = this.getPageUrl(chapter);
					urlList.forEach(page->{
						SinglePictureDownloader downloader = new SinglePictureDownloader(page, dir.getAbsolutePath());
						downloader.download();
					});
				} catch (IOException e) {
					e.printStackTrace();
				}
			}
		});
	}

	//获取每一个页漫画的位置
	private List getPageUrl(Chapter chapter) throws IOException {
		String html = this.getHtml(chapter.getUrl());
		 Document doc = Jsoup.parse(html, "UTF-8");
		 Element script = doc.getElementsByTag("script").get(2); //获取第三个脚本的数据
		 // 获取的script 无法直接解析,必须先将 page url 取出来,
		 // 这里以 [ ] 为界限,分割字符串。
		 String pageUrls = script.data();
		 int start = pageUrls.indexOf("[");
		 int end = pageUrls.indexOf("]") + 1;
		 String urls = pageUrls.substring(start, end);
		 //json 转 集合,这个可以总结一下,不熟悉。
		 List urlList = JSONArray.parseArray(urls, String.class);

		 AtomicInteger index=new AtomicInteger(0);  //我无法使用索引,这是别人推荐的方式
		 return urlList.stream()   //注意这里拼接的不是 root 路径,而是一个新的路径
		 		.map(url->new ComicPage(index.getAndIncrement(),"https://restp.dongqiniqin.com//"+url))
		 		.collect(Collectors.toList());
	}
}
注意: 这里我的思路是,所有的漫画都存放到 DIR_PATH 目录中。 然后每一章节是一个子目录(以章节名来命名),然后每一个章节的漫画放到一个目录中,但是这里会遇到一个问题。因为实际上漫画是一页一页观看的,所以漫画就有一个顺序的问题(毕竟一堆乱序漫画,看起来也很费劲,虽然我这里不是为了看漫画)。所以我就给每一个漫画页一个编号,按照上面脚本上的顺序,进行编号。但是由于我使用了Java8的 Lambda 表达式,所以我无法使用索引。(这涉及到另一个问题了)。 这里的解决办法是我看别人推荐的: 每次调用 index的 getAndIncrement 方法就可以增加 index 的值,非常方便。
 AtomicInteger index=new AtomicInteger(0);  //我无法使用索引,这是别人推荐的方式
 return urlList.stream()   //注意这里拼接的不是 root 路径,而是一个新的路径
 		.map(url->new ComicPage(index.getAndIncrement(),"https://restp.dongqiniqin.com//"+url))
 		.collect(Collectors.toList());
Chapter 和 ComicPage 类
两个实体类,因为是面向对象嘛,我就设计了两个简单的实体类来封装一下信息,这样操作比较方便一点。
Chapter 类代表的是目录中的每一个章节的信息,章节的名字和章节的链接。 ComicPage 类代表的是每一个章节中的每一页漫画信息,每一页的编号和链接地址。
package com.comic;

public class Chapter {
	private String name;  //章节名
	private String url;   //对应章节的链接

	public Chapter(String name, String url) {
		this.name = name;
		this.url = url;
	}
	public String getName() {
		return name;
	}
	public String getUrl() {
		return url;
	}
	@Override
	public String toString() {
		return "Chapter [name=" + name + ", url=" + url + "]";
	}
}
package com.comic;
public class ComicPage {
private int number; //每一页的序号
private String url; //每一页的链接
public ComicPage(int number, String url) {
this.number = number;
this.url = url;
}
public int getNumber() {
return number;
}
public String getUrl() {
return url;
}
}SinglePictureDownloader 类
因为前几天使用多线程下载类爬取图片,发现速度太快了,ip 好像被封了,所以就又写了一个当线程的下载类。 它的逻辑很简单,主要是获取对应的漫画页链接,然后使用get请求,将它保存到对应的文件夹中。(它的功能大概和获取网络中的一张图片类似,既然你可以获取一张,那么成千上百也没有问题了。)
package com.comic;

import java.io.BufferedOutputStream;
import java.io.File;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.OutputStream;
import java.util.Random;

import org.apache.http.HttpEntity;
import org.apache.http.client.ClientProtocolException;
import org.apache.http.client.methods.CloseableHttpResponse;
import org.apache.http.client.methods.HttpGet;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.util.EntityUtils;

import com.m3u8.HttpClientUtil;

public class SinglePictureDownloader {
	private CloseableHttpClient httpClient;
	private ComicPage page;
	private String filePath;

	private String[] headers = {
			"Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.95 Safari/537.36",
		    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_2) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/35.0.1916.153 Safari/537.36",
		    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:30.0) Gecko/20100101 Firefox/30.0",
		    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_2) AppleWebKit/537.75.14 (KHTML, like Gecko) Version/7.0.3 Safari/537.75.14",
		    "Mozilla/5.0 (compatible; MSIE 10.0; Windows NT 6.2; Win64; x64; Trident/6.0)",
		    "Mozilla/5.0 (Windows; U; Windows NT 5.1; it; rv:1.8.1.11) Gecko/20071127 Firefox/2.0.0.11",
		    "Opera/9.25 (Windows NT 5.1; U; en)",
		    "Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 1.1.4322; .NET CLR 2.0.50727)",
		    "Mozilla/5.0 (compatible; Konqueror/3.5; Linux) KHTML/3.5.5 (like Gecko) (Kubuntu)",
		    "Mozilla/5.0 (X11; U; Linux i686; en-US; rv:1.8.0.12) Gecko/20070731 Ubuntu/dapper-security Firefox/1.5.0.12",
		    "Lynx/2.8.5rel.1 libwww-FM/2.14 SSL-MM/1.4.1 GNUTLS/1.2.9",
		    "Mozilla/5.0 (X11; Linux i686) AppleWebKit/535.7 (KHTML, like Gecko) Ubuntu/11.04 Chromium/16.0.912.77 Chrome/16.0.912.77 Safari/535.7",
		    "Mozilla/5.0 (X11; Ubuntu; Linux i686; rv:10.0) Gecko/20100101 Firefox/10.0 "
	};

	public SinglePictureDownloader(ComicPage page, String filePath) {
		this.httpClient = HttpClientUtil.getHttpClient();
		this.page = page;
		this.filePath = filePath;
	}

	public void download() {
		HttpGet get = new HttpGet(page.getUrl());
		String url = page.getUrl();
		//取文件的扩展名
		String prefix = url.substring(url.lastIndexOf("."));

		Random rand = new Random();
		//设置请求头
		get.setHeader("User-Agent", headers[rand.nextInt(headers.length)]);
		HttpEntity entity = null;
		try (CloseableHttpResponse response = httpClient.execute(get)) {
			int statusCode = response.getStatusLine().getStatusCode();
			if (statusCode == 200) {
				entity = response.getEntity();
				if (entity != null) {
					File picFile = new File(filePath, page.getNumber()+prefix);
					try (OutputStream out = new BufferedOutputStream(new FileOutputStream(picFile))) {
						entity.writeTo(out);
						System.out.println("下载完毕:" + picFile.getAbsolutePath());
					}
				}
			}
		} catch (ClientProtocolException e) {
			e.printStackTrace();
		} catch (IOException e) {
			e.printStackTrace();
		} finally {
			try {
				//关闭实体,关于 httpClient 的关闭资源,有点不太了解。
				EntityUtils.consume(entity);
			} catch (IOException e) {
				e.printStackTrace();
			}
		}
	}
}
Main 类
package com.comic;

public class Main {
	public static void main(String[] args) {
		String root = "https://www.manhuaniu.com/"; //网站根路径,用于拼接字符串
		String url = "https://www.manhuaniu.com/manhua/5830/";  //第一张第一页的url
		ComicSpider spider = new ComicSpider(url, root);
		spider.start();
	}
} 










火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。