


Java如何实现Unicode代理编程
顺序访问顺序访问是在Java语言中处理字符串的一个基本操作。在这种方法下,输入字符串中的每个字符从头至尾按顺序访问,或者有时从尾至头访问。本小节讨论使用顺序访问方法从一个字符串创建一个32位码位数组的7个技术示例,并估计它们的处理时间。示例1-1:基准测试(不支持代理对)清单1将16位char类型值直接分配给32位码位值,完全没有考虑代理对:清单1.不支持代理对int[]toCodePointArray(Stringstr){//Example1-1intlen=str.length();//thelen
顺序访问
顺序访问是在 Java 语言中处理字符串的一个基本操作。在这种方法下,输入字符串中的每个字符从头至尾按顺序访问,或者有时从尾至头访问。本小节讨论使用顺序访问方法从一个字符串创建一个 32 位码位数组的 7 个技术示例,并估计它们的处理时间。
示例 1-1:基准测试(不支持代理对)
清单 1 将 16 位 char 类型值直接分配给 32 位码位值,完全没有考虑代理对:
清单 1. 不支持代理对
int[] toCodePointArray(String str) { // Example 1-1 int len = str.length(); // the length of str int[] acp = new int[len]; // an array of code points for (int i = 0, j = 0; i < len; i++) { acp[j++] = str.charAt(i); } return acp; }尽管这个示例不支持代理对,但它提供了一个处理时间基准来比较后续顺序访问示例。
示例 1-2:使用 isSurrogatePair()
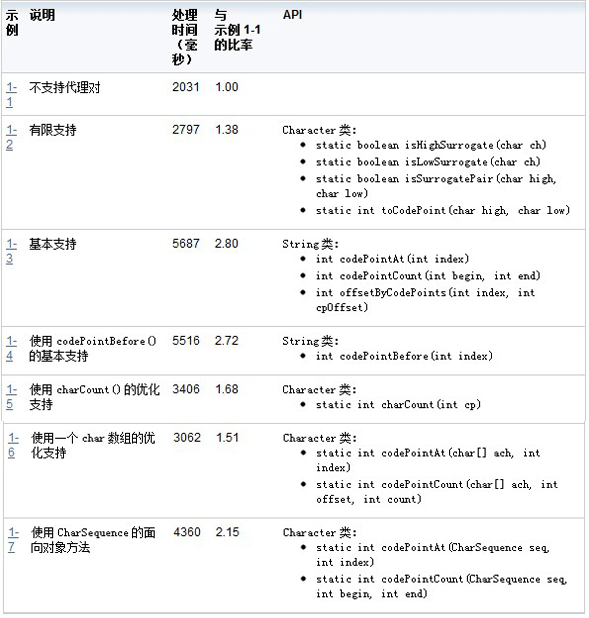
清单 2 使用 isSurrogatePair() 来计算代理对总数。计数之后,它分配足够的内存以便一个码位数组存储这个值。然后,它进入一个顺序访问循环,使用 isHighSurrogate() 和 isLowSurrogate() 确定每个代理对字符是高代理还是低代理。当它发现一个高代理后面带一个低代理时,它使用 toCodePoint() 将该代理对转换为一个码位值并将当前索引值增加 2。否则,它将这个 char 类型值直接分配给一个码位值并将当前索引值增加 1。这个示例的处理时间比 示例 1-1 长 1.38 倍。
清单 2. 有限支持
int[] toCodePointArray(String str) { // Example 1-2 int len = str.length(); // the length of str int[] acp; // an array of code points int surrogatePairCount = 0; // the count of surrogate pairs for (int i = 1; i < len; i++) { if (Character.isSurrogatePair(str.charAt(i - 1), str.charAt(i))) { surrogatePairCount++; i++; } } acp = new int[len - surrogatePairCount]; for (int i = 0, j = 0; i < len; i++) { char ch0 = str.charAt(i); // the current char if (Character.isHighSurrogate(ch0) && i + 1 < len) { char ch2 = str.charAt(i + 1); // the next char if (Character.isLowSurrogate(ch2)) { acp[j++] = Character.toCodePoint(ch0, ch2); i++; continue; } } acp[j++] = ch0; } return acp; }清单 2 中更新软件的方法很幼稚。它比较麻烦,需要大量修改,使得生成的软件很脆弱且今后难以更改。具体而言,这些问题是:
◆需要计算码位的数量以分配足够的内存
◆很难获得字符串中的指定索引的正确码位值
◆很难为下一个处理步骤正确移动当前索引
一个改进后的算法出现在下一个示例中。
示例:基本支持
Java 1.5 提供了 codePointCount()、codePointAt() 和 offsetByCodePoints() 方法来分别处理 示例 1-2 的 3 个问题。清单 3 使用这些方法来改善这个算法的可读性:
清单 3. 基本支持
int[] toCodePointArray(String str) { // Example 1-3 int len = str.length(); // the length of str int[] acp = new int[str.codePointCount(0, len)]; for (int i = 0, j = 0; i < len; i = str.offsetByCodePoints(i, 1)) { acp[j++] = str.codePointAt(i); } return acp; }但是,清单 3 的处理时间比 清单 1 长 2.8 倍。
示例 1-4:使用 codePointBefore()
当 offsetByCodePoints() 接收一个负数作为第二个参数时,它就能计算一个距离字符串头的绝对偏移值。接下来,codePointBefore() 能够返回一个指定索引前面的码位值。这些方法用于清单 4 中从尾至头遍历字符串:
清单 4. 使用 codePointBefore() 的基本支持
int[] toCodePointArray(String str) { // Example 1-4 int len = str.length(); // the length of str int[] acp = new int[str.codePointCount(0, len)]; int j = acp.length; // an index for acp for (int i = len; i > 0; i = str.offsetByCodePoints(i, -1)) { acp[--j] = str.codePointBefore(i); } return acp; }这个示例的处理时间 — 比 示例 1-1 长 2.72 倍 — 比 示例 1-3 快一些。通常,当您比较零而不是非零值时,JVM 中的代码大小要小一些,这有时会提高性能。但是,微小的改进可能不值得牺牲可读性。
示例 1-5:使用 charCount()
示例 1-3 和 1-4 提供基本的代理对支持。他们不需要任何临时变量,是健壮的编码方法。要获取更短的处理时间,使用 charCount() 而不是 offsetByCodePoints() 是有效的,但需要一个临时变量来存放码位值,如清单 5 所示:
清单 5. 使用 charCount() 的优化支持
int[] toCodePointArray(String str) { // Example 1-5 int len = str.length(); // the length of str int[] acp = new int[str.codePointCount(0, len)]; int j = 0; // an index for acp for (int i = 0, cp; i < len; i += Character.charCount(cp)) { cp = str.codePointAt(i); acp[j++] = cp; } return acp; }清单 5 的处理时间降低到比 示例 1-1 长 1.68 倍。
示例 1-6:访问一个 char 数组
清单 6 在使用 示例 1-5 中展示的优化的同时直接访问一个 char 类型数组:
清单 6. 使用一个 char 数组的优化支持
int[] toCodePointArray(String str) { // Example 1-6 char[] ach = str.toCharArray(); // a char array copied from str int len = ach.length; // the length of ach int[] acp = new int[Character.codePointCount(ach, 0, len)]; int j = 0; // an index for acp for (int i = 0, cp; i < len; i += Character.charCount(cp)) { cp = Character.codePointAt(ach, i); acp[j++] = cp; } return acp; }char 数组是使用 toCharArray() 从字符串复制而来的。性能得到改善,因为对数组的直接访问比通过一个方法的间接访问要快。处理时间比 示例 1-1 长 1.51 倍。但是,当调用时,toCharArray() 需要一些开销来创建一个新数组并将数据复制到数组中。String 类提供的那些方便的方法也不能被使用。但是,这个算法在处理大量数据时有用。
示例 1-7:一个面向对象的算法
这个示例的面向对象算法使用 CharBuffer 类,如清单 7 所示:
清单 7. 使用 CharSequence 的面向对象算法
int[] toCodePointArray(String str) { // Example 1-7 CharBuffer cBuf = CharBuffer.wrap(str); // Buffer to wrap str IntBuffer iBuf = IntBuffer.allocate( // Buffer to store code points Character.codePointCount(cBuf, 0, cBuf.capacity())); while (cBuf.remaining() > 0) { int cp = Character.codePointAt(cBuf, 0); // the current code point iBuf.put(cp); cBuf.position(cBuf.position() + Character.charCount(cp)); } return iBuf.array(); }与前面的示例不同,清单 7 不需要一个索引来持有当前位置以便进行顺序访问。相反,CharBuffer 在内部跟踪当前位置。Character 类提供静态方法 codePointCount() 和 codePointAt(),它们能通过 CharSequence 接口处理 CharBuffer。CharBuffer 总是将当前位置设置为 CharSequence 的头。因此,当 codePointAt() 被调用时,第二个参数总是设置为 0。处理时间比 示例 1-1 长 2.15 倍。
处理时间比较
这些顺序访问示例的计时测试使用了一个包含 10,000 个代理对和 10,000 个非代理对的样例字符串。码位数组从这个字符串创建 10,000 次。测试环境包括:
◆OS:Microsoft Windows® XP Professional SP2
◆Java:IBM Java 1.5 SR7
◆CPU:Intel® Core 2 Duo CPU T8300 @ 2.40GHz
◆Memory:2.97GB RAM
表 1 展示了示例 1-1 到 1-7 的绝对和相对处理时间以及关联的 API:
表 1. 顺序访问示例的处理时间和 API
随机访问
随机访问是直接访问一个字符串中的任意位置。当字符串被访问时,索引值基于 16 位 char 类型的单位。但是,如果一个字符串使用 32 位码位,那么它不能使用一个基于 32 位码位的单位的索引访问。必须使用 offsetByCodePoints() 来将码位的索引转换为 char 类型的索引。如果算法设计很糟糕,这会导致很差的性能,因为 offsetByCodePoints() 总是通过使用第二个参数从第一个参数计算字符串的内部。在这个小节中,我将比较三个示例,它们通过使用一个短单位来分割一个长字符串。
示例 2-1:基准测试(不支持代理对)
清单 8 展示如何使用一个宽度单位来分割一个字符串。这个基准测试留作后用,不支持代理对。
清单 8. 不支持代理对
String[] sliceString(String str, int width) { // Example 2-1 // It must be that "str != null && width > 0". List slices = new ArrayList(); int len = str.length(); // (1) the length of str int sliceLimit = len - width; // (2) Do not slice beyond here. int pos = 0; // the current position per char type while (pos < sliceLimit) { int begin = pos; // (3) int end = pos + width; // (4) slices.add(str.substring(begin, end)); pos += width; // (5) } slices.add(str.substring(pos)); // (6) return slices.toArray(new String[slices.size()]); } sliceLimit 变量对分割位置有所限制,以避免在剩余的字符串不足以分割当前宽度单位时抛出一个 IndexOutOfBoundsException 实例。这种算法在当前位置超出 sliceLimit 时从 while 循环中跳出后再处理最后的分割。
示例 2-2:使用一个码位索引
清单 9 展示了如何使用一个码位索引来随机访问一个字符串:
清单 9. 糟糕的性能
String[] sliceString(String str, int width) { // Example 2-2 // It must be that "str != null && width > 0". List slices = new ArrayList(); int len = str.codePointCount(0, str.length()); // (1) code point count [Modified] int sliceLimit = len - width; // (2) Do not slice beyond here. int pos = 0; // the current position per code point while (pos < sliceLimit) { int begin = str.offsetByCodePoints(0, pos); // (3) [Modified] int end = str.offsetByCodePoints(0, pos + width); // (4) [Modified] slices.add(str.substring(begin, end)); pos += width; // (5) } slices.add(str.substring(str.offsetByCodePoints(0, pos))); // (6) [Modified] return slices.toArray(new String[slices.size()]); } 清单 9 修改了 清单 8 中的几行。首先,在 Line (1) 中,length() 被 codePointCount() 替代。其次,在 Lines (3)、(4) 和 (6) 中,char 类型的索引通过 offsetByCodePoints() 用码位索引替代。
基本的算法流与 示例 2-1 中的看起来几乎一样。但处理时间根据字符串长度与示例 2-1 的比率同比增加,因为 offsetByCodePoints() 总是从字符串头到指定索引计算字符串内部。
示例 2-3:减少的处理时间
可以使用清单 10 中展示的方法来避免 示例 2-2 的性能问题:
清单 10. 改进的性能
String[] sliceString(String str, int width) { // Example 2-3 // It must be that "str != null && width > 0". List slices = new ArrayList(); int len = str.length(); // (1) the length of str int sliceLimit // (2) Do not slice beyond here. [Modified] = (len >= width * 2 || str.codePointCount(0, len) > width) ? str.offsetByCodePoints(len, -width) : 0; int pos = 0; // the current position per char type while (pos < sliceLimit) { int begin = pos; // (3) int end = str.offsetByCodePoints(pos, width); // (4) [Modified] slices.add(str.substring(begin, end)); pos = end; // (5) [Modified] } slices.add(str.substring(pos)); // (6) return slices.toArray(new String[slices.size()]); } 首先,在 Line (2) 中,(清单 9 中的)表达式 len-width 被 offsetByCodePoints(len,-width) 替代。但是,当 width 的值大于码位的数量时,这会抛出一个 IndexOutOfBoundsException 实例。必须考虑边界条件以避免异常,使用一个带有 try/catch 异常处理程序的子句将是另一个解决方案。如果表达式 len>width*2 为 true,则可以安全地调用 offsetByCodePoints(),因为即使所有码位都被转换为代理对,码位的数量仍会超过 width 的值。或者,如果 codePointCount(0,len)>width 为 true,也可以安全地调用 offsetByCodePoints()。如果是其他情况,sliceLimit 必须设置为 0。
在 Line (4) 中,清单 9 中的表达式 pos + width 必须在 while 循环中使用 offsetByCodePoints(pos,width) 替换。需要计算的量位于 width 的值中,因为第一个参数指定当 width 的值。接下来,在 Line (5) 中,表达式 pos+=width 必须使用表达式 pos=end 替换。这避免两次调用 offsetByCodePoints() 来计算相同的索引。源代码可以被进一步修改以最小化处理时间。
处理时间比较
图 1 和图 2 展示了示例 2-1、2-2 和 2-3 的处理时间。样例字符串包含相同数量的代理对和非代理对。当字符串的长度和 width 的值被更改时,样例字符串被切割 10,000 次。
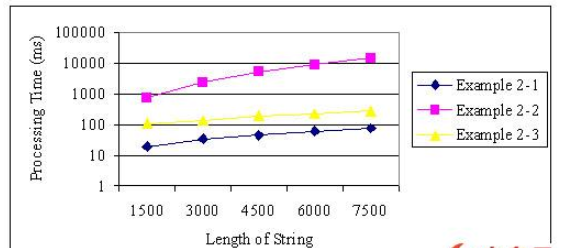
图 1. 一个分段的常量宽度
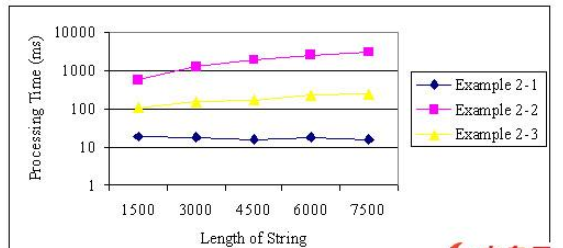
图 2. 分段的常量计数
示例 2-1 和 2-3 按照长度比例增加了它们的处理时间,但 示例 2-2 按照长度的平方比例增加了处理时间。当字符串长度和 width 的值增加而分段的数量固定时,示例 2-1 拥有一个常量处理时间,而示例 2-2 和 2-3 以 width 的值为比例增加了它们的处理时间。
信息 API
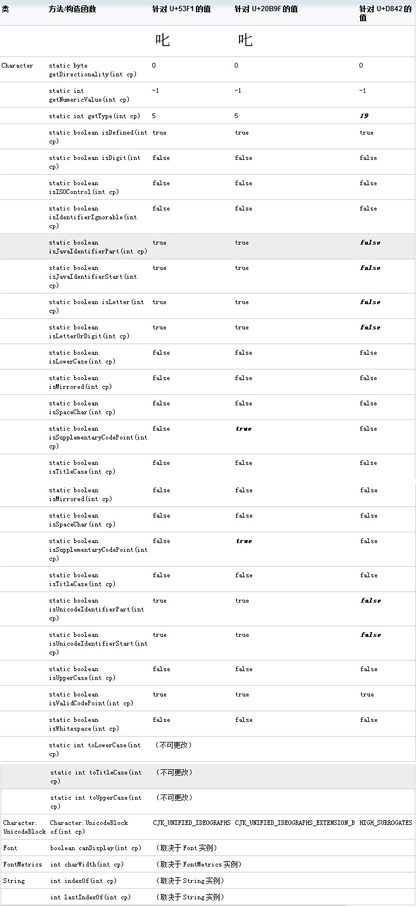
大多数处理代理的信息 API 拥有两种名称相同的方法。一种接收 16 位 char 类型参数,另一种接收 32 为码位参数。表 2 展示了每个 API 的返回值。第三列针对 U+53F1,第 4 列针对 U+20B9F,最后一列针对 U+D842(即高代理),而 U+20B9F 被转换为 U+D842 加上 U+DF9F 的代理对。如果程序不能处理代理对,则值 U+D842 而不是 U+20B9F 将导致意想不到的结果(在表 2 中以粗斜体表示)。
表 2. 用于代理的信息 API
其他 API
本小节介绍前面的小节中没有讨论的代理对相关 API。表 3 展示所有这些剩余的 API。所有代理对 API 都包含在表 1、2 和 3 中。
表 3. 其他代理 API
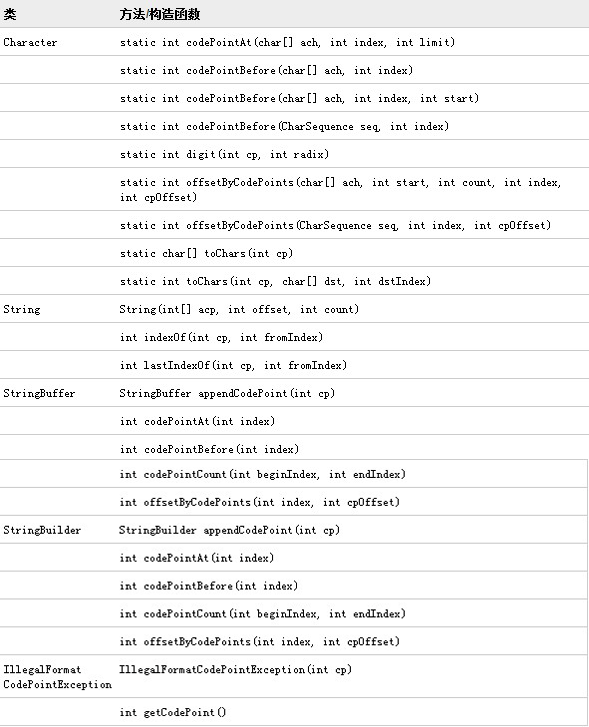
清单 11 展示了从一个码位创建一个字符串的 5 种方法。用于测试的码位是 U+53F1 和 U+20B9F,它们在一个字符串中重复了 100 亿次。清单 11 中的注释部分显示了处理时间:
清单 11. 从一个码位创建一个字符串的 5 种方法
int cp = 0x20b9f; // CJK Ideograph Extension B String str1 = new String(new int[]{cp}, 0, 1); // processing time: 206ms String str2 = new String(Character.toChars(cp)); // 187ms String str3 = String.valueOf(Character.toChars(cp)); // 195ms String str4 = new StringBuilder().appendCodePoint(cp).toString(); // 269ms String str5 = String.format("%c", cp); // 3781msstr1、str2、str3 和 str4 的处理时间没有明显不同。相反,创建 str5 花费的时间要长得多,因为它使用 String.format(),该方法支持基于本地和格式化信息的灵活输出。str5 方法应该只用于程序的末尾来输出文本。


















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。