


node.js怎么操作数据库
系统介绍Node.js操作数据库的核心机制与实现方法,涵盖原生数据库驱动与ORM工具选型、连接池配置、参数化CRUD、事务处理及生产安全规范。
在 Node.js 中操作数据库,本质上是通过运行环境提供的异步网络 I/O 能力,利用特定数据库的协议驱动与数据库服务器建立 TCP 套接字连接,随后将组装好的查询命令发送给服务端执行,并在事件循环中接收、解析异步返回的数据包。开发者根据实际项目对开发效率与性能控制的需求,通常有两条成熟路径:直接使用面向特定数据库的底层原生驱动(如 MySQL 的 mysql2、PostgreSQL 的 pg),或者使用高度封装的对象关系映射(ORM / 查询构建器)工具(如 Prisma、TypeORM、Drizzle)。本文将完整梳理连接机制、核心 CRUD 编码、安全防护与技术选型。
一、Node.js 操作数据库的底层运行机制
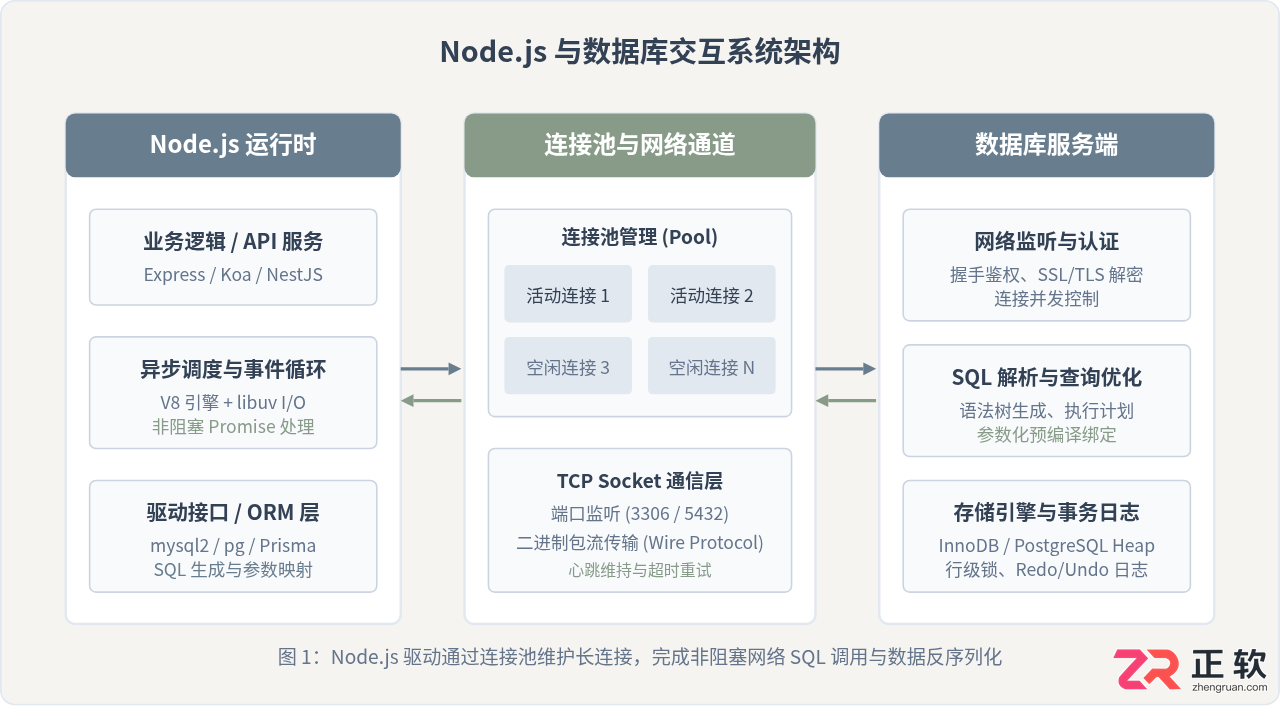
Node.js 本身并不内置具体数据库的客户端接口,所有数据库交互均依赖用户态安装的第三方模块。无论使用哪种数据库或库工具,其底层都遵循统一的异步交互模型:Node.js 应用线程发起调用后,底层的 libuv 处理非阻塞网络读写,当数据库完成运算并将结果通过网络包回传时,驱动程序解析二进制协议并触发 JavaScript 层的 Promise 决议(resolve)。
在面对 Web 接口等并发请求场景时,单次连接(Single Connection)无法承载并发查询,必须引入连接池(Connection Pool)。连接池会在内存中维护一定数量处于活跃或空闲状态的物理连接,当应用收到请求时借用连接,查询完成后立即归还,从而避免了频繁执行 TCP 三次握手和数据库身份鉴权带来的高昂开销。
二、关键方案对照:原生驱动 vs 现代 ORM
在开展代码编写前,开发者需要明确技术路线。Node.js 生态中主要存在两类主流方案,它们在控制力度、执行效率与开发维护成本上各有侧重:
| 对比维度 | 原生数据库驱动 (如 mysql2 / pg) | 现代 ORM / 查询构建器 (如 Prisma / TypeORM) |
|---|---|---|
| 核心编码方式 | 直接手写 SQL 字符串,传递参数数组 | 调用高阶 JavaScript/TypeScript API 方法 |
| 性能损耗 | 极低,仅包含协议编解码与对象映射开销 | 稍有开销,包含 AST 解析、SQL 翻译与实体实例化 |
| 类型安全支持 | 需手动定义 TypeScript 类型,容易与数据库字段脱节 | 自动根据数据表模型生成强类型定义,编译期检查错误 |
| 复杂查询灵活度 | 极高,支持复杂子查询、窗口函数、专有语法 | 中等,非常规语法受限于 ORM 表达式,常需回退到原生查询 |
| 数据表迁移维护 | 需手动编写 DDL 脚本或引入额外迁移工具 | 内置强大的 Migration 迁移系统,版本追踪自动透明 |
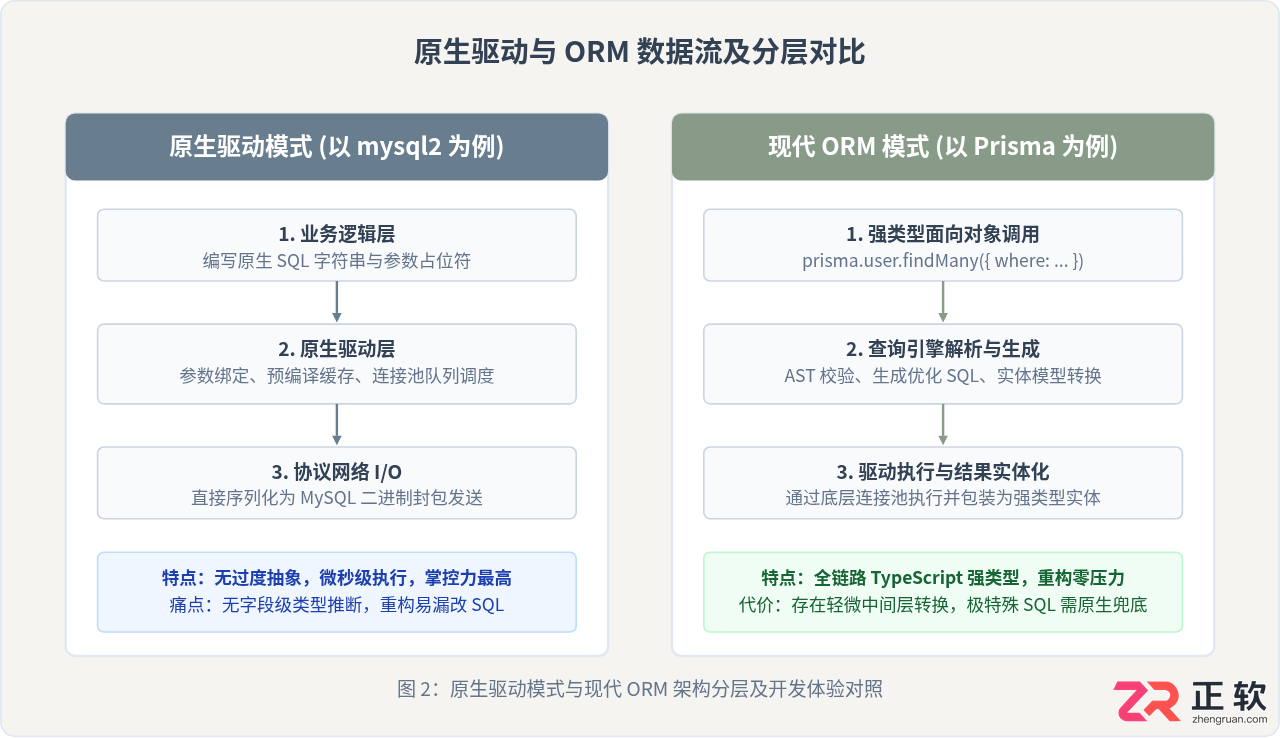
关键差异的实际影响:原生驱动更贴近硬件与网络本质,在每秒需要处理数万次简单查询的超高并发系统或报表复杂查询中具有优势;而 ORM 工具则通过牺牲微秒级的转换耗时,彻底消除了拼写错误带来的运行时异常,极大提升了团队协作和业务迭代效率。
三、使用原生驱动操作数据库完整步骤(以 MySQL 为例)
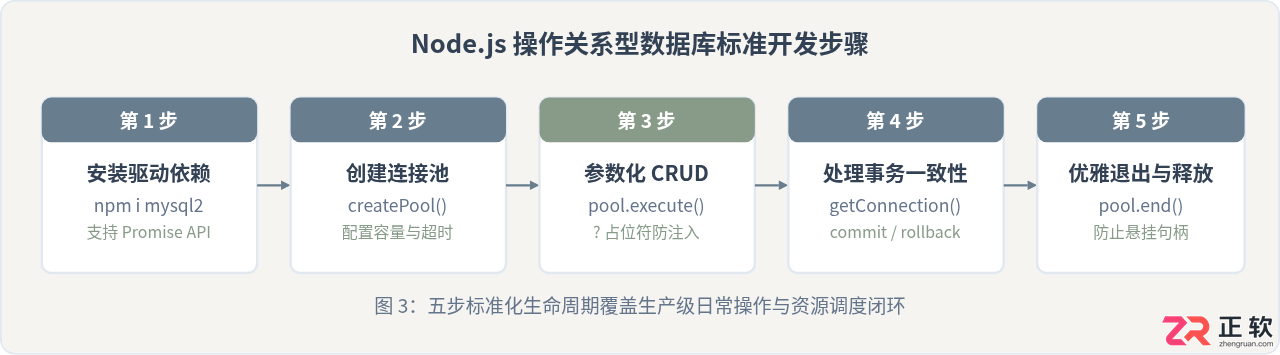
在 Node.js 中操作关系型数据库,标准流程包括五大核心环节:依赖管理、连接池初始化、参数化 CRUD 操作、事务一致性控制,以及优雅停机处理。
步骤一:安装驱动模块
在项目根目录运行以下命令安装 mysql2。相比老旧的 mysql 驱动,mysql2 原生支持 Promise,并对预编译查询(Prepared Statements)提供了底层优化:
npm install mysql2 dotenv步骤二:建立模块化连接池模块 (db.js)
新建 db.js 文件。请勿在每次处理请求时使用 createConnection,必须创建全局单例连接池:
// db.js
const mysql = require('mysql2/promise');
require('dotenv').config();

// 创建连接池
const pool = mysql.createPool({
  host: process.env.DB_HOST || '127.0.0.1',
  port: Number(process.env.DB_PORT) || 3306,
  user: process.env.DB_USER || 'root',
  password: process.env.DB_PASSWORD || '',
  database: process.env.DB_NAME || 'test_db',
  waitForConnections: true,
  connectionLimit: 10,       // 连接池最大连接数
  queueLimit: 0,             // 排队请求上限,0 表示不设上限
  enableKeepAlive: true,     // 启用 TCP 保活
  keepAliveInitialDelay: 0
});

module.exports = pool;
步骤三:执行增删改查(参数化查询防御 SQL 注入)
在执行任何包含外部变量的 SQL 时,必须使用 ? 占位符并通过参数数组传参,底层驱动会自动将 SQL 模版与数据隔离发送,从根源上杜绝 SQL 注入攻击:
// app.js
const pool = require('./db');

async function runDatabaseOperations() {
  try {
    // 1. 创建示例表
    await pool.execute(`
      CREATE TABLE IF NOT EXISTS users (
        id INT AUTO_INCREMENT PRIMARY KEY,
        username VARCHAR(50) NOT NULL UNIQUE,
        email VARCHAR(100) NOT NULL,
        created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
      ) ENGINE=InnoDB;
    `);
    console.log('数据表就绪');

    // 2. 插入数据 (Create)
    const [insertResult] = await pool.execute(
      'INSERT INTO users (username, email) VALUES (?, ?)',
      ['zhangsan', 'zhangsan@example.com']
    );
    console.log('插入成功,自增 ID:', insertResult.insertId);

    // 3. 查询单条与多条数据 (Read)
    const [rows] = await pool.execute(
      'SELECT id, username, email, created_at FROM users WHERE username = ?',
      ['zhangsan']
    );
    console.log('查询结果:', rows[0]);

    // 4. 更新数据 (Update)
    const [updateResult] = await pool.execute(
      'UPDATE users SET email = ? WHERE id = ?',
      ['new_email@example.com', insertResult.insertId]
    );
    console.log('影响行数:', updateResult.affectedRows);

    // 5. 删除数据 (Delete)
    const [deleteResult] = await pool.execute(
      'DELETE FROM users WHERE id = ?',
      [insertResult.insertId]
    );
    console.log('删除完成,受影响行数:', deleteResult.affectedRows);

  } catch (error) {
    console.error('数据库操作失败:', error.message);
  } finally {
    // 6. 关闭连接池(通常在进程退出时调用)
    await pool.end();
  }
}

runDatabaseOperations();
步骤四:保证多步操作的事务一致性(Transaction)
当执行银行转账或批量更新等多个关联操作时,必须通过事务保证 ACID 特性。此时需要从连接池中手动取出一个独立连接(Connection),在操作结束后务必调用 connection.release() 归还连接:
async function transferBalance(fromUserId, toUserId, amount) {
  // 从池中显式获取一个专属连接
  const connection = await pool.getConnection();
  try {
    // 开启事务
    await connection.beginTransaction();

    // 扣减付款方余额
    await connection.execute(
      'UPDATE accounts SET balance = balance - ? WHERE user_id = ? AND balance >= ?',
      [amount, fromUserId, amount]
    );

    // 增加收款方余额
    await connection.execute(
      'UPDATE accounts SET balance = balance + ? WHERE user_id = ?',
      [amount, toUserId]
    );

    // 提交事务
    await connection.commit();
    console.log('转账成功');
  } catch (err) {
    // 发生任何异常立即回滚
    await connection.rollback();
    console.error('转账失败,事务已回滚:', err.message);
    throw err;
  } finally {
    // 无论成功还是失败,必须释放连接回池!
    connection.release();
  }
}当通过 pool.getConnection() 手动借出连接时,若缺少 finally { connection.release(); } 保护,一旦代码抛出异常,该连接将永远无法被回收。当未释放的连接累积达到 connectionLimit 上限后,整个 Node.js 服务的所有数据库请求都将陷入永久挂起(Hang)。
四、使用现代 ORM(Prisma)提升工程化与类型安全
在面向中大型项目或 TypeScript 工程时,编写大量无类型约束的原生 SQL 字符串往往会随着需求变更带来高维护成本。Prisma 是当前 Node.js 社区广受推崇的现代 ORM 工具,其核心工作流如下:
1. 安装与初始化 Prisma
npm install @prisma/client
npm install prisma --save-dev
npx prisma init
2. 定义数据模型 (prisma/schema.prisma)
datasource db {
  provider = "mysql"
  url      = env("DATABASE_URL")
}

generator client {
  provider = "prisma-client-js"
}

model User {
  id        Int      @id @default(autoincrement())
  email     String   @unique
  name      String?
  posts     Post[]
  createdAt DateTime @default(now())
}

model Post {
  id        Int      @id @default(autoincrement())
  title     String
  content   String?
  published Boolean  @default(false)
  authorId  Int
  author    User     @relation(fields: [authorId], references: [id])
}
3. 迁移并生成客户端代码
# 自动执行 DDL 迁移并生成数据表
npx prisma migrate dev --name init
4. 在代码中进行面向对象的数据操作
// prisma-demo.js
const { PrismaClient } = require('@prisma/client');
const prisma = new PrismaClient();

async function main() {
  // 创建带有嵌套关联的新记录
  const newUser = await prisma.user.create({
    data: {
      name: 'Li Si',
      email: 'lisi@example.com',
      posts: {
        create: [
          { title: '深入理解 Node.js 异步模型' },
          { title: 'Prisma 生产环境配置指南' }
        ]
      }
    },
    include: { posts: true } // 一同查询关联数据
  });
  console.log('创建用户与文章成功:', newUser);

  // 条件筛选与分页查询
  const users = await prisma.user.findMany({
    where: { email: { endsWith: '@example.com' } },
    orderBy: { createdAt: 'desc' },
    take: 10
  });
  console.log('匹配用户数量:', users.length);
}

main()
  .catch((e) => console.error(e))
  .finally(async () => {
    await prisma.$disconnect();
  });
五、生产环境核心避坑指南与选型决策
无论是直接运行 SQL 还是使用 ORM 封装,在实际将 Node.js 接入数据库并部署到生产环境时,均需严格遵守以下三项铁律:
- 严禁字符串拼接构造 SQL:绝对不要使用模板字符串
`SELECT * FROM users WHERE id = ${req.query.id}`。这是导致 Web 应用遭遇 SQL 注入破坏的头号原因。务必使用参数化绑定execute('SELECT * FROM ... WHERE id = ?', [id])。 - 科学评估连接池大小:连接池容量绝非越大越好。在单核或 2 核的云数据库实例上,每个连接均占用独享的内存缓冲区并参与 CPU 时间片上下文切换。通常每个 Node.js 实例的连接数设置为
5 ~ 20即可满足高吞吐需求;如有多实例集群部署(如 PM2 或 K8s),应确保实例数 × 每个连接池容量 < 数据库最大允许连接数 (max_connections)。 - 配置合理的网络与查询超时:Node.js 与数据库跨云网络时,偶发抖动会导致连接挂起。必须在连接配置中设置
connectTimeout与timeout,避免单个慢查询或网络死锁拖垮整个服务进程。
总结
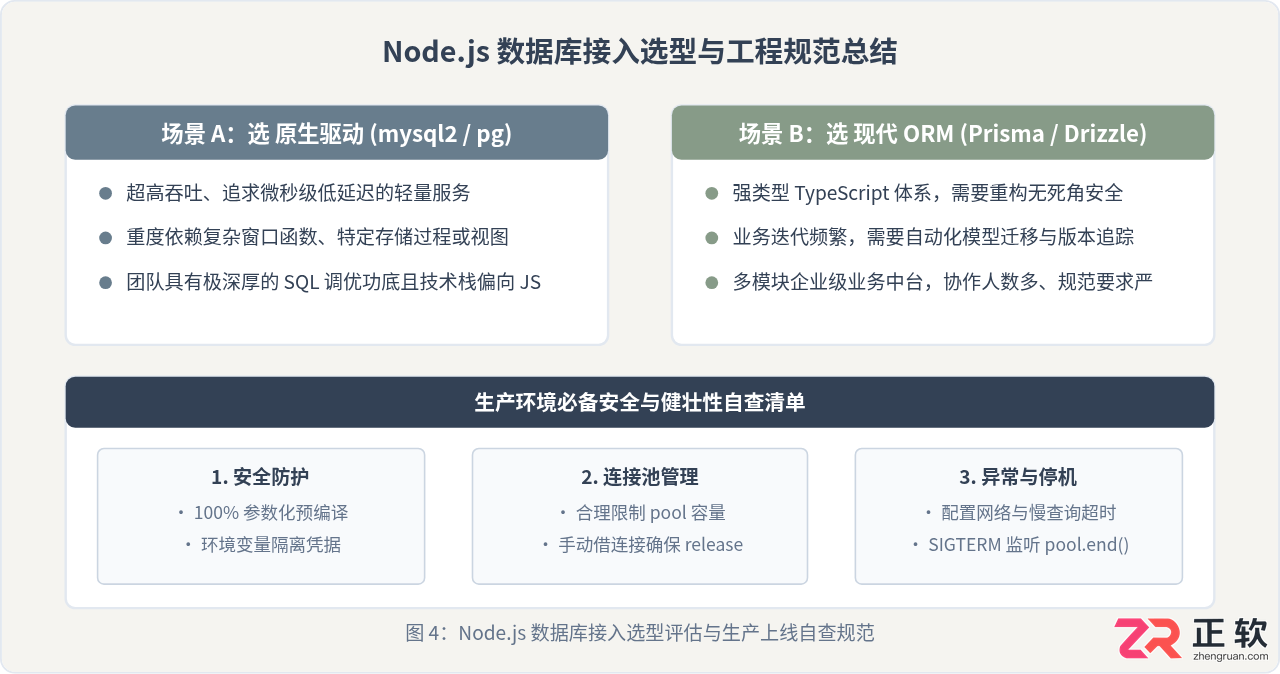
掌握 Node.js 操作数据库的核心在于理顺“事件循环驱动的非阻塞通信”与“池化连接调度”的配合机制。对于轻量脚本或极高并发场景,使用 mysql2 等原生驱动结合参数化 SQL 能带来最直接的掌控力与性能;而对于快速演进的企业级应用,以 Prisma 为代表的现代 ORM 则能显著降低重构隐患与心智负担。无论采取何种方案,建立科学的连接池配置、严格实施防注入参数绑定、完善事务回滚与优雅退出机制,都是保障后端系统持久稳定运行的基石。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。