


客製化AI晶片领军 联发科陈冠州:投资翻倍将创10亿美元营收
联发科2025年营收创历史新高,2026年AI客制化晶片投入将翻倍,目标10亿美元营收。因制程红利放缓,产业转向系统级设计,ASIC成为数据中心算力增长的核心载体,通过端到端架构优化实现效能提升。
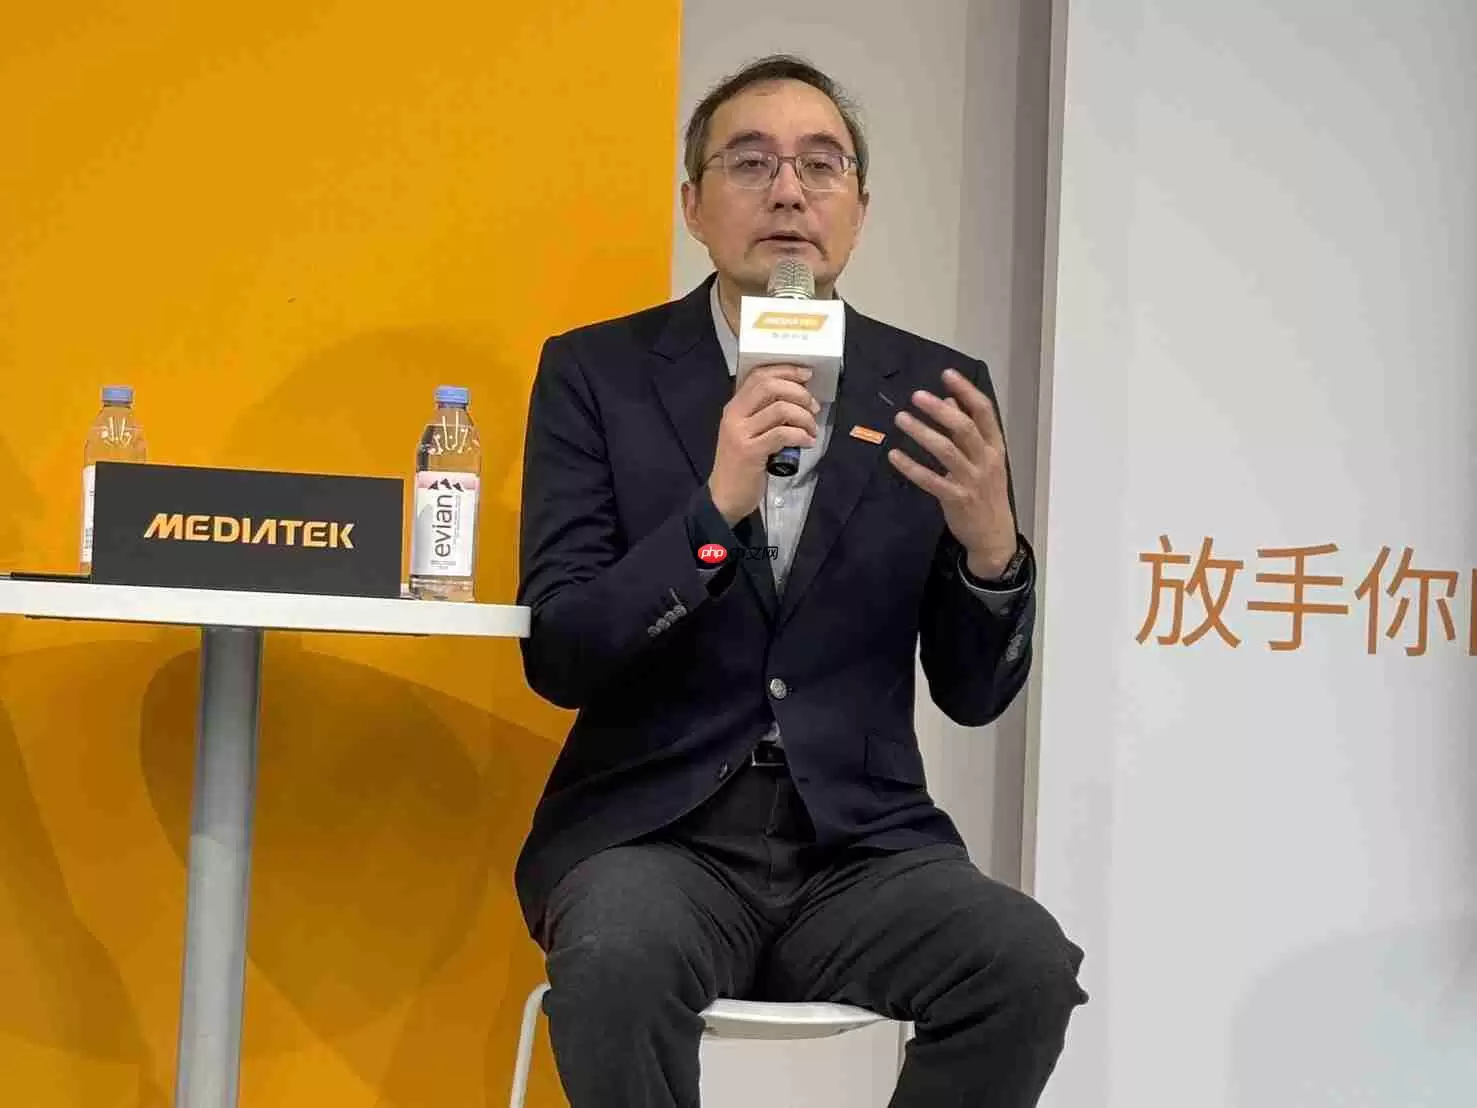 AI运算模型在训练与推理环节的需求差异,正在越拉越大。传统通用型晶片已经很难在效能、功耗和成本之间找到那个最优平衡点。陈冠州点出了一个关键趋势:制程微缩带来的红利正在放缓,单靠提升晶体管密度来撬动效能增长,这条路越走越窄。产业正加速转向以Chiplet架构、先进封装和高速互连技术为核心的系统级设计路径。说得直白一点,就是让晶片能根据实际应用场景进行模组化组合和深度客制化。这个演进,让ASIC重新站到了AI时代半导体价值链的枢纽位置。
与此同时,AI算力需求的爆发式增长,正在显著拓宽半导体产业的成长空间。云端服务提供商持续加码AI基础设施建设,动辄百亿级的资本支出中,相当大一部分直接流向了先进晶片研发和异构系统架构创新。这些需求不光盯着峰值性能,更看重能效比、数据吞吐效率以及整体拥有成本(TCO)。换句话说,谁能帮客户在同样功耗和物理空间里塞进更多算力,谁就能吃到这波红利。
陈冠州对此的解读是:针对特定工作负载量身打造的ASIC,能协助云端服务商在同等功耗与空间约束下,实现更高的运算密度和更稳定的长期效能输出,同时有效压降运维阶段的总体成本。正因如此,数据中心客制化晶片已被联发科定位为驱动AI时代营收增长的重要引擎,没有之一。
再看产业链的另一端:AI算力的扩张,加剧了先进制程与先进封装产能的结构性紧张。供需错配不仅推高制造成本,更倒逼芯片设计企业必须把资源投得更准、看得更远。在这个背景下,客制化晶片的战略价值进一步凸显——它不再只是“定制版通用芯片”,而是系统级优化的核心载体。
那么联发科具体怎么做?陈冠州给出的思路是:不只盯着单一计算单元优化,而是以端到端系统架构思维切入,全面覆盖算力生成、数据传输与存储协同三大维度。
算力层面,结合前沿制程节点与2.5D、3.5D等先进封装技术,持续提升单位面积下的有效运算能力;互连层面,长期深耕高速接口技术,并且积极推动从电信号向光信号传输演进——因为算力再强,数据送不到处理单元也是白搭;存储层面,则聚焦高频宽、低功耗且支持按系统规格灵活配置的记忆体架构设计,确保整机系统效率最大化。
在产能合作上,陈冠州透露,联发科与台积电保持着紧密的战略协同。无论是两纳米制程还是S14先进节点,联发科都位列首批导入客户行列,相关产品今年就会正式面世。互连带宽方面,后续将推进铜线传输向3.2T硅光子引擎过渡,同时开发更低功耗的定制化HBM方案。整体来看,联发科对AI ASIC领域年度资源投入实现翻倍增长,已经不是喊口号,而是实打实的战略落地。










赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
