


佐治亚理工学院徐丹飞:别被「视觉生成」骗了,视频预测≠机器人规划|RSS 2026
以Sora为代表的高保真视频生成技术能预测完美未来画面,但无法替代真实物理规划。佐治亚理工学院徐丹飞指出视频预测与机器人控制存在“视频-动作跨越断层”,提出组合式世界模型,利用因子图动态拼装基础技能,引入时间注意力比例指标,提升机器人执行复杂长流程任务成功率。
具身智能和世界模型这两个方向,眼下正处在一个相当尴尬的位置上。
以 Sora 为首的高保真视频生成技术,已经能做到让机器人“脑补”出极其逼真的未来画面,感觉 AGI 马上就要来了。可一旦回到真实的物理世界,事情就变得有点魔幻了:模型预测的未来画面再完美,机械臂在实际落地时依然频频掉链子。
这背后,其实暴露了一个行业长期忽视的核心矛盾:能“生成”成功的结果,绝不等于拥有了真正的“规划能力”。面对那些从未见过的长流程任务,碰上复杂的物理约束,机器人就卡在了“看得懂画面,做不出动作”的尴尬境地。
最近在一场顶尖学术会议上,佐治亚理工学院助理教授、NVIDIA 研究员徐丹飞(Danfei Xu)直接点出了这个症结,并分享了他的破局思路。
在题为《Compositional World Models》(组合式世界模型)的主旨演讲中,他提出了一套方案:利用模块化和因子图(Factor Graphs),让机器人像搭积木一样,在测试阶段动态拼装基础技能。同时,他还首次系统性地剖析了视频预测与真实控制之间的那个“视频-动作跨越断层(Video-Action Gap)”。
以下内容为徐丹飞在大会上的演讲精编,在不改变原意的基础上进行了整理与译介:

01 别被“脑补画面”骗了:视觉生成并不等于物理规划
今天我们聚焦一个方向——组合式世界模型,这是我们实验室坚持了很久的一条路。
毫无疑问,世界模型(World Models)是当下机器人领域最受关注的技术路线。从早年结合线性动力学做视频控制,到如今借助扩散模型生成高保真视频,大家的终极目标都很一致:造出一个“通用规划器”,让机器人先在脑海里把成功的过程演一遍,然后照着做就行。
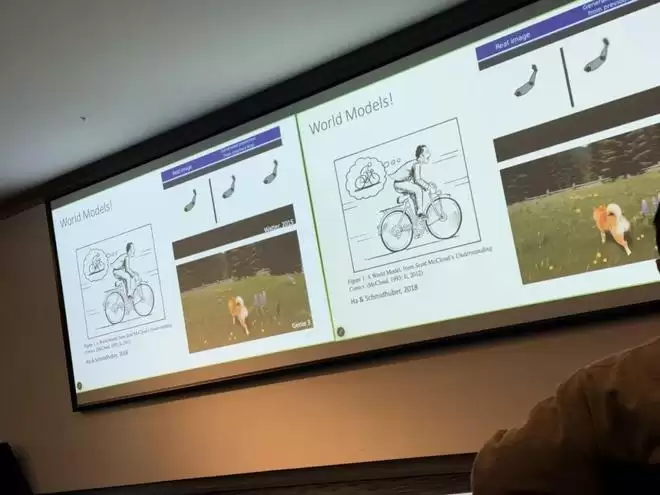
问题在于,这里藏着一个根本性的认知误区:高保真的画面生成,并不等同于物理意义上的规划。
举个例子。假设让机器人干一个复合任务——“把重物放进冰箱”。在训练数据里,模型可能已经分别学会了“双手抱重物”、“打开冰箱门”、“高位摆放”这几个独立技能。但当你让它面对一个从未组合过的全新场景时,结果会怎样?
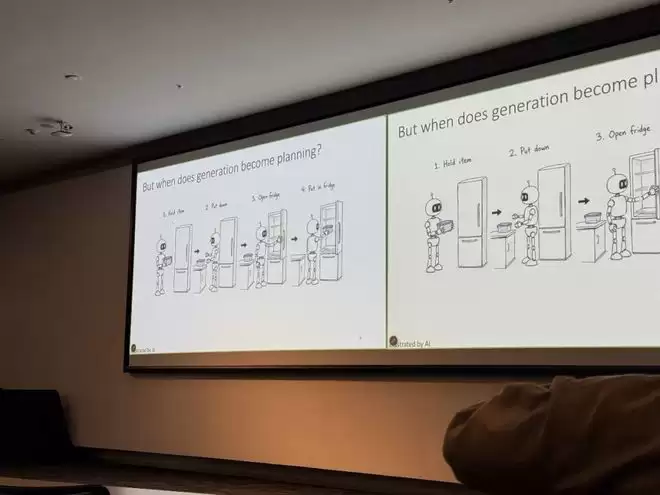
如果完全依赖生成模型,它或许能基于数据分布,合成一段看起来挺合理的“预测视频”。但到了真实执行时,往往会违背最基本的物理约束——比如,双手还抱着重物呢,就试图去拉冰箱门,甚至门都没开就想把东西往里塞。
生成(Generation),是在已有数据分布中提取一个高概率的预测结果;而规划(Planning),则必须在测试阶段(Test-time),针对新的长流程和物理限制,实时构造出一个数据集中从未出现过的“有效解(Valid Solution)”。
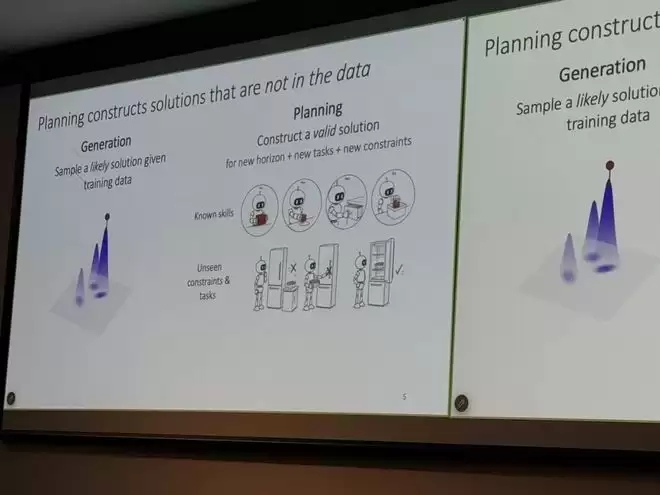
要打破这个局限,需要两个核心要素:具备泛化能力的先验表达,以及目标导向的测试期组合机制(Goal-directed Test-time Composition)。
02 像搭积木一样拼技能:用因子图破解长流程难题
受 AI 先驱马文·明斯基(Marvin Minsky)思想的启发,我们的核心思路很直接:把复杂的系统拆解成多个简单的模块化组件,然后在测试阶段动态组合起来。
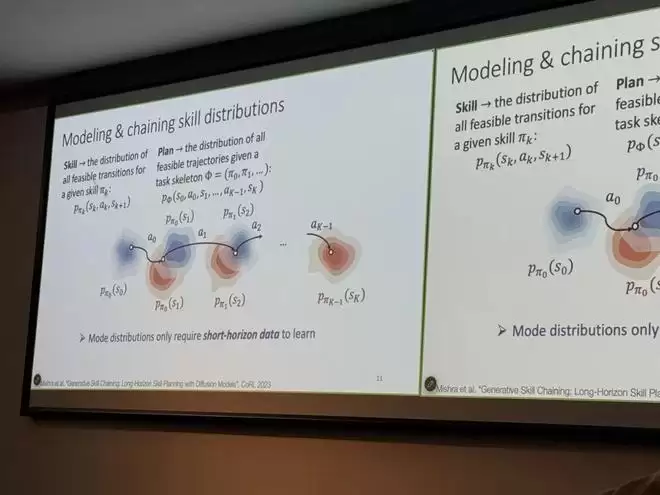
当需要按顺序执行两个技能时,逻辑有点像接力赛——前一个技能终止时的状态分布,必须精准覆盖后一个技能能够成功启动的起始状态区间。这个重叠的状态交集,就是两个技能之间能否顺畅衔接的“契约”。
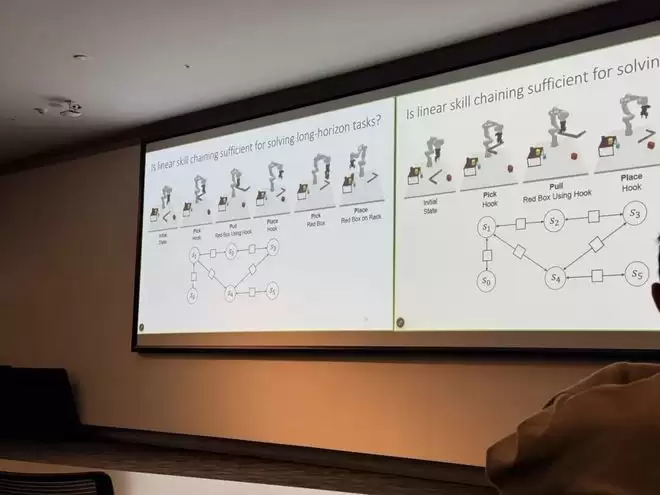
不过,如果只采用传统的单线串联方式(Linear Chaining),信息传递效率会非常低。假设第 10 步的抓握方式直接决定了第 1 步的准备姿态,信息就需要在整个链路上来回震荡、反复迭代。
为此,我们把这种链式结构扩展成了因子图(Factor Graphs)。借助因子图,可以在时空维度上自由定义各种约束条件:
空间维度:精确约束机械臂末端与目标物体之间的相对姿态;
时间维度:确保物体在移动过程中与机械臂保持物理同步;
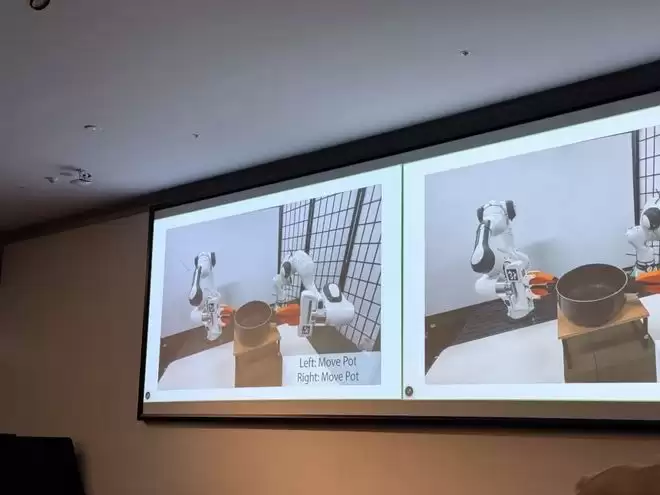
多臂协同:过去需要专门采集大量双手协同数据,现在只需要训练好单臂技能,在测试时通过因子图把两个单臂模型约束组合起来就行。
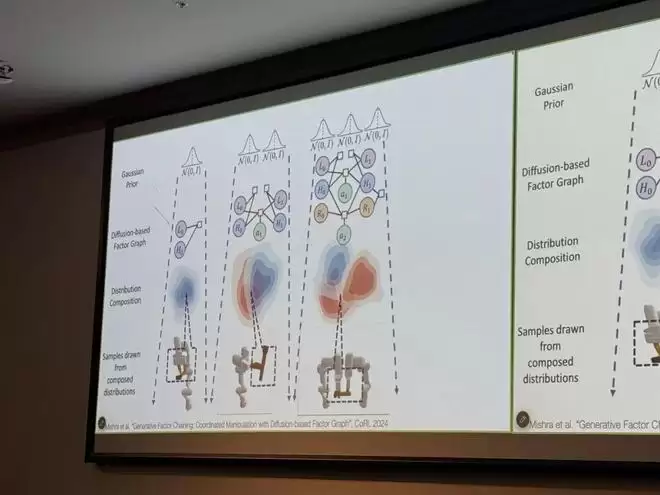
在这种机制下,机器人能顺利完成单臂难以应对的复杂任务——比如双手协同抬起沉重的双耳锅并旋转角度,或者左手递出锤子、右手精准接住并敲击钉子。
03 为什么眼会了手还是不会?揭秘“视频与动作”的断层
研究深入之后,我们遭遇了一个极其关键的工程瓶颈:即便世界模型预测出了一段看起来完美无瑕的未来视频,机器人的真实动作依然可能跟不上。
背后的本质原因在于:目前的视频大模型吸收了全网极其海量的视觉数据,泛化能力很强;而机器人底层的动作(Action)数据却极其匮乏。这就导致视频生成模型已经成功泛化到了新场景,但动作控制模型却出现了泛化滞后。
为了量化这个断层现象,我们提出了一个新的测量指标——时间注意力比例(Temporal Ratio),用来诊断模型在实时控制过程中,究竟将注意力权重分配给了“预测的未来”还是“眼前的当下”。
通过这个指标,我们发现了一个重要规律:
当机器人处于接近目标(Reaching)阶段时,它高度依赖对未来的轨迹预测,Temporal Ratio 显著偏高;而一旦进入物理接触与抓取(Grasping)阶段,它的注意力就会立刻回到“当前帧”,转而由实时的触觉与视觉微调主导。
基于这个发现,可以在测试期引入策略引导(Policy Guidance):在接近目标时强化模型对未来的前瞻注意力,在接触物体的瞬间把注意力拉回当下。这套方法显著提升了模型在面对分布外(OOD)复杂任务时的真实执行成功率。
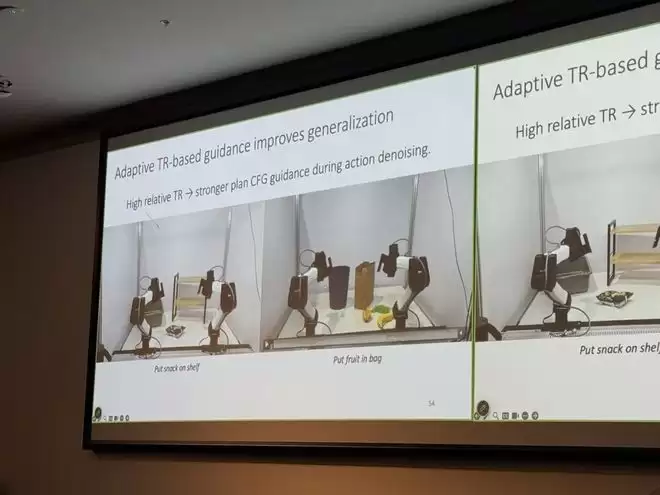
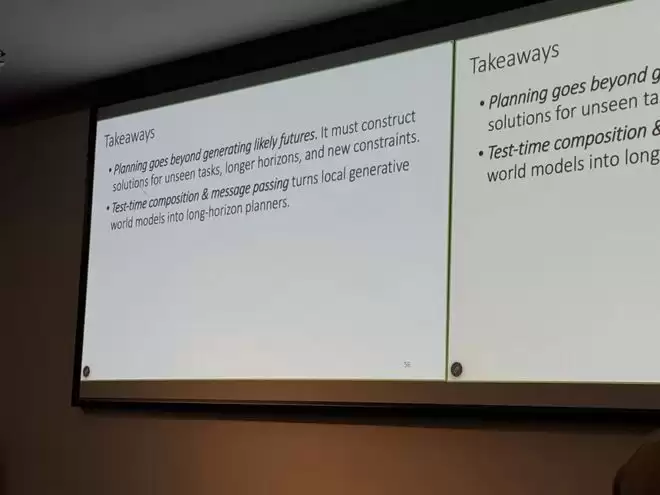
规划的本质,远不止于“预测出合理的未来视觉”。要推动具身智能真正落地,必须攻克“在测试阶段确定组合对象(What to compose)与组合机制(How to compose)”这个底层难题。
只有当机器人的真实动作能够精准对齐并执行那些预演的视觉未来时,世界模型的潜能才算真正释放出来。
谢谢大家!
04 现场对撞:关于数据、世界模型与策略模型的深层思考
Q1:目前的论文和产业实践大多聚焦于利用“成功的轨迹”进行预测,你如何看待训练数据中的“失败样本(Failures)”?将失败数据引入扩散模型训练具有怎样的学术或工程价值?
徐丹飞:目前大家普遍偏好成功数据,核心原因在于我们在测试阶段还缺乏一个足够高效的规划器,去消化和利用那些“失败视频”。一旦我们构建出能够深刻理解物理约束的规划算法,预测“某种动作会导致失败”的价值绝不亚于预测成功。
另一方面,现有的视频大模型几乎全部基于人类日常成功的活动数据进行训练,数据集中天然缺乏失败的案例。未来如果我们有意识地去捕获那些边缘和失败轨迹,对拓展世界模型的安全边界将带来质的飞跃。
Q2:在圆桌辩论环节,针对“世界模型(World Model)应该与策略模型(Policy)融合成单一模型,还是保持分立”这一争议,你的核心立场是什么?
徐丹飞:我倾向于保持两者的分立与独立性,主要基于两点考虑:
第一,模型目前依然处于严重的欠拟合(Underfitting)状态。面对互联网极其庞大的视频与具身数据集,现有的模型容量远未饱和。如果在一个本就在努力拟合物理世界规律的模型中,强行引入 Policy 的控制目标,会大幅增加预训练的收敛难度。
第二,两者对数据利用方式(Data Consumption)存在本质差异。Policy 的终极目标是输出精准的控制指令,天然偏好高质量的成功数据(更适合 SFT 或强化学习精调);而世界模型则需要吞下海量的失败与异常数据,才能完整构建对物理世界全貌的认知。将两者解耦、各司其职地进行优化,是当前更为稳妥且高效的工程路径。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。