


香港中文大学等机构联合提出的视觉感知新范式
最近,一项由深圳循环区研究院、武汉大学与香港中文大学多媒体实验室合作完成的研究,在预印本平台arXiv上发布,编号为arXiv:2605.12497。这项研究瞄准了一个我们日常都会遇到,但AI却长期束手无策的难题。 想象一下这个场景:朋友发来一张热闹的派对合照,问你“帮我找找今年奥斯卡最佳女配角在哪
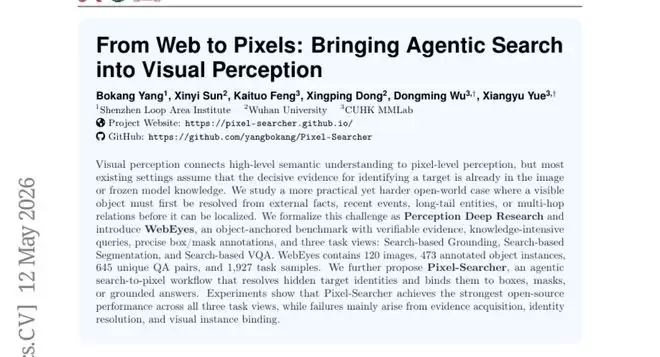
最近,一项由深圳循环区研究院、武汉大学与香港中文大学多媒体实验室合作完成的研究,在预印本平台arXiv上发布,编号为arXiv:2605.12497。这项研究瞄准了一个我们日常都会遇到,但AI却长期束手无策的难题。
想象一下这个场景:朋友发来一张热闹的派对合照,问你“帮我找找今年奥斯卡最佳女配角在哪儿”。如果你压根不关注奥斯卡,第一反应是什么?肯定是先掏出手机,搜索一下获奖者是谁,知道了名字和长相,再回到照片里去找人。这个“先查资料,再看图”的步骤,对我们来说再自然不过。然而,对于现有的AI视觉系统来说,这却是一道难以逾越的鸿沟——它们只会盯着图片看,缺乏“先上网查一查”的本能。
上述研究团队,正是为了攻克这个“AI不会查资料再看图”的核心瓶颈而来。他们为此定义了一个全新的任务:“感知深度研究”,并构建了一套完整的评测基准与解决方案。这相当于向整个AI领域抛出了一个新问题:我们能否让机器像人一样,先通过搜索厘清目标身份,再在图像中进行精准定位?
一、AI看图找人,为何会在知识门槛前碰壁
要理解这项研究的价值,得先看看当前AI视觉系统的主流工作模式。
目前的方法大致分为两类。第一类是“看图说话型”:给系统一张图和一句如“找那辆红色的车”的指令,AI直接根据颜色、形状等视觉特征定位目标。这好比考试只考图形识别,不涉及任何课外知识。第二类则进化了一些,可称为“推理型”:给系统一张图,问“找那个能让女人站得更高的东西”。AI需要调动训练时学到的常识,推理出“凳子”或“台阶”等答案,再到图中寻找。这类方法需要AI“肚子里的存货”。
但这两类方法共享一个关键前提:目标要么能凭视觉特征直接认出,要么能利用模型已有的常识推断出来。一旦这个前提不成立——当目标的身份隐藏在最新的新闻、冷门的关系或模型从未接触过的细节中时——现有方法便会集体失灵。
论文里举了一个堪称“变态”的例子:给AI看一张游戏主机摆在桌上的图,问题是“找那个发布时附赠了与一款赛车游戏捆绑套装的设备,而那款赛车游戏的主角在1981年的游戏中曾用过另一个名字”。解题链条是这样的:1981年的游戏是《大金刚》,主角当时叫“Jumpman”,后来改名“马里奥”;马里奥是《马里奥赛车》系列的主角;任天堂Switch 2发布时曾捆绑《马里奥赛车:世界》套装。所以,答案是Switch 2。这道题,靠“看”是看不出来的,靠常识库也未必够用,必须依赖多轮网络搜索来串联线索。
这正是“感知深度研究”要解决的核心挑战:它要求的不是简单描述“图里有什么”,而是先通过主动的网络搜索锁定目标身份,再将这个身份对应到图像中具体的像素位置。
二、WebEyes:一套专门为“查完资料再找目标”设计的考卷
为了科学地衡量这种能力,研究团队构建了一个名为“WebEyes”的数据集。你可以把它理解成一套专门考察AI“先查资料再看图”能力的标准化考卷。
这套考卷的设计逻辑很独特:它从具体的视觉实例出发,反向构造出需要外部知识才能解答的问题。数据集包含120张图片,标注了473个目标物体实例,并由此生成了645组独特的问答对,最终形成了1927道考题。内容覆盖六大类别:知名人物(23.68%)、标志性IP形象(27.06%)、流行文化IP(15.64%)、动漫角色(13.32%)、商品(12.69%)和车辆(7.61%),基本囊括了日常生活中那些“可能需要查一下才知道是谁/是什么”的物体。
考卷设计了三种题型,从不同维度考察AI的能力:
1. 基于搜索的目标定位:给一张图和一个知识密集的描述,AI必须输出目标在图中的精确边界框坐标。
2. 基于搜索的目标分割:要求更高,AI需要输出精确到像素级别的目标轮廓蒙版,好比用最精细的橡皮擦,只留下目标物体的形状。
3. 基于搜索的视觉问答:图中某个区域已被红框标出,AI需要从四个选项中,选出那个正确的描述,而正确选项必然包含需要联网查证的知识。
这三种题型源于同一批标注数据。这意味着,对于同一个物体,AI需要证明自己既能找到它,又能精确勾勒它,还能依据搜索到的知识正确描述它——三重考核,环环相扣。
构建这套考卷本身就是一项大工程。团队从网络、新闻和社交媒体收集包含多个前景目标的图片,经AI初筛和人工审核,剔除低质量或遮挡严重的样本。接着,人工标注每个目标的轮廓蒙版和边界框,并由AI辅助生成视觉特征描述。最关键的一步是:系统为每个目标发起三轮链式网络搜索,像侦探串联线索一样,重点收集近六个月内的非视觉信息(如最新动态、品牌关系、发布历史等)。最后,基于这些证据链生成问题,并刻意隐藏目标的直接名称和明显视觉特征,只留下需要推理才能破解的间接线索。
为了防止题目“放水”,系统设置了自动过滤机制,淘汰那些仅靠常识或看图就能回答的候选问题,这一步筛掉了38.2%的样本。通过自动筛选的题目再进入人工审核,检查证据准确性、目标唯一性等,又淘汰了49.2%。最终保留下来的每一道题,都拥有清晰、可追溯的证据链。
与以往的数据集相比,WebEyes的独特之处在于它同时满足了多个条件:既需要常识又需要实时网络知识;既考核定位也考核分割和问答;提供像素级精细标注。过去的RefCOCO等数据集主要考察视觉推理,MMSearch等则侧重纯文本搜索,而WebEyes首次将联网搜索与像素级视觉感知深度捆绑,提出了一个更完整、更贴近现实难度的挑战。
三、Pixel-Searcher:像侦探破案一样的两阶段视觉感知流程
有了高难度的“考卷”,研究团队也提出了自己的“解题思路”——一个名为Pixel-Searcher的方案。它的工作逻辑很像侦探破案:先调查线索锁定嫌疑人身份,再回到现场指认具体位置。
整个流程分为两个核心阶段:
第一阶段:主动搜索与目标身份解析。 系统拿到问题和图片后,并不急于看图,而是先拆解问题。如果问题涉及多步知识跳跃,系统会将其分解成一系列逻辑相扣的子问题。随后,系统进入“搜索-推理-判断”的循环:通过搜索获取外部证据,推理现有证据是否足够,判断当前对目标身份的最佳猜测。这个循环持续进行,直到证据充足或达到预设轮数。
此阶段最终输出的并非一段文字答案,而是一个结构化的“目标假设”,包含三个关键要素:目标的具体名称、其所属的视觉类别(如“人物”、“手机”),以及一组可以在图片中实际核验的关键视觉线索。这个结构化假设,成了连接网络文字证据与视觉感知的关键桥梁。
系统还会主动验证这个假设的可靠性,检查目标是否可见、假设是否过于宽泛或与场景矛盾,必要时启动修复流程。
第二阶段:主动定位与工具调用。 系统使用第一阶段生成的“目标假设”(而非原始问题)来指导视觉定位。这一步至关重要,因为原始问题充满间接描述,而“目标假设”已将其转化为可直接用于视觉检索的指令。
定位本身也是一个多步骤验证过程。系统会生成多个候选区域,然后用解析出的目标身份和关键线索为每个区域打分,选出最匹配的那个。对于目标定位任务,选中区域即为答案;对于目标分割任务,该区域会被送入专门的图像分割模型(如SAM3)生成像素级蒙版;对于视觉问答任务,流程则反过来,系统解析每个选项涉及的实体,判断哪个选项的描述与图中标注区域最匹配。
四、实验结果:查完网页再找目标,AI的表现提升了多少
研究团队对多种AI系统进行了全面测试,包括GPT-4o、Gemini等闭源商业模型,多种开源模型,以及他们提出的Pixel-Searcher方案。
在目标定位任务上,Pixel-Searcher在开源方案中表现最佳。以衡量预测框与真实框重叠度的IoU指标来看,基础模型Qwen3-VL-8B得分为26.81,而Pixel-Searcher将其提升至34.17,提升幅度约27%。另一个衡量准确框住目标比例的Recall@0.5指标,也从32.61提升到41.30。提升最显著的类别是动漫角色和标志性IP形象,这两类恰恰是最难凭外观直接区分、最依赖背景知识的类别。
在目标分割任务上,Pixel-Searcher同样是开源方案中的最优者,将基础模型的gIoU指标从35.78提升到39.17,cIoU指标从25.94提升到32.41。车辆、动漫和商品类别的提升尤为明显,这说明更准确的身份定位,确实能带来更精细的像素级分割结果。
在视觉问答任务上,准确率从36.34%提升至42.24%,在标志性IP和商品类别上优势突出。
不过,一个值得注意的现象是,即便是表现最好的开源方案Pixel-Searcher,与顶尖闭源商业模型(如Doubao-Seed-2.0-Pro)相比仍有明显差距。后者在目标定位上的IoU能达到35.69,在分割上的gIoU高达61.22。这清晰地表明,WebEyes所定义的任务依然非常困难,即使引入了联网搜索能力,距离人类水平或顶尖模型的性能,仍有很长的路要走。
五、哪里出了问题?失败的根源在于查资料而非画轮廓
研究团队通过深入的消融实验和失败案例分析,揭示了一些关键且反直觉的发现。
消融实验通过逐步移除Pixel-Searcher的组件来评估每个部分的重要性。最关键的发现是:如果移除“直接候选区域”生成与筛选这一步(即不让系统生成多个可能的位置框),模型的IoU会从34.17暴跌至20.14,Recall@0.5从41.30跌至19.72,性能近乎腰斩。这证明候选生成与筛选机制是整个流程的基石。当然,如果只有候选生成,缺乏后续基于目标证据的验证,效果也大打折扣——“仅直接定位”版本的IoU只有22.28。矛盾检测和参考图匹配等验证步骤,单独贡献虽小,但组合起来能带来稳定增益,说明多重验证机制之间存在协同效应。
失败分析则更深刻地指出了问题的瓶颈所在。团队仔细检查了389个失败案例,结论出乎意料:其中约78%(304个)的失败源于搜索过程或实体解析出错,例如搜到了错误证据,或将中间推理步骤误认为最终目标。约19%(75个)的失败是实体身份解析正确,却在图像中定位错了区域。仅有约3%(10个)的失败,是在正确找到区域后,生成像素蒙版时出了差错。
这个分布传达了一个明确信号:当前系统的核心瓶颈,不在于“画轮廓画得有多准”,而在于“前期能不能把要找谁搞清楚”。换句话说,如果能更精准地从网络获取证据、更可靠地解析出目标身份,并将其正确对应到图像实例,那么最终的定位和分割精度自然会水涨船高。这一发现为未来的研究指明了最值得发力的方向。
总而言之,这项研究完成了三件关键工作:定义了一个需要结合实时搜索与视觉感知的新问题;构建了一套能精准测量该问题难度的基准数据集;并提出了一套能部分解决该问题的方案,同时通过诊断实验,精准地指出了当前性能瓶颈所在。
目前的AI视觉系统,就像一个视力不错却知识匮乏的助手——眼力尚可,但知识库严重受限。WebEyes和Pixel-Searcher的探索表明,只有当视觉感知与主动的信息搜索能力真正深度融合,AI才有可能处理那些现实中大量存在的、“需要先查网页才能看懂图”的复杂任务。全面解决这个问题道阻且长,但前进的方向,已然清晰。
对技术细节感兴趣的读者,可通过arXiv编号2605.12497查阅完整论文。
Q&A
Q1:WebEyes数据集里的问题到底有多难?普通AI模型完全无法应对吗?
A:WebEyes的问题被刻意设计为需要多步联网推理,例如通过品牌收购事件找到代言人,再对应到图中人物。仅使用不联网的纯视觉模型,准确率通常极低,部分模型在定位任务上的IoU得分甚至是个位数。然而,联网搜索也非万能钥匙,目前最好的开源方案Pixel-Searcher的整体IoU也仅在34分左右,这说明该数据集对现有AI系统而言,仍然是一个相当大的挑战。
Q2:Pixel-Searcher为什么不直接组合现成的搜索引擎和图像识别模型,而要设计复杂的两阶段流程?
A:直接组合会存在“语义断层”:搜索引擎返回的是文本证据,而图像识别需要视觉特征。Pixel-Searcher的两阶段设计核心就是为了搭建桥梁。第一阶段将文本证据浓缩为结构化的“目标假设”(包含名称、类别、视觉线索),第二阶段用这个假设而非原始问题去指导视觉定位和验证。这个“中间表示”是整个系统能工作的关键,消融实验也证实,缺少其中任何一环,性能都会显著下降。
Q3:“感知深度研究”与现有的视觉问答、图像搜索任务本质上有何不同?
A:现有视觉问答通常假设答案能从图片内容或模型内置知识中推导;图像搜索则是根据文本描述寻找相关图片。“感知深度研究”的特殊性在于:目标物体在图片中清晰可见,但识别它所需的关键信息却隐藏在图片之外的实时网络知识中,并且最终输出要求是图片中的精确像素坐标或轮廓,而非一段文本。它要求AI同时具备主动搜索、多跳推理和像素级视觉感知三种能力,这在以往的任务设定中从未被如此严格地要求过。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。