


纽约大学与弗拉托恩研究所:AI大模型到底是怎么"记住"知识的?
关于大语言模型如何记忆事实,一个流传甚广的比喻是“电话本”:每一条知识都像一条独立的记录,存储在模型庞大的参数矩阵里。查询时,模型通过模式匹配找到对应的词条。这个思路很直观,但代价也显而易见——知识越多,模型就越臃肿。 然而,一项由纽约大学与弗拉托恩研究所联合开展的最新研究,为我们揭示了一个截然不同
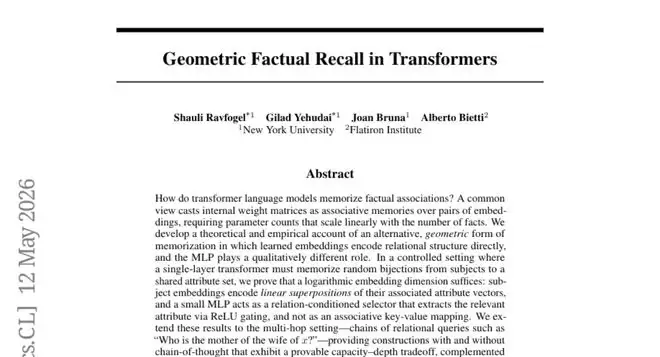
关于大语言模型如何记忆事实,一个流传甚广的比喻是“电话本”:每一条知识都像一条独立的记录,存储在模型庞大的参数矩阵里。查询时,模型通过模式匹配找到对应的词条。这个思路很直观,但代价也显而易见——知识越多,模型就越臃肿。
然而,一项由纽约大学与弗拉托恩研究所联合开展的最新研究,为我们揭示了一个截然不同、且更为精巧的真相。这项于2026年5月以预印本形式发布的研究(论文编号:arXiv:2605.12426)发现,模型采用的是一种“几何化压缩”策略。它并非笨拙地开辟独立空间存储每条知识,而是将多条相关信息叠加编码进同一个向量空间,就像一个多层透明胶片叠放在一起。负责读取的模块则像一个智能滤镜,能根据问题精准抽取出对应的那一层信息。
这不仅仅是效率的提升,更是一种记忆哲学的转变。
一、记忆的两种哲学:电话本还是叠影
不妨把大语言模型的记忆系统想象成一座图书馆。传统的“电话本”式认知认为,图书馆里每个人都有一个独立的档案柜,里面分门别类地存放着他的所有信息。查询“爱因斯坦的出生地”,就去找到“爱因斯坦”的柜子,翻开“出生地”那一页。这种方式清晰,但代价是图书馆的规模必须与档案数量同步增长。
而这项研究提出的“几何记忆”方式,则描绘了另一番景象。在这座图书馆里,没有独立的档案柜,取而代之的是一面巨大的“叠影投影墙”。每个人的信息——出生地、职业、语言等——都被编码成特定角度的光影,叠加在同一束光里。当你想知道某人的出生地时,一个名为MLP的“智能滤镜”就会启动,过滤掉其他所有信息,只让与“出生地”对应的那道光影显现出来。
这个思路的惊人之处在于,它彻底模糊了“存储”与“计算”的界限。知识并非静态地存放在某个固定地址,而是以一种动态的、几何叠加的结构存在于向量空间中,由一个通用的筛选机制实时提取。这意味着,存储一千个人的信息,可能并不需要比存储一百个人多出十倍的“书架空间”。
二、实验的舞台:一个干净的玩具世界
为了将这一猜想转化为可严格验证的结论,研究团队构建了一个极度简化但保留核心矛盾的“玩具实验”。他们没有在GPT或Llama这类复杂模型上直接动手,因为干扰因素太多。
实验场景设定如下:有N个“主体”(如人物),R种“关系”(如出生地、职业),每种关系将每个人映射到一个“属性”上(如“伦敦”)。关键约束在于,所有关系共享同一个属性池,且每种关系都是“双射”——即每个属性只对应一个主体。这比许多理论假设更困难,因为模型无法通过属性本身来判断它属于哪种关系。
在这个场景中训练一个单层Transformer,任务很简单:给定主体名称和关系类型,预测正确的属性。这就像一场填空题测试:“张三的出生地是?”模型需要从N个可能答案中选出正确的一个。
核心问题随之浮现:模型到底需要多大的向量维度,才能完美记住所有N×R条知识?
三、数学的结论:对数维度就够了
这是整篇论文的理论核心。所谓“维度”,可以理解为每个词汇被表示成多长的一串数字。维度越大,表达能力越强,但参数也越庞大。
传统的关联记忆方法,其所需维度大约与主体数量N成正比。主体翻倍,所需维度和参数量也近乎翻倍。
而研究团队的核心定理(定理4.1)证明:如果允许模型自主学习嵌入向量,那么所需维度d大约仅为 4R × log₂(N) + 1。这里的log₂(N)是以2为底N的对数。
对数增长意味着什么?如果N是4096(约4千),log₂(N)等于12。即使N膨胀到一百万,log₂(N)也只有20。换句话说,需要记忆的主体数量翻几百倍,所需维度的增加却微乎其微。这是一个质的飞跃。
那么,压缩是如何实现的?答案在于“叠加编码”。每个主体的向量,实际上是其在所有R种关系下的属性向量的线性叠加。就像将旋律、节奏、歌词信息同时压缩进一段声波。随后,MLP模块扮演“筛选器”的角色。当被问及特定关系时,它通过ReLU等非线性操作,精准地从叠加的向量中抽取出对应信息,屏蔽其他干扰。至关重要的是,这个MLP的宽度仅与关系种类R成正比,与主体数量N无关——它是一个通用的提取器,而非庞大的记忆库。
四、梯度下降能找到这个解吗?实验给出的答案
理论很优美,但模型在训练中真能自发找到这个高效解吗?这是理论与现实之间的关键桥梁。
研究团队进行了系统性实验。他们固定N=4096,让关系数R在2到16间变化,向量维度d在32到768间调整,进行了大量测试。
第一个发现是:当维度d达到128或以上时,模型几乎总能完美记忆所有知识,准确率100%。相比之下,如果冻结嵌入向量(模拟传统记忆方式),则需要d达到512甚至更高才能达到同等精度。
更进一步,他们测量了达到95%准确率所需的最小维度d。对于可学习嵌入,d随N的增长完美符合对数曲线。而对于随机固定嵌入,d则随N呈线性增长。两条曲线的对比,直观展示了几何记忆的效率优势。
五、叠影结构真的存在吗?三种验证方式
光有性能表现还不够,必须验证模型内部是否真的形成了理论预测的叠加结构。研究团队设计了三种互补的实验进行探查。
1. 线性读出测试:为每种关系单独训练一个线性变换矩阵,尝试直接从主体嵌入向量中解码出对应属性。结果清晰显示,在维度足够时,所有关系的线性解码准确率都接近100%。这意味着每个主体的向量里,确实线性叠加了所有关系的信息。而使用随机嵌入的模型,解码准确率与随机猜测无异。
2. 因果干预测试:思路是,如果MLP是精准的关系选择器,那么只扰动主体向量中与某种关系对应的部分,就应该只影响对该关系的预测,而不影响其他。实验通过构造精准扰动并计算“选择性”分数来验证。在维度足够时,该分数接近1,证实了MLP确实在进行关系特异性的筛选。
3. MLP冻结迁移测试:这是最令人印象深刻的验证。先用一组随机映射训练模型直至收敛,然后完全冻结MLP的参数。接着,换上一套全新的、模型从未见过的随机映射,并仅通过线性代数方法重新初始化主体嵌入向量(使其成为新属性向量的叠加)。最后,直接测试,不做任何额外训练。结果发现,冻结了MLP的模型,在新映射上的零样本准确率依然接近100%。这强有力地证明,MLP学到的不是具体的“张三-北京”映射,而是一套通用的筛选机制——只要信息按正确方式叠加,它就能正确提取,无论具体内容是什么。
六、多跳推理:当你问“X的妻子的母亲是谁”
以上实验都是单步事实查询。但现实问题往往更复杂,例如“这本书作者的出生地是哪里?”,这涉及两步推理。研究团队将此类问题称为“多跳推理”,并深入探究了其容量瓶颈。
直觉上,多跳推理更难,但难在何处?论文定理4.2从信息论角度给出了精确答案。
该定理通过计数分析揭示,模型的参数比特数W与嵌入维度比特数D之间必须满足特定不等式,否则无法区分所有可能的映射关系。分析指出了三种迥异的情形:
当嵌入维度D非常小时,模型权重必须承担海量存储工作,参数需求巨大。当D足够大时,嵌入空间足以容纳完整的推理树,权重负担减轻,但代价是嵌入维度随推理跳数k指数增长(约R^k量级)。在这两个极端之间,则存在参数与维度的连续权衡。
为了证明这个理论下界是“紧的”(即存在实际构造能达到该效率极限),研究团队给出了两种明确的多跳Transformer构造方案,恰好对应了两个极端,验证了理论分析的完备性。
七、思维链:一个优雅的解法
面对多跳推理的维度瓶颈,一个自然的解决方案是:让模型一步步推导,把中间结果“说”出来,而不是试图一次完成所有计算。这正是“思维链”(Chain-of-Thought)的核心思想。
论文定理4.4为此提供了明确的理论支持。它证明,当模型被允许生成中间步骤时,仅需一个单层Transformer,嵌入维度约为R×log(N),即可解决任意跳数的推理问题。与不使用思维链的方案相比,这是一个质的飞跃:嵌入维度从R^k级别降回对数级别,模型层数也从k层降为1层,唯一的代价是需要多一些推理时间来生成中间步骤。
这背后的逻辑非常优雅。思维链的本质,是将连续的“隐式计算”转化为分步的“显式中间状态”。每输出一个中间答案,模型就把该主体的完整嵌入信息重新带入序列,作为下一步推理的起点。这相当于每次推理后都重置了状态,无需在内部维持指数级复杂的信息。
实验结果印证了这一点:在多跳任务中,使用思维链的模型在4跳高难度配置下仍能保持接近完美的准确率;而不使用思维链的模型,在2跳时准确率就已显著下降,4跳时几乎完全失败。
八、真实大模型里的线性结构
理论和玩具模型都支持几何记忆的图景,但在Llama、Qwen、Phi这些真实的庞然大物内部,是否也存在类似结构?研究团队进行了探索性验证。
他们构建了一个涵盖4610个实体、42种关系的测试集,并在Qwen、Llama、Phi等多个不同规模的模型上,训练“线性探针”来尝试从模型中间层的隐向量中预测答案。
结果呈现出一个清晰一致的模式:线性探针的预测准确率远高于随机猜测。更有趣的是各层的动态变化:探针效果随着网络层数加深而持续提升,在深度50%到80%处达到峰值,之后趋于平稳。这与“信息层层丰富化”的理论预测高度吻合——模型在前向传播中,逐渐将隐向量加工成更容易线性解码的结构。
此外,实验还发现,如果用单层词嵌入模型来记忆相同语料,其线性解码准确率甚至比多层预训练大模型更高。这进一步印证了“主体嵌入直接编码属性信息”这一理论预测在简化场景下的有效性。
九、与以往观点的对比和理论的精确位置
这项研究并非凭空而来,它是在与既有理论框架的对话中确立自身位置的。此前最具影响力的观点,如Bietti等人(2024)和Nichani等人(2025)的工作,将Transformer的知识存储理解为一种“联想记忆”,即注意力或MLP权重相当于存储键值对的外积。这种方式所需的参数量,大致与知识条数(N×R)成正比。
而本篇论文的核心突破在于,它证明了当模型被赋予学习嵌入向量的自由度时,可以突破这种线性增长的束缚,实现对数量级的压缩。这并非否定了前人的工作,而是指明了在另一种更高效的机制下,模型记忆知识的根本性不同路径。它为我们理解大模型如何以如此经济的参数存储海量知识,提供了一个强有力的、且可验证的新范式。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。