


实现Python代码以增强大型模型的检索功能

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
本文的首要关注点是RAG的概念和理论。接下来,我们将展示如何利用LangChain、OpenAI语言模型和Weaviate向量数据库来实现一个简单的RAG编排系统检索增强生成是什么?检索增强生成(RAG)这一概念是指通过外部知识源来为LLM提供附加的信息。这让LLM可以生成更准确和更符合上下文的答案,同时减少幻觉。在进行内容重写时,需要将原文改写为中文,而无需出现原句当前最佳的LLM都是使用大量数据训练出来的,因此其神经网络权重中存储了大量一般性知识(参数记忆)。但是,如果在通过prompt让LLM生成结
本文的首要关注点是RAG的概念和理论。接下来,我们将展示如何利用LangChain、OpenAI语言模型和Weaviate向量数据库来实现一个简单的RAG编排系统
检索增强生成是什么?
检索增强生成(RAG)这一概念是指通过外部知识源来为 LLM 提供附加的信息。这让 LLM 可以生成更准确和更符合上下文的答案,同时减少幻觉。
在进行内容重写时,需要将原文改写为中文,而无需出现原句
当前最佳的 LLM 都是使用大量数据训练出来的,因此其神经网络权重中存储了大量一般性知识(参数记忆)。但是,如果在通过 prompt 让 LLM 生成结果时需要其训练数据之外的知识(比如新信息、专有数据或特定领域的信息),就可能出现事实不准确的在进行内容重写时,需要将原文改写为中文,而无需出现原句(幻觉),如下截图所示:
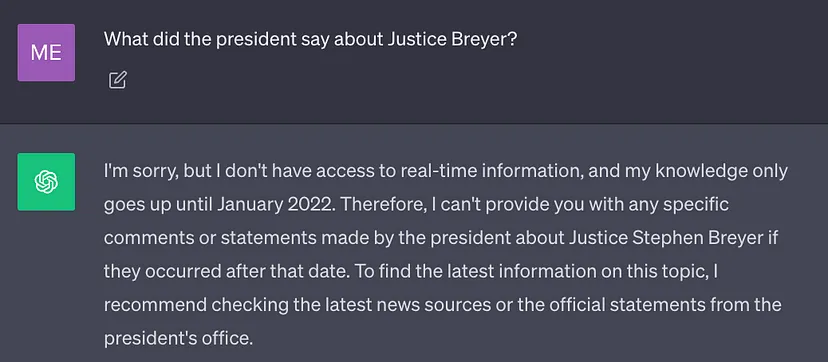
因此,重要的是将LLM的一般知识与附加上下文结合起来,以便生成更准确且更符合上下文的结果,并减少幻觉
解决方案
传统上,我们可以通过微调模型来让神经网络适应特定领域或专有信息。尽管这种技术是有效的,但它需要大量的计算资源,成本高昂,并且需要技术专家的支持,因此很难快速适应不断变化的信息
2020 年,Lewis et al. 的论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》提出了一种更为灵活的技术:检索增强生成(RAG)。在这篇论文中,研究者将生成模型与一个检索模块组合到了一起;这个检索模块可以用一个更容易更新的外部知识源提供附加信息。
用大白话来讲:RAG 之于 LLM 就像开卷考试之于人类。在开卷考试时,学生可以携带教材和笔记等参考资料,他们可以从中查找用于答题的相关信息。开卷考试背后的思想是:这堂考试考核的重点是学生的推理能力,而不是记忆特定信息的能力。
同样,事实上的知识与 LLM 推理能力是不同的,并且可以存储在易于访问和更新的外部知识源中
- 参数化知识:在训练期间学习到的知识,以隐含的方式储存在神经网络权重之中。
- 非参数化知识:储存于外部知识源,比如向量数据库。
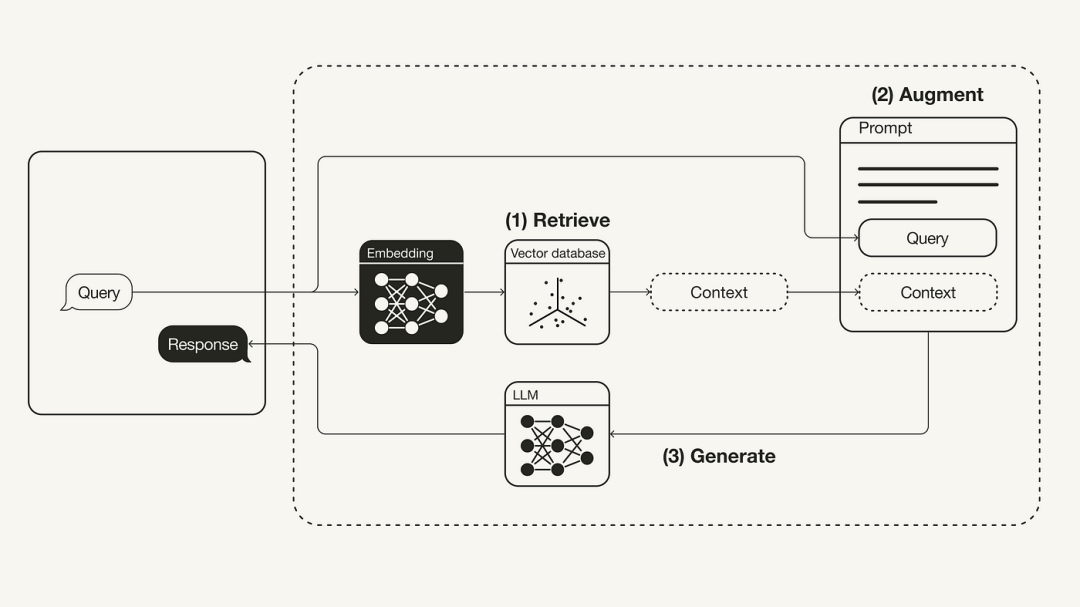
以下图表展示了最基本的RAG工作流程:
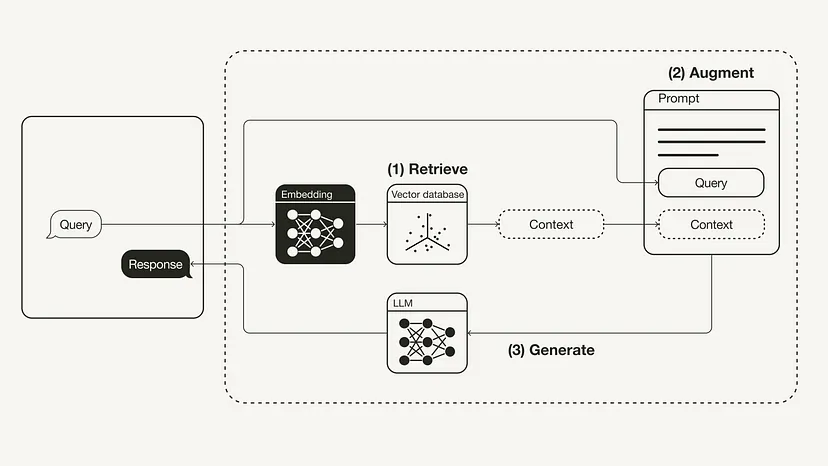
重新编写的内容:重建检索增强生成(RAG)的工作流程
- 检索:将用户查询用于检索外部知识源中的相关上下文。为此,要使用一个嵌入模型将该用户查询嵌入到同一个向量空间中,使其作为该向量数据库中的附加上下文。这样一来,就可以执行相似性搜索,并返回该向量数据库中与用户查询最接近的 k 个数据对象。
- 增强:然后将用户查询和检索到的附加上下文填充到一个 prompt 模板中。
- 生成:最后,将经过检索增强的 prompt 馈送给 LLM。
使用 LangChain 实现检索增强生成
下面将介绍如何通过 Python 实现 RAG 工作流程,这会用到 OpenAI LLM 以及 Weaviate 向量数据库和一个 OpenAI 嵌入模型。LangChain 的作用是编排。
请重新表达:必需的先决条件
请确保你已安装所需的 Python 软件包:
- langchain,编排
- openai,嵌入模型和 LLM
- weaviate-client,向量数据库
#!pip install langchain openai weaviate-client
另外,在根目录下用一个 .env 文件定义相关环境变量。你需要一个 OpenAI 账户来获取 OpenAI API Key,然后在 API keys(https://platform.openai.com/account/api-keys )「创建新的密钥」。
OPENAI_API_KEY=""
然后,运行以下命令来加载相关环境变量。
import dotenvdotenv.load_dotenv()
准备工作
在准备阶段,你需要准备一个作为外部知识源的向量数据库,用于保存所有的附加信息。这个向量数据库的构建包含以下步骤:
- 收集并载入数据
- 将文档分块
- 对文本块进行嵌入操作并保存
重写后的内容:首先,我们需要收集和加载数据。举个例子,如果我们想要使用拜登总统2022年的国情咨文作为附加上下文,LangChain的GitHub库提供了该文件的原始文本文档。为了加载这些数据,我们可以利用LangChain内置的多种文档加载工具。一个文档(Document)由文本和元数据构成的词典。要加载文本,可以使用LangChain的TextLoader工具
原始文档地址:https://raw.githubusercontent.com/langchain-ai/langchain/master/docs/docs/modules/state_of_the_union.txt
import requestsfrom langchain.document_loaders import TextLoaderurl = "https://raw.githubusercontent.com/langchain-ai/langchain/master/docs/docs/modules/state_of_the_union.txt"res = requests.get(url)with open("state_of_the_union.txt", "w") as f:f.write(res.text)loader = TextLoader('./state_of_the_union.txt')documents = loader.load()接下来,将文档分块。因为文档的原始状态很长,无法放入 LLM 的上下文窗口,所以就需要将其拆分成更小的文本块。LangChain 也有很多内置的拆分工具。对于这个简单示例,我们可以使用 CharacterTextSplitter,其 chunk_size 设为 500,chunk_overlap 设为 50,这样可以保持文本块之间的文本连续性。
from langchain.text_splitter import CharacterTextSplittertext_splitter = CharacterTextSplitter(chunk_size=500, chunk_overlap=50)chunks = text_splitter.split_documents(documents)
最后,对文本块进行嵌入操作并保存。为了让语义搜索能够跨文本块执行,就需要为每个文本块生成向量嵌入,并将它们与它们的嵌入保存在一起。为了生成向量嵌入,可以使用 OpenAI 嵌入模型;至于储存,则可使用 Weaviate 向量数据库。通过调用 .from_documents (),可以自动将文本块填充到向量数据库中。
from langchain.embeddings import OpenAIEmbeddingsfrom langchain.vectorstores import Weaviateimport weaviatefrom weaviate.embedded import EmbeddedOptionsclient = weaviate.Client(embedded_options = EmbeddedOptions())vectorstore = Weaviate.from_documents(client = client,documents = chunks,embedding = OpenAIEmbeddings(),by_text = False)
步骤 1:检索
填充完向量数据库后,我们可以将其定义为一个检索器组件,该组件可以根据用户查询和嵌入块之间的语义相似性获取附加上下文
retriever = vectorstore.as_retriever()
步骤 2:增强
from langchain.prompts import ChatPromptTemplatetemplate = """You are an assistant for question-answering tasks. Use the following pieces of retrieved context to answer the question. If you don't know the answer, just say that you don't know. Use three sentences maximum and keep the answer concise.Question: {question} Context: {context} Answer:"""prompt = ChatPromptTemplate.from_template(template)print(prompt)接下来,为了使用附加上下文增强 prompt,需要准备一个 prompt 模板。如下所示,使用 prompt 模板可以轻松地定制 prompt。
步骤 3:生成
最终,我们可以为这个 RAG 流程建立一个思维链,将检索器、prompt 模板和 LLM 链接在一起。一旦定义完成 RAG 链,就可以调用它
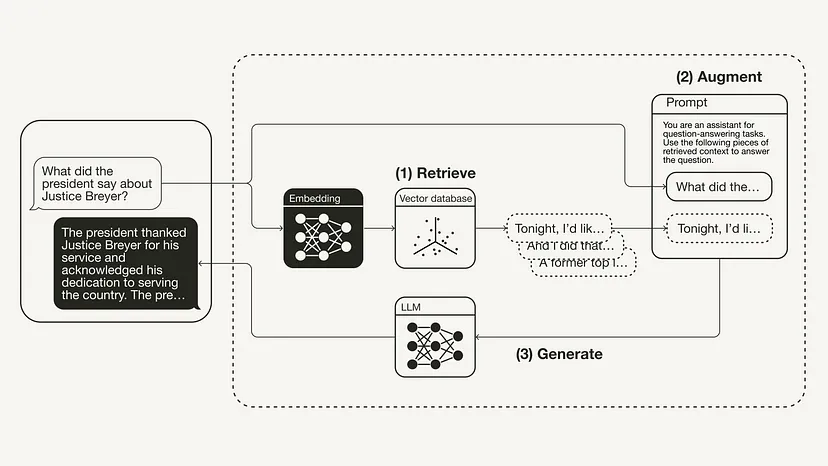
from langchain.chat_models import ChatOpenAIfrom langchain.schema.runnable import RunnablePassthroughfrom langchain.schema.output_parser import StrOutputParserllm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)rag_chain = ({"context": retriever,"question": RunnablePassthrough()} | prompt | llm| StrOutputParser() )query = "What did the president say about Justice Breyer"rag_chain.invoke(query)"The president thanked Justice Breyer for his service and acknowledged his dedication to serving the country. The president also mentioned that he nominated Judge Ketanji Brown Jackson as a successor to continue Justice Breyer's legacy of excellence."下图展示了这个具体示例的 RAG 流程:
总结
本文介绍了 RAG 的概念,其最早来自 2020 年的论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》。在介绍了 RAG 背后的理论(包括动机和解决方案)之后,本文又介绍了如何用 Python 实现它。本文展示了如何使用 OpenAI LLM 加上 Weaviate 向量数据库和 OpenAI 嵌入模型来实现一个 RAG 工作流程。其中 LangChain 的作用是编排。











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。