


abbyy finereader怎么用 文档扫描与文字识别
是一种图片文字识别软件。FineReader提供快速、准确、方便的方式来扫描文件、PDF格式、数字或移动电话图像转换成可编辑的格式
详解 ABBYY FineReader 在 Windows 下的操作流程:包括扫描设置、OCR 语言选择、版面区域校正、文字校对以及导出 Word 和可搜索 PDF 的方法,助您准确还原纸质文档内容。
把纸质合同、报告或书籍变成电脑里能搜索、能修改的数字文件,是办公自动化的基础需求。ABBYY FineReader 的核心价值在于它不仅能把图片“拍”下来,还能通过 OCR(光学字符识别)技术读懂里面的文字。你可以选择导出为 Word 继续排版,或者生成带文本层的 PDF 用于归档检索。这两种结果用途不同,操作细节也有差异。
下面以 Windows 版 FineReader PDF 为例,演示如何处理一份包含中文正文和英文名称的两页文档。我们将按照“扫描/导入—设置—识别—校对—导出”的顺序,确保最终得到的文件既准确又可用。
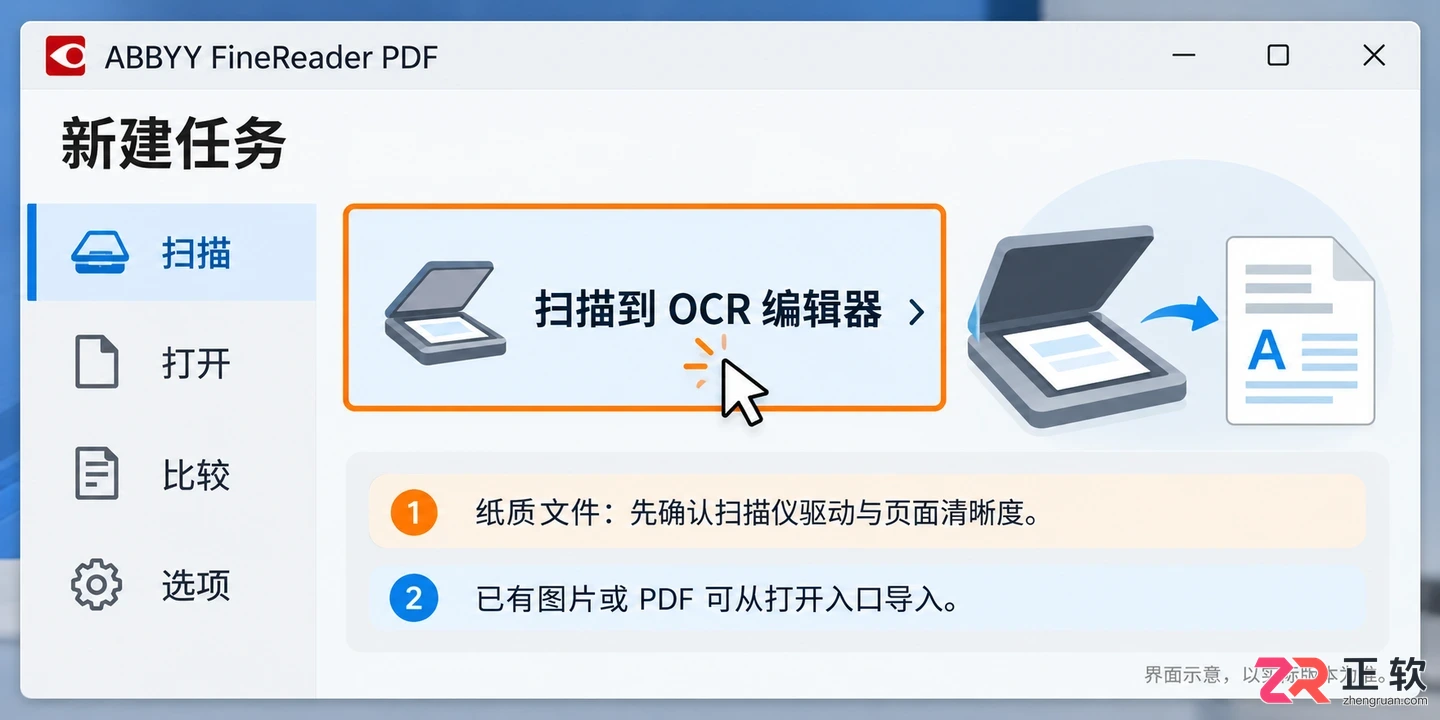
FineReader 新建任务窗口,选择扫描到 OCR 编辑器入口
1. 连接扫描仪,先准备清楚的页面
在开始软件操作前,物理介质的质量决定了识别的上限。确认扫描仪已安装好 Windows 驱动,并能被系统正常调用。FineReader 支持符合 TWAIN 或 WIA 标准的设备,具体兼容性取决于你的硬件型号。
放置纸张时务必铺平,避免折痕、阴影遮挡文字。先在扫描软件中预览一页,检查方向是否正确、边缘是否完整。分辨率设置要适中,通常 300 DPI 足以应对普通印刷体;不要试图通过放大模糊的低清图片来弥补清晰度不足,那样只会增加噪点。
如果原稿含有彩色图表、底纹或印章,请选择彩色模式扫描;若只需纯文字且原稿对比度高,黑白模式可以减小文件体积,但要注意浅色文字可能在二值化过程中丢失。
2. 从新建任务进入 OCR 编辑器
打开 FineReader,在新建任务窗口中选择【扫描】功能,并指定【扫描到 OCR 编辑器】。这是处理复杂版面和需要精细校对时的最佳入口。选定扫描设备后执行扫描,页面图像会直接载入 OCR 工程界面。
如果你手头已经有扫描好的图片或普通 PDF 文件,可以直接拖入软件或选择【打开】,同样进入 OCR 编辑器。请注意,普通的 PDF 阅读器界面与 OCR 编辑器不同,后者左侧有页面缩略图,右侧有识别结果对照区,专门用于逐字核对。
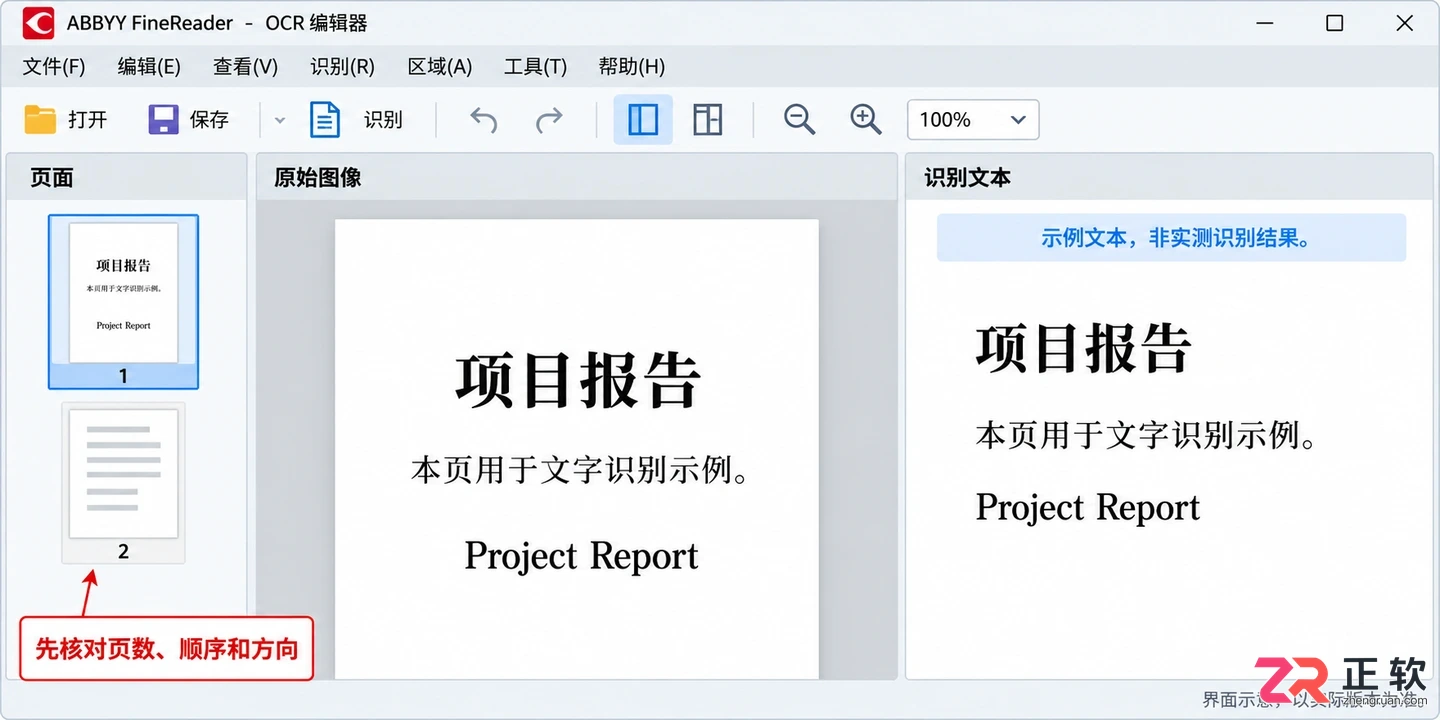
OCR 编辑器主界面,左侧页列表显示完整的双页文档
页面载入后,首先检查左侧页列表。确认页数是否完整、顺序是否正确。如果有缺页、倒置或重复的情况,请在此阶段调整或删除,避免在识别完成后才发现资料缺失,导致返工。
3. 设置与文档相符的识别语言
识别准确率很大程度上取决于语言设置。点击工具栏中的【识别语言】或相关设置按钮,勾选文档中实际使用的语言。本例中正文为简体中文,夹杂英文专有名词,因此应同时选中“中文简体”和“英语”。
需要区分的是,“识别语言”不等于“软件界面语言”。即使菜单显示为中文,如果未勾选中文识别包,软件也无法正确识别汉字。反之,英文界面的软件只要安装了相应语言包,同样可以精准识别中文。
不要为了“保险”而勾选所有语言。过多的语言选项会增加混淆概率,导致软件将中文误判为其他相似字符集的语言。遇到识别不准时,优先检查语言设置和原图清晰度,而不是盲目增加语言选项。
4. 检查页面方向和识别区域
在 OCR 编辑器中,软件会自动分析页面并划分区域。你需要检查这些区域框是否准确覆盖了文字、图片和表格。
如果页面有歪斜,使用【图像处理】工具中的“纠偏”功能进行校正。对于自动划分错误的区域,例如将正文误判为图片,或将表格拆散为独立文本块,需要手动调整。选中错误区域,右键更改其类型(如改为“文本”、“表格”或“图片”),并拖动边框使其精确贴合内容。
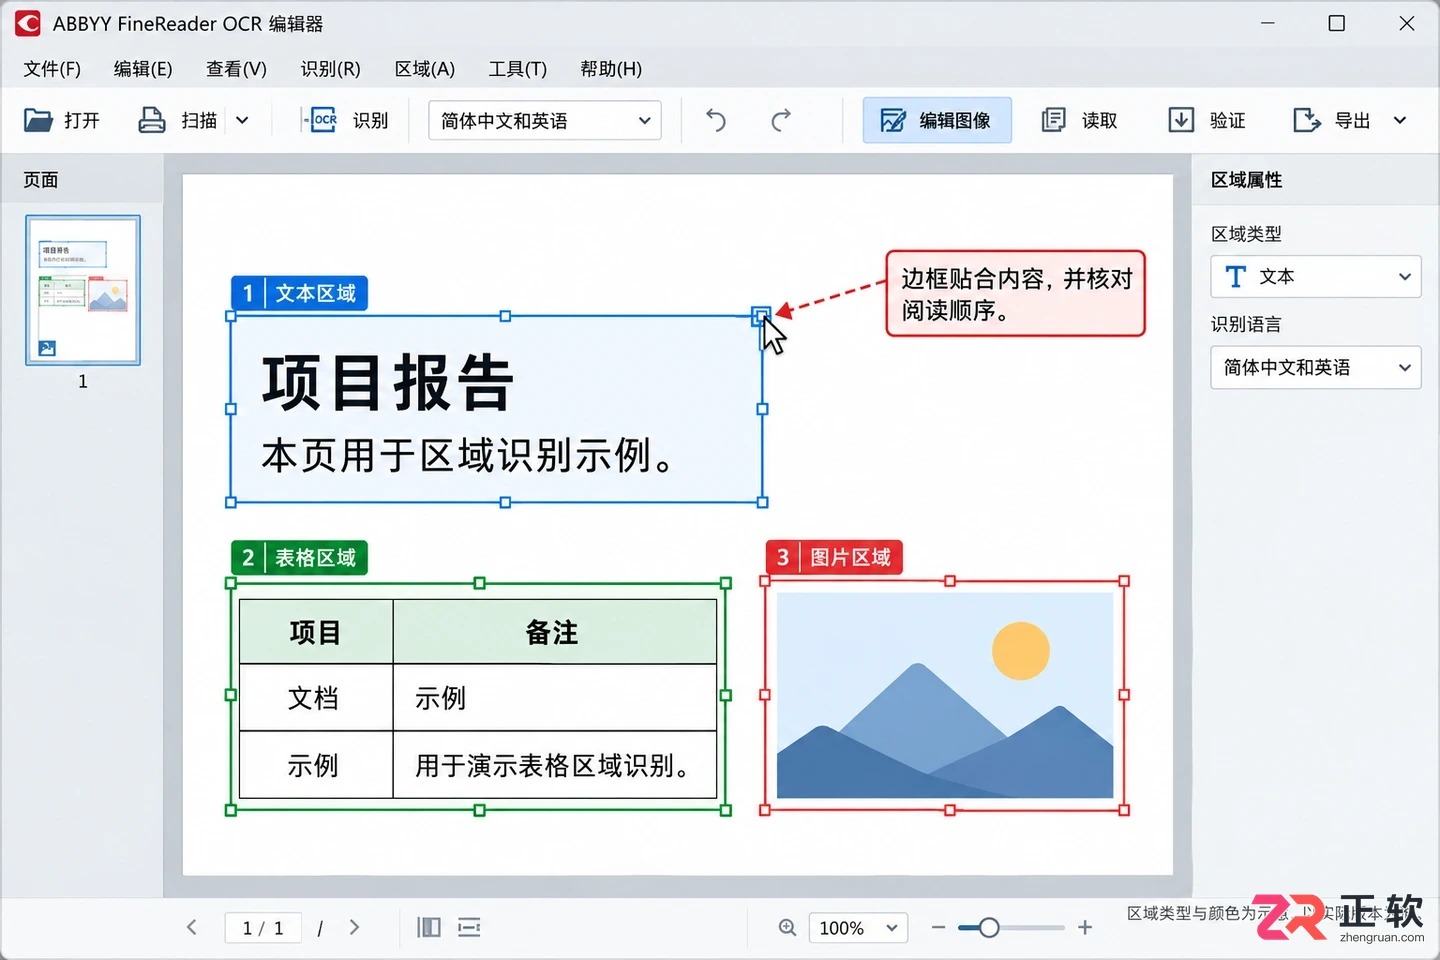
手动调整识别区域,区分文本、表格和图片块
对于多栏排版的文档,还要检查阅读顺序。软件通常用数字标记区域的读取先后,确保它符合人类的阅读习惯(如从左到右、从上到下)。如果顺序错误,导出的文字将会错乱。
5. 对照原图校对文字与表格
点击【识别】按钮后,软件会将图像转换为文本。此时进入最关键的校对环节。界面通常分为三部分:上方是原图,下方左侧是识别结果,右侧是可疑字符提示。
优先检查姓名、日期、金额、编号等关键信息。特别注意形近字(如“1”和“l”,“0”和“O”)以及标点符号。软件标记为红色的不确定字符必须逐一核对,但未标记的部分也可能存在错误,尤其是模糊印章或手写备注附近。
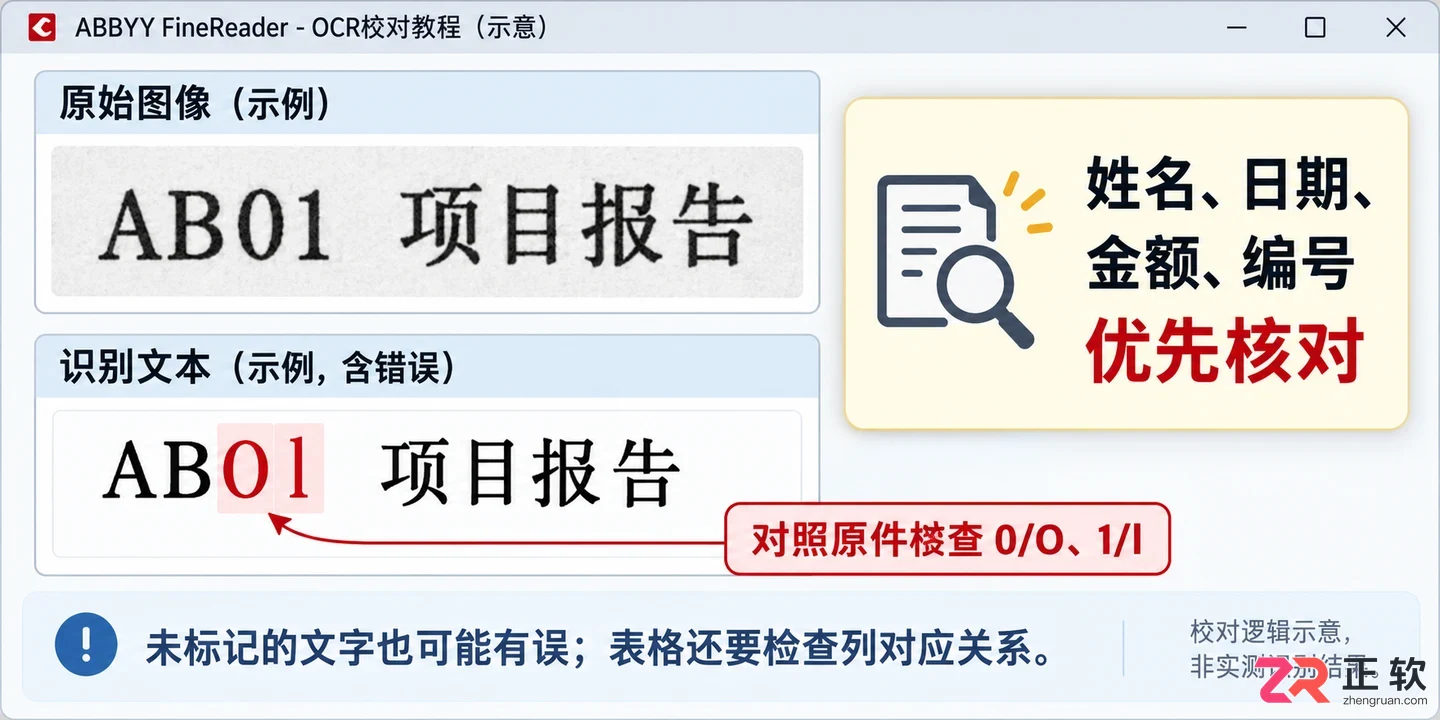
校对模式下,原图与识别文本上下对照,重点检查可疑字符
表格内容的校对要格外细心。检查合并单元格是否正确、列对应关系是否错位。有时一个数字识别正确,但被放入了错误的列,这在财务数据中是致命错误。如果发现大面积表格识别错误,建议回到第 4 步重新调整表格区域,然后重新识别,而不是在导出后的 Word 里手动修补。
6. 按用途导出 Word 或可搜索 PDF
校对无误后,根据用途选择导出格式。
如果需要继续编辑内容,选择【保存为 Microsoft Word】。在保存选项中,可以选择“精确副本”以保留原版式,或选择“可编辑副本”以获得更流畅的文本流,方便重新排版。
如果目的是归档和检索,选择【保存为 PDF】。务必确认勾选了“包含文本层”或类似选项。这样生成的 PDF 看起来是图片,但实际上背后有一层可搜索、可复制的文字。仅在 FineReader 内部能搜索是不够的,必须保存为文件后,用其他 PDF 阅读器测试搜索功能,确保文本层已正确嵌入。
导出后,用独立的 Word 或 PDF 阅读器打开文件。在 Word 中检查段落断行和表格结构;在 PDF 中搜索一个生僻词,并尝试复制粘贴到记事本中,查看是否有乱码或多余空格。
7. 保留原稿与 OCR 工程
最后,不要删除原始扫描文件和 FineReader 的工程文件(.frdoc 或类似格式)。导出后的 Word 或 PDF 是“成品”,但不再包含区域划分和识别状态信息。如果未来需要调整版面或重新识别某一部分,保留工程文件可以大幅节省时间。
建议建立清晰的文件命名规范,如“项目名_原始扫描”、“项目名_校对工程”、“项目名_最终输出”。对于合同、发票等重要法律或财务文件,自动识别结果仅供参考,务必以原件和人工审核为准,避免因 OCR 误差造成实质性的业务风险。
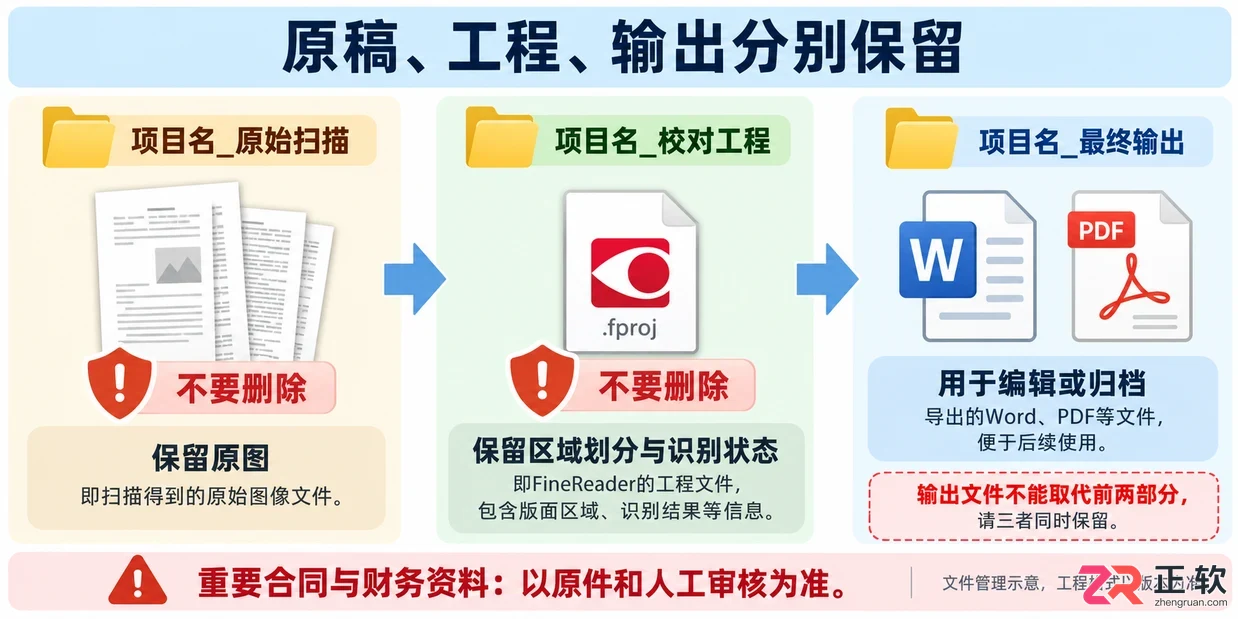
7. 保留原稿与 OCR 工程








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。