


Java递归实战:二叉树遍历与文件目录扫描
深入讲解Java递归在二叉树遍历与磁盘文件目录扫描中的落地实现,包含运行机制推导、完整可编译代码示例、栈溢出风险分析及生产级规避策略。
一、递归的核心机制与调用栈模型
递归是一种通过方法直接或间接调用自身来解决复杂问题的编程技术。其核心思想是将一个规模庞大的问题拆解为与原问题结构相同但规模更小的子问题,直到触及可以直接得出结果的基线终止条件(Base Case)。
在实际开发中,无论是内存中的层级数据(如二叉树),还是操作系统底层的文件系统层次,本质上都属于树形(Tree)或有向无环图结构。这类具有自相似性的结构天然契合递归的处理范式。
任何一个健壮的递归方法都必须具备两个核心支柱:
- 基线终止条件(Base Case):防止无限循环的出口。
- 递归推进关系(Recursive Step):确保子问题的规模不断缩小并趋向于终止条件。
如果缺失基线条件,或者子问题没有向终止条件靠拢,程序将陷入无限递归,最终因耗尽方法栈空间而抛出 java.lang.StackOverflowError。
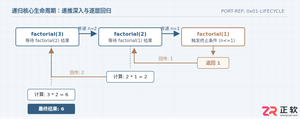
在 JVM 规范中,每一次方法调用都会在线程专有的 Java 虚拟机栈(JVM Stack)中分配一个独立的栈帧(Stack Frame)。每个栈帧封装了局部变量表、操作数栈、动态链接以及方法退出信息。当递归发生时,JVM 持续向栈顶压入(Push)新栈帧;一旦命中基线条件开始返回,当前栈帧被弹出(Pop),返回值传递给上一层父级栈帧。
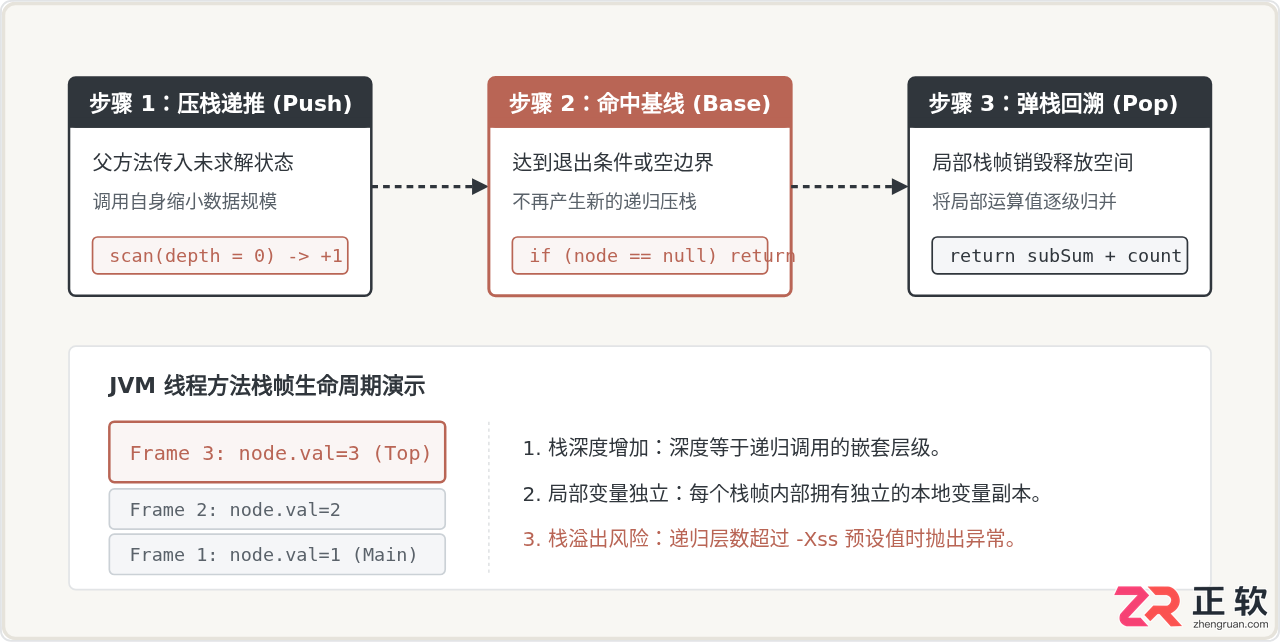
图 1:递归调用时栈帧生命周期与三个推导阶段
二、实战一:二叉树递归遍历(前序、中序、后序)
二叉树(Binary Tree)是树形数据结构的基础,每个节点至多包含左子树与右子树。由于子树本身也符合二叉树定义,因此遍历操作非常适合用递归表达。
遍历方式的分类取决于根节点的访问时机:
- 前序遍历(Pre-order):根 → 左 → 右。常用于快速克隆树结构或目录路径序列化。
- 中序遍历(In-order):左 → 根 → 右。对于二叉搜索树(BST),中序遍历能天然输出单调递增的有序序列。
- 后序遍历(Post-order):左 → 右 → 根。适用于需先处理子节点再推导父节点的场景,如子目录容量汇总、语法分析树节点释放等。
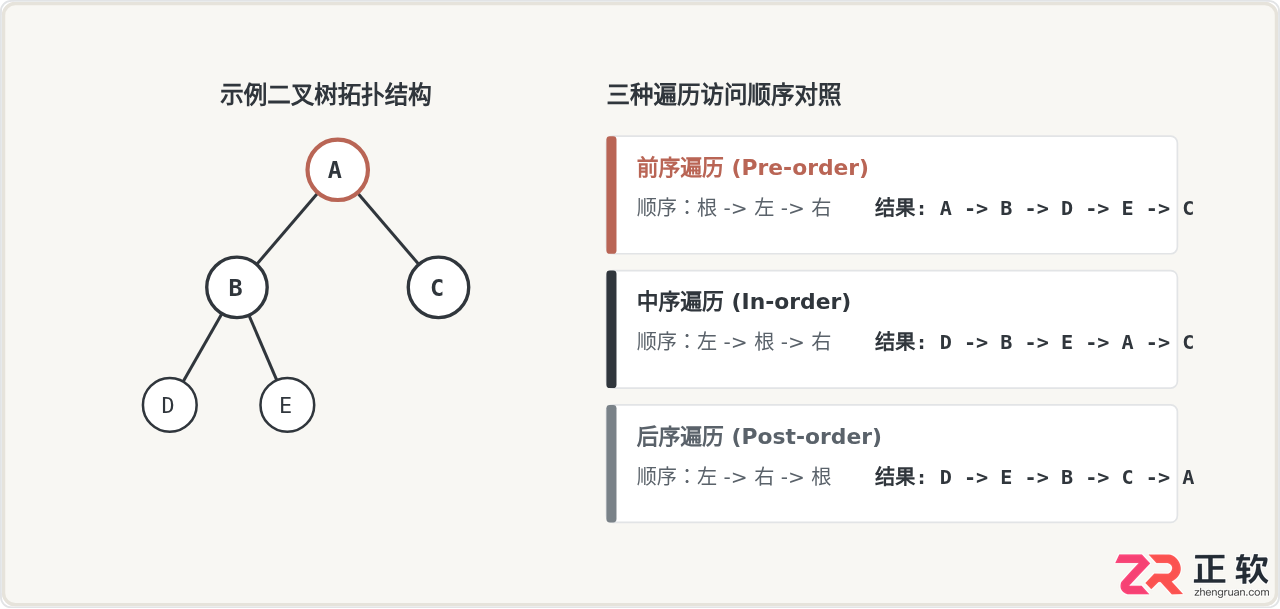
图 2:二叉树拓扑与三种遍历访问逻辑及输出对比
二叉树遍历代码实现
以下代码定义了泛型树节点 TreeNode,并在 JDK 8+ 环境下实现了三种遍历方式。
package com.example.recursion;

import java.util.ArrayList;
import java.util.List;

/**
 * 二叉树节点定义
 */
class TreeNode {
    T val;
    TreeNode left;
    TreeNode right;

    TreeNode(T val) {
        this.val = val;
    }
}

public class BinaryTreeTraversalDemo {

    /**
     * 前序遍历:根 -> 左 -> 右
     */
    public static  void preOrder(TreeNode node, List result) {
        // 基线终止条件
        if (node == null) {
            return;
        }
        // 处理当前根节点
        result.add(node.val);
        // 递归访问左子树
        preOrder(node.left, result);
        // 递归访问右子树
        preOrder(node.right, result);
    }

    /**
     * 中序遍历:左 -> 根 -> 右
     */
    public static  void inOrder(TreeNode node, List result) {
        if (node == null) {
            return;
        }
        inOrder(node.left, result);
        result.add(node.val);
        inOrder(node.right, result);
    }

    /**
     * 后序遍历:左 -> 右 -> 根
     */
    public static  void postOrder(TreeNode node, List result) {
        if (node == null) {
            return;
        }
        postOrder(node.left, result);
        postOrder(node.right, result);
        result.add(node.val);
    }

    public static void main(String[] args) {
        // 构建图2中所示的二叉树拓扑结构
        TreeNode root = new TreeNode<>("A");
        root.left = new TreeNode<>("B");
        root.right = new TreeNode<>("C");
        root.left.left = new TreeNode<>("D");
        root.left.right = new TreeNode<>("E");

        List preResult = new ArrayList<>();
        preOrder(root, preResult);
        System.out.println("前序遍历输出: " + String.join(" -> ", preResult));

        List inResult = new ArrayList<>();
        inOrder(root, inResult);
        System.out.println("中序遍历输出: " + String.join(" -> ", inResult));

        List postResult = new ArrayList<>();
        postOrder(root, postResult);
        System.out.println("后序遍历输出: " + String.join(" -> ", postResult));
    }
}
控制台示例输出结果:
前序遍历输出: A -> B -> D -> E -> C
中序遍历输出: D -> B -> E -> A -> C
后序遍历输出: D -> E -> B -> C -> A
三、实战二:多叉树实战——文件目录扫描与尺寸统计
操作系统的目录层级本质上是一棵多叉树(N-ary Tree)。每个目录项代表树中的一个节点,既可能是叶子节点(普通文件),也可能包含子节点集合(子目录)。因此,深度优先扫描文件系统是递归最直观的应用场景。
在编写扫描逻辑时,需重点解决以下问题:
- 基线条件识别:若目标路径不存在或为普通文件,直接计算大小并返回,无需继续下探。
- 权限及空指针防范:调用
file.listFiles()时,若目录无读取权限或发生 I/O 错误,该方法可能返回null。必须校验以避免NullPointerException。 - 层级深度格式化:引入
depth计数器,向下递归时传递depth + 1,利用缩进展示树状视觉效果。
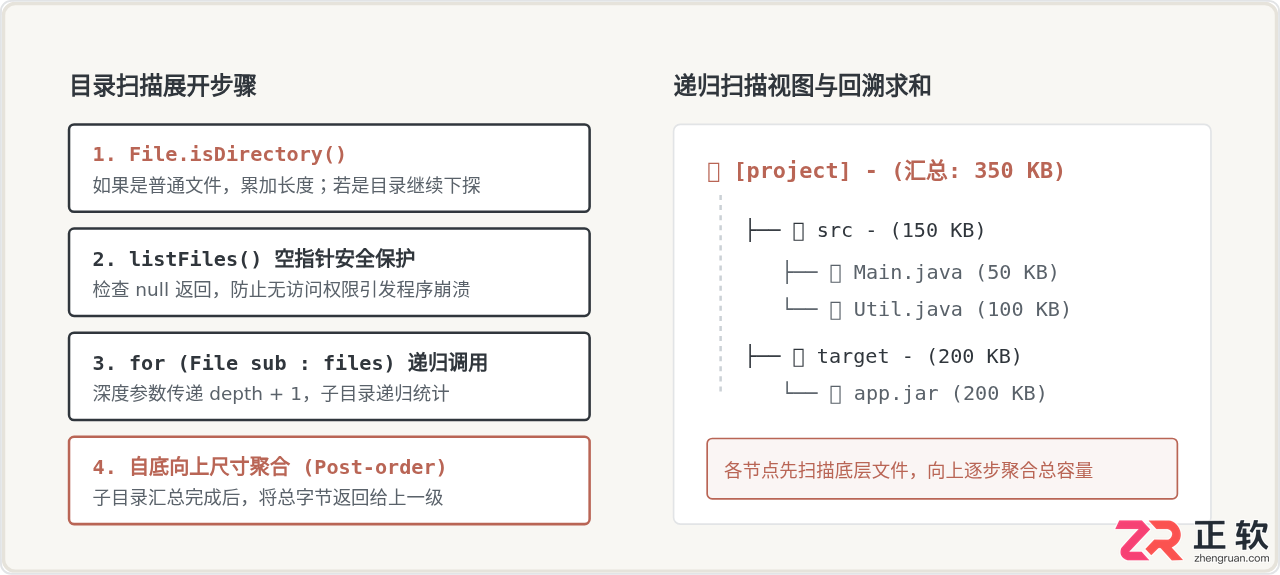
图 3:目录层级遍历流程与多叉树自底向上的数据聚合过程
目录扫描与尺寸统计代码实现
以下示例结合递归遍历与容量后序统计功能,格式化打印目录层级并返回总字节数。
package com.example.recursion;

import java.io.File;

public class DirectoryScannerDemo {

    /**
     * 递归扫描指定文件或目录,打印层级树形,并返回总字节大小
     *
     * @param target 当前检查的文件或目录
     * @param depth  递归深度(用于生成输出缩进)
     * @return 当前路径项及其子文件占用的总字节数
     */
    public static long scanAndCalculateSize(File target, int depth) {
        // 边界条件:若目标为 null 或在磁盘中并不存在,直接返回 0
        if (target == null || !target.exists()) {
            return 0L;
        }

        // 基线终止条件:如果当前节点是普通文件
        if (target.isFile()) {
            printIndented(target.getName() + " [" + target.length() + " bytes]", depth, false);
            return target.length();
        }

        // 递归推进分支:当前节点是目录
        printIndented("📁 " + target.getName(), depth, true);

        File[] subFiles = target.listFiles();
        // 防御性保护:处理空目录、系统隐藏限制或权限受限导致的 null 情况
        if (subFiles == null || subFiles.length == 0) {
            return 0L;
        }

        long currentDirectoryTotalSize = 0L;

        // 遍历所有子节点(多叉树递归分支展开)
        for (File child : subFiles) {
            // 向下传递递归深度:depth + 1
            long childSize = scanAndCalculateSize(child, depth + 1);
            currentDirectoryTotalSize += childSize;
        }

        return currentDirectoryTotalSize;
    }

    /**
     * 依据层级深度输出带有树形缩进标记的文字
     */
    private static void printIndented(String message, int depth, boolean isDirectory) {
        StringBuilder prefix = new StringBuilder();
        for (int i = 0; i < depth; i++) {
            prefix.append("  │ ");
        }
        prefix.append(isDirectory ? "├─ " : "└─ ");
        System.out.println(prefix + message);
    }

    public static void main(String[] args) {
        // 传入需要扫描的路径(这里使用示例目录路径)
        File scanDir = new File("./test-sample");

        // 如果示例目录不存在,可在本地动态创建测试沙箱进行验证
        if (!scanDir.exists()) {
            scanDir.mkdirs();
            try {
                new File(scanDir, "notes.txt").createNewFile();
                File subDir = new File(scanDir, "data");
                subDir.mkdirs();
                new File(subDir, "core.bin").createNewFile();
            } catch (Exception ignored) {
            }
        }

        System.out.println("开始执行目录扫描任务...");
        long totalBytes = scanAndCalculateSize(scanDir, 0);
        System.out.println("扫描完成,统计总字节大小: " + totalBytes + " bytes (" + (totalBytes / 1024.0) + " KB)");
    }
}
控制台示例输出结果:
开始执行目录扫描任务...
├─ 📁 test-sample
│ └─ notes.txt [1024 bytes]
│ ├─ 📁 data
│ │ └─ core.bin [204800 bytes]
扫描完成,统计总字节大小: 205824 bytes (201.0 KB)
四、递归在生产应用中的风险控制与对比
递归代码简洁且可读性高,特别适合处理分形与树形特质的问题。但在复杂的生产环境中,盲目使用传统递归面临现实的技术约束。
生产陷阱提醒:
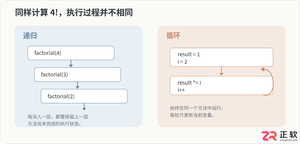
JVM 的线程调用栈深度并非无限。在 64 位 HotSpot JVM 中,默认单线程栈深度(由 -Xss 参数控制,通常为 1MB)可支撑的调用层级一般在数千层到一万层之间。若文件系统遭遇恶意软链接循环引用(如 A 链接到 B,B 链接回 A),或面对严重倾斜的二叉单枝树,程序必将触发 StackOverflowError。
图 4:隐式递归调用栈与显式堆容器迭代方案的多维度架构对比
生产级目录扫描的三项优化准则
-
引入深度熔断限制 在业务逻辑中强制校验
maxDepth。例如当检测到depth > 32时,立即截断下探并记录警告日志,防止因异常目录拓扑导致资源枯竭。 -
符号链接(Symbolic Links)死循环检测 传统的
java.io.File无法自动识别符号链接造成的循环回环。生产环境推荐迁移至 Java 7+ 引入的java.nio.file.Files.walkFileTree。该 API 会自动维护已访问节点的FileKey集合;若检测到路径循环,会直接抛出FileSystemLoopException而非陷入死循环。 -
极端深度的迭代重构 若明确面对未知深度的层次结构(如海量归档文件目录或未平衡二叉树),应使用
Deque将算法从“JVM 隐式方法调用栈”重构为“堆内存显式数据栈”。堆内存容量通常在数百兆到数十吉字节,能彻底免除方法栈溢出的隐患。stack = new ArrayDeque<>();












火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,