


Java递归与循环迭代:性能、内存与场景选择指南
全面解析Java递归与循环迭代的差异。从方法调用开销、线程栈内存消耗到树形结构遍历,结合基准测试与改写步骤,帮助开发者在性能、可读性与稳定性间做出准确的技术选型。
在 Java 开发中,递归和循环往往能解决同一类重复计算问题,但两者的底层成本截然不同。对于简单的线性计算,循环通常具备更低的调用开销与更稳定的内存占用,且天然规避了栈溢出风险;而对于树形结构、目录扫描或分治算法等具有天然层级特征的问题,递归往往能更直观地映射业务逻辑。
因此,技术选型不应停留在“哪种写法更好”的表面争论,而应综合评估调用深度、数据结构特征、性能指标、内存限制以及代码可维护性。
一、底层执行机制的本质差异
循环迭代依赖 for、while 或 do...while 等控制语句,在同一个方法上下文中反复执行代码块。每次迭代通常只需更新局部变量状态,随后直接进入下一轮。
递归则是方法直接或间接调用自身。每进入一次新的递归层级,JVM 都需要在调用栈中开辟新的栈帧,用于保存当前方法的参数、局部变量及返回地址。直到满足终止条件,栈帧才会逐层弹出并返回结果。
以计算正整数 n 的阶乘为例,两种实现方式如下:
递归实现
public static long factorialRecursive(int n) {
    if (n <= 1) {
        return 1;
    }
    return n * factorialRecursive(n - 1);
}
循环实现
public static long factorialIterative(int n) {
    long result = 1;

    for (int i = 2; i <= n; i++) {
        result *= i;
    }

    return result;
}
两者计算结果一致,但执行轨迹完全不同。调用 factorialRecursive(4) 时,递归版本需连续压栈四层,到达最底层后才开始逐层返回;循环版本始终停留在同一方法内,仅通过更新 result 和 i 完成计算。
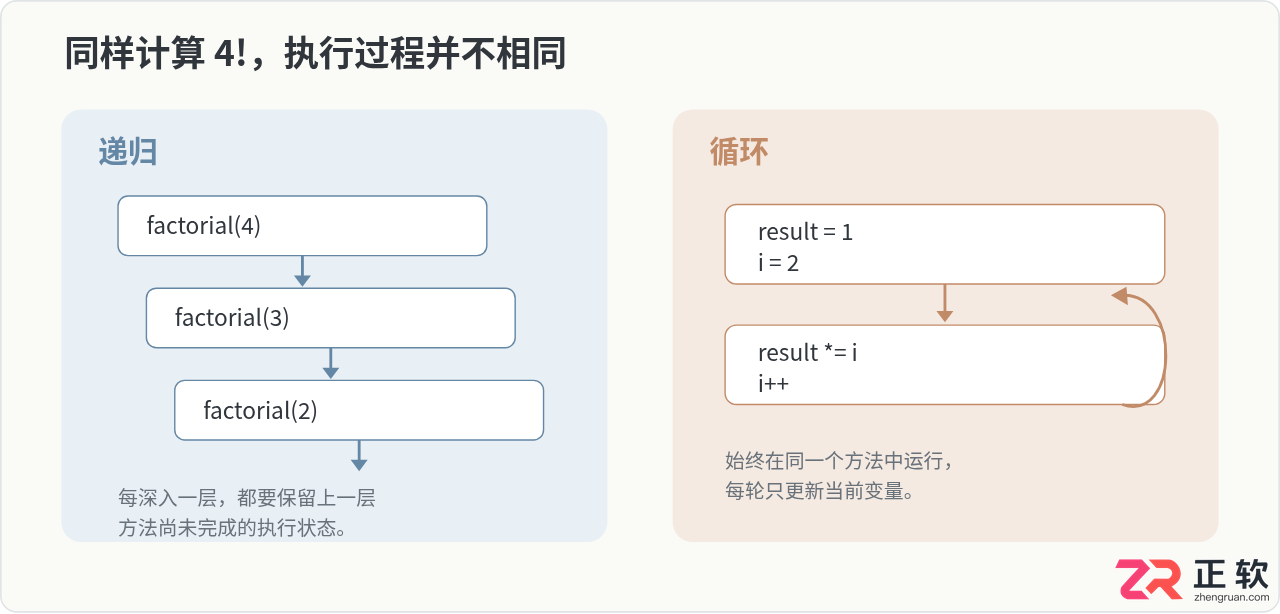
图1:递归通过多层方法调用完成计算,循环则在同一执行上下文中反复更新状态。
二、性能开销的来源与算法误区
对于可直接用循环替代的线性逻辑,循环通常能获得更低的执行开销。但这并非因为“递归语法天生更慢”,而是递归实现不可避免地引入了方法调用与返回的固定开销。一次完整的递归调用通常包含以下动作:
- 准备并传递下一层参数;
- 压入新的方法执行上下文(栈帧);
- 保存当前层的执行断点与局部状态;
- 执行子逻辑并等待返回;
- 恢复当前层上下文并继续执行。
循环跳过了上述压栈与恢复流程,因此在简单重复任务中控制流更扁平。但需注意,现代 JVM 的即时编译器(JIT)会进行大量优化(如内联、逃逸分析),实际性能差距受代码结构、调用频率、JVM 版本及运行环境共同影响。
更重要的是,必须严格区分算法时间复杂度与实现方式的固定开销。若递归与循环的理论工作量均为 O(n),循环通常仅胜在附加开销更低;若递归本身存在大量重复子问题,性能瓶颈则源于算法设计缺陷,而非递归语法。
典型反例:低效算法导致的性能误判
以下斐波那契数列的递归写法极为常见:
public static long fibonacciRecursive(int n) {
    if (n <= 1) {
        return n;
    }

    return fibonacciRecursive(n - 1)
         + fibonacciRecursive(n - 2);
}
该实现不仅存在方法调用开销,更致命的是会指数级重复计算相同子问题。例如计算 fibonacciRecursive(5) 时,fibonacciRecursive(3) 和 fibonacciRecursive(2) 会被反复求解。
若改用循环,可从底向上递推,彻底消除重复计算:
public static long fibonacciIterative(int n) {
    if (n <= 1) {
        return n;
    }

    long previous = 0;
    long current = 1;

    for (int i = 2; i <= n; i++) {
        long next = previous + current;
        previous = current;
        current = next;
    }

    return current;
}
此时两者的差异已超越“函数调用 vs 循环”,而是算法复杂度的根本不同。因此,评估递归与迭代性能时,必须确保两者基于等价或相近的算法思路。
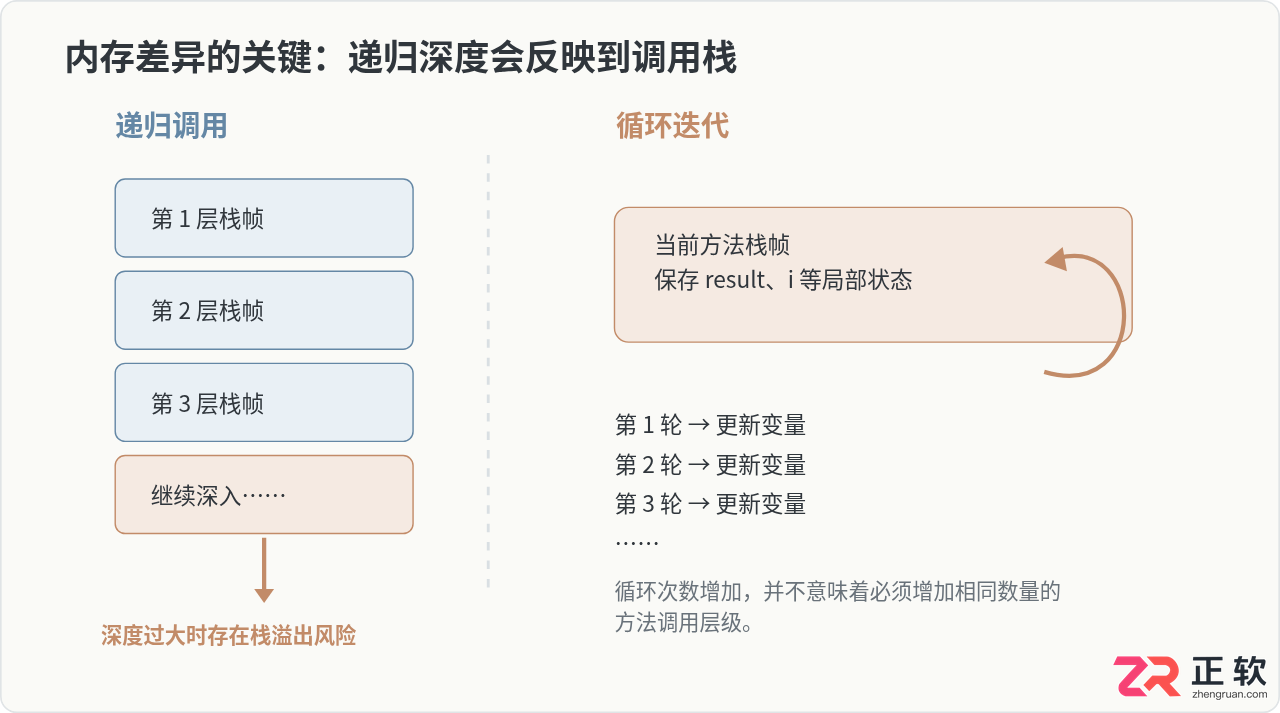
图2:递归深度通常会增加调用栈层数,而普通循环可以在固定方法层级内持续迭代。
三、内存消耗:聚焦线程栈与 StackOverflowError
Java 方法执行强依赖线程调用栈。递归每深入一层,调用栈上就会多保留一个未完成的栈帧。随着深度增加,同时驻留的状态数据呈线性增长。
若递归未能及时命中终止条件,调用栈空间耗尽时将抛出 StackOverflowError。这与堆内存不足(OutOfMemoryError)机制不同,本质是调用栈无法继续容纳新的方法层级。
以下代码演示了无限递归的典型后果:
public class RecursiveErrorExample {

    public static void callAgain() {
        callAgain();
    }

    public static void main(String[] args) {
        callAgain();
    }
}
运行后通常会抛出异常:
Exception in thread "main" java.lang.StackOverflowError
需注意,“最大递归深度”并非固定常量。它受线程栈大小(-Xss 参数)、方法局部变量占用、JVM 实现及操作系统栈限制等多重因素制约。因此,在输入深度不可预测的场景中,盲目使用递归存在隐患。即使当前测试未触发异常,也不能保证生产环境的数据规模绝对安全。
循环就一定不占内存吗?
并非如此。循环同样可能因持续创建对象、扩容集合或维护显式数据结构而消耗大量内存。“循环更省内存”的核心前提是:完成相同简单任务时,它无需为每一轮迭代创建新的方法调用栈帧。
例如将递归深度优先搜索改为迭代时,通常需手动维护一个 Deque。内存开销并未消失,只是从 JVM 隐式管理的调用栈转移到了堆内存中的显式数据结构。
四、树形结构为何偏爱递归
尽管循环在扁平任务中更直接,但面对树形数据时,递归具备极强的表达优势。因为树的定义本身就是递归的:节点包含子节点,子节点又可继续向下延伸。
定义二叉树节点如下:
class TreeNode {
    int value;
    TreeNode left;
    TreeNode right;

    TreeNode(int value) {
        this.value = value;
    }
}
使用递归实现前序遍历极为直观:
public static void preorder(TreeNode node) {
    if (node == null) {
        return;
    }

    System.out.println(node.value);
    preorder(node.left);
    preorder(node.right);
}
代码逻辑与“访问当前节点 → 遍历左子树 → 遍历右子树”的结构完全同构,阅读时无需在脑中模拟状态切换。
若强制改为循环,则需显式维护待处理节点集合:
import java.util.ArrayDeque;
import java.util.Deque;

public static void preorderIterative(TreeNode root) {
    if (root == null) {
        return;
    }

    Deque stack = new ArrayDeque<>();
    stack.push(root);

    while (!stack.isEmpty()) {
        TreeNode node = stack.pop();
        System.out.println(node.value);

        if (node.right != null) {
            stack.push(node.right);
        }

        if (node.left != null) {
            stack.push(node.left);
        }
    }
}
此处的迭代版本并未真正消除“栈”,而是将 JVM 隐式维护的方法调用栈替换为开发者手动管理的 Deque。这也揭示了递归与迭代转换的核心规律:多数递归算法均可改写为循环,但转换过程必须显式还原原本由调用栈自动保存的上下文状态。
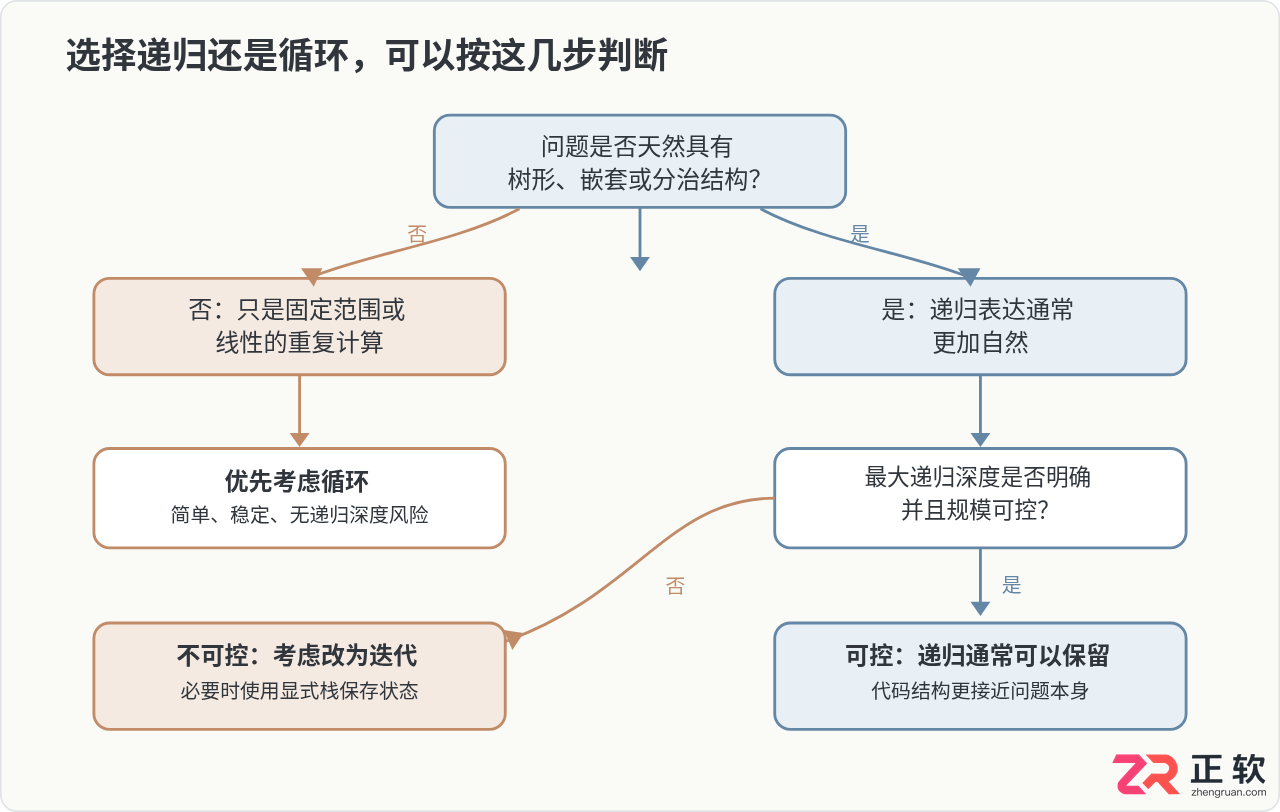
图3:先看问题结构,再判断递归深度是否可控,比单纯比较代码行数更可靠。
五、场景选择指南:何时用循环,何时用递归
选型的核心依据是问题结构与数据规模,而非代码形式的“高级感”。可参考以下判断路径:
优先使用循环的场景
- 1 到 n 的累加或累乘;
- 数组、链表或列表的线性遍历;
- 固定次数的重复操作;
- 寻找序列最大值/最小值;
- 仅需少量局部变量即可维护状态的线性逻辑;
- 预期调用次数极大,且需严格规避栈深度风险。
例如数组求和,循环实现最为自然:
public static int sum(int[] values) {
    int total = 0;

    for (int value : values) {
        total += value;
    }

    return total;
}
强行将此类逻辑改写为递归不仅无法提升可读性,反而会徒增调用层级。
适合考虑递归的场景
- 二叉树、N 叉树等层级结构遍历;
- 目录及子目录的嵌套扫描;
- 快速排序、归并排序等分治策略;
- 组合、排列、路径搜索等回溯算法;
- 解析 JSON/XML 等具有嵌套层级的数据格式。
需注意,“适合递归”不等于“允许无限深度”。若输入可能构造极深的树或嵌套链,仍须评估最坏情况下的栈空间消耗。
六、Java 中的尾递归并非万能解药
部分语言(如 Scala、Scheme)支持尾递归优化(TCO),可将符合条件的递归自动转换为循环执行。尾递归指:递归调用是方法返回前的最后一个操作。
示例如下:
public static long factorialTail(int n, long result) {
    if (n <= 1) {
        return result;
    }

    return factorialTail(n - 1, result * n);
}
尽管该写法通过参数传递累积了中间结果,但在 Java 中,不能将其视为可靠消除栈增长的通用手段。JVM 规范并未强制要求实现 TCO,主流 JIT 编译器也极少对尾递归进行循环化优化。若目标是彻底规避深递归风险,最稳妥的做法仍是直接改写为循环或显式栈。
重要提示: 切勿因尾递归代码在特定环境下未报错,就假设其具备与循环等同的深度承载能力。架构设计应基于明确的深度约束,而非依赖未获保证的底层优化。
七、规范的性能对比步骤
业务中若需评估某段递归是否值得改为循环,切忌仅凭一次 System.currentTimeMillis() 差值下结论。Java 运行时的类加载、JIT 预热、GC 停顿及动态优化极易干扰单次测试结果。
针对微小代码片段的性能对比,建议使用 JMH 等 JVM 微基准测试框架。若仅用于学习验证,可遵循以下标准化流程:
步骤1:准备等价实现
public class RecursionVsLoop {

    public static long sumRecursive(long n) {
        if (n <= 0) {
            return 0;
        }
        return n + sumRecursive(n - 1);
    }

    public static long sumIterative(long n) {
        long total = 0;

        for (long i = 1; i <= n; i++) {
            total += i;
        }

        return total;
    }

    public static void main(String[] args) {
        System.out.println(sumRecursive(1000));
        System.out.println(sumIterative(1000));
    }
}
步骤2:验证结果一致性
编译运行后,确认两者输出一致。仅在算法目标与计算结果等价的前提下,后续的性能对比才具备参考价值。
示例输出: 500500 500500
步骤3:逐步放大输入规模,探测边界
递增 n 的值,观察递归版本何时触发栈深度限制。此步骤的目的并非测定某台机器的“绝对上限”,而是验证一个关键事实:循环可安全执行的迭代次数,绝不等于同等深度的递归也必然安全。
步骤4:生产决策采用规范基准
当结论将直接影响线上代码时,必须在目标运行环境中使用专业微基准工具进行测试。对比数据应基于真实业务输入,而非为证明某种写法更快而构造的特殊数据集。
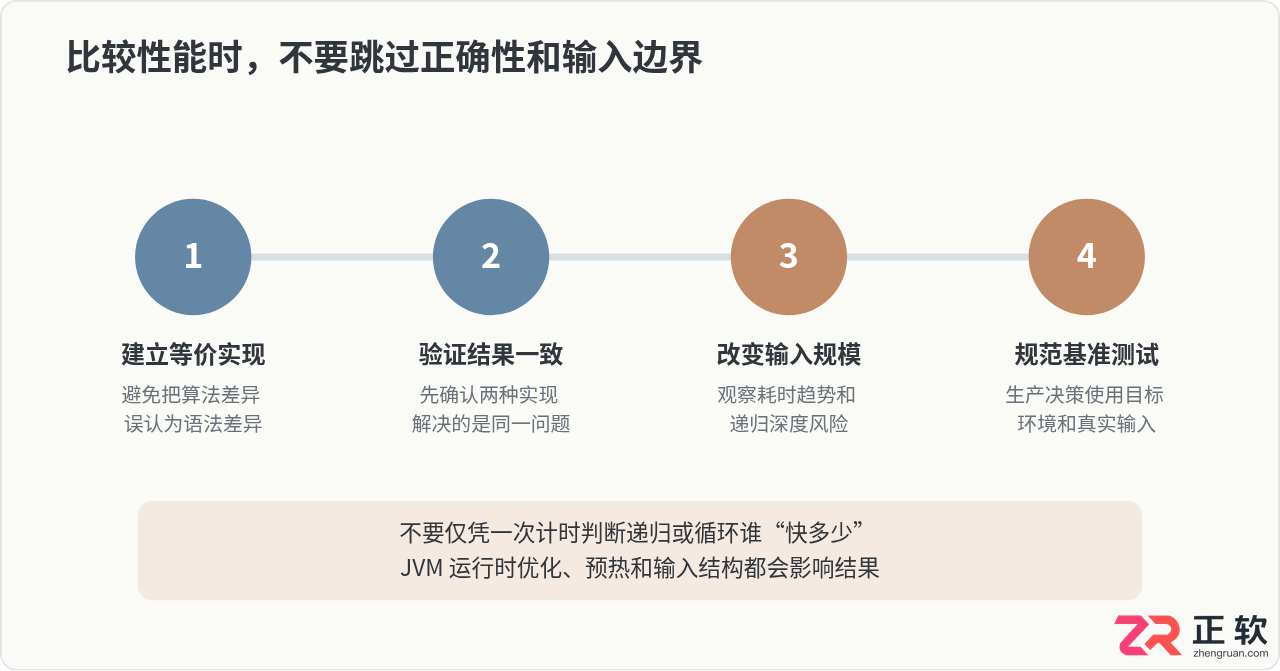
图4:性能比较应先保证算法和结果可比,再观察规模变化,生产决策则需要更规范的基准测试。
八、递归转循环的核心思路
简单的尾递归改写为循环通常只需提取循环变量即可。但面对树遍历、回溯或分治逻辑,不能仅用 for 替换方法调用。
递归调用本质上是替开发者自动保存了执行现场:当前处理到哪个节点、返回后应继续执行哪条分支等。改为迭代时,这些状态必须由代码显式接管。
转换过程可拆解为以下步骤:
- 明确递归的终止条件;
- 梳理每一层调用需要保留的关键状态;
- 判断是否仅需基础变量即可承载(适用于线性逻辑);
- 若存在多分支或需回溯,引入栈、队列等集合保存待处理任务;
- 循环消费任务集合,直至为空或满足终止条件。
前文树遍历迭代版引入 Deque 的原因正在于此:循环必须显式记录“哪些节点尚未访问,需留待后续处理”。
九、常见技术误区澄清
1. 递归代码更短,所以性能一定更好?
不成立。代码行数与运行成本无直接关联。递归虽能简化树形算法的表达,但仍需承担调用栈开销与深度风险。
2. 循环一定比递归占用更少的总内存?
不能绝对化。简单线性计算中,循环确实无需随迭代增加栈帧;但复杂算法的迭代实现往往需要额外集合(如显式栈、队列、缓存表)维护状态。应评估完整算法的内存分布,而非仅关注是否使用了 for。
3. 树遍历既然能写成循环,就应该全部替换?
无必要。若树的深度明确可控,递归代码更贴近业务语义,且性能并非瓶颈,保留递归是合理选择。仅当深度不可控、栈风险显著或性能剖析明确指出该处为热点时,才具备充分的改写动机。
4. 出现 StackOverflowError,调大 -Xss 即可根治?
扩大栈空间仅能延缓异常发生,并未解决算法层面的深度失控问题。若递归深度由外部数据驱动且可能持续增长,应优先审查算法设计或转为显式迭代,而非依赖参数调优掩盖隐患。
十、核心差异速查表
| 比较维度 | 递归实现 | 循环迭代 |
|---|---|---|
| 执行机制 | 方法调用自身,逐层压栈后逐层返回 | 在当前控制流内重复执行代码块 |
| 调用开销 | 存在方法调用与栈帧分配成本 | 简单循环通常无额外调用开销 |
| 调用栈占用 | 随递归深度线性增长 | 普通循环不因迭代次数增加方法层级 |
| 深度风险 | 深度过大易触发 StackOverflowError |
无递归栈溢出风险,但需关注算法自身内存消耗 |
| 代码表达 | 高度契合树、分治、回溯、嵌套结构 | 适合线性遍历、累加、固定频次任务 |
| 状态维护 | 部分上下文由 JVM 调用栈自动保存 | 复杂逻辑需手动维护栈、队列或状态变量 |
| 选型重心 | 问题结构天然递归且最大深度可控 | 数据规模大、深度不可预测或属简单线性任务 |
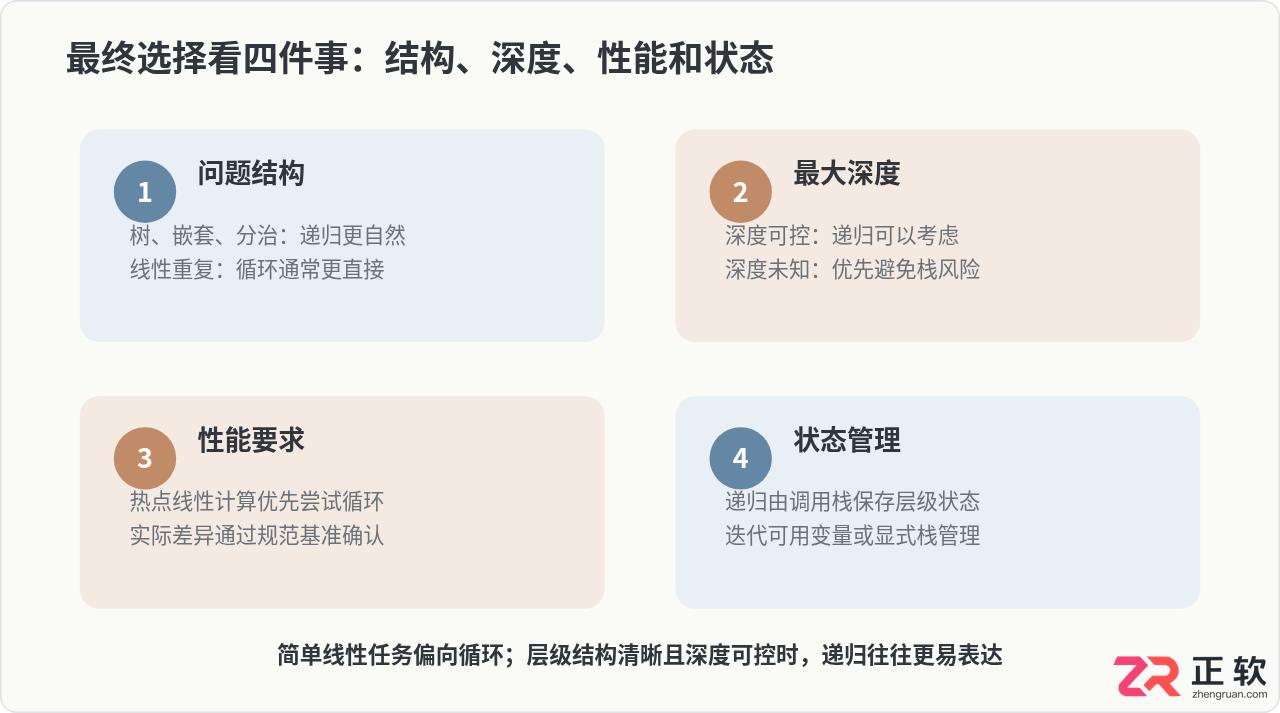
图5:递归和循环没有统一胜负,选择时重点考虑问题结构、递归深度、性能需求与状态管理方式。
结语
Java 中的递归与循环并非互斥对立的技术路线。多数递归逻辑均可转换为迭代,而部分复杂的迭代逻辑有时借助递归反而能大幅提升可读性。
对于数组遍历、累计计算、固定次数处理等线性任务,循环是更直接且稳健的选择。它无需随执行次数扩张调用栈,方法调用成本也更低。面对树遍历、目录扫描、分治与回溯等具备明确层级关系的问题,递归能让代码结构高度贴合问题本质,前提是开发者能准确评估并控制最大递归深度。
工程实践中应避免“递归慢、循环快”的片面结论。正确的决策路径是:首先确认两种实现是否基于等价算法,其次评估调用深度与内存边界,最后结合目标运行环境与性能剖析结果判断优化必要性。 唯有如此,才能在代码清晰度、执行效率与系统稳定性之间取得最佳平衡。










火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,