


MySQL分组统计函数有哪些及常用写法详解

一个可视化的工具,可以用在脑力风暴(brainstorm)和计划(plan)当中。提供给商务人士一个更有效的、电子化的手段来进行捕捉、组织和联系信息(information)和想法(idea)。
系统梳理MySQL常用分组统计函数COUNT、SUM、AVG、MAX、MIN与GROUP_CONCAT的具体用法、执行机制、NULL值处理与常见避坑指南。
在日常业务开发与数据统计中,按特定维度对数据聚合汇总是一项核心任务。MySQL中的分组统计基于GROUP BY子句,配合聚合函数(Aggregate Functions)将多行数据折叠为单一维度的汇总结果。本文将系统梳理MySQL中支持的核心分组统计函数(COUNT、SUM、AVG、MAX、MIN以及专用的GROUP_CONCAT),详解其运行机制、标准写法与生产环境中高频踩坑的边界细节。
一、SQL分组执行模型:聚合函数如何工作
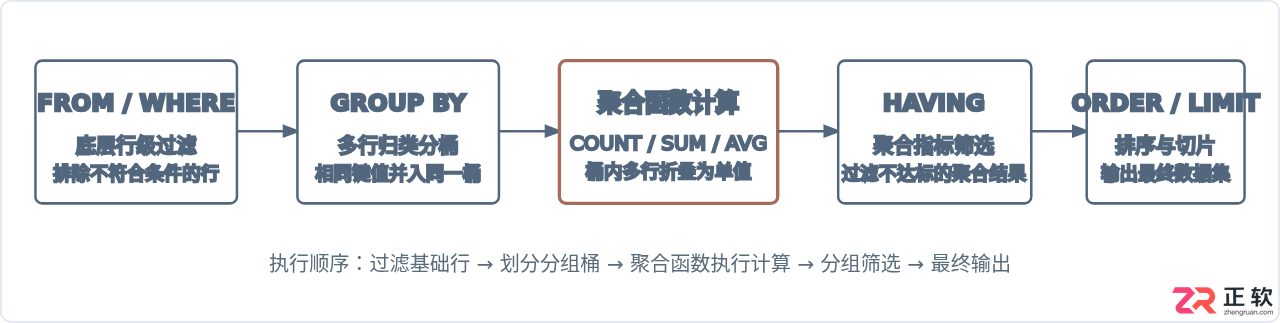
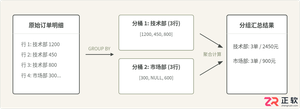
理解聚合函数的写法,前提是理清SQL引擎的处理顺序。很多初学者容易混淆WHERE与HAVING,根源就在于不清楚分组聚合到底发生在哪一步。当一条包含分组统计的SQL执行时,数据库并非先挑出统计结果,而是依次完成过滤、分桶、折叠计算与再次筛选。
二、常用分组统计函数及其实战写法
为了直观说明各函数用法,我们假设存在一张电商订单表 orders,其结构包含:order_id(订单编号)、dept_name(销售部门)、user_id(用户ID)、amount(订单金额,可为NULL)、bonus_points(积分)与 status(状态)。
1. 记录计数:COUNT()
COUNT()用于统计符合条件的行数或列中非NULL值的个数。主要存在三种写法:
COUNT(*):统计所有返回的行数,即使整行字段均为NULL也会被计入。在现代InnoDB引擎中,COUNT(*)与COUNT(1)经过优化器处理后效率等同。COUNT(列名):仅统计指定列非NULL的记录数。如果某行对应的该列为NULL,则计数不加1。COUNT(DISTINCT 列名):统计去重后的非NULL记录数,常用于统计去重活跃用户(UV)。
-- 统计各部门订单总条数、有支付金额的有效订单数、下单客户去重总数
SELECT
    dept_name,
    COUNT(*) AS total_orders,
    COUNT(amount) AS paid_orders,
    COUNT(DISTINCT user_id) AS unique_buyers
FROM orders
GROUP BY dept_name;
2. 数值求和:SUM() 与 均值计算:AVG()
SUM(列名) 计算指定列所有非NULL值的总和;AVG(列名) 计算平均值。两者的关键机制是:它们在计算时都会完全忽略NULL值。
这一机制导致了一个非常经典的业务误区:AVG(amount) 的分母是“包含非NULL金额的订单数”,而不是“该部门的所有订单总数”。如果需要把未支付(NULL)算作0元参与均摊,必须显式结合 COALESCE 或 IFNULL。
SELECT
    dept_name,
    -- 部门总成交金额(NULL自动被跳过)
    SUM(amount) AS total_revenue,
    -- 仅对有付款记录的订单算平均额
    AVG(amount) AS avg_paid_amount,
    -- 将NULL视作0元,拉平到所有订单维度计算平均额
    AVG(COALESCE(amount, 0)) AS avg_overall_amount
FROM orders
GROUP BY dept_name;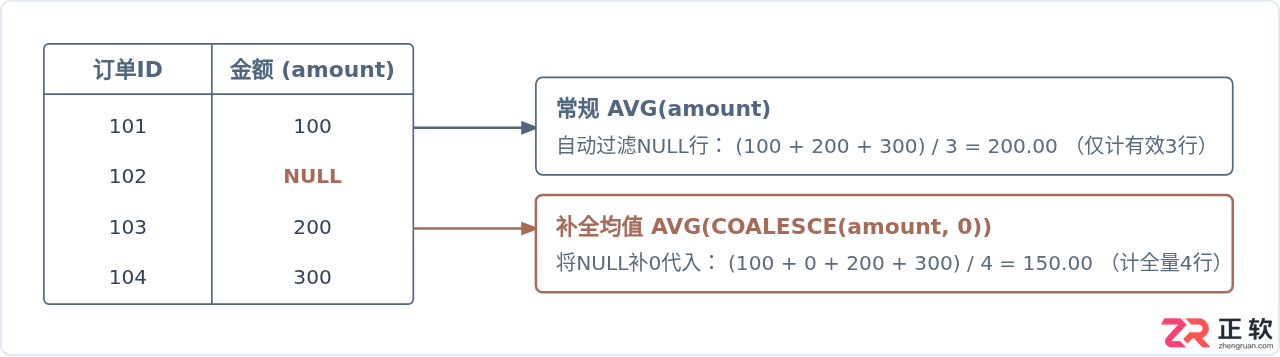
3. 极值检测:MAX() 与 MIN()
MAX()与MIN()用于检索桶内的最大值与最小值。除了常规的数值类型外,它们也完全适用于日期时间类型(如检索部门最早创单时间、最后活跃时间)以及字符串类型(按照字典排序规则比对)。与上述函数一样,它们在比对过程中自动忽略NULL。
SELECT
    dept_name,
    MIN(created_at) AS first_order_time,
    MAX(created_at) AS latest_order_time,
    MAX(amount) AS highest_sale
FROM orders
GROUP BY dept_name;
4. 分组拼接:GROUP_CONCAT()
在报表输出中,经常有将“某个分组下的所有子项以逗号拼成一列”的需求,MySQL提供了功能强大的GROUP_CONCAT()。它不仅支持拼接,还内置了去重(DISTINCT)、组内排序(ORDER BY)以及自定义分隔符(SEPARATOR)功能。
SELECT
    dept_name,
    -- 将该部门买家ID按倒序排重拼接,以竖线分隔
    GROUP_CONCAT(DISTINCT user_id ORDER BY user_id DESC SEPARATOR ' | ') AS buyer_list
FROM orders
GROUP BY dept_name;GROUP_CONCAT() 拼接后的文本长度受系统变量 group_concat_max_len 限制,默认通常为 1024 字节。如果分组内数据量过大,多余数据会被无警告截断。若拼接长内容,需提前调整:SET SESSION group_concat_max_len = 1048576;(设置为1MB)。
三、条件统计模式:聚合函数与 CASE WHEN 联动
在实际业务中,我们往往需要在一条查询中同时统计出“全部订单量”、“已支付订单量”以及“退款订单量”。如果多次执行不同的SQL或者多层JOIN,开销极大。行业通用的标准做法是在聚合函数内部嵌套 CASE WHEN 表达式。
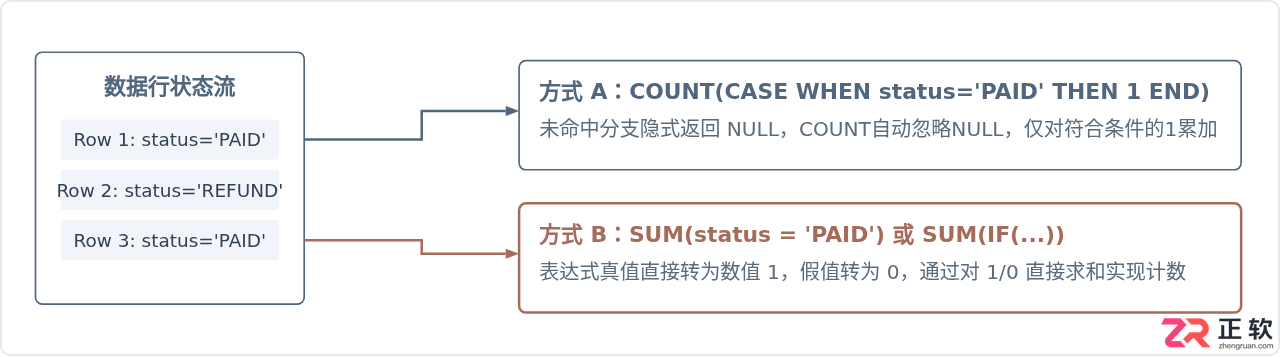
掌握这两种写法的差异极为关键:
- 若使用
COUNT,未命中条件的必须为NULL(CASE WHEN ... THEN 1 ELSE NULL END,可省略ELSE,默认即NULL)。若写成ELSE 0,由于0是非NULL值,仍会被COUNT计入行数导致失真! - 若使用
SUM,可以充分利用MySQL的布尔上下文。表达式status = 'PAID'命中时返回1,未命中返回0,直接通过SUM(status = 'PAID')即可完成优雅统计。
SELECT
    dept_name,
    COUNT(*) AS total_orders,
    -- 方式一:利用 COUNT 忽略 NULL 的特性
    COUNT(CASE WHEN status = 'PAID' THEN 1 END) AS paid_count,
    -- 方式二:利用布尔值自动转为 1 / 0 的特性直接 SUM
    SUM(status = 'REFUND') AS refund_count,
    -- 组合运算:只累加已支付订单的总金额
    SUM(CASE WHEN status = 'PAID' THEN amount ELSE 0 END) AS paid_revenue
FROM orders
GROUP BY dept_name;
四、核心注意事项与易错避坑指南
1. WHERE 与 HAVING 的界限
初学者极易在 WHERE 里引用聚合函数(例如:WHERE COUNT(1) > 5),这在SQL底层会直接报错。原因正如前文图1所示:WHERE 阶段发生在“聚合计算”之前,此时分组尚未形成,聚合值压根不存在。凡是针对聚合函数结果的过滤,必须使用 HAVING。
-- 正确写法:先用WHERE过滤行,分组聚合后用HAVING过滤统计指标
SELECT
    dept_name,
    COUNT(*) AS order_count,
    SUM(amount) AS total_amount
FROM orders
WHERE created_at >= '2026-01-01'  -- 行级过滤:排除历史数据
GROUP BY dept_name
HAVING total_amount > 50000;      -- 分组指标过滤:仅保留总额超5万的部门
2. ONLY_FULL_GROUP_BY 模式约束
在 MySQL 5.7 及以后的默认配置中,SQL模式开启了 ONLY_FULL_GROUP_BY。该约束规定:SELECT 列表中出现的非聚合字段,必须全部出现在 GROUP BY 子句中。
如果写 SELECT dept_name, user_id, COUNT(*) FROM orders GROUP BY dept_name;,数据库无法确定每个部门中该抽取哪一个 user_id 输出,从而直接抛出 1055 错误。解决办法是:要么将该列加入 GROUP BY,要么使用 ANY_VALUE(user_id) 显式指定接受任意值,要么使用 GROUP_CONCAT(user_id) 折叠展示。
五、函数特性横向总结
为了便于速查与技术决策,下表总结了本文涉及的六个分组聚合函数的关键特性:
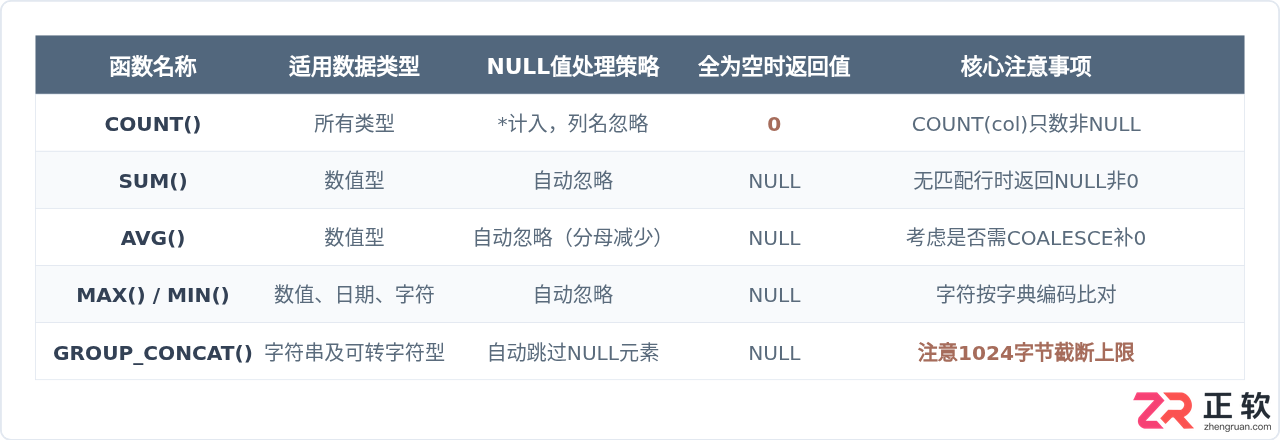
熟练运用上述六大聚合函数,并掌握它们与 GROUP BY、HAVING 以及 CASE WHEN 条件表达式的配合,足以应对绝大多数常规报表统计与复杂指标计算。在书写SQL时,始终牢记数据中 NULL 值的存在,是避免统计结果与实际业务预期发生偏差的关键底线。







WPS Office是一款面向macOS用户的综合办公套件,将文字处理、电子表格、演示文稿、PDF工具、模板与云协作整合在同一应用中。它兼容常见Microsoft Office格式,支持Intel及Apple芯片Mac,基础功能可免费使用,

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Ableton Live 是面向音乐制作人与现场表演者的数字音频工作站,提供编曲视图、独具特色的现场视图、音频录制、MIDI创作、实时变速、乐器及效果器。Mac版原生支持Apple芯片,并可连接音频接口、MIDI控制器和第三方插件。

Adobe After Effects 是面向动态图形、影视特效与视频合成的专业创作软件。它提供关键帧动画、遮罩抠像、运动跟踪、三维空间、文字动画和表达式等工具,并可与 Premiere Pro、Photoshop、Illustrator

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Adobe Bridge 是面向摄影师、设计师及内容团队的免费数字资产管理工具,可集中预览照片、视频和 Adobe 项目文件,并利用评级、标签、关键词、元数据、筛选与收藏集完成分类检索。它还支持批量重命名、格式导出、相机导入及 Camera

Adobe Illustrator 是 Adobe 推出的专业矢量图形设计软件,适合在 Mac 上制作标志、图标、插画、包装、信息图及印刷版面。它以路径和锚点构建可无损缩放的图形,并提供钢笔、形状、文字、图像描摹、渐变、画板及生成式功能。

Adobe InDesign 是面向印刷品与数字出版物的专业版面设计软件,可在 Mac 上制作书籍、杂志、宣传册、海报、报告及交互式文档。它提供精细的文字样式、网格、母版、长文档管理和印前输出能力。

Adobe Lightroom Classic 是面向桌面摄影工作流的照片管理与后期处理软件,可将原始照片保存在本地硬盘,通过目录、关键词、评分和收藏夹高效整理图库,并提供 RAW 冲印、蒙版、镜头校正、批量同步及多格式导出等功能。

Adobe Media Encoder 是 Adobe 推出的专业音视频编码与转码工具,可通过队列、预设和监视文件夹批量完成格式转换、代理文件创建及多平台成片输出,并与 Premiere Pro、After Effects 等软件紧密协作。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理软件,提供图层、蒙版、选区、修复、调色、文字排版、智能对象及生成式编辑等能力。Mac 版支持 Intel 与 Apple Silicon 处理器。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理工具,可在 Windows 上完成照片修饰、选区抠图、图层合成、文字排版、绘画及生成式编辑。软件采用订阅授权,由 Creative Cloud 管理安装、更新与许

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。

Adobe Bridge 是 Adobe 推出的创意资产管理工具,可集中预览、分类和查找照片、视频、PDF及多种设计文件,并支持元数据、关键词、评级、批量重命名和格式导出。它可与 Photoshop、Illustrator 等应用衔接,

Affinity Photo 是一款面向摄影师、修图师和视觉设计人员的桌面图像编辑工具,提供 RAW 显影、多图层合成、蒙版、实时滤镜、批处理和色彩管理等功能。原独立产品已停止销售,其照片编辑能力已延续至免费的新 Affinity 应用;

Adobe Lightroom Classic 是面向 Windows 桌面摄影工作流的照片管理与无损编辑工具,可通过目录集中整理大型图库,并完成 RAW 显影、局部蒙版、批量调整、打印和多格式导出。它强调本地文件管理与精细控制,

Figma 是面向产品设计与开发团队的云端协作平台,可在 Windows 桌面客户端中完成界面绘制、组件管理、交互原型、评论评审和开发交付。文件保存在云端,多名成员能够同步编辑并共享设计系统;官方同时提供免费 Starter 方案及按席位计

Affinity Designer 是面向矢量图形、数字插画和界面设计的专业创作工具,可在矢量、像素与导出工作区之间快速切换。它提供曲线编辑、形状构建、画板、排版、图层和专业色彩管理,并支持常见设计文件的导入及多种印刷、网页格式输出。

Capture One Pro 是面向摄影师和影像团队的专业桌面照片处理工具,提供相机定制色彩配置、RAW转换、图层与蒙版、联机拍摄、目录及会话管理等功能。它适合棚拍、人像、商业产品、婚礼和风光摄影,

Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,

Adobe After Effects 是面向动态图形、动画与影视视觉特效制作的专业工具,可完成关键帧动画、图层合成、遮罩跟踪、抠像、文字动画和二维三维元素整合。Windows 版通过 Adobe Creative Cloud 安装及更新,

DaVinci Resolve是Blackmagic Design推出的一体化影视后期工具,将素材管理、非线性剪辑、专业调色、Fusion视觉特效、Fairlight音频处理和成片交付整合在统一工程中。免费版已覆盖多数个人创作需求,