


pandas的数据格式怎么转换和设置方法教程
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
Pandas 读取数据时默认依赖推断机制,这往往导致整数列被读作浮点数,或长文本占用过多内存。类型不匹配不仅是显示问题,更是后续计算报错和内存溢出的根源。理解转换机制而非机械调用函数,是构建稳定数据管道的第一步。
为什么自动推断会失效
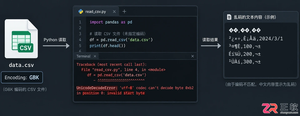
Pandas 的 read_csv 或 DataFrame 构造函数在初始化时会扫描前几行数据以猜测类型。如果某列包含缺失值 NaN,Pandas 通常会将整数列升级为 float64,因为原生 NumPy 整数类型不支持空值。此外,混合了数字和特殊字符(如 "1,000" 或 "N/A")的列会被直接判定为 object 字符串类型。
这种隐式转换在数据量较小时不可见,但在大规模聚合或连接操作时,object 类型会导致向量化操作失效,迫使 Pandas 退化为缓慢的逐行循环。更严重的是,浮点数精度问题可能在金额计算中引入微小误差,最终影响业务报表的准确性。
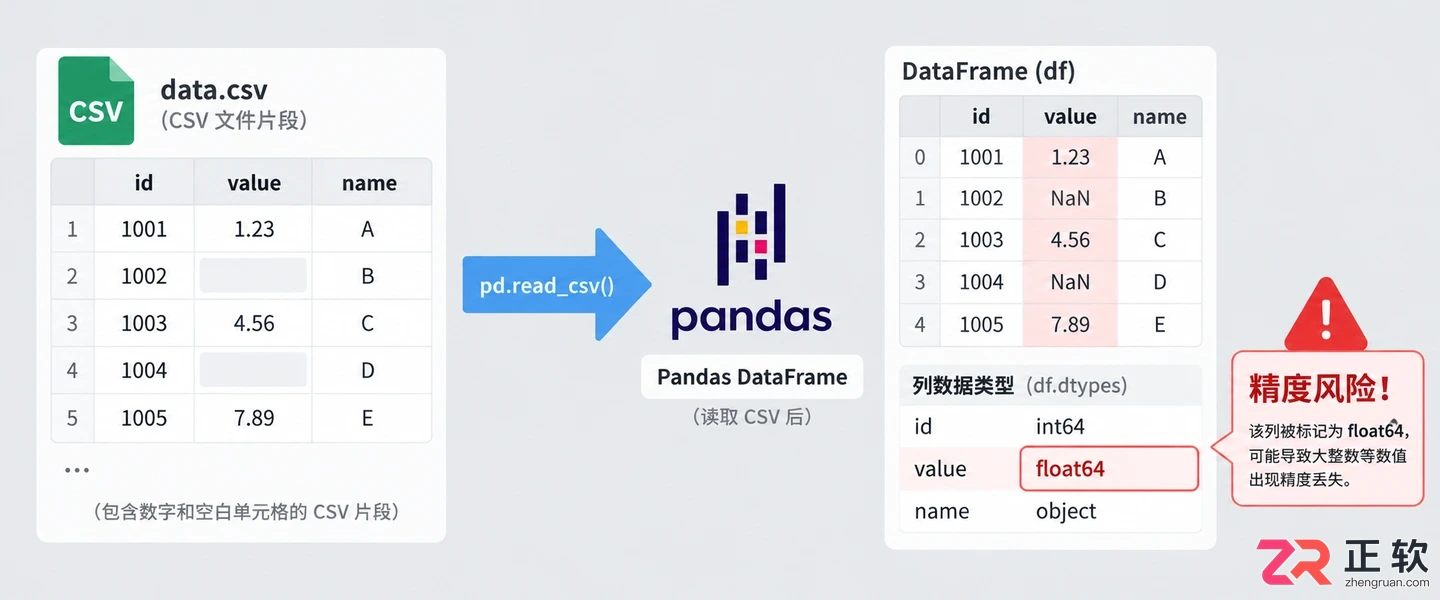
自动推断机制将含空值的整数列误判为浮点型
核心转换方法的因果逻辑
修正类型不能仅靠 astype 一把梭,需根据数据脏污程度选择策略。
1. 使用 astype 进行强制映射
当数据干净且目标类型明确时,astype 是最直接的工具。它执行严格的类型转换,遇到无法解析的值会直接抛出异常。
import pandas as pd

df = pd.DataFrame({'id': ['1', '2', '3'], 'score': ['90', '85', '88']})

# 正确用法:确保所有值均可转换
df['id'] = df['id'].astype(int)
df['score'] = df['score'].astype(float)

print(df.dtypes)
输出结果显示 id 变为 int64,score 变为 float64。若数据中存在空字符串或非数字字符,此步骤将中断执行。因此,astype 适用于清洗后的数据或已知规范的输入源。
2. 使用 to_numeric 处理脏数据
对于可能包含噪声的数值列,pd.to_numeric 提供了 errors 参数来控制行为。设置为 'coerce' 时,无法解析的值会被转换为 NaN,而不是报错。
raw_data = pd.Series(['100', '200', 'error', '300'])

# 将不可转换值设为 NaN
clean_data = pd.to_numeric(raw_data, errors='coerce')

print(clean_data)
输出中 "error" 变为 NaN,其余保持数值类型。这一步是数据清洗的关键环节,它允许我们在转换过程中识别并隔离异常值,随后再决定是填充还是删除。
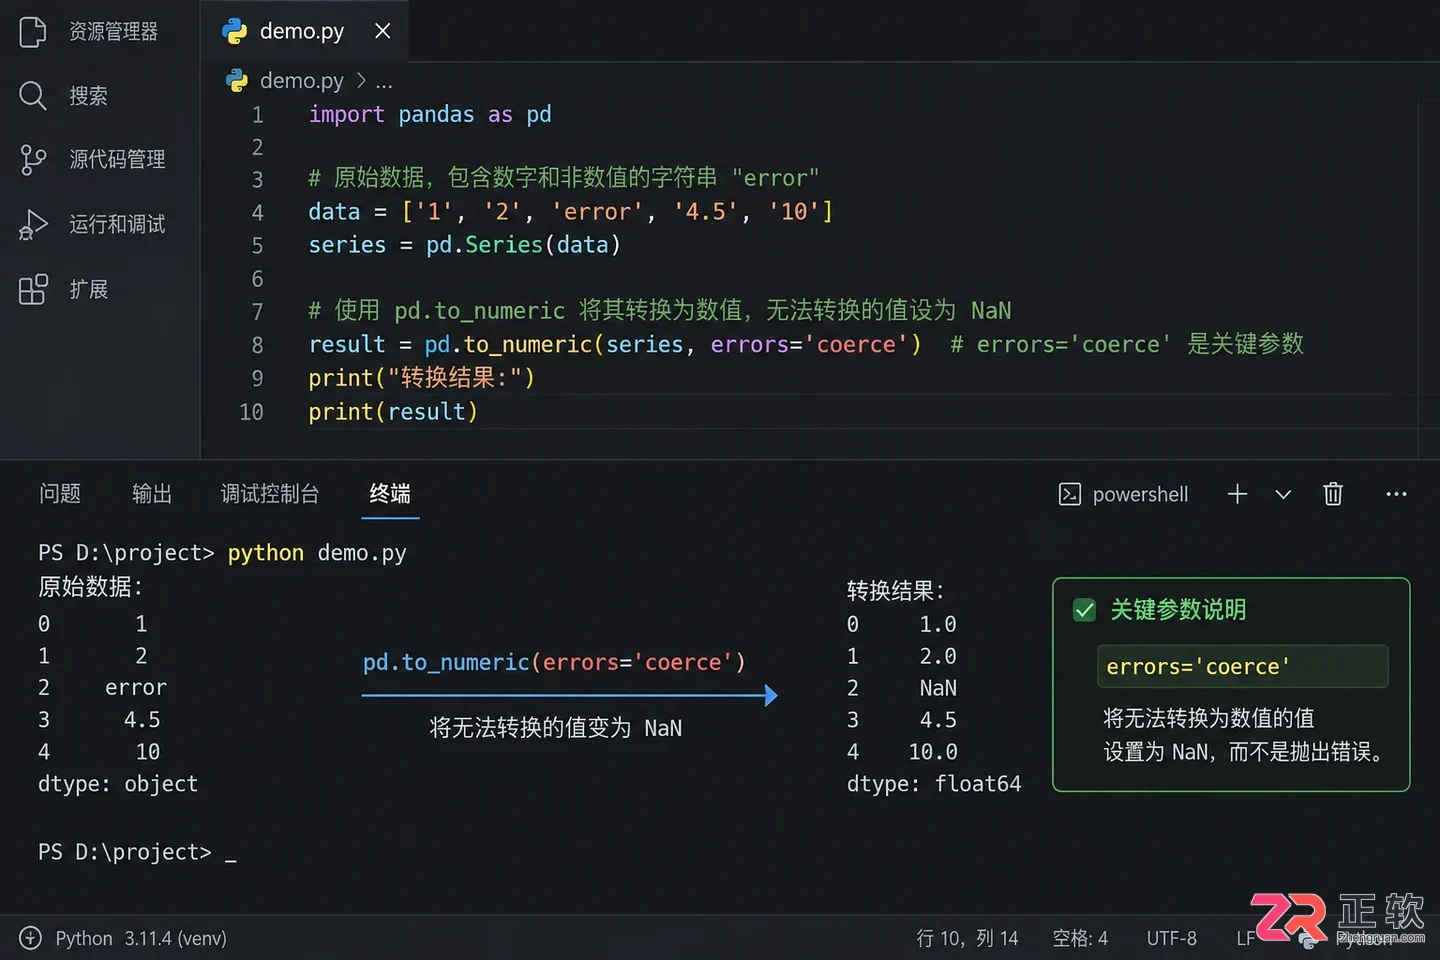
使用errors='coerce'将非法值转换为NaN
3. 使用 convert_dtypes 优化内存
Pandas 1.0+ 引入了 nullable 数据类型(如 Int64, string)。convert_dtypes() 方法能自动将列转换为这些新类型,它们原生支持缺失值,无需将整数升级为浮点数。
df_mixed = pd.DataFrame({'a': [1, 2, None], 'b': ['x', 'y', 'z']})

df_optimized = df_mixed.convert_dtypes()

print(df_optimized.dtypes)
输出显示列 a 变为 Int64(注意大写 I),列 b 变为 string。这不仅保留了整数语义,还显著降低了内存占用,特别是在处理大量分类文本时。
特定场景的精准控制
通用转换之外,日期和分类数据需要专门的解析逻辑。
1. 日期时间的解析陷阱
不要手动分割字符串来构建日期。使用 pd.to_datetime 并指定 format 参数可以大幅提升解析速度并避免歧义。
dates = pd.Series(['2023-01-01', '2023-02-15'])

# 指定格式加速解析
dt_series = pd.to_datetime(dates, format='%Y-%m-%d')
若日期格式复杂或不统一,可省略 format,但需接受性能损耗。解析后的 datetime64 类型支持直接提取年、月、日等属性,这是字符串类型无法做到的。
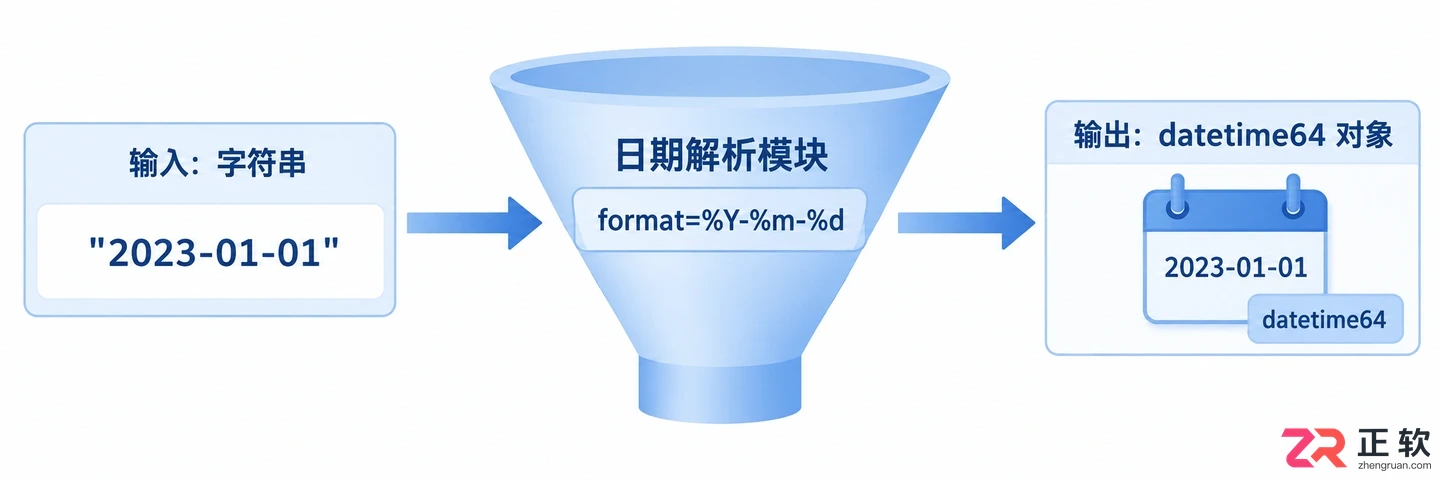
指定format参数提升日期解析效率
2. 分类数据的内存压缩
对于基数较低(唯一值较少)的字符串列,转换为 category 类型可将内存占用降低一个数量级。
gender = pd.Series(['Male', 'Female', 'Male', 'Female'] * 1000)

gender_cat = gender.astype('category')

print(f"原始内存: {gender.memory_usage(deep=True)} bytes")
print(f"分类内存: {gender_cat.memory_usage(deep=True)} bytes")
输出对比会显示显著的内存节省。但需注意,分类类型不适合高基数列(如用户 ID),因为其内部字典维护成本可能超过节省的空间。
何时停止转换
并非所有列都需要严格类型化。如果某列仅用于展示或作为唯一标识符(如 UUID),保持 object 或 string 类型即可。过度优化类型会增加代码复杂度,且在频繁修改数据时可能带来类型冲突的维护成本。
数据类型的选择本质上是内存、计算速度与开发便利性之间的权衡。在 ETL 流程的入口阶段完成一次性转换,并在后续操作中保持类型稳定,是避免隐性 Bug 的最佳实践。
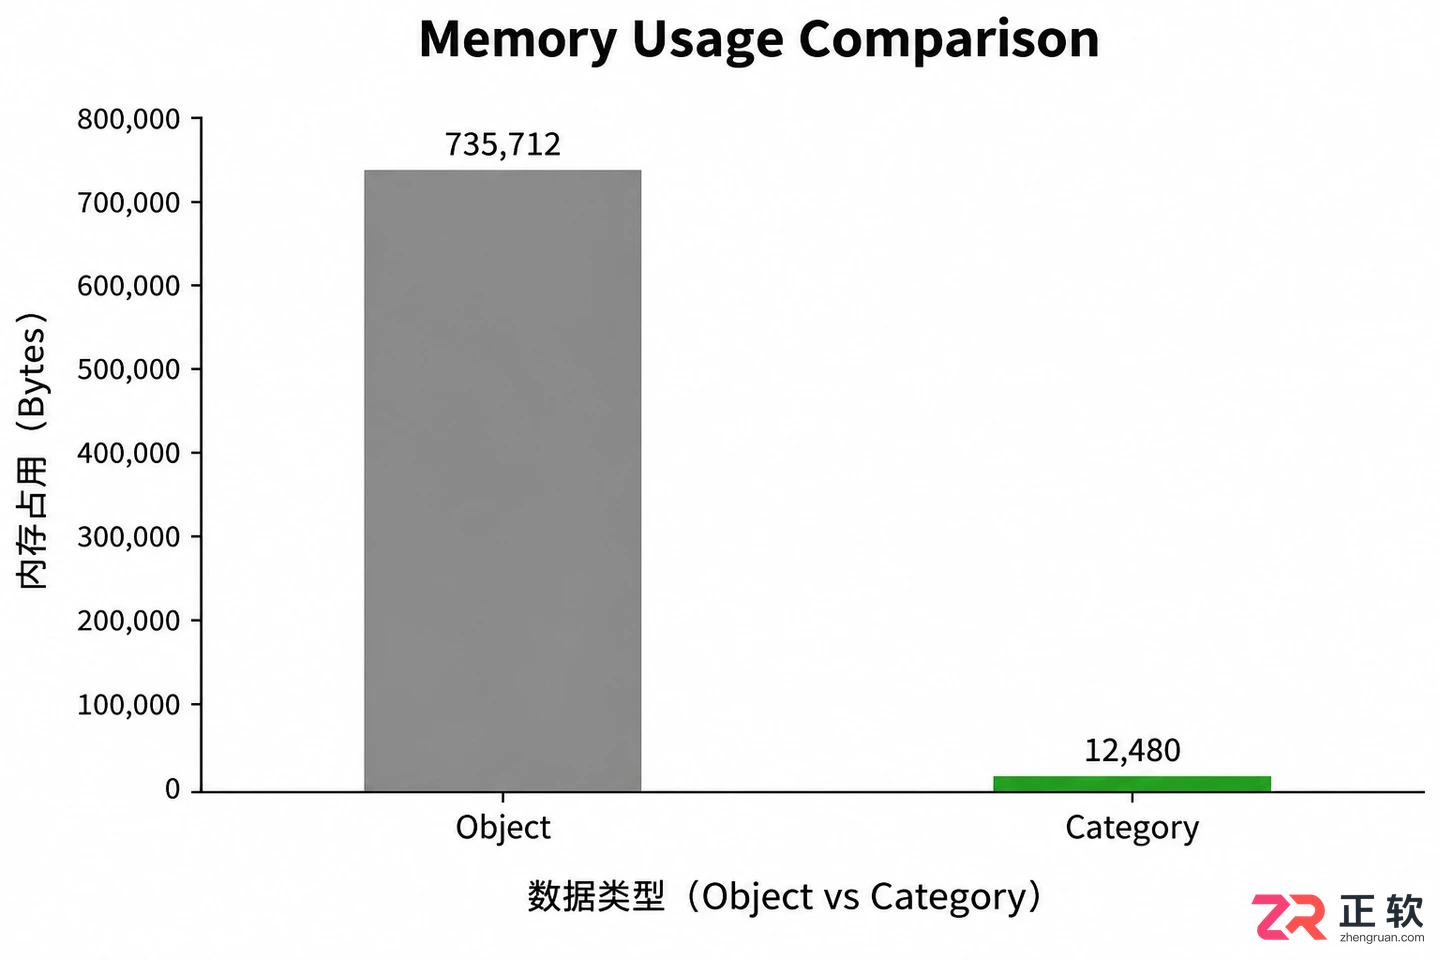
category类型显著降低高重复字符串列的内存占用





Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。