


n8n部署配置要求详解及硬件环境说明
详细解读n8n自动化平台的部署配置要求,涵盖CPU、内存、存储及数据库选型建议,帮助开发者根据业务规模合理规划硬件环境,避免资源浪费或性能瓶颈。
在开始搭建 n8n 自动化工作流平台时,许多开发者容易陷入一个误区:认为只要容器能跑起来,配置就足够了。实际上,n8n 的资源消耗具有极强的弹性,它既可以在一台 512MB 内存的微型服务器上安静地运行几个定时任务,也可能在高峰期吃掉几核 CPU 和数 GB 内存来处理高并发数据同步。理解 n8n 部署配置要求的核心,不在于背诵官方推荐的最低参数,而在于理解其执行模型与数据流转机制对硬件的具体映射关系。
核心计算资源:CPU 与内存的动态平衡
n8n 基于 Node.js 构建,这意味着它的单线程事件循环模型决定了其在处理大量并行 I/O 操作时表现优异,但在执行密集的计算任务或复杂 JavaScript 代码节点时,容易成为瓶颈。对于大多数以 API 调用、数据转换和 Webhook 接收为主的工作流,CPU 的使用率通常较低且呈现脉冲式特征。
然而,内存是更关键的约束条件。n8n 在执行工作流时,会将整个执行过程中的数据加载到内存中。如果一个工作流处理包含数万条记录的大型 JSON 数组,或者在多个节点间传递未经过滤的二进制文件,内存占用会瞬间飙升。因此,配置内存时不能仅看空闲状态,必须预留足够的缓冲以应对峰值负载。
// 示例:一个可能导致内存激增的简单逻辑
// 如果 items 数组包含 10万+ 对象,此操作将在内存中创建巨大副本
const largeDataset = $input.all();
const processedData = largeDataset.map(item => {
  return {
    json: {
      ...item.json,
      enrichedField: heavyComputation(item.json.id) // 耗时且占内存
    }
  };
});
return processedData;
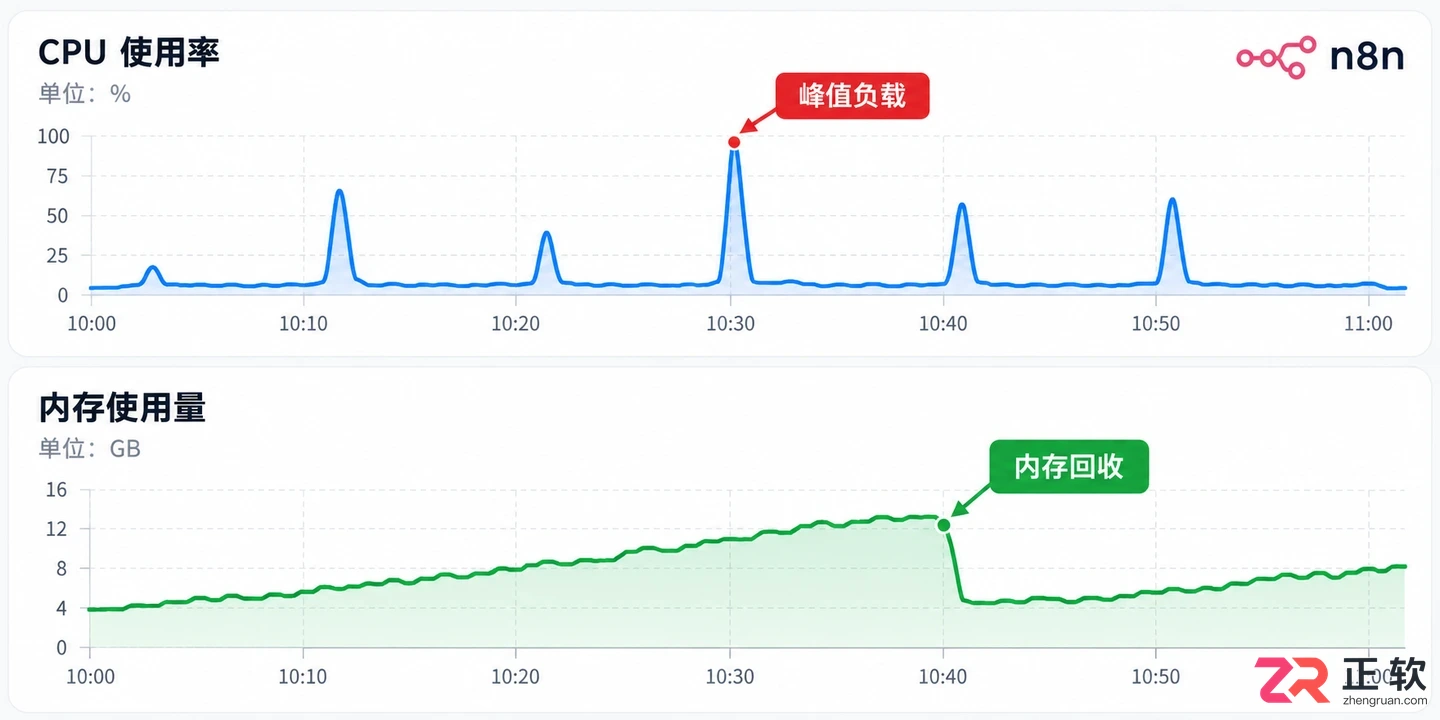
n8n 处理大数据集时的资源波动示意
在生产环境中,建议起步配置至少为 2 vCPU 和 4GB RAM。这个组合足以支撑中等复杂度的工作流和适度的并发。如果主要运行轻量级通知或简单的 CRUD 操作,1 vCPU 和 2GB RAM 也能胜任,但需密切监控 OOM(Out Of Memory)风险。值得注意的是,Node.js 进程默认有内存限制,虽然 n8n 会尝试优化,但在极端情况下,增加物理内存比单纯增加 CPU 核心数更能提升稳定性。
存储子系统:I/O 性能与执行历史
n8n 的存储需求主要分为两部分:应用程序本身及其依赖库,以及执行历史数据。前者占用空间固定且较小,通常在几百 MB 级别;后者则是随时间线性增长的变量,也是影响磁盘 I/O 性能的关键因素。
默认情况下,n8n 将执行数据存储在 SQLite 数据库中。SQLite 是一个基于文件的数据库,其读写性能直接依赖于磁盘的 I/O 吞吐能力。在高并发写入场景下,机械硬盘(HDD)极易成为瓶颈,导致工作流执行延迟甚至超时。因此,无论规模大小,强烈建议使用 SSD 作为 n8n 的数据盘。
此外,执行历史的保留策略直接影响存储增长速度。如果不对旧数据进行清理,几个月后数据库文件可能膨胀至数 GB,不仅占用空间,还会拖慢查询速度。合理的做法是结合业务需求,设置执行数据的过期时间,或将高频访问的热数据与归档的冷数据分离。
数据库选型:从 SQLite 到 PostgreSQL 的跨越
这是 n8n 部署配置中最具决定性的架构选择。官方文档明确指出,SQLite 仅适用于开发和小型个人使用。一旦进入生产环境,尤其是涉及多实例部署或高并发写入时,PostgreSQL 是必然的选择。
切换到 PostgreSQL 不仅仅是更换一个数据库地址,它改变了 n8n 的资源依赖结构。首先,你需要为 PostgreSQL 单独分配资源。一个稳定的 PostgreSQL 实例通常建议至少配备 1-2 vCPU 和 2-4GB 内存,具体取决于连接数和查询复杂度。其次,网络延迟变得至关重要。n8n 主应用与数据库之间的通信频率极高,如果两者部署在不同的物理机或可用区,网络抖动会导致显著的性能下降。
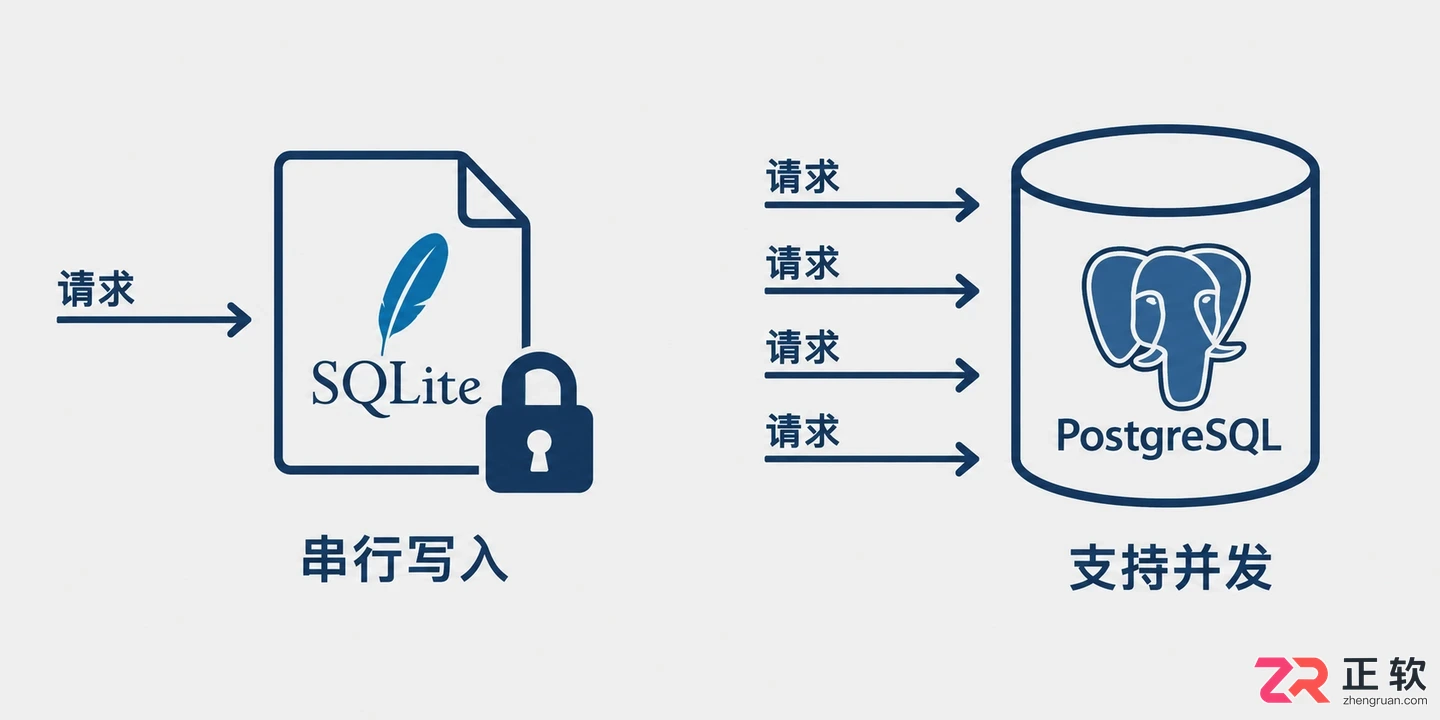
SQLite 文件锁与 PostgreSQL 并发处理对比
使用 PostgreSQL 的好处在于其强大的并发处理能力和数据完整性保障。它支持行级锁,允许多个工作流实例同时写入执行记录而不发生冲突。相比之下,SQLite 在写入时会锁定整个数据库文件,这在多用户或多工作流并行触发时会导致严重的排队等待。因此,当你的工作流数量超过 50 个,或日均执行次数超过数千次时,迁移到 PostgreSQL 应被视为标准操作而非可选优化。
网络环境与端口规划
n8n 本质上是一个 Web 服务,其网络配置直接影响可访问性和安全性。默认情况下,n8n 监听 5678 端口。在部署时,需要确保防火墙或安全组允许该端口的入站流量,或者通过反向代理(如 Nginx 或 Traefik)进行转发。
对于需要接收 Webhook 的工作流,公网 IP 或域名解析是必须的。如果部署在内网环境,需确保触发源能够访问 n8n 实例。此外,SSL/TLS 加密不仅是安全最佳实践,也是许多第三方 API 服务商的要求。在 Docker 部署中,通常通过环境变量 WEBHOOK_URL 指定外部访问地址,确保生成的回调链接正确无误。
# Docker 启动时的关键网络与环境变量配置
docker run -d \
  --name n8n \
  -p 5678:5678 \
  -e WEBHOOK_URL=https://n8n.example.com/ \
  -e GENERIC_TIMEZONE="Asia/Shanghai" \
  -v ~/.n8n:/home/node/.n8n \
  n8nio/n8n
需要注意的是,如果背后有负载均衡器,需配置好健康检查路径(通常为 /healthz),以避免因启动时间较长而被误判为不可用。n8n 的启动过程包括数据库迁移和插件加载,可能需要数十秒,这段时间内的请求应被妥善处理。
并发控制与队列模式
当单实例无法满足性能需求时,n8n 支持队列模式(Queue Mode),这是扩展性的关键。在队列模式下,n8n 分为 Webhook 前端、Worker 后端和 Redis 消息队列。这种架构允许水平扩展 Worker 节点,以处理积压的任务。
启用队列模式后,硬件配置要求发生结构性变化。你需要额外部署 Redis 实例,并为每个 Worker 节点分配独立的资源。Redis 对内存敏感,而 Worker 节点则侧重于 CPU 处理能力。这种解耦使得你可以针对不同类型的负载进行精细化调整:例如,为处理大量计算的 Worker 分配更多 CPU,而为处理频繁 I/O 的 Worker 分配更多内存。
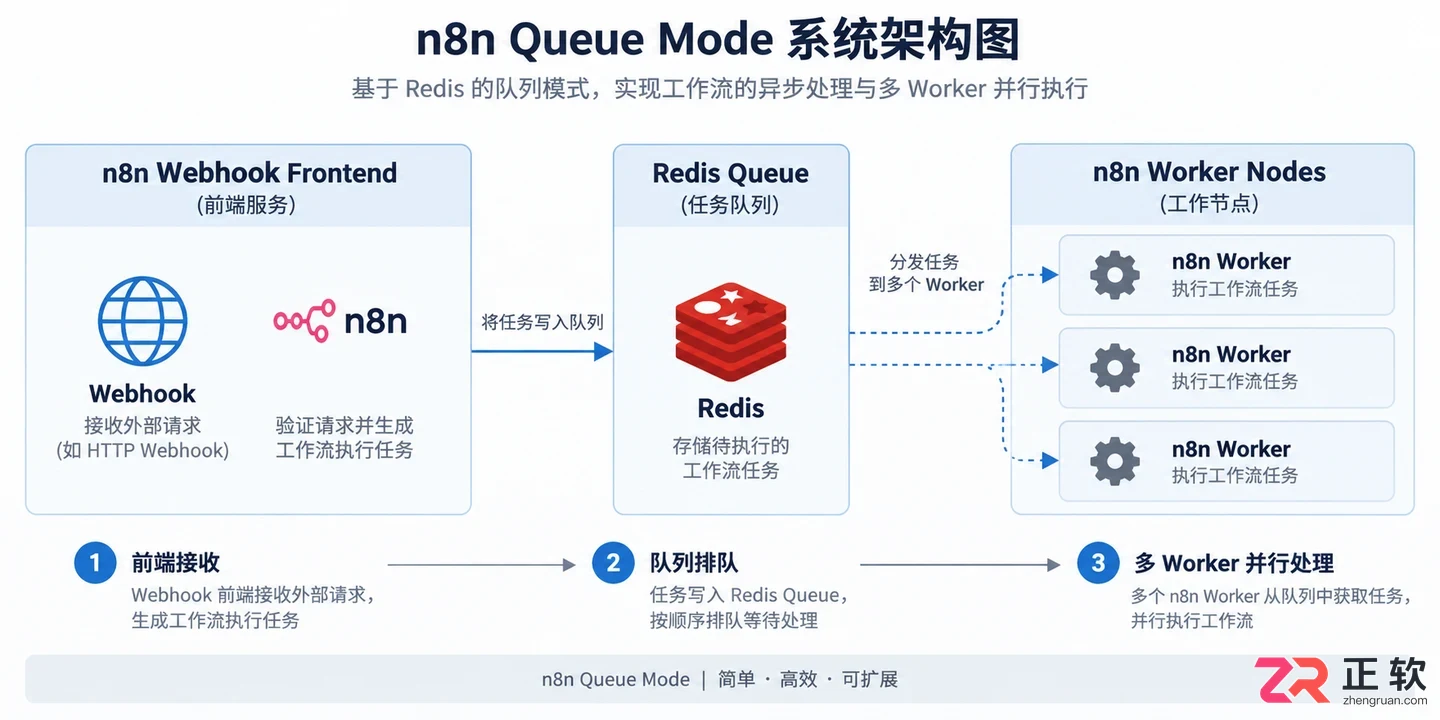
n8n 队列模式下的组件交互关系
然而,队列模式也引入了复杂性。你需要监控 Redis 的连接数和内存使用,以及 Worker 节点的健康状态。如果 Redis 出现故障,整个自动化系统将停滞。因此,在高可用架构中,Redis 也应配置持久化和主从复制。对于中小型团队,除非遇到明显的性能瓶颈,否则垂直扩展(升级单机配置)往往比横向扩展(引入队列模式)更具成本效益和维护便利性。
例外情况:何时可以打破常规建议
尽管上述建议涵盖了大多数场景,但在某些特定条件下,严格的配置要求可以被放宽或调整。
首先是无服务器(Serverless)部署。如果使用 Vercel、Netlify 或 AWS Lambda 托管 n8n,你无需关心底层服务器的 CPU 和内存配置,而是受限于平台函数的执行时长和内存上限。例如,AWS Lambda 最大执行时间为 15 分钟,这意味着长运行的工作流会被强制终止。在这种环境下,配置的重点转向了代码的无状态性和启动速度,而非持续的硬件资源。
其次是极简的个人用途。如果你仅用 n8n 每天定时发送一条天气邮件,且数据量极小,那么 1 vCPU 和 1GB RAM 的实例完全足够。此时,过度配置 PostgreSQL 和 Redis 反而是资源浪费。SQLite 的简单性和零维护成本在此类场景中具有不可替代的优势。
最后是开发测试环境。在本地开发或 CI/CD 流水线中,可以使用内存数据库或临时容器,无需持久化存储和高可用配置。此时的目标是快速迭代和验证逻辑,硬件配置的优先级让位于部署速度和灵活性。
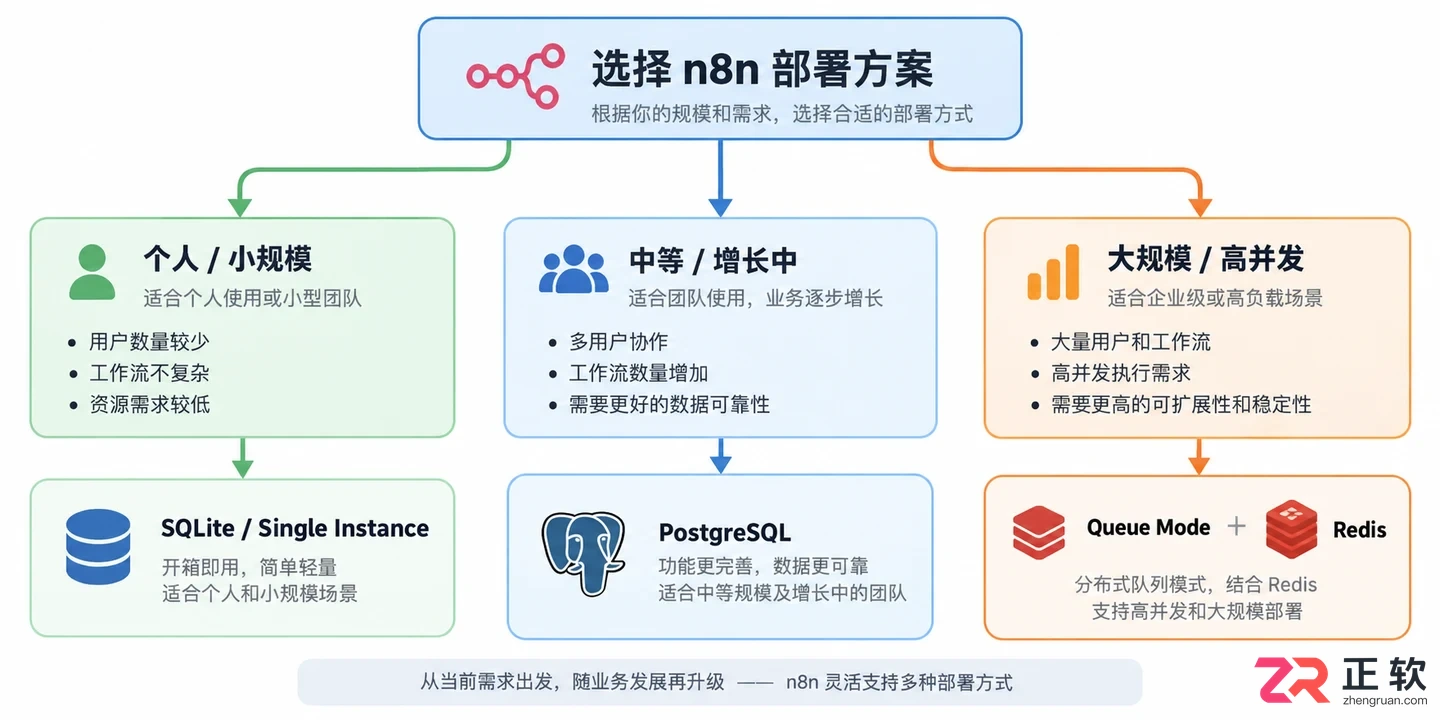
根据业务规模选择部署方案的决策逻辑
综上所述,n8n 的部署配置没有统一的标准答案。它取决于你的工作流复杂度、数据量、并发需求以及可用性要求。从最小的 SQLite 单实例起步,随着业务增长逐步引入 PostgreSQL 和队列模式,是一种稳健且经济的路径。关键在于持续监控资源使用情况,并在瓶颈出现前做出架构调整,而不是一开始就追求过度工程化的解决方案。

正软商城本月促销专区,汇集办公、设计、安全、影音、系统工具及AI软件等正版软件优惠活动,提供限时折扣、特价授权和优惠购买信息,活动库存及价格以页面实时展示为准。

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
