

Python教程:用日志清洗脚本学会异常处理与生成器
这篇 Python 教程通过一个真实可运行的日志清洗工具,讲解自定义异常、异常链、生成器、Counter、严格模式和退出状态。
刚开始写 Python 脚本时,最容易获得成就感的是“文件读出来了”。真正麻烦的部分往往出现在第三步:日志里混进一条坏数据,整个程序直接停了。
全部忽略当然也能跑完,但你随后会遇到更难回答的问题:到底丢了多少行?为什么丢?自动化任务应该算成功还是失败?
这篇 Python 教程不再重复变量和循环,而是完成一个可运行的日志清洗工具。输入一个 timestamp|level|message 格式的 UTF-8 日志文件,它会逐行校验数据、保留有效记录、统计日志级别,并把坏行原因放进 JSON 报告。脚本还提供严格模式,方便接进 CI 或定时任务。
先把“正常”和“异常”写成规则
我们先约定每行日志包含三个字段:
2026-09-03T10:00:00|INFO|service started规则看起来很简单,但至少有四种输入不能悄悄放过:
- 缺少分隔符,拆不出三个字段;
- 时间不是 ISO 8601 格式;
- 日志级别不在允许列表中;
- 消息字段为空。
这一步很重要。异常处理不是看到报错就套一层 try...except,而是先划清哪些问题可以恢复,哪些问题应该让程序停下来。
当前工具把单条坏行视为“可恢复”:记录原因,继续处理后面的行。文件不存在、无权读取或者脚本自身出现未知错误,则不应该伪装成一次成功清洗。
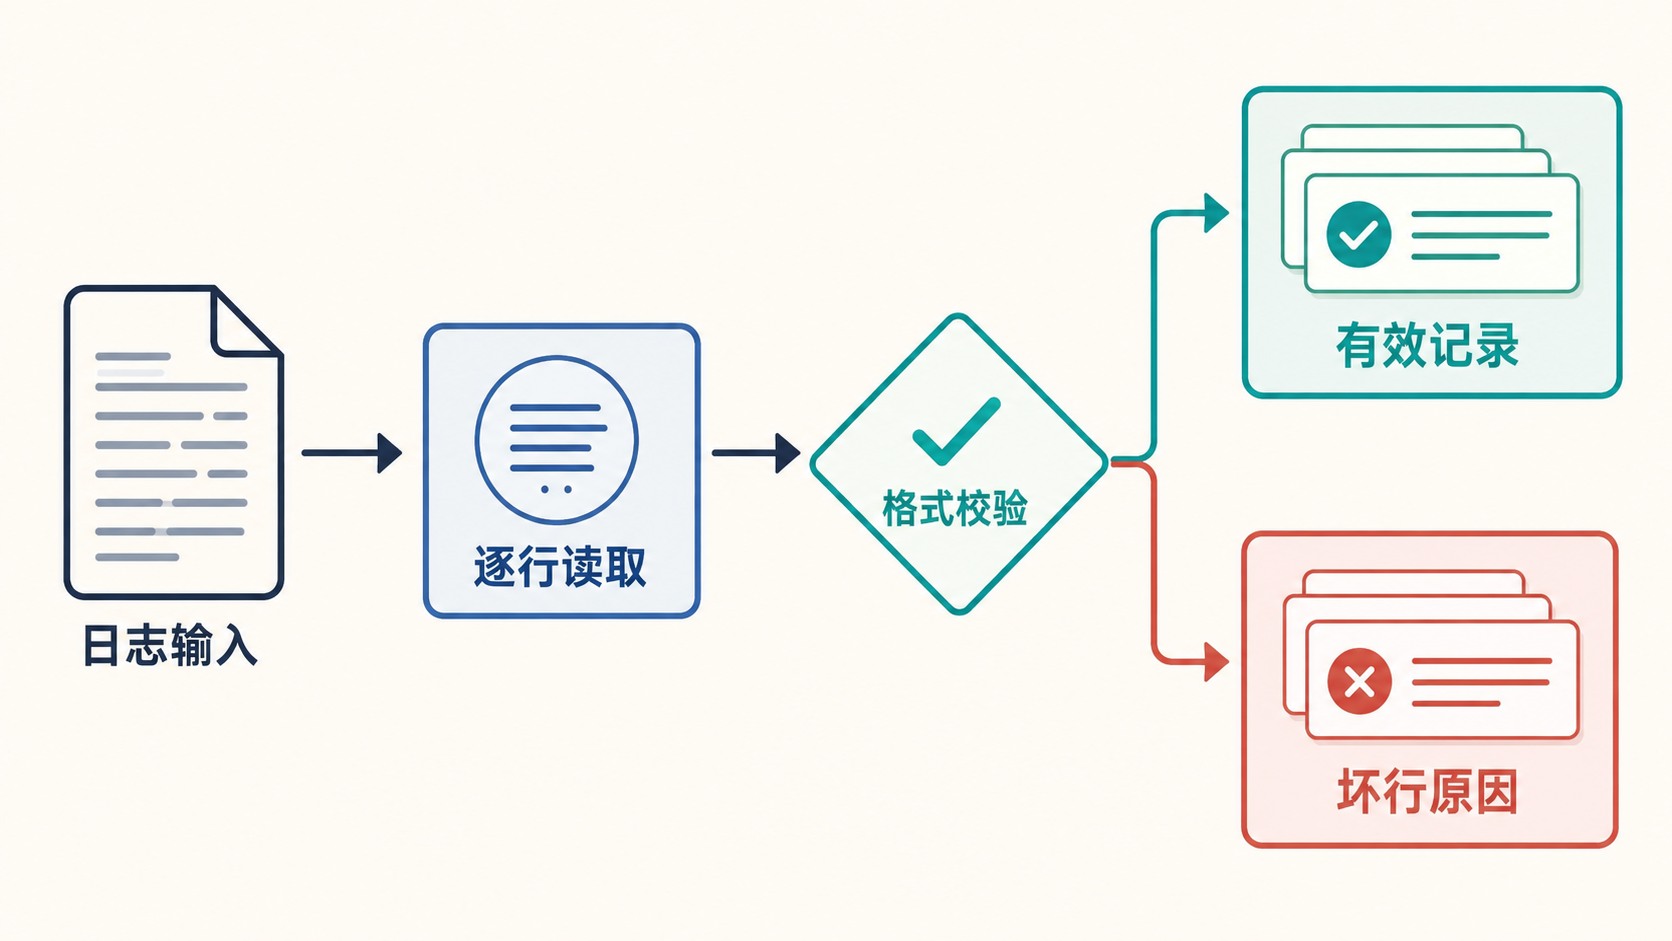
图:格式校验是分界点,有效记录继续参与汇总,坏行则保留具体原因。
用自定义异常表达数据错误
先实现一行日志的解析:
from datetime import datetime


VALID_LEVELS = {"DEBUG", "INFO", "WARNING", "ERROR", "CRITICAL"}


class LogFormatError(ValueError):
    """一行日志不符合 timestamp|level|message 约定。"""


def parse_line(line: str, line_number: int) -> dict[str, str]:
    parts = line.rstrip("\n").split("|", 2)
    if len(parts) != 3:
        raise LogFormatError(f"第 {line_number} 行:字段数量不是 3")

    timestamp, level, message = (part.strip() for part in parts)
    try:
        datetime.fromisoformat(timestamp)
    except ValueError as exc:
        raise LogFormatError(
            f"第 {line_number} 行:时间不是 ISO 8601 格式"
        ) from exc

    level = level.upper()
    if level not in VALID_LEVELS:
        raise LogFormatError(f"第 {line_number} 行:未知级别 {level!r}")
    if not message:
        raise LogFormatError(f"第 {line_number} 行:消息为空")

    return {"timestamp": timestamp, "level": level, "message": message}
这里有三个设计点。
第一,split("|", 2) 最多拆两次。这样消息正文里即使包含 |,剩余内容仍会留在第三个字段中;直接使用不带次数限制的 split("|") 反而容易误伤正常消息。
第二,输入中的 warning 会统一转换成 WARNING。这是可以恢复的格式差异,不需要把整行判坏。
第三,时间解析产生的 ValueError 被转换成更贴合业务含义的 LogFormatError,同时通过 raise ... from exc 保留原异常链。Python 官方异常教程建议尽量捕获具体异常,让未预料的问题继续暴露,而不是用一个宽泛的 except Exception 把所有错误吞掉。
为什么这里要用生成器
解析一行之后,还要遍历整个文件。最直观的写法是先把所有结果放进列表,但我们其实只需要“取一条、处理一条”。生成器正适合表达这种过程:
from pathlib import Path
from typing import Iterator


def iter_records(
    path: Path,
    errors: list[str],
) -> Iterator[dict[str, str]]:
    with path.open(encoding="utf-8") as log_file:
        for line_number, line in enumerate(log_file, start=1):
            if not line.strip():
                continue
            try:
                yield parse_line(line, line_number)
            except LogFormatError as exc:
                errors.append(str(exc))
函数中出现 yield 后,它返回的是生成器。调用方每请求下一条数据,函数才从上次暂停的位置继续执行。Python 官方教程把生成器描述为创建迭代器的一种紧凑方式,局部变量和执行位置会在两次取值之间保留下来。
这意味着代码不需要先构造“全部有效记录”的列表。需要克制一点:这并不自动证明脚本在任何场景都更快,它只是改变了数据产生方式,减少了为有效记录额外保存完整列表的需要。实际性能仍取决于日志大小、磁盘和后续处理。
errors 列表则是这版实现的现实取舍。它会保留所有错误文本,方便输出报告;如果坏行多到不可控,这个列表仍会占用内存。生产版本可以只保留前 N 条错误,再单独累计总数。
Counter 把汇总逻辑压缩到一行
有了有效记录流,就可以统计各级别出现次数:
from collections import Counter


def build_report(path: Path) -> dict[str, object]:
    errors: list[str] = []
    levels = Counter(
        record["level"]
        for record in iter_records(path, errors)
    )
    valid_lines = sum(levels.values())

    return {
        "file": str(path.resolve()),
        "valid_lines": valid_lines,
        "invalid_lines": len(errors),
        "levels": dict(sorted(levels.items())),
        "errors": errors,
    }
Counter 是一个专门计数可哈希对象的字典子类。生成器每交出一条有效记录,Counter 就给对应的日志级别加一。最后再转回普通字典,让 JSON 输出更直观。
为什么不把计数写进 parse_line()?因为解析函数应该只回答“这一行是否合法、解析结果是什么”。汇总是另一个层次的职责。两者拆开以后,后面改成按服务名或日期统计时,不必动底层格式校验。
同一份报告,为什么需要两种退出策略
交互运行脚本时,遇到几条坏行通常希望继续处理;接进数据流水线后,坏行又可能意味着上游格式已经变化,任务必须亮红灯。
因此命令行增加一个 --strict 开关:
import argparse
import json


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser(
        description="清洗 timestamp|level|message 格式的 UTF-8 日志。"
    )
    parser.add_argument("log_file", type=Path, help="待处理日志文件")
    parser.add_argument(
        "--strict",
        action="store_true",
        help="发现坏行时返回非零状态",
    )
    return parser.parse_args()


def main() -> int:
    args = parse_args()
    if not args.log_file.is_file():
        raise SystemExit(f"文件不存在:{args.log_file}")

    report = build_report(args.log_file)
    print(json.dumps(report, ensure_ascii=False, indent=2))
    return 2 if args.strict and report["invalid_lines"] else 0
默认模式始终输出报告,发现坏行后继续处理,程序正常结束。严格模式也会输出相同报告,但只要存在坏行就返回退出码 2。Shell、CI 或定时任务可以据此判断这次清洗是否满足质量要求。
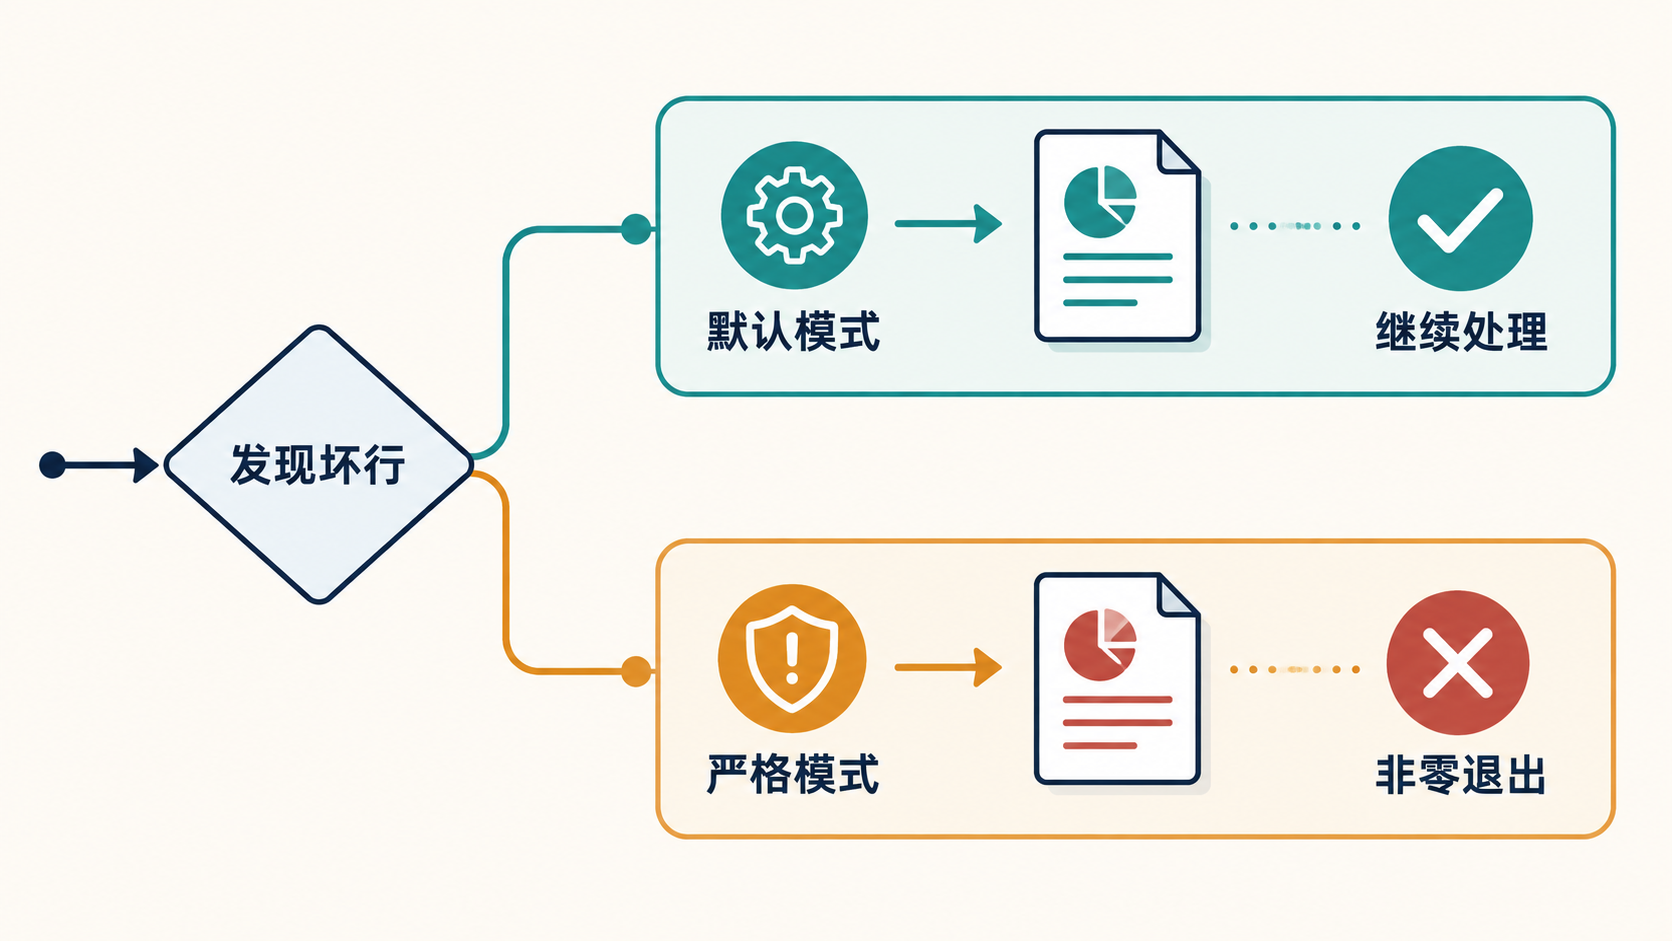
图:两种模式都保留报告,区别是严格模式会用非零退出状态通知自动化系统。
运行真实样例,别只看代码猜结果
把脚本保存为 log_cleaner.py,准备下面这份 sample-data/app.log:
2026-09-03T10:00:00|INFO|service started
2026-09-03T10:00:01|ERROR|database timeout
this line is malformed
2026-09-03T10:00:03|warning|queue depth high
2026-09-03T10:00:04|TRACE|cache lookup
2026-09-03T10:00:05|ERROR|retry exhausted
在脚本所在目录执行:
python3 log_cleaner.py sample-data/app.log本文示例在 Python 3.14.2 环境真实运行,关键输出如下:
{
  "valid_lines": 4,
  "invalid_lines": 2,
  "levels": {
    "ERROR": 2,
    "INFO": 1,
    "WARNING": 1
  },
  "errors": [
    "第 3 行:字段数量不是 3",
    "第 5 行:未知级别 'TRACE'"
  ]
}
绝对文件路径在上面的节选中省略,完整输出会保留 file 字段。
再运行严格模式:
python3 log_cleaner.py sample-data/app.log --strict
echo $?
实测退出码是 2。这不是异常崩溃,而是脚本按约定主动给调用方的质量信号。
测试要覆盖坏数据,而不只是正常路径
这类工具最值得测的恰恰是异常输入:
def test_report_separates_valid_and_invalid_lines(self) -> None:
    source.write_text(
        "2026-09-03T10:00:00|INFO|started\n"
        "bad line\n"
        "2026-09-03T10:00:01|error|timeout\n"
        "2026-09-03T10:00:02|TRACE|unknown level\n",
        encoding="utf-8",
    )

    report = build_report(source)

    self.assertEqual(report["valid_lines"], 2)
    self.assertEqual(report["invalid_lines"], 2)
    self.assertEqual(report["levels"], {"ERROR": 1, "INFO": 1})
完整示例还测试了严格模式的退出码。实际执行:
python3 -m unittest -v test_log_cleaner.py结果为 2 tests OK,脚本和测试文件也通过了 py_compile 语法检查。
这份脚本的边界在哪里
它适合学习和处理格式明确的小型文本日志,但还不是通用日志平台:
- 分隔格式是自定义约定,不支持多行消息;
- 只处理 UTF-8,其他编码会在文件读取阶段失败;
- ISO 时间只校验格式,没有统一时区;
- 所有坏行原因都会留在内存中;
- 统计结果只按日志级别聚合,没有时间窗口和服务维度。
下一步可以增加 --max-errors 限制错误样本数量,要求时间必须带时区,并把有效记录写成 JSON Lines。日志量继续增大后,再考虑批量落盘、压缩输入和并行处理;在没有测量数据前,不要先承诺性能提升。
这次真正要带走的不是某个固定日志格式,而是一条可复用的 Python 编程路径:把输入规则写清楚,用具体异常表达可预期错误,用生成器逐条交付数据,再通过退出状态把结果告诉外部系统。遇到下一个文件处理任务时,这套拆法仍然成立。
参考资料
Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。
Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。