


利用LLM进行文本嵌入学习实现无需人工标注的跨语言支持,适应数十万下游任务
文本嵌入(wordembedding)是自然语言处理(NLP)领域的基础技术,它能够将文本映射到语义空间,并转化为稠密的矢量表示。这种方法已经被广泛应用于各种NLP任务,包括信息检索(IR)、问答、文本相似度计算和推荐系统等。通过文本嵌入,我们可以更好地理解文本的含义和关系,从而提高NLP任务的效果。在信息检索(IR)领域,第一阶段的检索通常使用文本嵌入进行相似度计算。它通过在大规模语料库中召回一个小的候选文件集,然后进行细粒度的计算。基于嵌入的检索也是检索增强生成(RAG)的重要组成部分。它使得大型语言
文本嵌入(word embedding)是自然语言处理(NLP)领域的基础技术,它能够将文本映射到语义空间,并转化为稠密的矢量表示。这种方法已经被广泛应用于各种NLP任务,包括信息检索(IR)、问答、文本相似度计算和推荐系统等。通过文本嵌入,我们可以更好地理解文本的含义和关系,从而提高NLP任务的效果。
在信息检索(IR)领域,第一阶段的检索通常使用文本嵌入进行相似度计算。它通过在大规模语料库中召回一个小的候选文件集,然后进行细粒度的计算。基于嵌入的检索也是检索增强生成(RAG)的重要组成部分。它使得大型语言模型(LLM)能够访问动态的外部知识,而无需修改模型参数。这样一来,IR系统可以更好地利用文本嵌入和外部知识,提高检索效果。
早期的文本嵌入学习方法如word2vec和GloVe虽然被广泛应用,但它们的静态特性限制了对自然语言中丰富上下文信息的捕捉能力。然而,随着预训练语言模型的兴起,一些新方法如Sentence-BERT和SimCSE通过微调BERT来学习文本嵌入,在自然语言推理(NLI)数据集上取得了显著的进展。这些方法利用BERT的上下文感知能力,能够更好地理解文本的语义和语境,从而提高了文本嵌入的质量和表达能力。通过预训练和微调的结合,这些方法能够从大规模的语料库中学习到更丰富的语义信息,为自然语言处理
为了提高文本嵌入性能和鲁棒性,先进的方法如E5和BGE采用了多阶段训练。它们首先对数十亿个弱监督文本对进行预训练,然后再在几个标注数据集上进行微调。这种策略能够有效地提升文本嵌入的表现。
现有的多阶段方法仍然存在两个缺陷:
1. 构造一个复杂的多阶段训练pipeline,需要大量的工程工作来管理大量的相关性数据对(relevance pairs)。
2. 微调依赖于人工收集的数据集,而这些数据集往往受到任务多样性和语言覆盖范围的限制。
大部分方法使用BERT式编码器,忽略了更好的LLM和相关技术的训练进展。
微软的研究团队最近提出了一种简单而高效的文本嵌入训练方法,以克服之前方法存在的一些缺陷。这种方法不需要复杂的管道设计或人工构建的数据集,而是利用LLM来合成多样化的文本数据。通过这种方法,他们能够为近100种语言的数十万文本嵌入任务生成高质量的文本嵌入,而整个训练过程不到1000步。
论文链接:https://arxiv.org/abs/2401.00368
具体来说,研究人员使用两步提示策略,首先提示LLM头脑风暴候选任务池,然后提示LLM从池中生成给定任务的数据。
为了覆盖不同的应用场景,研究人员为每个任务类型设计了多个提示模板,并将不同模板生成的数据进行联合收割机组合,以提高多样性。
实验结果证明,当「仅对合成数据」进行微调时,Mistral-7B在BEIR和MTEB基准上获得了非常有竞争力的性能;当同时加入合成和标注数据进行微调时,即可实现sota性能。
用大模型提升文本嵌入
1. 合成数据生成
利用GPT-4等最先进的大型语言模型(LLM)来合成数据越来越受到重视,可以增强模型在多任务和多语言上的能力多样性,进而可以训练出更健壮的文本嵌入,在各种下游任务(如语义检索、文本相似度计算、聚类)中都能表现良好。
为了生成多样化的合成数据,研究人员提出了一个简单的分类法,先将嵌入任务分类,然后再对每类任务使用不同的提示模板。
非对称任务(Asymmetric Tasks)
包括查询(query)和文档在语义上相关但彼此不互为改写(paraphrase)的任务。
根据查询和文档的长度,研究人员进一步将非对称任务分为四个子类别:短-长匹配(短查询和长文档,商业搜索引擎中的典型场景),长-短匹配,短-短匹配和长-长匹配。
对于每个子类别,研究人员设计了一个两步提示模板,首先提示LLM头脑风暴的任务列表,然后生成一个具体的例子的任务定义的条件;从GPT-4的输出大多连贯一致,质量很高。
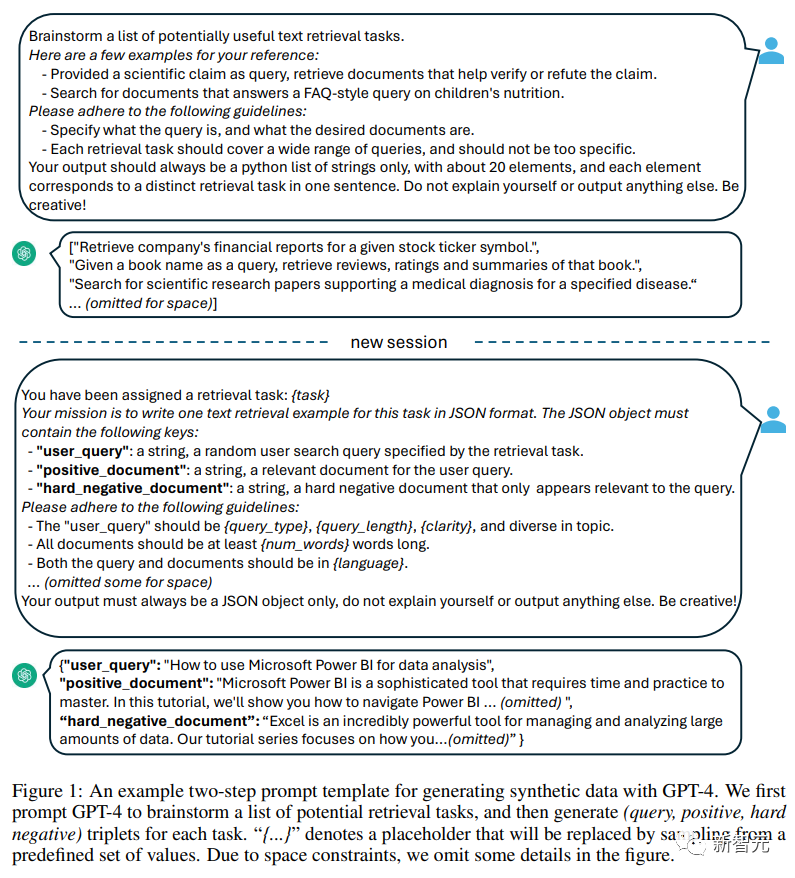
在初步实验中,研究人员还尝试使用单个提示生成任务定义和查询文档对,但数据多样性不如上述的两步方法。
对称任务
主要包括具有相似语义但不同表面形式的查询和文档。
文中研究了两个应用场景:单语种(monolingual)语义文本相似性(STS)和双文本检索,并且为每个场景设计了两个不同的提示模板,根据其特定目标进行定制,由于任务的定义比较简单,所以头脑风暴步骤可以省略。
为了进一步提高提示词的多样性,提高合成数据的多样性,研究人员在每个提示板中加入了几个占位符,在运行时随机采样,例如「{query_length}」代表从集合「{少于5个单词,5-10个单词,至少10个单词}」中采样的。
为了生成多语言数据,研究人员从XLM-R的语言列表中采样「{language}」的值,给予高资源语言更多的权重;任何不符合预定义JSON格式的生成数据都将在解析过程中被丢弃;还会根据精确的字符串匹配删除重复项。
2. 训练
给定一个相关的查询-文档对,先使用原始查询q+来生成一个新的指令q_inst,其中「{task_definition}」是嵌入任务的一句话描述的占位符。
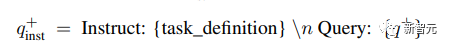
对于生成的合成数据,使用头脑风暴步骤的输出;对于其他数据集,例如MS-MARCO,研究人员手动创建任务定义并将其应用于数据集中的所有查询,不修改文件端的任何指令前缀。
通过这种方式,可以预先构建文档索引,并且可以通过仅更改查询端来自定义要执行的任务。
给定一个预训练的LLM,将一个[EOS]标记附加到查询和文档的末尾,然后馈送到LLM中,通过获取最后一层[EOS]向量来获得查询和文档嵌入。
然后采用标准的InfoNCE loss对批内negatives和hard negatives进行损失计算。
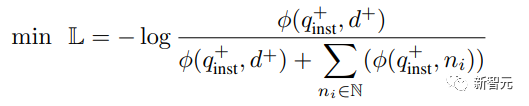
其中ℕ表示所有negatives的集合, 用来计算查询和文档之间的匹配分数,t是一个温度超参数,在实验中固定为0.02
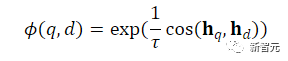
实验结果
合成数据统计
研究人员使用Azure OpenAI服务生成了500k个样本,包含150k条独特指令,其中25%由GPT-3.5-Turbo生成,剩余由GPT-4生成,总共消耗了1.8亿个token。
主要语言是英语,一共覆盖93种语言;对于75种低资源语言,平均每种语言约有1k个样本。
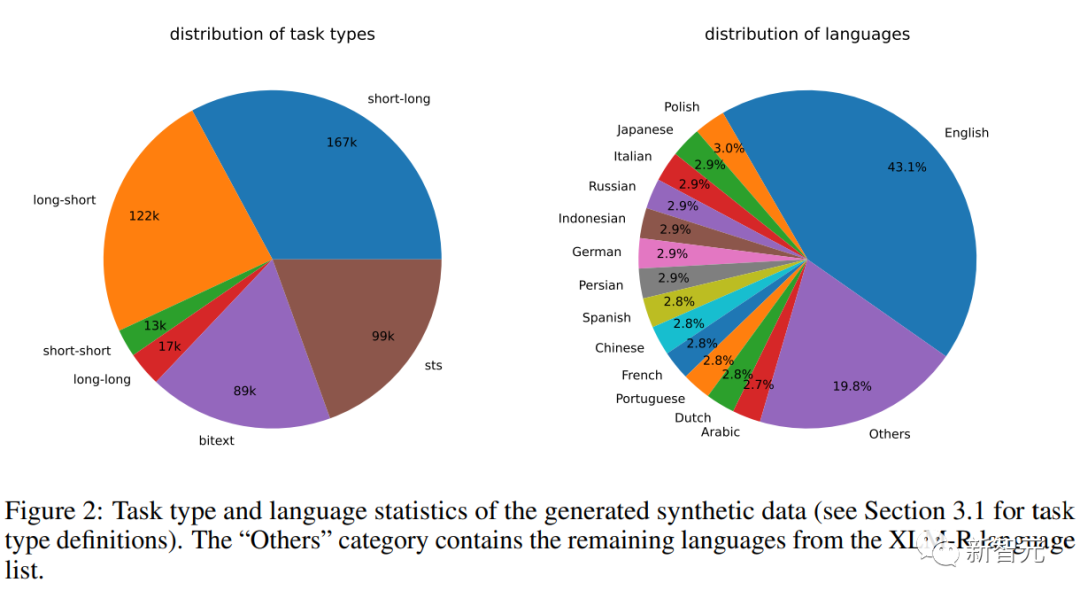
在数据质量方面,研究人员发现GPT-3.5-Turbo的部分输出没有严格遵循提示模板中规定的准则,但尽管如此,总体质量仍然是可以接受的,初步实验也证明了采用这一数据子集的好处。
模型微调和评估
研究人员对预训练Mistral-7B使用上述损失微调1个epoch,遵循RankLLaMA的训练方法,并使用秩为16的LoRA。
为了进一步降低GPU内存需求,采用梯度检查点、混合精度训练和DeepSpeed ZeRO-3等技术。
在训练数据方面,同时使用了生成的合成数据和13个公共数据集,采样后产生了约180万个示例。
为了与之前的一些工作进行公平比较,研究人员还报告了当唯一的标注监督是MS-MARCO篇章排序数据集时的结果,还在MTEB基准上对模型进行了评估。
主要结果
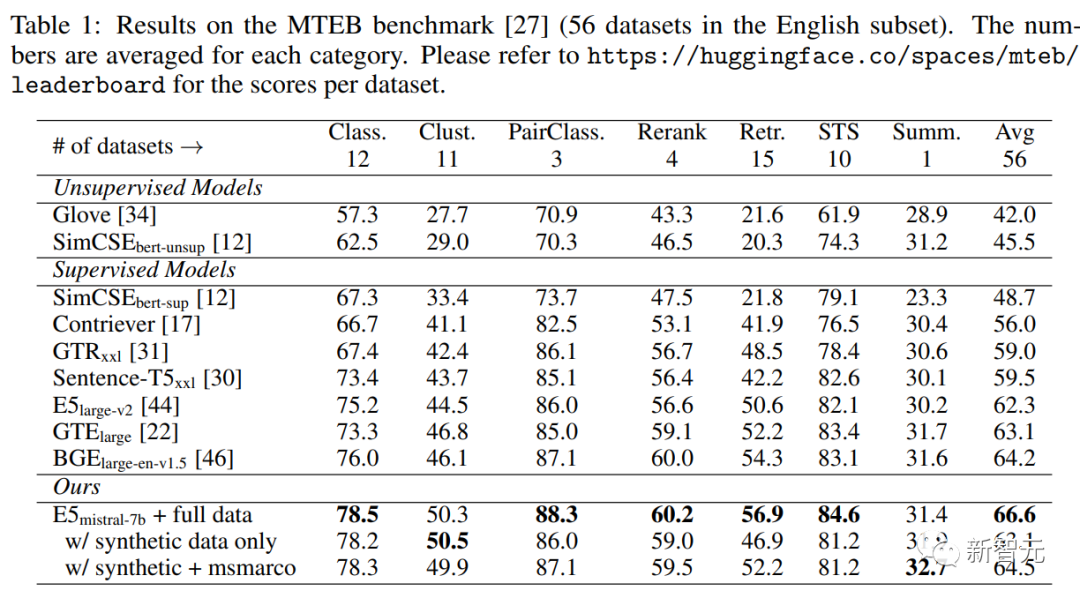
下表中可以看到,文中得到的模型「E5mistral-7B + full data」在MTEB基准测试中获得了最高的平均分,比之前最先进的模型高出2.4分。
在「w/ synthetic data only」设置中,没有使用标注数据进行训练,但性能仍然很有竞争力。
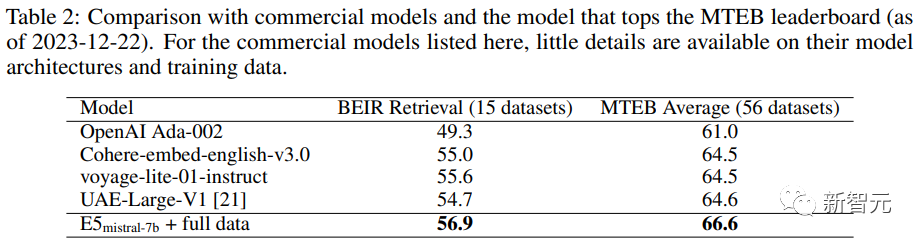
研究人员还对几种商业文本嵌入模型进行了比较,但由于这些模型缺乏透明度和文档,因此无法进行公平的比较。
不过,在BEIR基准上的检索性能对比结果中可以看到,训练得到的模型在很大程度上优于当前的商业模型。
多语言检索
为了评估模型的多语言能力,研究人员在MIRACL数据集上进行了评估,包含18种语言的人工标注查询和相关性判断。
结果显示,该模型在高资源语言上超过了mE5-large,尤其是在英语上,性能表现更出色;不过对于低资源语言来说,该模型与mE5-base相比仍不理想。
研究人员将此归因于Mistral-7B主要在英语数据上进行了预训练,预测多语言模型可以用该方法来弥补这一差距。










火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,