


阿里通义千问的多模态大模型,是否能与GPT-4V竞争?
通义千问的图像推理能力,最近有了大幅提升。2024年,大模型领域要卷什么?如果没有思路的话,不妨看看各家大厂都在押注什么方向。最近一段时间,先是OpenAI推出GPT-4V,让大模型拥有了前所未有的图像语义理解能力。谷歌随后发布的Gemini是首个原生的多模态大模型,在泛化和无缝理解、操作、组合不同类型信息上具有突出能力,包括文本、代码、音频、图像和视频。显然,多模态是当前的新方向。随着GPT-4在语言领域的突破,业界一致认为"视觉"将是下一个爆发的领域。毕竟,视觉信息占据了人类五感的80%,因此未来的大
通义千问的图像推理能力,最近有了大幅提升。
2024 年,大模型领域要卷什么?
如果没有思路的话,不妨看看各家大厂都在押注什么方向。
最近一段时间,先是 OpenAI 推出 GPT-4V,让大模型拥有了前所未有的图像语义理解能力。
谷歌随后发布的 Gemini 是首个原生的多模态大模型,在泛化和无缝理解、操作、组合不同类型信息上具有突出能力,包括文本、代码、音频、图像和视频。
显然,多模态是当前的新方向。随着GPT-4在语言领域的突破,业界一致认为"视觉"将是下一个爆发的领域。毕竟,视觉信息占据了人类五感的80%,因此未来的大型模型应该充分利用更多类型的感知,以此来探索实现人工通用智能的路径。
国内的技术力量也在这个充满潜力的方向上蓬勃发展,除了GPT-4V和Gemini,阿里最近发布的新升级通义千问视觉语言大模型Qwen-VL-Max也值得关注。该模型在上周正式发布,并在多个测评基准上取得了优异成绩,展现出强大的图像理解能力。
我们还记得 Gemini 发布之后,谷歌马上被曝出给 Demo 加速。这让人们对新技术产生了一些质疑,并开始好奇:在当下的各路多模态大模型中,到底哪家比较强?
Demo 不作数,实际一测便知。有人拿着自己的名片给 GPT-4V 和 Qwen-VL-Plus 看,高下立见了:值得注意的是,去年底升级的 Plus 版还不是 Qwen-VL 的最强版本,最近发布的 Max 才是。
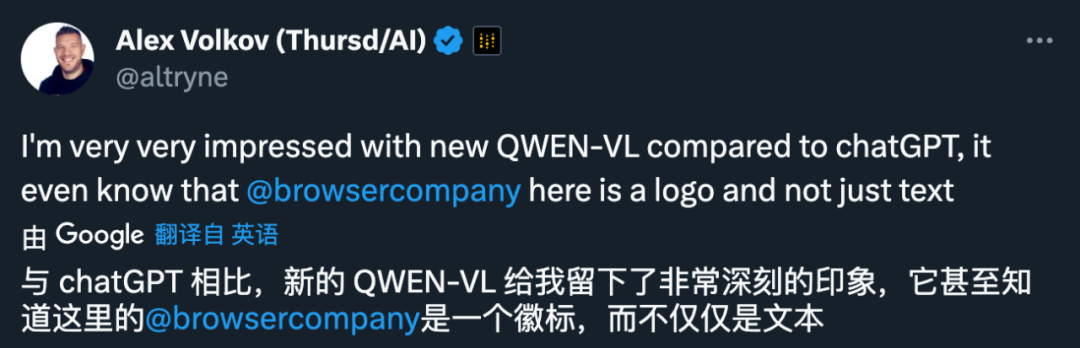
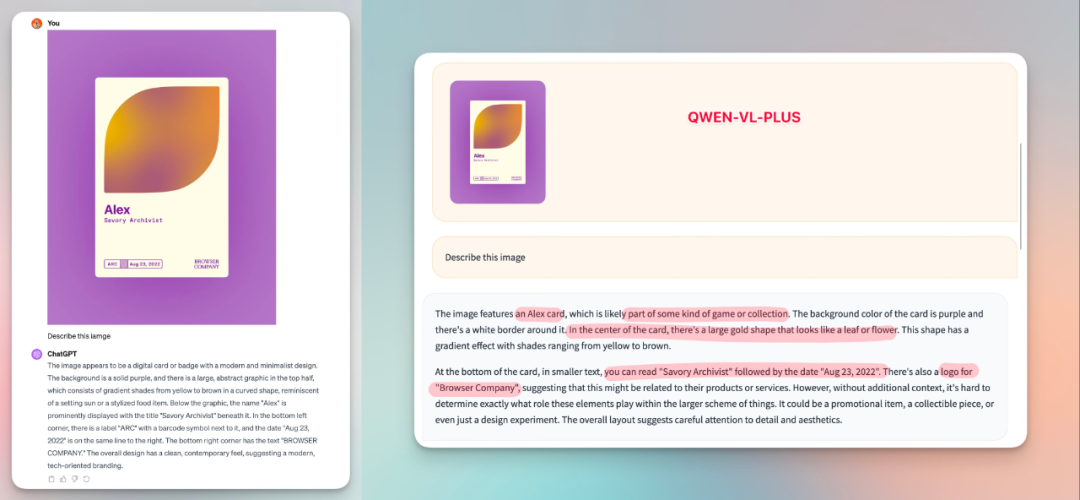
图源:https://x.com/altryne/status/1742597044781395982?s=20
在 Qwen-VL-Plus 发布后,国内也有人拿 Gemini 演示视频里的问题对它进行了测试,发现所有问题 Qwen-VL-Plus 完全都能回答上来。
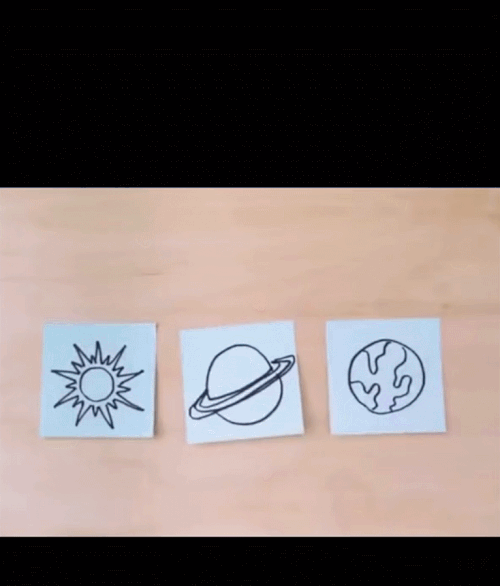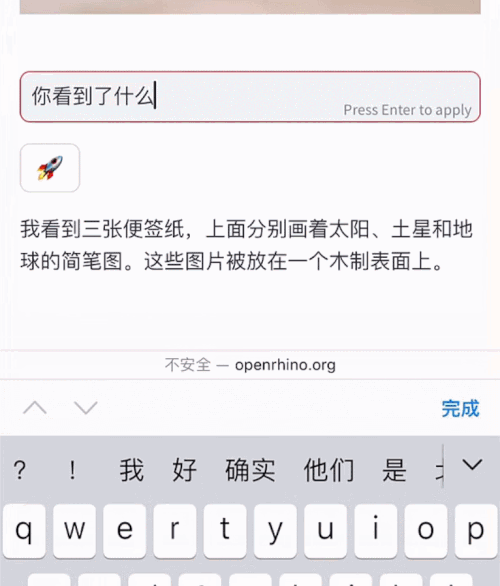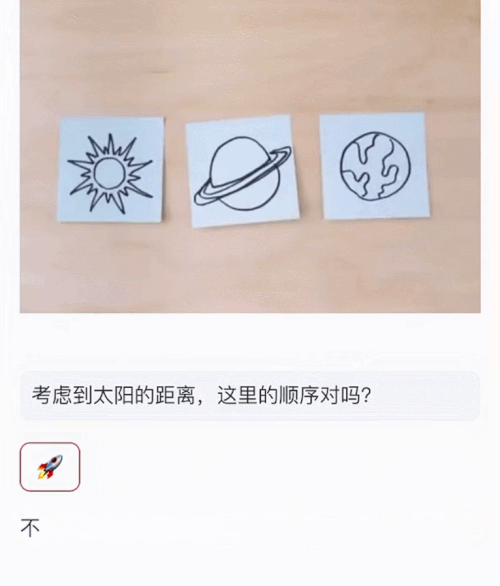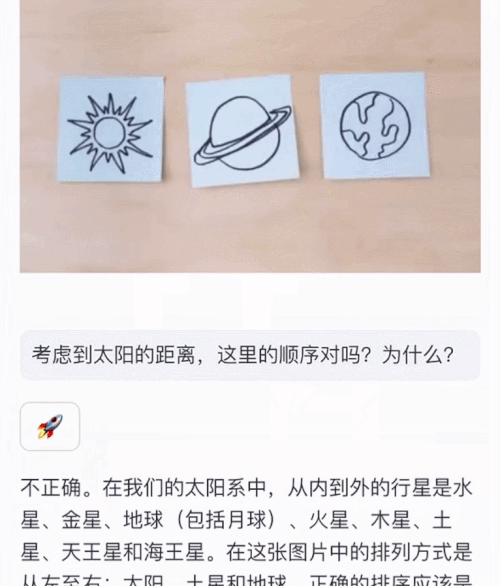
一系列测评看下来,我们确实可以说,Qwen-VL 的整体能力已经达到了媲美 GPT-4V 和 Gemini 的水平,在多模态大模型领域实现了业内领先。
Qwen-VL 如何追平 GPT-4V、Gemini?
事实上,通义千问的视觉理解大模型已经经历了几轮迭代。
早在去年 8 月,阿里就放出了 Qwen-VL 模型的第一个版本,并很快对通义千问进行了升级。Qwen-VL 支持以图像、文本作为输入,并以文本、图像、检测框作为输出,让大模型真正具备了「看」世界的能力。
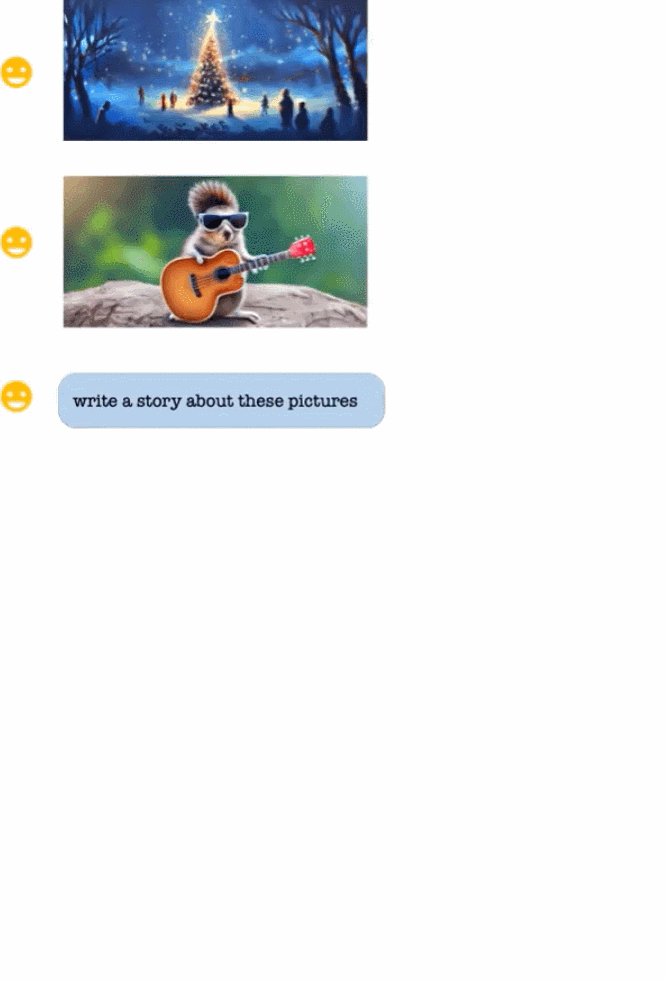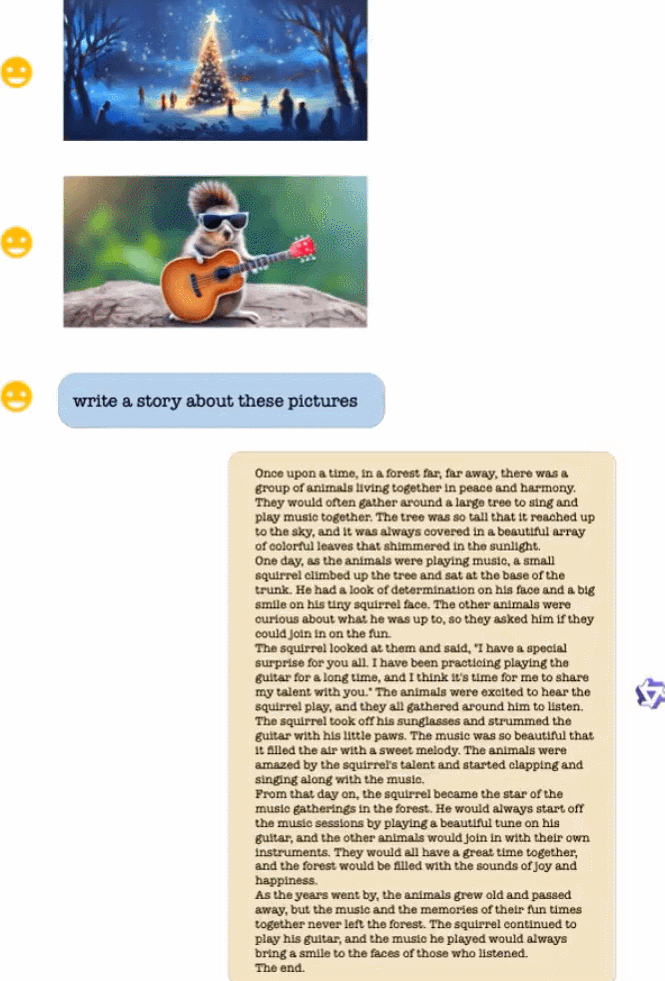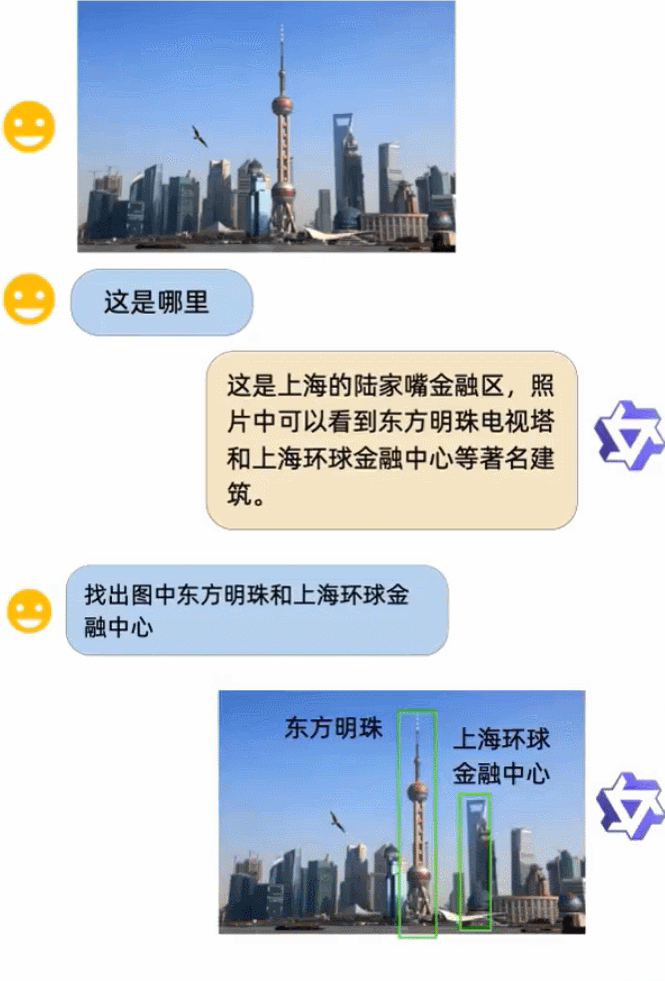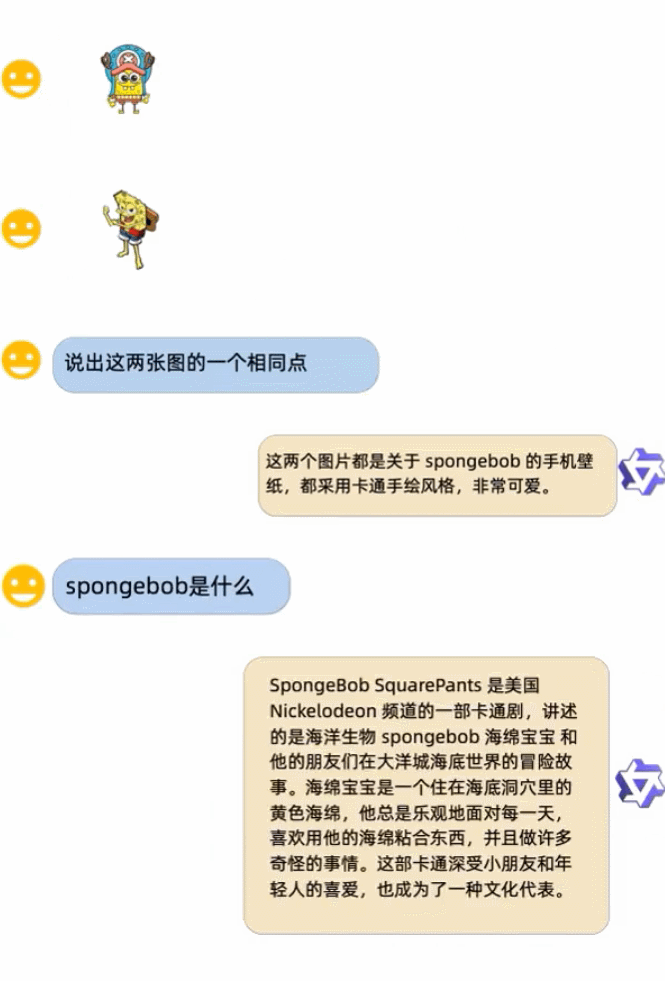
图片来源:https://twitter.com/Gorden_Sun/status/1696021151753855331
经历了几个月的改进,Qwen-VL 的整体能力又有了一个跃升,陆续推出 Plus 和 Max 两大升级版本,限时免费使用。用户可以在通义千问官网、通义千问 APP 直接体验 Max 版本模型的能力,也可以通过阿里云灵积平台(DashScope)调用模型 API。
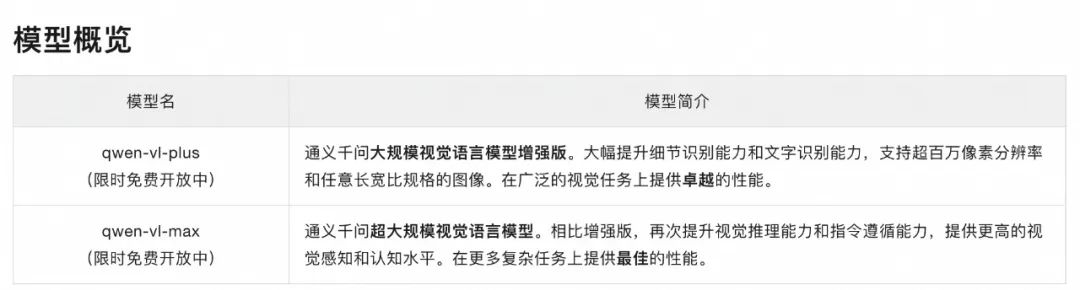
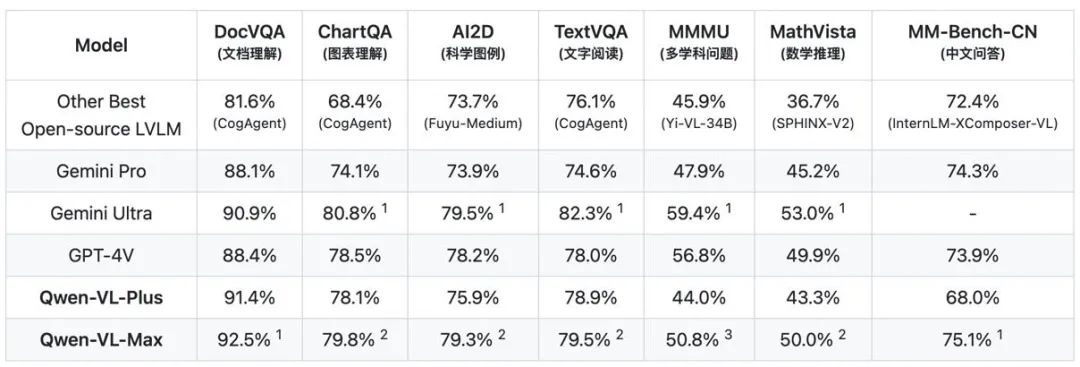
相比于开源版本的 Qwen-VL,这两个模型在多项图文多模态标准测试中获得了堪比 Gemini Ultra 和 GPT-4V 的水准,并大幅超越此前开源模型的最佳水平。
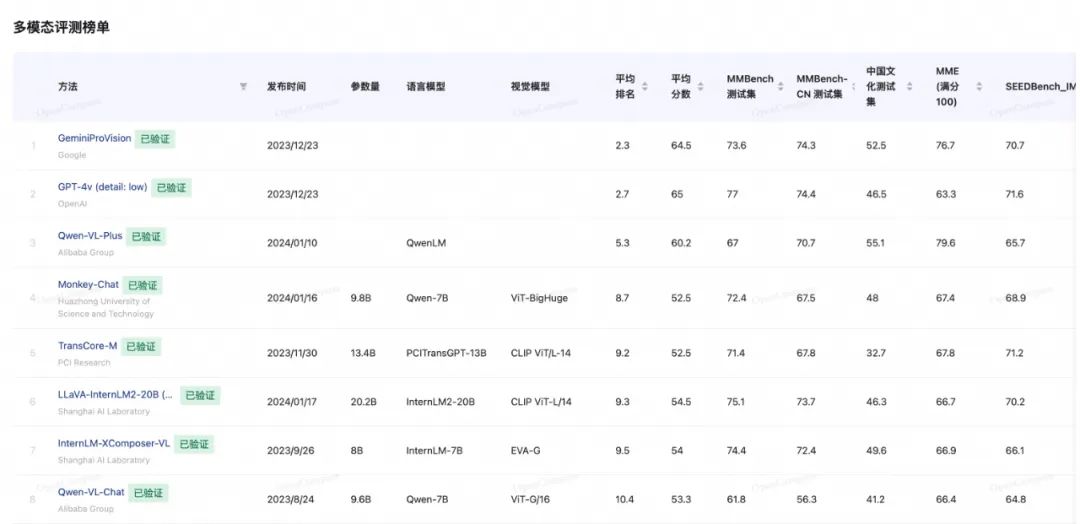
在多模态大模型性能整体榜单 OpenCompass 中,Qwen-VL-Plus 紧随 Gemini Pro 和 GPT-4V,占据了前三名的位置。
图片来源:https://opencompass.org.cn/leaderboard-multimodal
Qwen-VL Plus 和 Max 支持百万像素以上的高清图,甚至各种极端长宽比的图片。
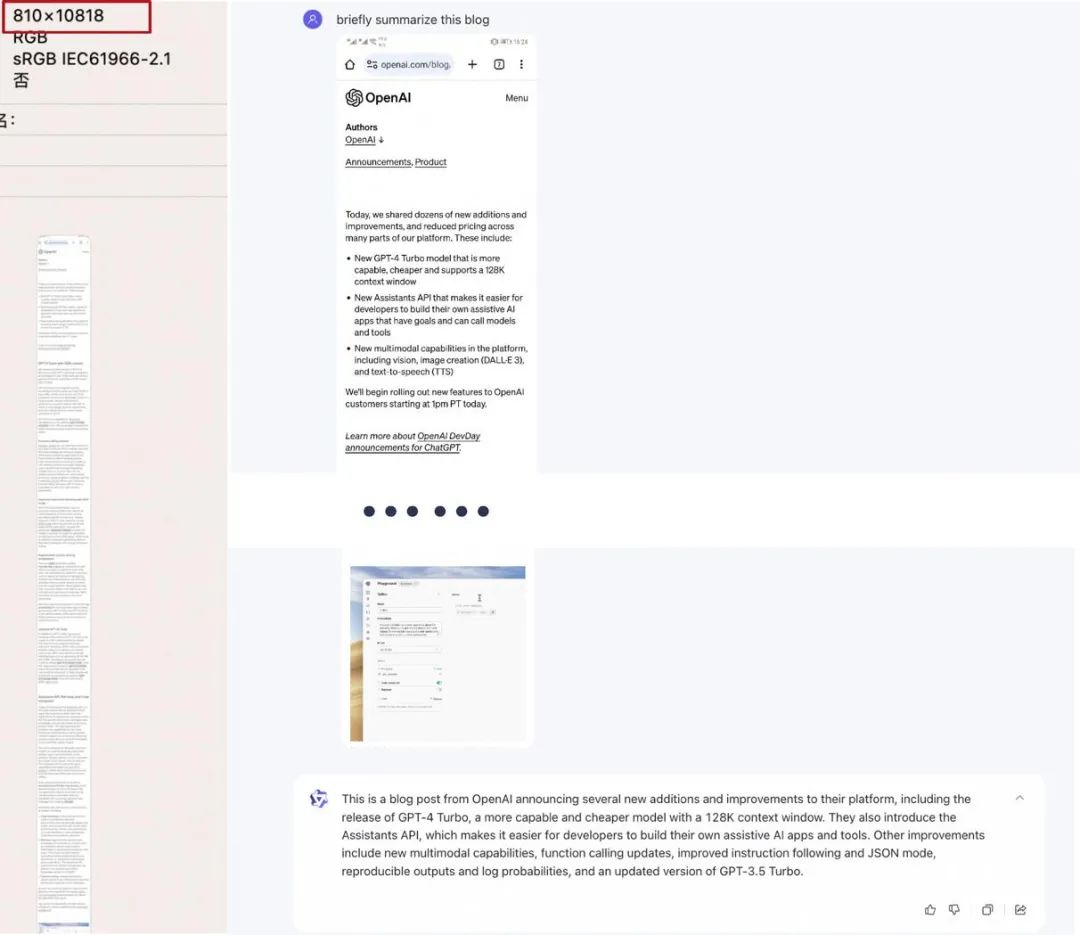
它们不仅有高水平的基准评测性能,在真实场景中展现出来的解决问题的能力也有显著提高,不仅可以轻松进行对话,识别名人、地标,生成文本内容,视觉推理能力也有明显改善。
开发者一手实测
Qwen-VL 发布以来,从开源社区到社交网络上,我们已经看到了一系列「花活」。
接下来,我们从普通用户的角度,再来考验一下升级版的 Qwen-VL。
给它一张《繁花》里面 90 年代初的上海滩照片:
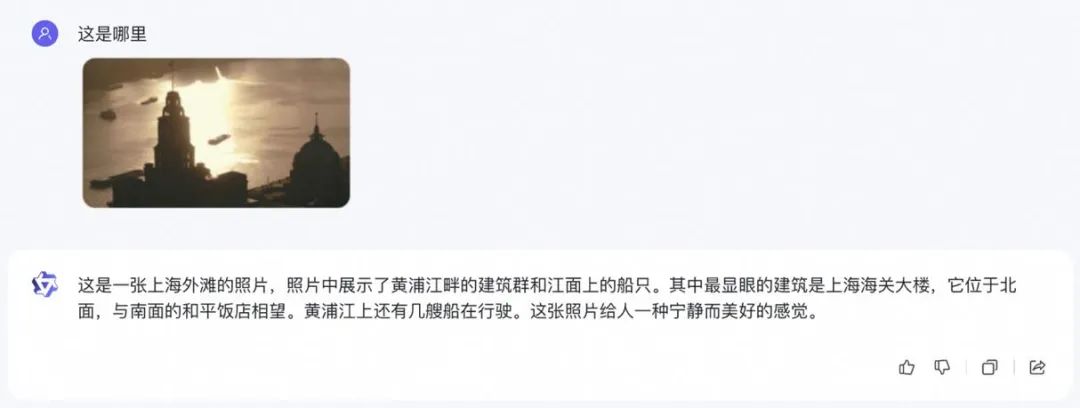
通义千问识别出了这里是上海外滩,还能介绍一下黄浦江的景色,以及上海海关大楼等特定建筑物。
剧中提到的炒饭内含多少卡路里?
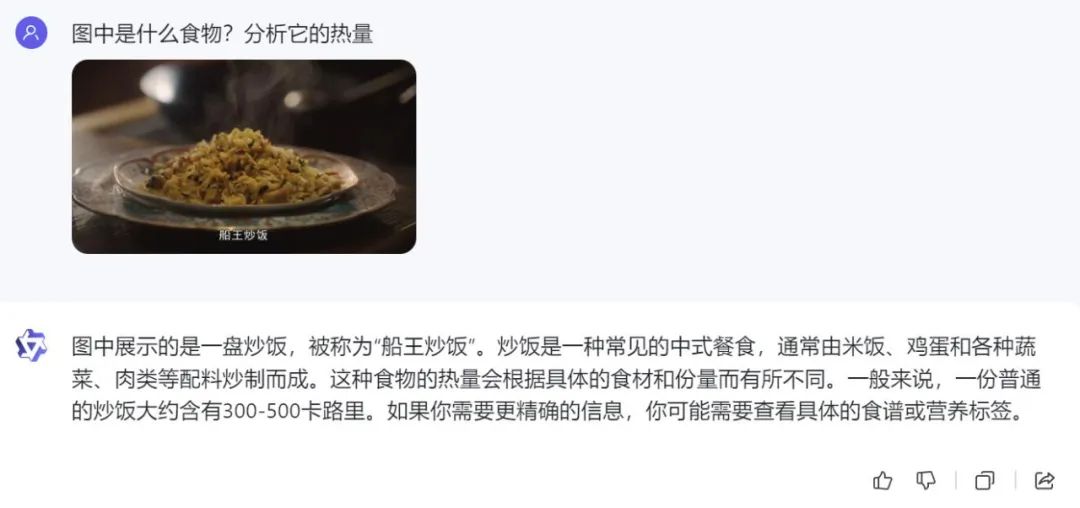
看起来大模型可以理解并联系一些知识。
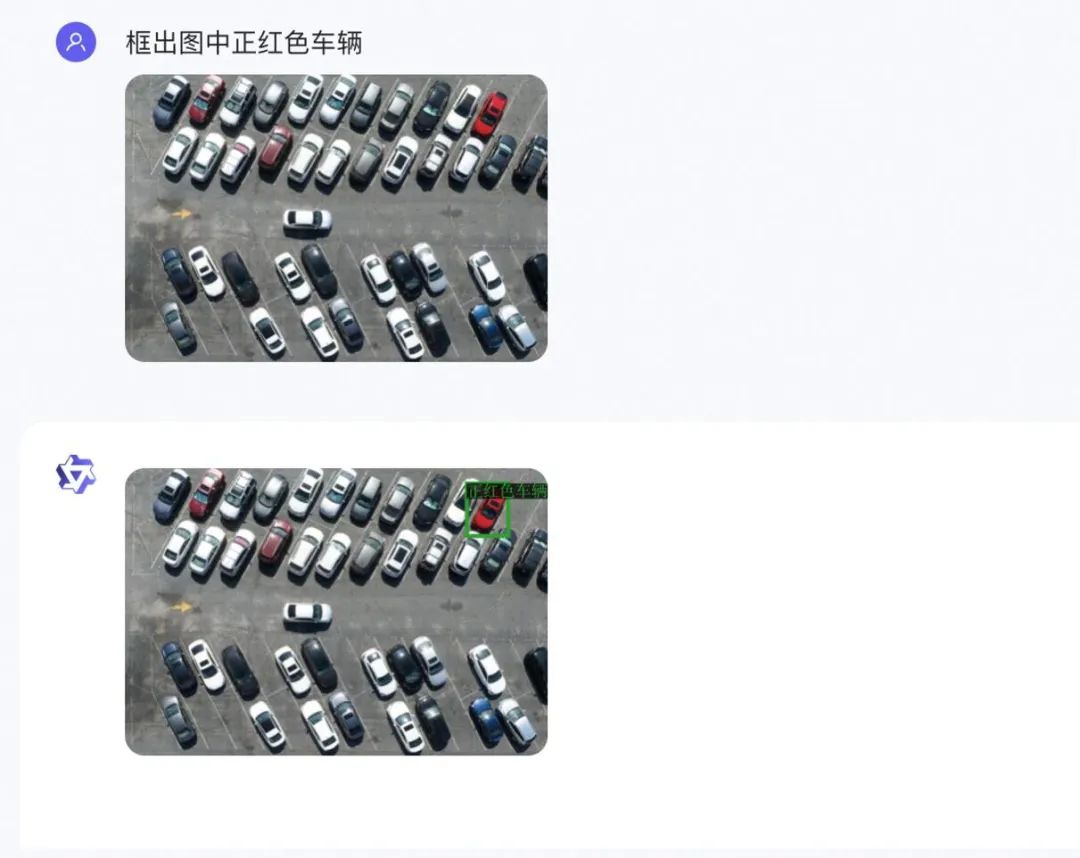
除了基础的描述和识别能力外,Qwen-VL 模型还具备视觉定位能力和针对画面指定区域进行问答的能力。比如,根据指示进行目标检测。
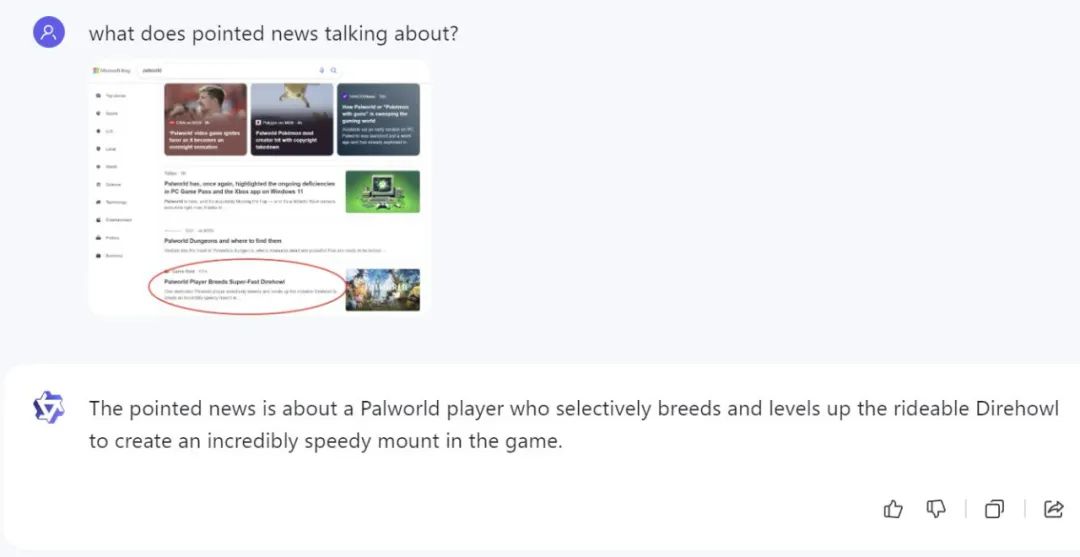
如果你在截图上圈住一部分,它可以对其中的内容进行解释:
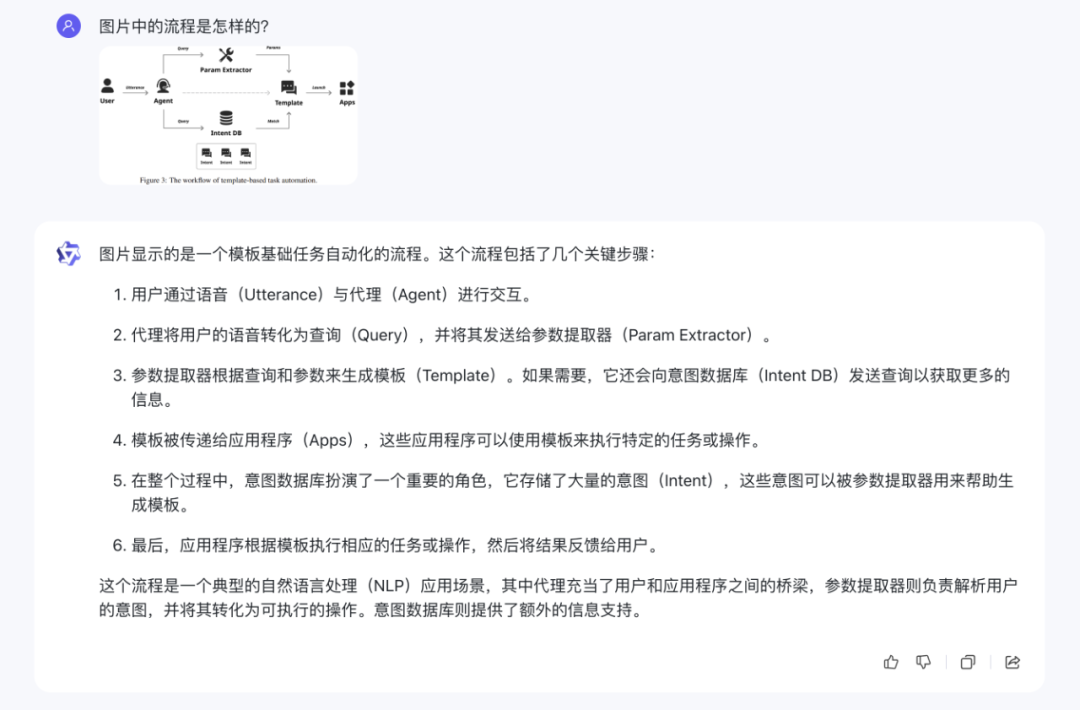
新升级的 Qwen-VL 模型最显著的进步之一是基于视觉完成复杂推理的能力,比如理解流程图这种复杂的表示形式:
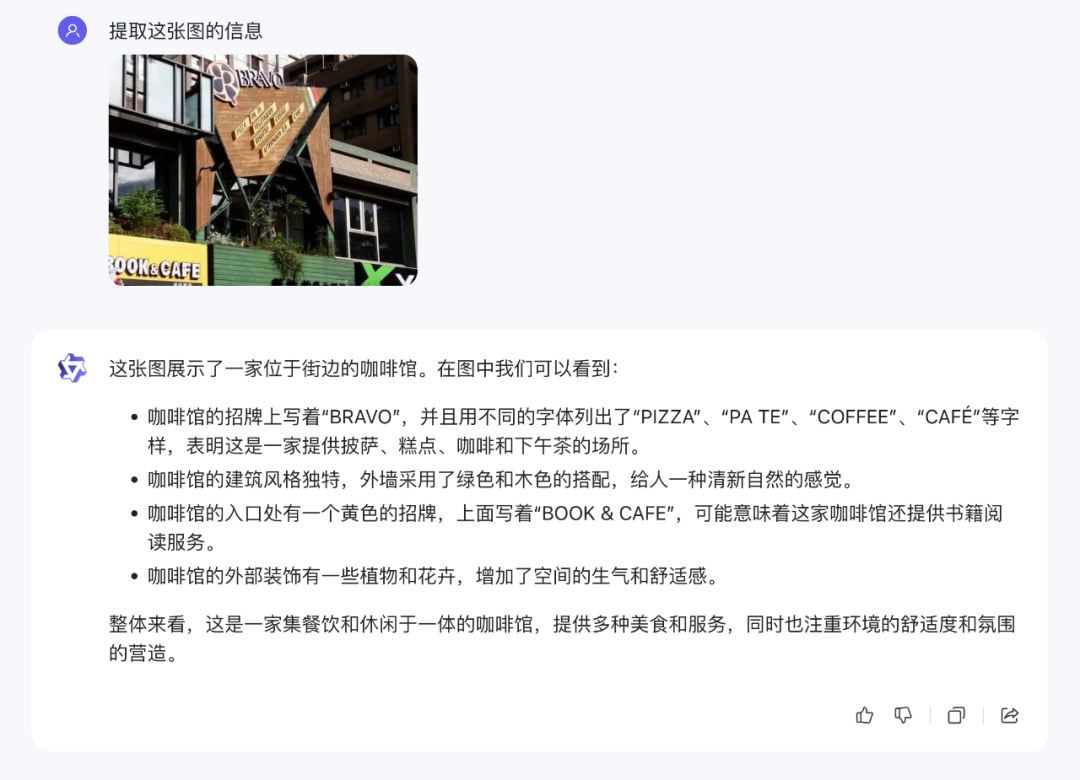
与此同时,升级后的 Qwen-VL 处理图像中文本的能力也有了显著提高,不管是识别中文还是英文文本。Qwen-VL-Plus/Max 可以有效地从表格和文档中提取信息,并将这些信息重新格式化,以满足自定义输出要求。
四个多月就有如此进步,这就让人们开始感叹,阿里通义千问大模型更新够快,能力够强。
阿里多模态大模型,正在爆炸式发展
能够达到如今的水准,Qwen-VL 的技术实力不是一朝一夕炼成的。
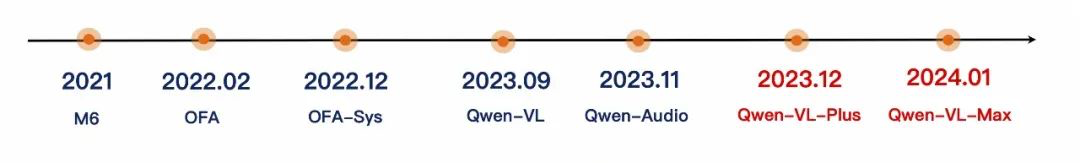
在多模态大模型方向上,阿里很早就开始布局。从 2021 年 M6 系列的预训练 - 微调模式,到 2022 年 OFA (One-For-All) 系列的统一模态表示和任务的模式,再到 OFASys 的系统化 AI 学习的尝试,通义千问团队的目标是做出和人一样能听、能看、能理解 & 沟通的通用 AI 模型(系统)。
2022 年,阿里开源了 OFA。OFA 能通过自然语言来描述一个图文多模态任务,比如输入「描述一下这张图片」,模型就会尝试去产生一个合适的图像描述,打破了大家对通用多模态任务模型效果不如专用多模态模型的传统观念。这篇被 ICML 2022 接收的论文思路启发了后续的许多研究,被谷歌、微软、Meta 等众多国际大厂所引用,是近年来多模态方向的高引论文之一。
2023 年以来,通义千问团队延续了 OFA 的研究路线,利用通义千问语言模型的能力,弥补了过去多模态模型在新任务泛化能力上的缺陷,相关成果就是 2023 年下半年我们看到的开源图文多模态模型 Qwen-VL 和音频多模态模型 Qwen-Audio。
与此同时,阿里云通义实验室的一系列视觉生成类成果,也彻底火出了圈,社交网络上时不时可以看到利用通义 AI 技术生成的动图。
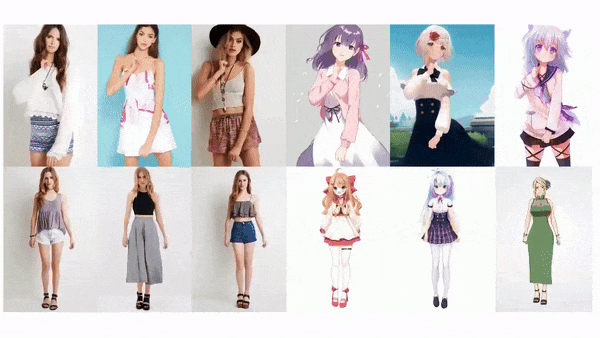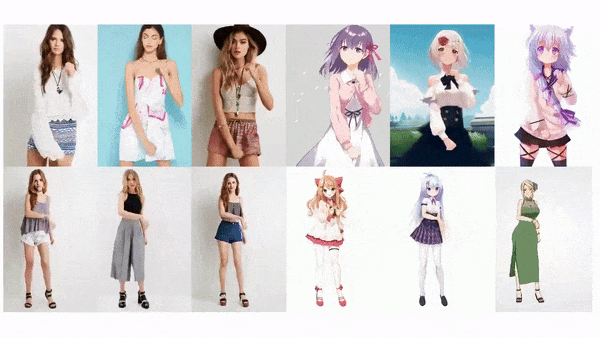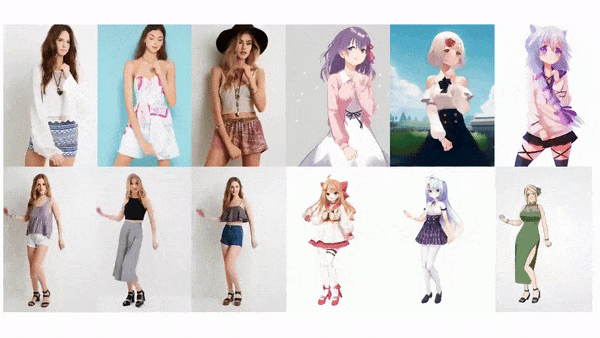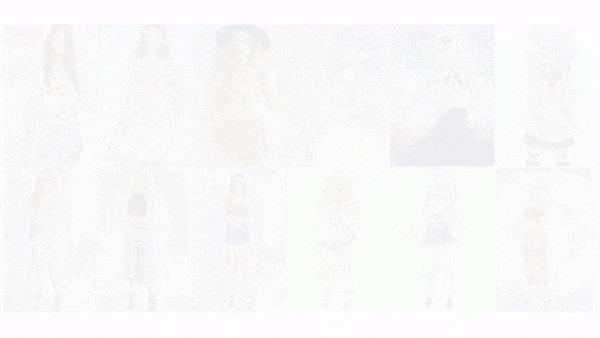
比如只需一张图片即可生成跳舞视频的 Animate Anyone,在国内外都引发了大量关注:
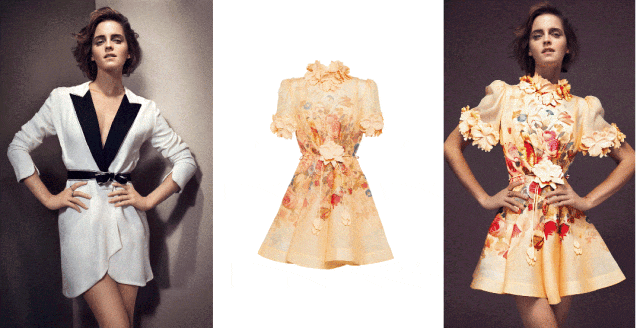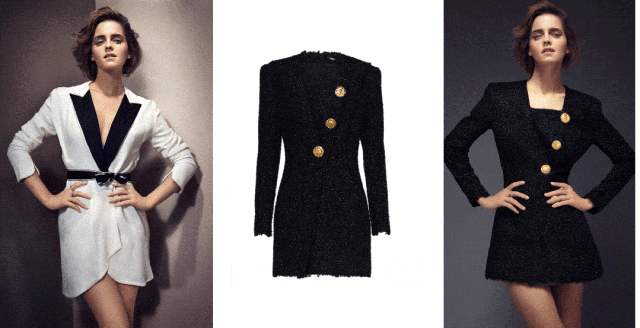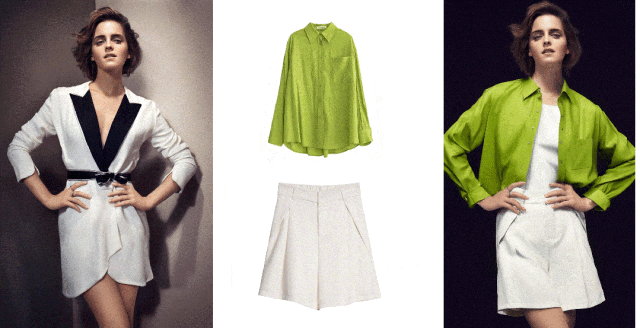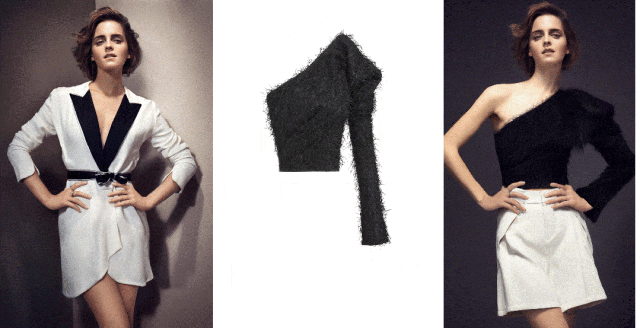
再比如实现真人百变换装的 Outfit Anyone。这项技术不仅能够精确地处理服装的变形效果,并且能调整以适应不同的姿势和体形,实现更加逼真的试穿体验。无论是动画形象还是真人,都可以一键换装,让「QQ 秀」真正升级成了真人版。
此外,通义实验室的文生视频模型 I2VGen-XL 也是实实在在地火了一把,生成的视频兼顾高清、高分辨率、平滑、美观,毫不逊于 Gen2、Pika 效果。
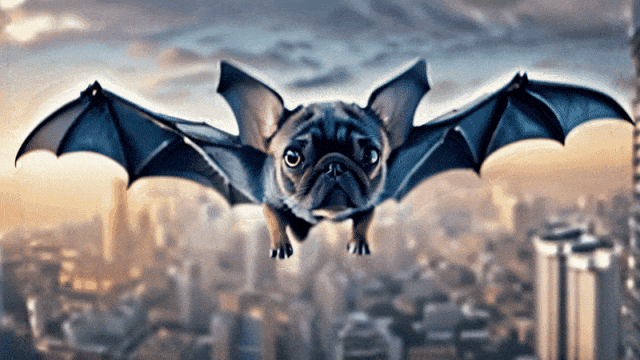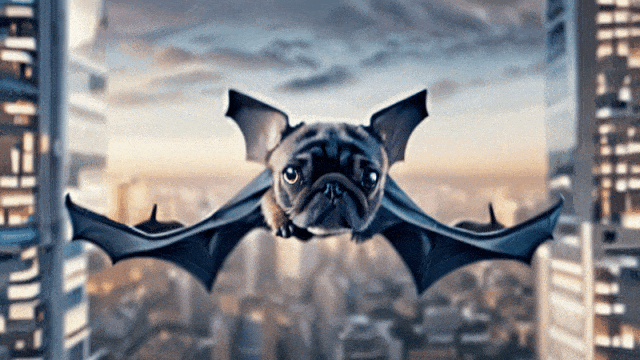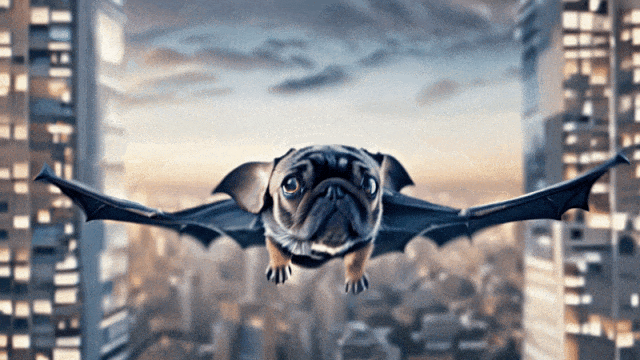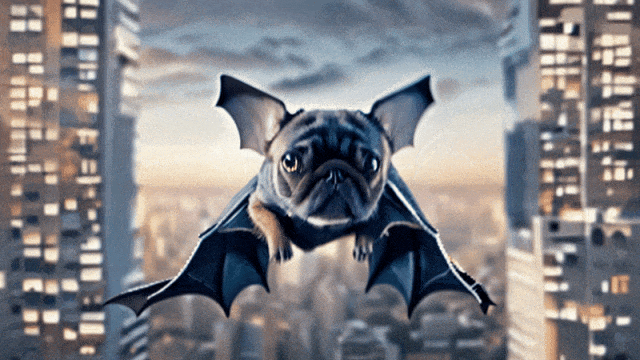
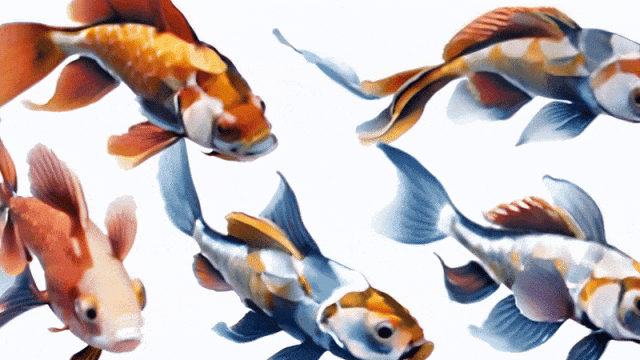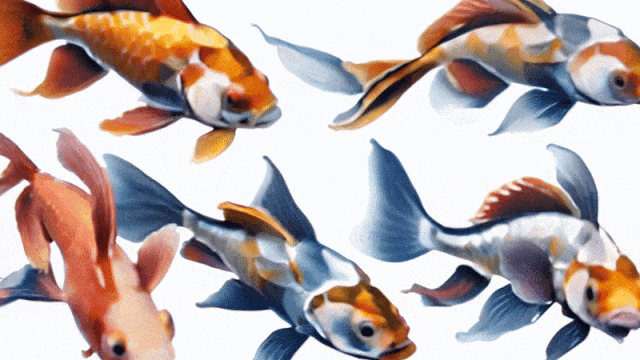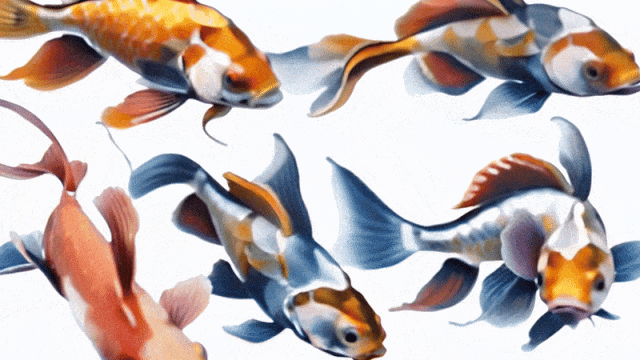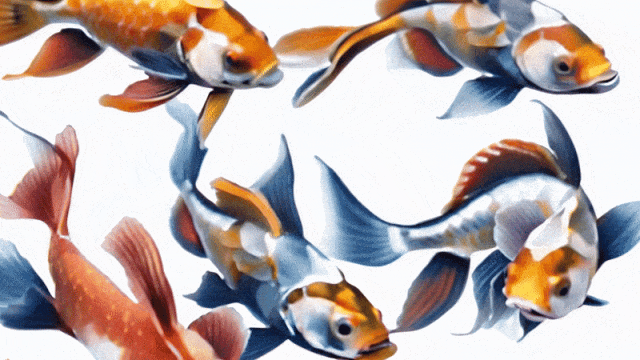
I2VGen-XL 生成视频结果。
众所周知,通用人工智能的求索之路相当漫长,而大模型的技术突破,已经为我们指出了一个光明的方向。过去一年多,人们见证了一场激烈的 AI 技术角逐,赛道上不乏来自中国的选手。
以往,大模型领域的厂商大多以 OpenAI 为标杆,需要承认的是,OpenAI 的最新一代对话大模型 GPT-4 仍然在语言领域保持着领先优势。
但在接下来的 2024 年,在下一个最具爆发潜力的技术方向 —— 多模态大模型上,中国的技术与产品或可与 OpenAI、谷歌这样的选手掰一掰手腕。像 Qwen-VL 这样的国产大模型,能否实现从追平到进一步超越?会不会再诞生一批爆款应用?这些都是接下来一年值得期待的事情。
长远来看,在多模态大模型进一步实用化之后,我们以后可以更加理直气壮,让 AI 自动识别图像和音频中的内容,进行总结、摘要和分析,新技术势必会大幅度提升我们的工作效率;我们在 AR、VR 世界中与环境的交互也会更加便捷,可穿戴设备的体验将会更具真实感,新应用可以大幅改进娱乐和日常体验。
更加直观的是,多模态大模型能够根据每个人的喜好生成定制化内容和产品,对于阿里来说,这件事很重要。
或许,随着多模态大模型技术的突破,我们将很快看到电商领域发生一场革命。










火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。