用来运行Llama3405B优势明显。最近,Meta开源了最新的405B模型(Llama3.1405B),把开源模型的性能拉到了新高度。由于模型参数量很大,很多开发者都关心一个问题:怎么提高模型的推理速度?时隔才两天,LMSYSOrg团队就出手了,推出了全新的SGLangRuntimev0.2。这是一个用于LLM和VLM的通用服务引擎。在运行Llama3.1405B时,它的吞吐量和延迟表现都优于vLLM和TensorRT-LLM。在某些情况下(运行Llama系列模型),它的吞吐量甚至能达到TensorRT
用来运行 Llama 3 405B 优势明显。
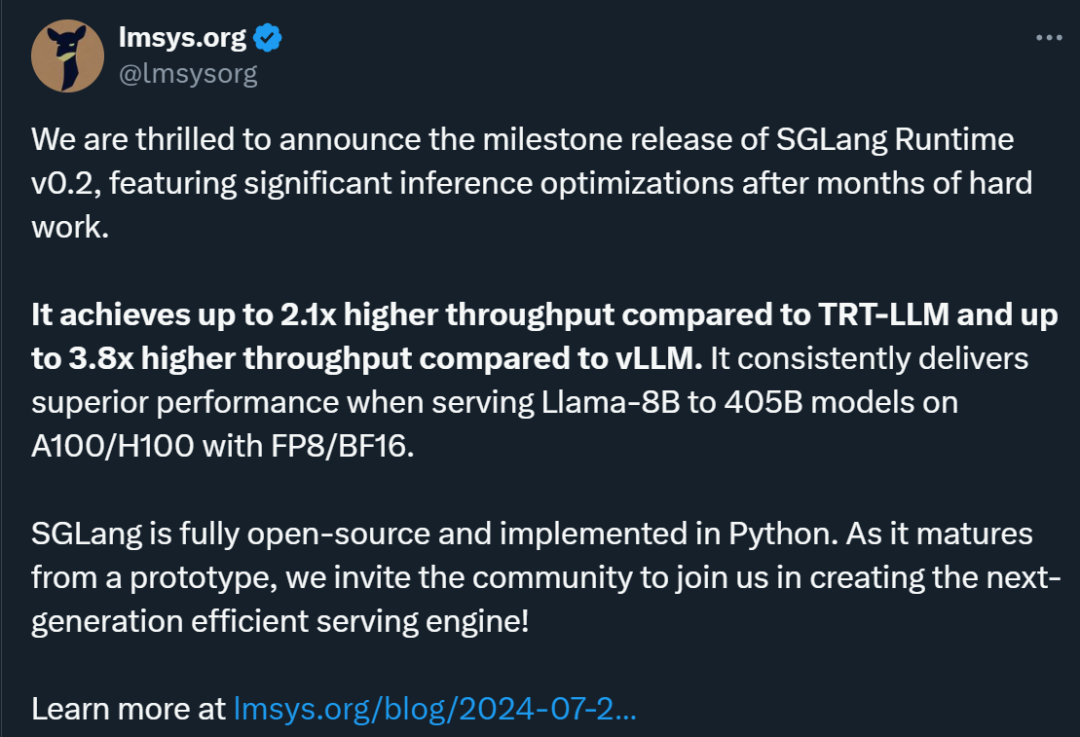
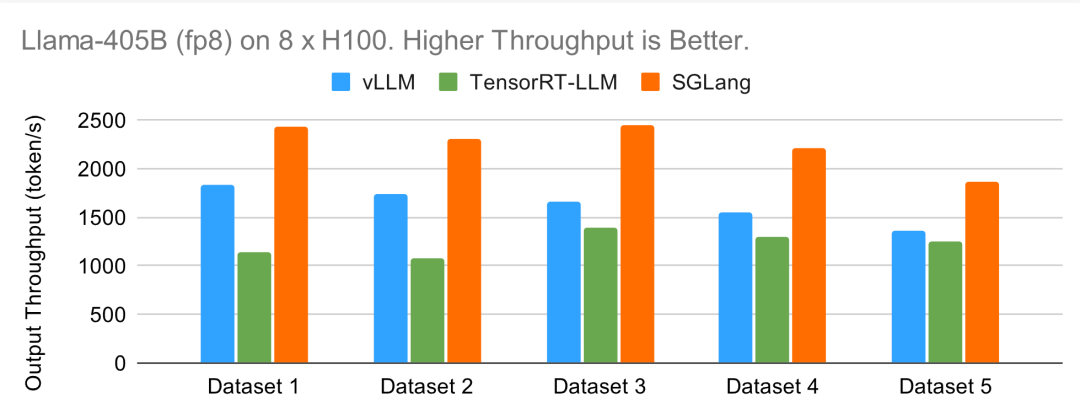
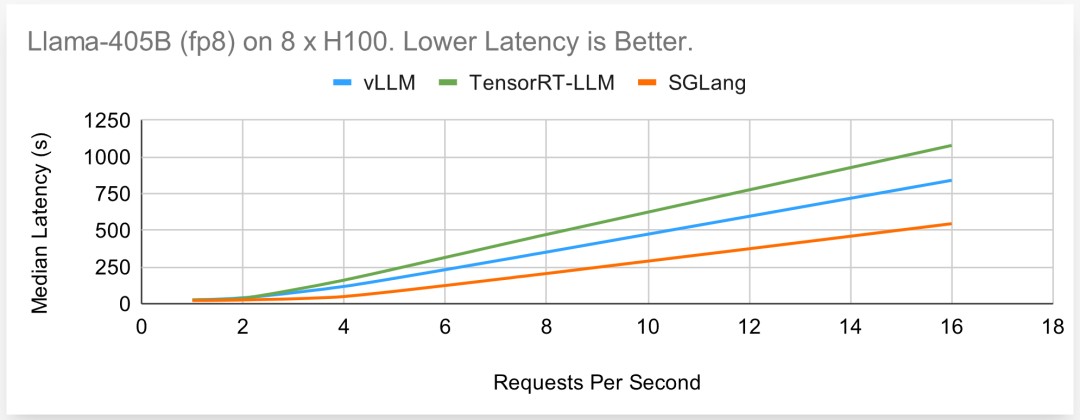
最近,Meta 开源了最新的 405B 模型(Llama 3.1 405B),把开源模型的性能拉到了新高度。由于模型参数量很大,很多开发者都关心一个问题:怎么提高模型的推理速度?时隔才两天,LMSYS Org 团队就出手了,推出了全新的 SGLang Runtime v0.2。这是一个用于 LLM 和 VLM 的通用服务引擎。在运行 Llama 3.1 405B 时,它的吞吐量和延迟表现都优于 vLLM 和 TensorRT-LLM。在某些情况下(运行 Llama 系列模型),它的吞吐量甚至能达到 TensorRT-LLM 的 2.1 倍,vLLm 的 3.8 倍。LMSYS Org 团队是一个由加州大学伯克利分校、加州大学圣地亚哥分校以及卡内基梅隆大学的学生与教职员工共同组建的公开性质的研究团体。他们开发的大模型评测平台 ——Chatbot Arena 已经成为检验大模型能力的重要平台,也被认为是一种相对公平的评测方式。SGLang 是该团队开发的一个用于大型语言模型和视觉语言模型的快速服务框架,于今年 1 月份正式推出,在 GitHub 上已经收获了超过 3k 的 star 量。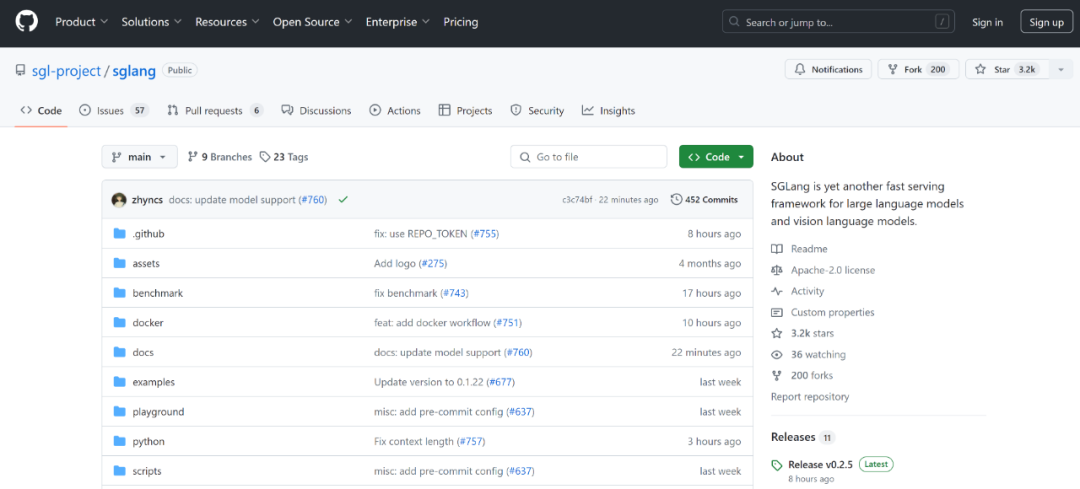
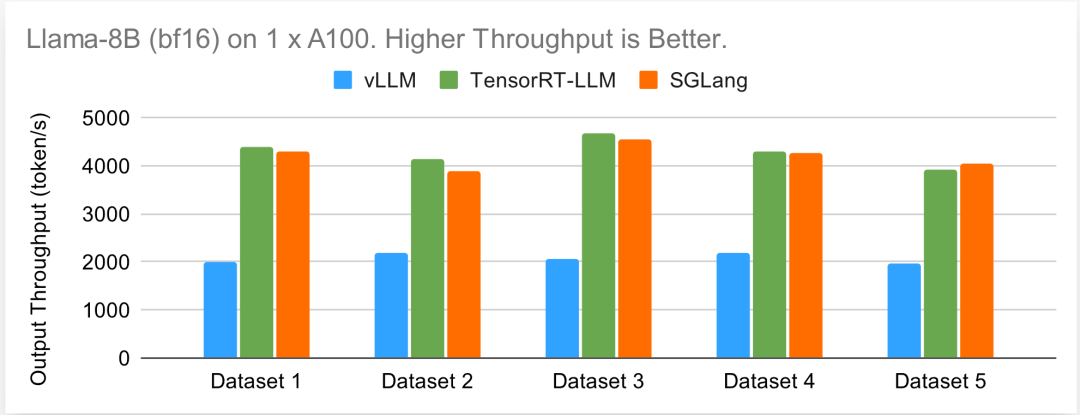
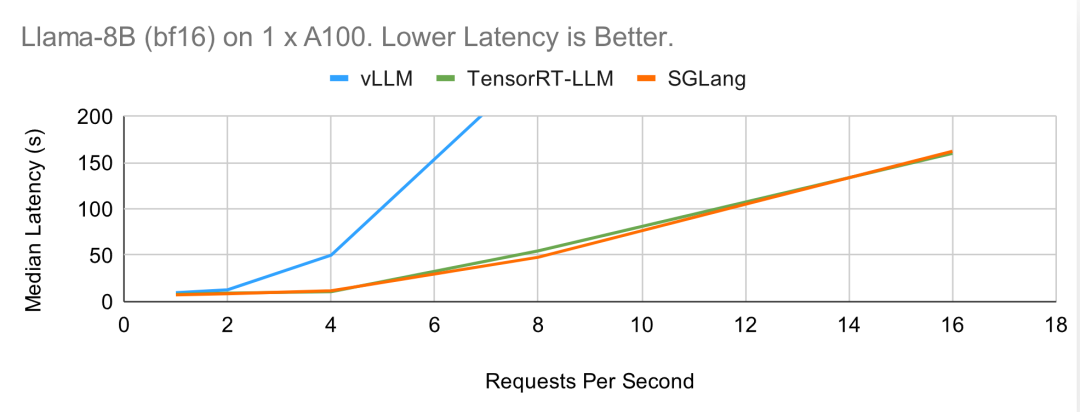
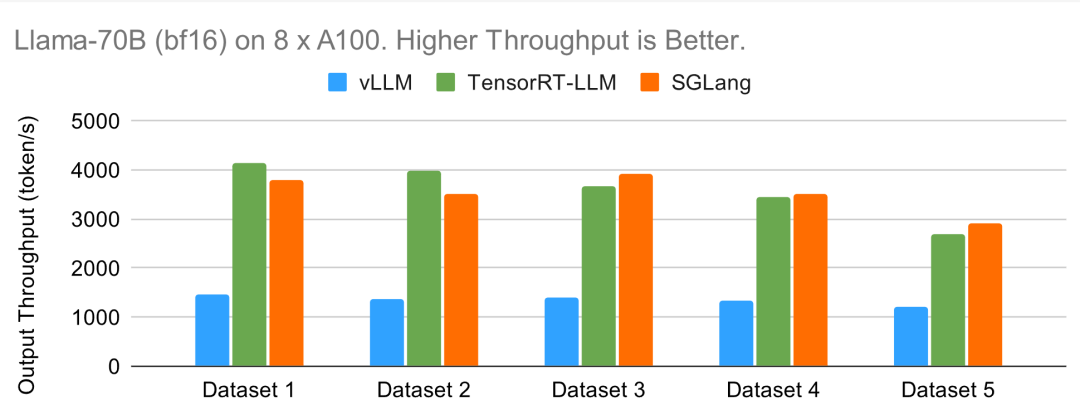
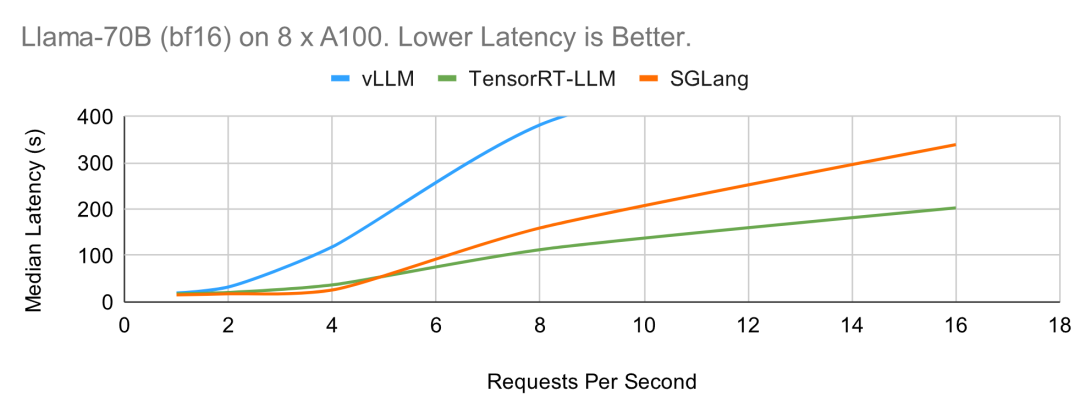
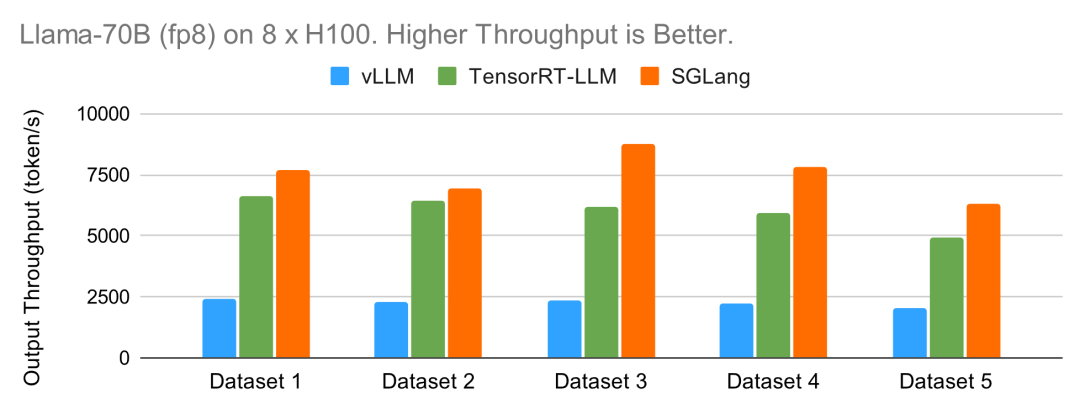
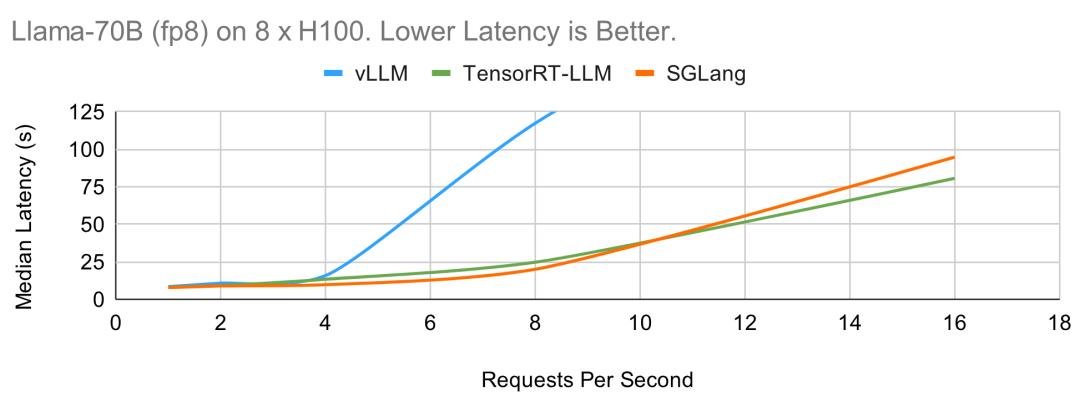
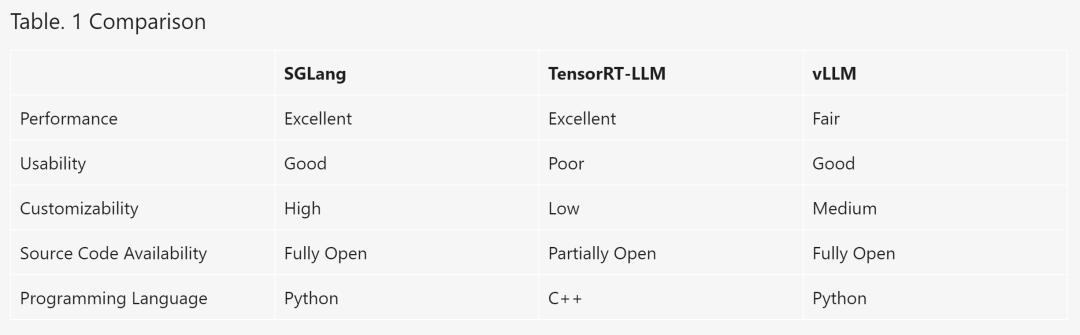
这次的更新效果惊艳,知名 AI 研究者、Lepton AI 联合创始人兼 CEO 贾扬清评价说「我一直被我的博士母校加州大学伯克利分校惊艳,因为它不断交付最先进的人工智能和系统协同设计成果。去年我们看到了 SGLang 的使用,现在它变得更好了。迫不及待地想在产品中部署并尝试新的 SGLang!」为什么 LMSYS Org 要开发并迭代 SGLang 呢?他们在博客中提到,「我们已经运行 Chatbot Arena 平台一年多,为数百万用户提供服务。我们深知高效服务对人工智能产品和研究的重要性。通过运营经验和深入研究,我们不断增强底层服务系统,从高级多模型服务框架 FastChat 到高效服务引擎 SGLang Runtime (SRT)。」「这篇文章的重点是 SGLang Runtime,它是一个用于 LLM 和 VLM 的通用服务引擎。虽然 TensorRT-LLM、vLLM、MLC-LLM 和 Hugging Face TGI 等现有选项各有优点,但我们发现它们有时难以使用、难以定制或性能不佳。这促使我们开发了 SGLang v0.2,旨在创建一个不仅用户友好、易于修改,而且性能一流的服务引擎。」与 TensorRT-LLM 和 vLLM 相比,SGLang Runtime 在处理从 Llama-8B 到 Llama-405B 的模型时,以及在 A100 和 H100 GPU 上使用 FP8 和 FP16 时,在在线和离线场景下都能持续提供卓越或有竞争力的性能。SGLang 的性能始终优于 vLLM,在 Llama-70B 上的吞吐量最高是前者的 3.8 倍。它还经常与 TensorRT-LLM 不相上下,甚至超过 TensorRT-LLM,在 Llama-405B 上的吞吐量最高是前者的 2.1 倍。更重要的是,SGLang 是完全开源的,由纯 Python 编写,核心调度器只用了不到 4K 行代码就实现了。SGLang 是一个开源项目,采用 Apache 2.0 许可授权。它已被 LMSYS Chatbot Arena 用于支持部分模型、Databricks、几家初创公司和研究机构,产生了数万亿 token,实现了更快的迭代。离线:他们一次发送 2K 到 3K 个请求,测量输出吞吐量(token / 秒),即输出 token 数除以总持续时间。他们测试的合成数据集来自 ShareGPT 数据集。例如,I-512-O-1024 表示平均输入 512 个 token、平均输出 1024 个 token 的数据集。五个测试数据集分别为:在线:他们以每秒 1 到 16 个请求 (RPS) 的速率发送请求,测量端到端延迟的中位数。他们使用合成数据集 I-292-O-579。他们使用 vLLM 0.5.2(带默认参数)和 TensorRT-LLM(带推荐参数和调整后的批大小)。所有引擎都关闭了前缀缓存。目的是在没有任何附加功能(如推测解码或缓存)的情况下,对基本性能进行基准测试。他们使用与 OpenAI 兼容的 API 对 SGLang 和 vLLM 进行基准测试,并使用 Triton 接口对 TensorRT-LLM 进行基准测试。Llama-8B 在一个 A100 上运行(bf16)研究者从小型模型 Llama-8B 开始测试。下图显示了每个引擎在五个不同数据集的离线设置下所能达到的最大输出吞吐量。TensorRT-LLM 和 SGLang 都能达到每秒约 4000 个 token 的吞吐量,而 vLLM 则稍逊一筹。下面的在线基准图显示了与离线情况类似的趋势。TensorRT-LLM 和 SGLang 的性能相当,可以保持 RPS > 10,而 vLLM 的延迟在请求率较高时显著增加。Llama-70B 在 8 个 A100 上运行(bf16)至于在 8 个 GPU 上进行张量并行的较大型 Llama-70B 模型,趋势与 8B 相似。在下面的离线基准测试中,TensorRT-LLM 和 SGLang 都能达到很高的吞吐量。在下图的在线结果中,TensorRT-LLM 凭借高效的内核实现和运行时间,显示出较低的延迟。Llama-70B 在 8 个 H100 上运行(fp8)现在来测试 FP8 性能。vLLM 和 SGLang 都使用了 CUTLASS 的 FP8 内核。在离线设置中,SGLang 的批处理调度器非常高效,可以随着批处理规模的增大而继续扩展吞吐量,在这种情况下实现了最高吞吐量。其他系统则由于 OOM、缺少大量手动调整或存在其他开销而无法扩展吞吐量或批大小。在线情况下也是如此,SGLang 和 TensorRT 的中位延迟相似。Llama-405B 在 8 个 H100 上运行(fp8)最后,研究者在最大的 405B 模型上对各种方法的性能进行了基准测试。由于模型较大,大部分时间都花在了 GPU 内核上。不同框架之间的差距缩小了。TensorRT-LLM 性能不佳的原因可能是 405B 模型刚刚问世,而图中使用的版本尚未集成一些最新优化。在在线和离线情况下,SGLang 的性能都是最好的。SGLang 是大型语言模型和视觉语言模型的服务框架。它基于并增强了多个开源 LLM 服务引擎(包括 LightLLM、vLLM 和 Guidance)的许多优秀设计。它利用了来自 FlashInfer 的高性能注意力 CUDA 内核,并集成了受 gpt-fast 启发的 torch.compile。此外,研究者还引入了一些创新技术,如用于自动 KV 缓存重用的 RadixAttention 和用于快速约束解码的压缩状态机。SGLang 以其完全用 Python 实现的高效批处理调度器而闻名。为了进行公平比较,本博客测试了这些服务引擎在关闭特定场景或工作负载优化(如前缀缓存和推测解码)后的基本性能。SGLang 的提速是通过适当的工程设计实现的。SGLang 基于 Python 的高效批处理调度器具有良好的扩展性,通常可与使用 C++ 构建的闭源实现相媲美,甚至更胜一筹。表 1 比较了 SGLang、TensorRT-LLM 和 vLLM 的各个方面。在性能方面,SGLang 和 TensorRT-LLM 都非常出色。在可用性和可定制性方面,SGLang 的轻量级和模块化内核使其易于定制,而 TensorRT-LLM 复杂的 C++ 技术栈和设置说明使其更难使用和修改。SGLang 的源代码完全开源,而 TensorRT-LLM 仅部分开源。相比之下,vLLM 的 CPU 调度开销较高。研究者还表示,未来他们还将开发长上下文和 MoE 优化等新功能。1、使用 pip、源代码或 Docker 安装 SGLang:https://github.com/sgl-project/sglang/tree/main?tab=readme-ov-file#install# Llama 8Bpython -m sglang.launch_server --model-path meta-llama/Meta-Llama-3.1-8B-Instruct# Llama 405Bpython -m sglang.launch_server --model-path meta-llama/Meta-Llama-3.1-405B-Instruct-FP8 --tp 8
3、使用 OpenAI 兼容的 API 发送请求:curl http://localhost:30000/v1/completions \-H "Content-Type: application/json" \-d '{"model": "default","prompt": "Say this is a test","max_tokens": 7,"temperature": 0 }'python3 -m sglang.bench_serving --backend sglang --num-prompts 1000
重现基准的说明位于 sglang/benchmark/blog_v0_2。对于所有基准测试,研究者都设置了 ignore_eos 或 min_length/end_id 以确保每个引擎输出相同数量的 token。他们曾尝试使用 vLLM 0.5.3.post1,但它在高负载情况下经常崩溃,与部分基准测试中的 vLLM 0.5.2 相比,vLLM 0.5.3.post1 性能似乎差不多甚至更差。因此,他们报告的是 vLLM 0.5.2 的结果。虽然他们知道不同的服务器配置会对服务性能产生重大影响,但他们主要使用每个引擎的默认参数来模拟普通用户的情况。对于 8B 和 70B 模型,他们使用 meta-llama/Meta-Llama-3-8B-Instruct 和 meta-llama/Meta-Llama-3-70B-Instruct bf16 检查点,以及 neuralmagic/Meta-Llama-3-70B-Instruct-FP8 fp8 检查点。对于 405B 模型,他们在所有基准测试中都使用了虚拟权重。由于 TensorRT-LLM 最新图像 r24.06 不支持官方 meta-llama/Meta-Llama-3.1-405B-FP8 检查点中的 fbgemm_fp8 量化,他们在所有框架中都使用了每层 fp8 量化,并对除 lm_head 以外的所有层进行了量化。他们相信这样可以对所有引擎进行公平的比较。A100 和 H100 GPU 为 80GB SXM 版本。参考链接:https://lmsys.org/blog/2024-07-25-sglang-llama3/