


29 秒视频教会机器人新技能,清华北理工联合开源 HOST
清华大学与北京理工大学等联合开源HOST框架,使机器人仅需观看平均29秒的人类演示视频,即可在不更新模型参数、不采集新数据的情况下执行新任务。在50项未见过的桌面操作任务中,技能复现成功率达62%,数据量减少至1/50,学习时间缩短至1/507,且不遗忘旧技能。
教机器人学会一个新技能,需要几步?
如果你看过波士顿动力机器人的跑酷视频,或者 Figure 01 在工厂里搬运箱子的 demo,可能会觉得机器人已经很聪明了。但一个容易被忽视的事实是:这些机器人展示的每一个技能,背后都是工程师团队数月的数据采集和模型训练。
过去的标准答案是什么?专业工程师用昂贵的遥操作设备采集数百条演示数据、花数小时微调模型参数,然后祈祷机器人学会新技能之后别把旧技能忘光。现在,这个流程被彻底改写了。
8月3日,自变量机器人与北京理工大学、清华大学联合发布并开源了 HOST 框架(Human-to-robot One-Shot Skill AcquisiTion,人类到机器人单样本技能获取)。机器人只需观看一段平均29秒的人类演示视频,就能在不更新模型参数、不采集新数据的情况下执行全新任务。
测试涵盖放水果、堆碗、擦盘子、插笔等50项训练阶段从未见过的桌面操作任务,HOST 的技能复现成功率达到62%。根据发表在 arXiv 上的论文(2607.20033),相比当前主流的 Pi-0.5 配合微调方案,所需数据量减少至 1/50,学习时间缩短至 1/507,成功率显著领先。
更关键的是,HOST 的技能习得过程不改变模型权重——这意味着它不会“学新忘旧”。论文数据显示,在微调方案学习新技能后,最强基线模型(Wall-OSS+SFT)在旧任务上的表现下降至原来的43%,而 HOST 几乎完整保留了所有已掌握的技能。
机器人学习范式的转折
机器人学习人类技能的核心难点,长期以来被归结为一个问题:如何弥合机器人与人类之间的“身体鸿沟”?
人类有双臂、五指关节、灵活的躯干;机器人可能是单臂、夹爪甚至轮式底盘。直接让机器人照搬人类手臂的轨迹和角度,几乎不可能成功,因为两者的运动学和动力学模型完全不同。
过去十年,行业的主流解法是“大量数据暴力拟合”:用遥操作设备采集数以万计的机器人执行轨迹,然后训练端到端模型。这条路走得通,但代价极高。每一次教机器人新技能,都需要专业工程师重新采集数据、重新微调模型,成本以数万元计。更致命的是,这种“专才专用”的模式意味着,每一个新技能的学习都是一次从头再来的过程,旧技能积累的经验几乎无法复用。
HOST 的突破在于,它将问题的原始出发点从“动作模仿”转向了“结果推理”。机器人不再试图模仿人类的肢体动作,而是观察人类完成任务后的结果状态,再反推自己需要执行的行动序列。这一转变绕开了“人机身体结构差异”这个不可约的难题,将学习目标从“复现过程”重新定义为“达成结果”。
这一思路其实借鉴了认知科学中的“观察学习”理论——人类在面对陌生任务时,并非通过反复试错来掌握技能,而是基于已有经验在脑中模拟动作的预期效果,再据此执行。HOST 将这一理论工程化,实现了从“训练时微调”到“推理时即获取”的范式转变。
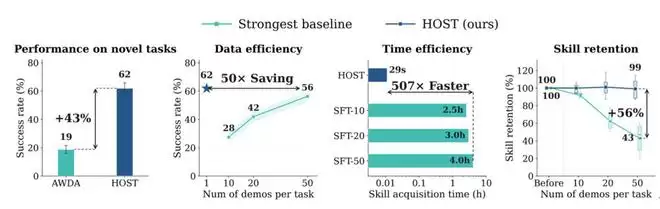
HOST 与传统方法在数据效率、时间效率和技能保留率上的全面对比
“结果反推”:让机器人学会“想”再“做”
HOST 的核心创新在于一套“结果先行”的推理范式。与传统方法“看到人类动作 → 映射为机器人动作”的直线思路不同,HOST 的处理流程分为三步:
第一步:任务阶段判断。机器人观看人类视频时,首先判断当前任务进行到哪一阶段。以烹饪为例,系统需要识别出“此刻是切菜阶段还是炒菜阶段”。这一判断并非简单的时间戳对齐,而是基于视觉内容的任务进度语义理解。
第二步:视角迁移。将人类执行完动作后的画面,转化为机器人自身视角和身体结构下的画面。这一步解决的是“身体鸿沟”问题——人类用五指完成的任务,机器人需要用夹爪完成,两者的视觉画面和运动逻辑都需要转换。
第三步:动作反推。从目标画面反推需要执行的动作序列并执行。机器人不是在“复制”人类动作,而是在“求解”一个问题:要达成这个结果状态,我应该怎么做?
这种“先想象结果,再反推动作”的机制,使得 HOST 具备了传统方法不具备的泛化能力。即使执行过程中物品位置被移动,机器人也能根据目标状态重新规划动作,继续完成任务。
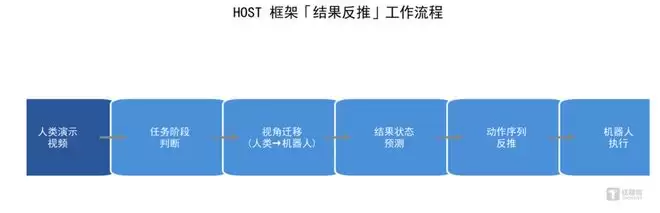
HOST 框架「结果反推」工作流程示意图
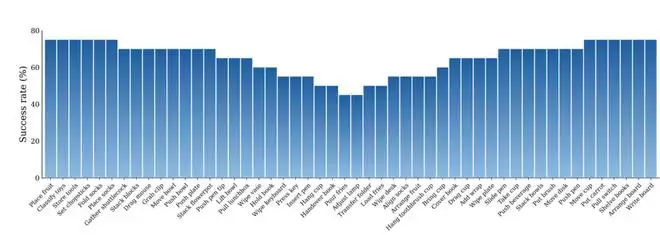
HOST 在50项未见过的操作任务上的技能习得结果
视频学习有一个容易被忽视的难题:人类与机器人的执行速度不同步。同样经过10秒,视频中的人类可能已完成切菜并开始炒菜,而机器人仍在切菜阶段。如果按简单的时间轴对齐,机器人将丢失任务进度信息,导致后续动作全部错位。
HOST 的解决方案是“按任务进度对齐”策略。系统将视频每一帧和机器人操作的每一步都映射到同一向量空间中,再通过动态时间规整(Dynamic Time Warping)算法,自动建立人类视频帧与机器人操作步骤之间的对应关系。
据论文披露,该方法将对齐误差降低了一个数量级——从基于时钟时间对齐的 0.079 降至 0.006(平均绝对进度差),使机器人执行与视频示范能够精准同步。这意味着,即使人类以快进或慢速演示,机器人也能正确理解每个阶段应该完成的任务目标。这一技术的工程价值在于:它大幅降低了对人类演示视频的“规范性”要求——普通人不需要刻意放慢动作或标准化流程,随手拍摄的视频即可作为教学素材。
双专家架构:学新不忘旧
HOST 的技术底座是一个带有视觉预测功能的级联策略模型,采用双专家混合架构。其核心设计是将技能学习拆分为两个阶段。
第一阶段:同体预训练。模型首先在193,462条机器人同体轨迹数据上预训练,覆盖229项任务。这一阶段的目标是让机器人学会“跟随演示过程”的基本能力——通过预测同一任务另一条轨迹的未来状态和动作来建立基础技能框架。
第二阶段:人机视频训练。在预训练基础上,使用5,847条人类-机器人配对演示数据进行微调。这一阶段将模型的能力从“机器人跟随机器人”扩展到“机器人跟随人类”,实现跨本体迁移。
这种分阶段训练设计基于数据可获取性的考量。机器人执行任务的轨迹数据相对容易采集,而人与机器人执行同一任务的配对数据则极为稀缺。通过先利用机器人视频打好基础,再向人类视频迁移,HOST 在有限数据条件下实现了高效的跨本体技能学习。
由于 HOST 在推理时完全不修改模型参数,技能习得更像是“加载了一个新菜谱”而非“重塑了厨师的大脑”。旧技能以模型权重形式存在,新技能以推理时输入的形式存在,两者互不干扰。同一台机器人,今天学会切菜,明天学会擦桌子,只需更换输入视频即可,无需重新配置或训练。
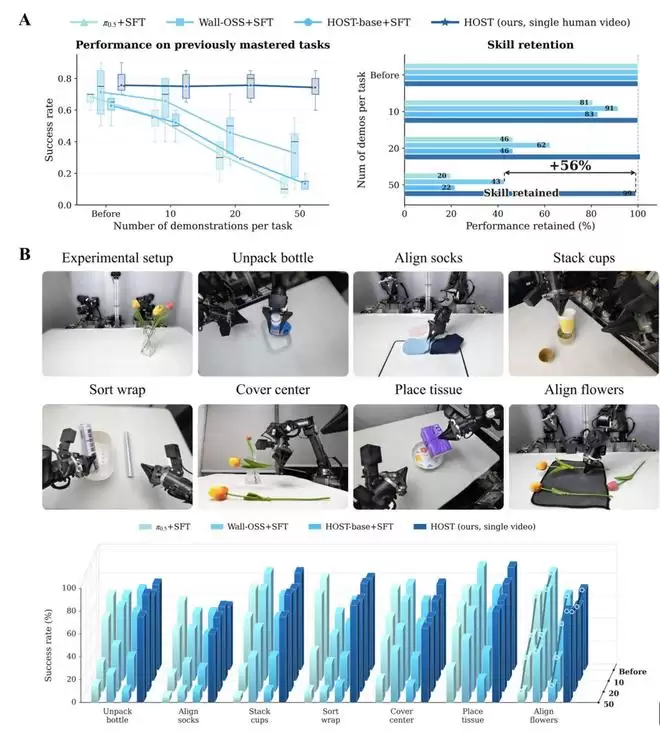
HOST 在旧任务上的表现几乎不变,而微调方案学习新技能后旧技能保留率大幅下降
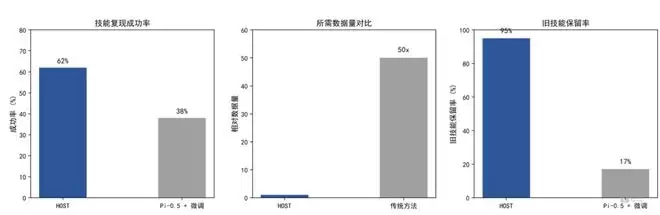
HOST 与传统方法在成功率、数据量、技能保留率上的对比(基于论文数据整理)
开源的意义:从专业工具到普通人可用
HOST 的论文、代码和模型权重已全部开源至 GitHub 和 Hugging Face。项目主页提供了完整的文档和示例教程。研究团队表示,开源的目的是“将机器人技能获取从依赖专业人员采集数据、反复训练的专业流程,转变为普通人通过一段视频即可完成教学的方式”。
这一目标指向具身智能行业最核心的瓶颈:数据获取成本。目前,具身智能领域的头部玩家大多走“大规模数据采集”路线——用上百台机器人同时采集数据,训练通用基础模型。但这条路天然存在两个问题:一是遥操作数据采集成本极高,一条有效演示的成本可能在数百到上千元;二是长尾场景覆盖不足,大多数家庭场景下的任务,机器人从未见过,而这些罕见场景恰恰是用户最需要机器人学会的。
HOST 提供了一条不同的路径:不追求数据规模的无限扩张,而是通过算法创新降低单次学习的门槛。如果机器人能够通过观看一段人类视频就学会新技能,那么“数据”就不再是遥操作工程师的专利——每一个普通人都可以成为机器人的“老师”。
当然,HOST 并非没有局限。62% 的成功率在单样本学习场景下已属突破性成果——作为参考,人类在仅观看一次演示后执行陌生任务的首次成功率也并非100%。但这一数字意味着在近四成场景下机器人仍会失败,距离“可靠部署”还有差距。目前测试的50项任务以桌面操作类为主,在更复杂的动态场景中表现如何尚待验证。但正如研究团队在项目主页所言:“HOST 是迈向通用机器人学习的第一步,我们希望社区能在此基础上走得更远。”
值得注意的是,HOST 的发布并非孤立事件。2026年以来,具身智能领域呈现“开源加速”的趋势——从谷歌的 Open X-Embodiment 到小米的 Xiaomi-Robotics-1,行业正在从“闭门造车”转向“共建生态”。自变量团队选择在项目之初就全面开源,无疑顺应了这一趋势。
从更宏观的视角来看,HOST 的意义在于它为“机器人的技能获取”提供了一条不同于“规模化”的路径。在 Scaling Law 仍主导AI叙事的今天,HOST 证明了算法创新同样可以大幅降低数据依赖——这或许为具身智能行业提供了一个值得深思的方向:与其无限堆数据,不如教会机器人如何更聪明地学习。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。