


RSS 2026 Manipulation 论文报告汇总1
作者:小宇宙叶知秋
时间:2026-08-04
浏览:2
RSS2026在悉尼开幕,主会接收约160篇论文。操作环节展示9项突破,趋势是摆脱数据依赖,迈向少样本强泛化。代表成果包括一次演示合成数据、从人类视频学习、触觉对齐、手术机器人泛化、触觉视觉融合、水下零样本迁移、VLA数据配比、安全纠偏及触觉接地等。
本文目录
 **看人类视频,机器人学会了用刀切苹果**
互联网上充斥着人类切苹果、倒饮料、叠杯子等操作各种工具的视频。但由于人类手部与机器人灵巧手在结构上差异巨大,这些视频的训练价值长期遭到忽视。这种“具身鸿沟”让直接从人类视频中预训练变得极其困难。上海人工智能实验室和清华大学的研究者决定正面攻克这一难题。
他们设计的DexImit是一个四阶段的自动化生成管线:首先从任意视角重建精度极高的手-物交互三维结构;接着对复杂任务进行子任务分解与双臂调度规划;然后合成与人类演示高度一致的机器人轨迹;最后通过综合数据增强确保其能零样本部署到真实世界。
这套流程的革命性在于,它能直接吃透互联网上的任意人类操作视频,甚至AI生成的视频。从工具使用到精细操作,当灵巧手不再需要从头采集昂贵的训练数据,机器人“学会动手”的门槛被大幅降低了。
 **触觉手套教机器人拧灯泡,无需配对数据**
仅需人类戴上触觉手套演示一次,机器人便能掌握拧灯泡的技巧——这在以往简直是天方夜谭。穿戴设备采集的人类触觉信号直观丰富,但如何将其迁移到传感器和本体结构截然不同的机器人上,一直是个痛点。现有方法大多要求设备高度一致且需要成对的训练数据,严重限制了扩展性。
来自UC Berkeley和Meta等机构的研究者提出了令人耳目一新的TactAlign:用整流流(rectified flow)将人类和机器人的触觉观测映射到同一个共享潜在空间。最关键的是,这个对齐过程不需要配对数据集、人工标注或特权信息。对齐的“锚点”直接来源于手物交互中自然产生的伪配对。简单来说,无论是人手还是机械手,在抓取同一物体时,其物理交互模式必然存在某种共性。
在接触密集型任务上,TactAlign显著提升了人机策略的迁移效果。在拧灯泡这种高灵巧任务中,仅需不到五分钟的人类触觉数据,就成功实现了零样本迁移。
 **跨越“虚实与场景鸿沟”**
解决了数据来源,下一个难题是“环境突变”。在仿真里学得好好的,到了真实世界就翻车;在实验室里能抓水杯,到了水下或手术室就失控。如何让机器人拥有抗干扰的泛化能力?
**手术室里,机器人学会了看眼色行事**
手术机器人面临的环境远比工厂流水线复杂:组织会变形、视野会遮挡,任何一个小失误都可能致命。传统手术机器人严重依赖多相机系统和海量演示数据,导致技术落地异常困难。对此,德国国家肿瘤疾病中心的研究团队给出了一个更轻量的答案。
他们提出了一种监督式混合专家(MoE)架构,能像插件一样叠加在任意自主策略之上。令人惊讶的是,仅配合立体内窥镜图像作为唯一输入,叠加MoE后的轻量级Action Chunking Transformer仅需不到150条演示数据,就能学会复杂的“肠道抓取与牵拉”长时序协作任务。在此过程中,机器人不仅要读懂外科医生的视觉提示,准确抓取可变形组织,还要保持稳定的牵拉。
更值得关注的是其泛化表现。面对新场景,通用视觉-语言-动作模型完全失效,标准ACT也频频掉链子;而MoE增强版本不仅在弱光、遮挡及全新抓取位置等干扰下保持稳健,还成功在离体猪组织上实现了零样本泛化,甚至完成了体内猪手术的初步验证。这无疑为手术机器人的临床落地释放了强烈的积极信号。
 **触觉+视觉:让机器人摸得准、刮得稳**
使用工具看似简单,实则需要解决“用哪里”(语义理解)和“用多大力”(物理精度)两个层次的挑战。当前的视觉-语言-动作模型擅长前者却在力控上捉襟见肘,而纯触觉策略虽精度高却不够通用。更棘手的是,大规模采集真实触觉数据的成本极高,且仿真与真实传感器数据之间存在复杂的非线性变形,导致零样本迁移几乎难以实现。
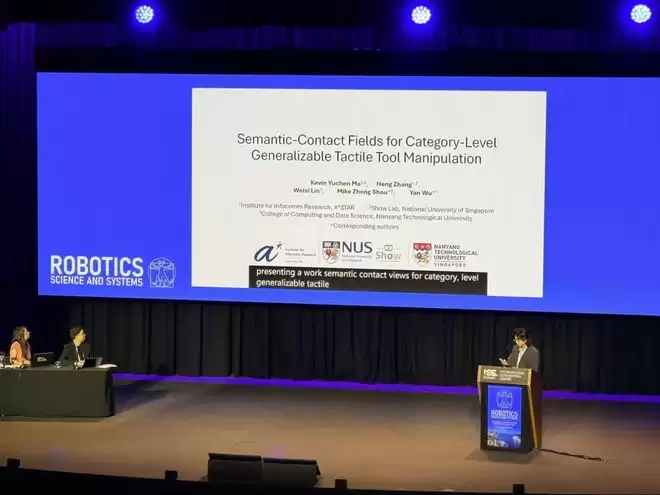
新加坡A*STAR和NUS的研究团队提出了Semantic-Contact Fields(SCFields),将视觉语义与密集接触估计融合到统一的三维表示中。他们设计了一个两阶段的Sim-to-Real学习管线:先在大规模仿真数据上预训练接触先验,再用几何启发式和力优化在少量真实数据上进行伪标注微调。
最终,这个力感知的表示被送入扩散策略作为观测输入。实验证明,SCFields能在未见过的工具实例上实现类别级泛化,大幅超越纯视觉和原始触觉基线方法。用仿真批量学、用真实数据精调,正在成为触觉操作的新范式。
 **水下抓取,不用下水采数据**
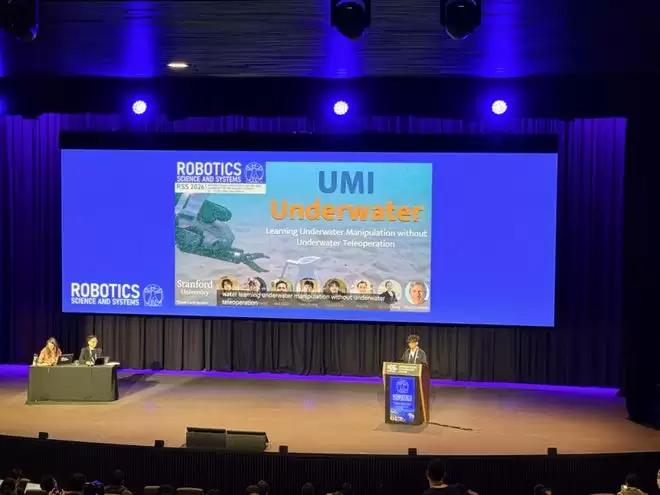
水下机器人操作面临着独特困境:水体会导致光线散射和颜色严重失真。如果要在多样化场景中采集水下演示数据,不仅需要专业潜水设备和人员,成本更是天文数字。斯坦福大学和哥伦比亚大学的研究者想到了一个巧妙的迂回策略:在水上教,到水下用。
UMI-Underwater系统包含一种基于深度信息的可供性表示。由于深度图在不同光照和水质条件下远比RGB图像稳定,它顺理成章地成为了弥合陆地与水下域间差距的“通用语言”。系统在陆地手持演示数据上训练模型,通过几何对齐即可零样本部署到水下。同时,该系统还配合了一个自监督数据采集管线,让机器人自主在水下试错并记录成功案例。
泳池实验显示,该方法在水下抓取性能和鲁棒性上全面超越了纯RGB方法,甚至能泛化到仅在陆地数据中间出现过的物体。海洋探索的自动化大门,正在以更低成本的方式徐徐打开。
 **重塑“底层逻辑”,用机制为模型兜底**
除了数据和环境,大语言模型的架构直接套用在机器人上并不完美。研究者们开始回归机器人的物理本质,探寻最优的数据配比、控制闭环与安全机制。
**VLA模型该用什么数据?89个策略揭晓答案**
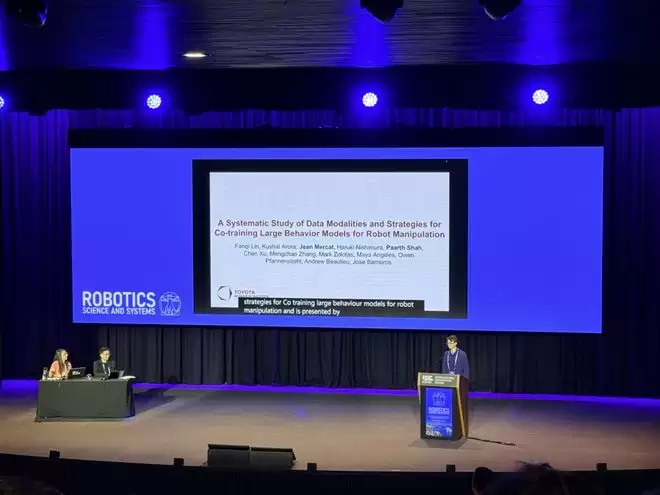
视觉-语言-动作(VLA)模型是当前通用机器人策略的主流架构,但在共训练的数据配比上一直缺乏系统性指导。除了机器人的本体数据,到底该掺杂视觉-语言数据、跨本体数据、人类视频,还是离散动作token?Meta AI的研究团队用一场大规模实证研究给出了定论。
这项研究规模惊人:利用4000小时操作数据和5000万视觉-语言样本,训练了89个VLA策略,并进行了超过六万次测试。结论非常清晰:视觉-语言数据和跨本体机器人数据堪称“黄金搭档”,两者联合共训练能显著提升模型对分布偏移、未见任务以及自然语言指令的泛化能力;相比之下,离散动作token则收效甚微。
研究还发现,仅用机器人数据训练会严重退化大模型的视觉语言理解能力,但加入共训练数据后即可有效恢复。这些翔实的结论,为社区构建下一代通用机器人策略提供了宝贵的“数据菜谱”。
 **两次演示、九成成功率:把机器人“滑”进安全区**
机器人操作最怕遇到突发状况:物体位置变了、角度偏了或受到外界扰动。此时,仅靠几次演示训练出来的端到端策略几乎必然会“掉出分布”,进而做出不可预测的危险动作。香港科技大学的研究团队提出了一种新范式:与其死磕数据,不如在推理时主动把系统“拉回”安全区。
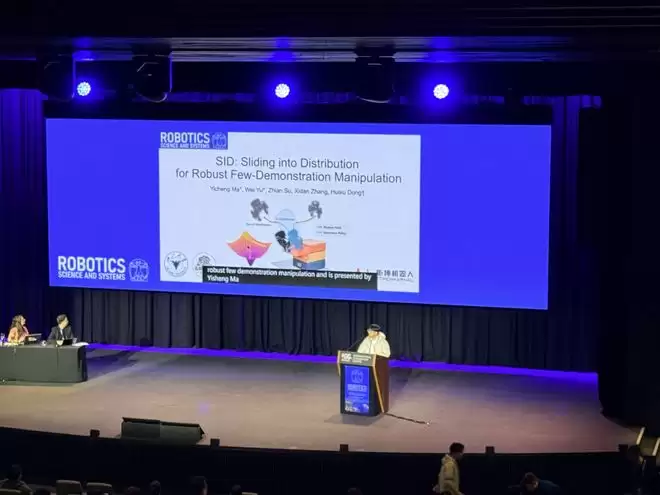
SID框架的核心是一个以物体为中心的运动场。该运动场通过学习规范化的演示,能在机器人偏离正常轨迹时提供大幅度的纠正运动,将系统逐步“滑”回可靠的操作区域。一旦接近目标,运动场会自然衰减,交由轻量级的自我中心执行策略完成精细操作。
这种“全局粗调+局部精调”的解耦设计,让SID在仅有两次演示的极限条件下依然稳健。在六个真实世界任务中,它在分布外初始条件下依然能保持约90%的成功率。这启示我们:少样本操作的瓶颈或许不在于策略不够强,而是缺乏显式管理分布偏移的机制。
 **让灵巧手真正“感知”接触:从多点触觉到动作接地**
多指灵巧手的接触密集型操作始终是机器人领域的一大难题,这类任务的成败高度依赖于多个接触点的持续演化,而这些状态对物体几何和滑移极为敏感。以往的研究大多把触觉当成“额外输入”,既不显式建模接触状态,也忽视了动作策略与底层控制器的动力学交互,导致策略给出的目标往往无法在物理世界执行。
来自UCSD、Brown和Sony AI的研究团队提出了Contact-Grounded Policy(CGP)视觉-触觉联合策略框架。该框架包含两个核心组件:其一是条件扩散模型,用于预测机器人状态与触觉反馈的耦合轨迹;其二是可学习的“接触一致性映射”,它能将上述的联合预测直接转化为柔顺控制器可执行的目标状态,从而确保控制系统真正落实预测出的接触意图。
在配备高精度触觉传感器的真实和仿真机械手上,CGP在操控、抓取和工具使用等任务中均显著优于现有基线。这项工作指明了方向:触觉不应只是锦上添花的额外观测,必须成为连接AI策略与物理现实的“接地”桥梁。
**结语**
三个方向,九篇论文,一条主线贯穿始终:机器人操作正在从“数据饥渴”走向“样本高效”。
无论是BiDemoSyn通过一次演示合成数千条数据、SID用两次演示实现九成成功率、DexImit从人类视频中自动提取操作知识,还是CGP让灵巧手真正感知接触状态,这些前沿探索都共同指向了一个未来:机器人再也不必在实验室里苦熬千万次演示。
作者最新文章
Excel单元格内换行教程:Alt+Enter快捷键与自动换行设置
2026-10-30 18:49
3DMax材质贴图浏览器怎么打开
2026-10-29 12:08
blender几何节点功能怎么开启教程界面入口与启用步骤
2026-10-18 13:20
PDF删页删错怎么找回?PDF删页报参数错误怎么办?
2026-10-17 11:21
蚂蚁庄园1月18日:人们常用砸锅来形容事情没办成猜猜最早源于哪个行业
2026-09-24 16:59
相关文章
更多
【城事】001,世界会客厅首位机器人员工上岗
08.25
300名截肢患者,正在变成机器人的触觉训练师
08.24
活力中国调研行|在智造一线,看机器人“结”新硕果
08.23
国家医保局:为“远程手术”等辅助操作统一价格立项
08.23
热门文章
更多
精品专题
更多






Mac软件
更多


火山引擎 网页版
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 macOS版
AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版
AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

WINDOWS
更多


Maya(Autodesk Maya) Windows版
Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版
AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。