


世界模型到底是什么?和智源王仲远深聊3小时后,我们拆解了五大疑惑
世界模型旨在预测下一个物理状态而非像素,智源发布悟界·Physis与RoboBrainOrca,分别定位物理底座与具身大脑。当前技术路线未收敛,面临数据匮乏、物理规律嵌入等难点,中美处于同一起跑线。
“世界模型”当下最吊诡的地方在于:它前所未有的热,却也前所未有的模糊。正是在这个时间点,智源研究院直接把“世界模型”推到了今年智源大会的核心位置。
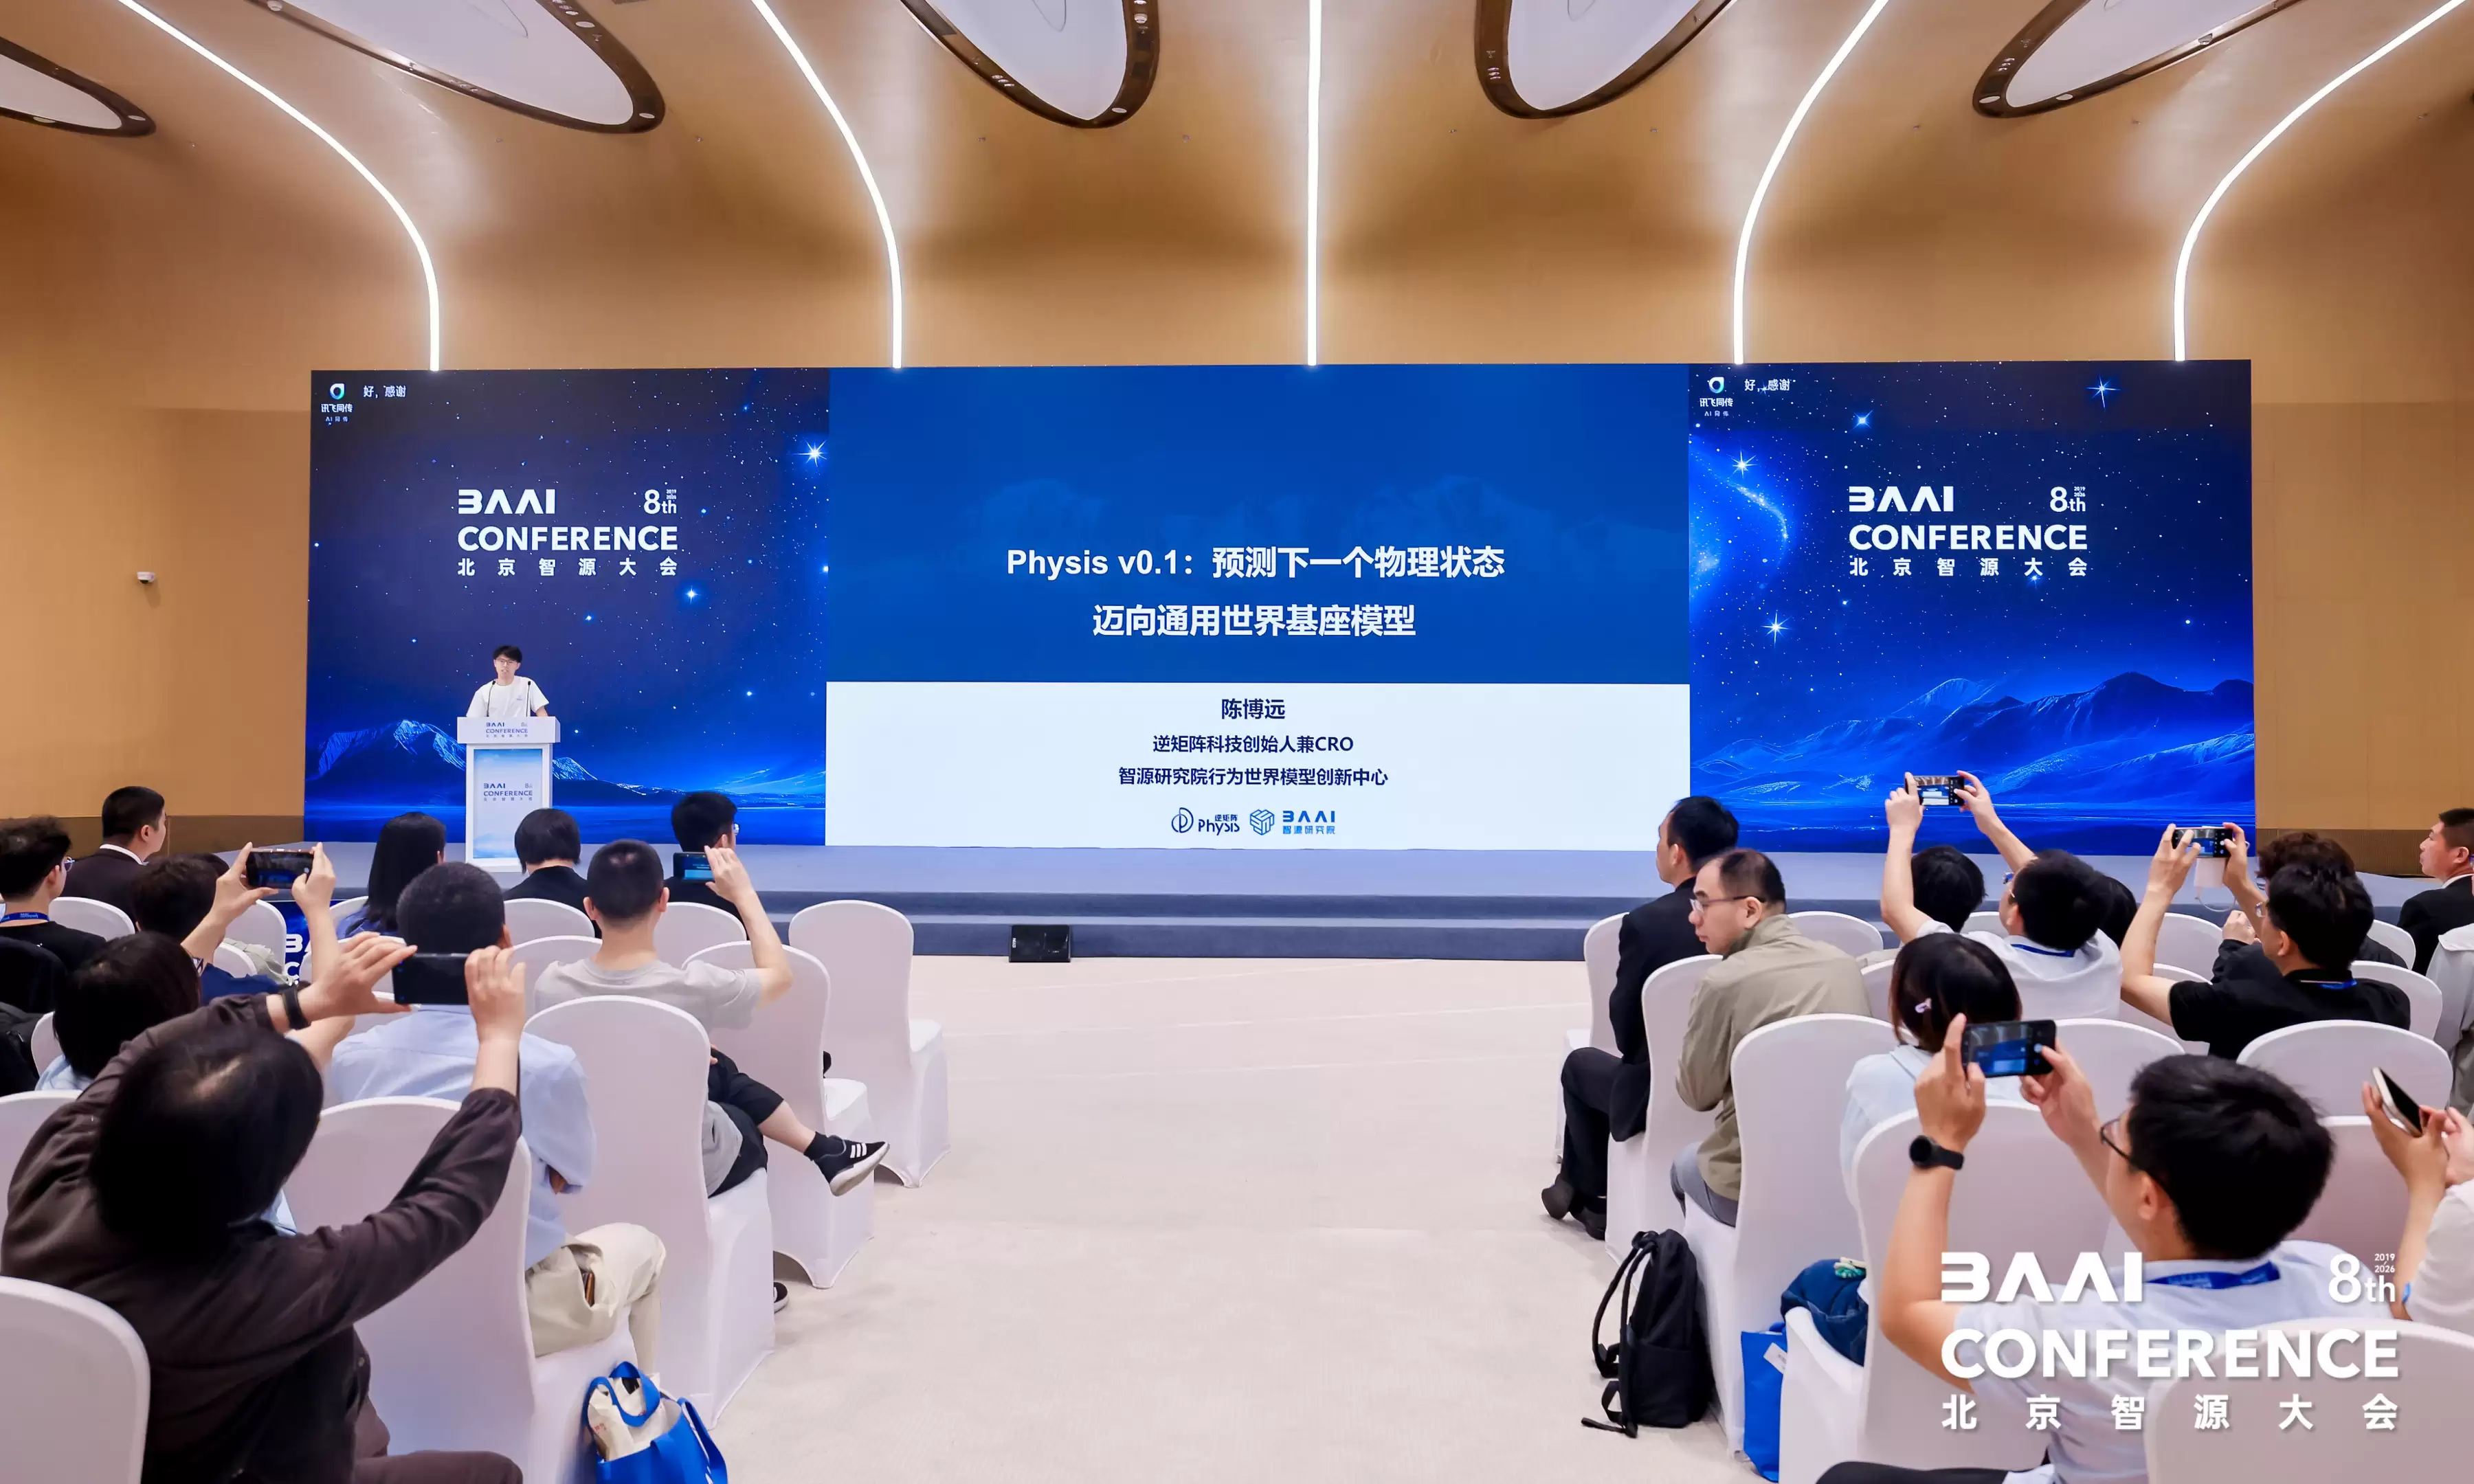
6月12日,2026智源大会上,智源研究院宣布了两项与世界模型相关的最新进展:悟界·Physis-v0.1 和悟界·RoboBrain Orca。前者指向通用物理世界基座模型,试图让AI从“生成画面”走向“预测物理状态”;后者面向具身智能,希望让机器人在行动之前,先学会感知、理解和推演世界。
大会前,与智源研究院院长王仲远等进行了近3小时的交流,主题正是拆解和探讨当下最热的“世界模型”。试图弄清楚:世界模型到底是什么?它是人工智能的一次重大范式变革吗?现在到了什么阶段?卡点在哪里?智源又打算怎么押注?中美之间有没有差距?
定义之惑:到底什么是“世界模型”?
王仲远给出了一个很清晰的判断:世界模拟器不等于世界模型,视频生成更不等于世界模型。原因很简单——视频模型可以生成看起来逼真的画面,但不一定真正理解物理规律。它能生成一头在天上飞的猪,也能生成物体凭空消失、流体运动违反物理规律、重力逻辑不成立的片段。这样的模型在影视、游戏、自动驾驶数据生成等场景中有价值,但如果直接用在机器人、工业控制或真实世界决策上,风险就大了。
“如果机器人装上这样的大脑,可能会误以为自己是钢铁侠。”王仲远打了个形象的比方。
他对世界模型的定义是:面向真实物理世界的下一代基座模型。核心从“预测下一个词”(Next Token Prediction)变成了“预测下一个物理状态”(Next Physical State Prediction)。
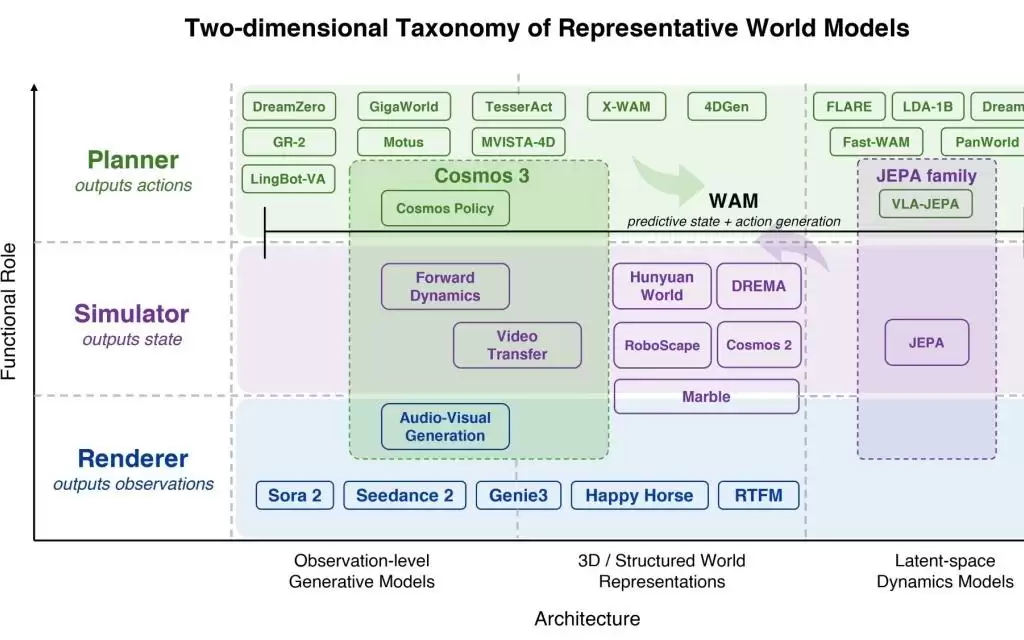
目前世界模型还处于早期,技术路线远未收敛。王仲远梳理出至少五条路线:
第一类是以语言为中心的世界模型。包含大语言模型、VLM、VLA都可归入此类。语言能总结很多世界的知识,但只是以文字方式表达;VLM、VLA则把其他模态映射到语言空间。以语言为中心,算是世界模型的一类。
第二类是以像素为中心的世界模型。这是目前最广为人知、也最容易被误用的路线。OpenAI发布Sora时用了“World Simulator”这个词,它预测的是下一个画面帧,所以更接近“世界模拟器”。这类模型能生成连贯视频,但短板在于:它可能学到的是影视作品中的视觉相关性,而不是真实物理世界的因果规律。
第三类是以三维结构为中心的世界模型。李飞飞提出的“空间智能”方向,本质上是数字世界的构建——关注3D重建、空间生成和可交互环境。World Labs发布的Marble,尝试从单张图片生成可交互、持久化的3D环境。王仲远指出,这更像元宇宙和游戏场景的延伸,解决的是“数字空间”的问题,而非“物理空间”。
第四类是以视觉表征为轴心的世界模型。这是Yann LeCun长期强调的方向,从I-JEPA、V-JEPA到V-JEPA-2,主张模型不必生成完整画面,而是在隐空间(latent space)中预测世界的抽象状态。王仲远认同这一路线对大语言模型局限性的判断——光靠语言模型确实无法解决真实物理世界的复杂问题,但他并不完全赞同“语言不重要”。在他看来,未来的世界模型不能只依赖隐式表征,也不能完全绕开语言,因为语言仍然是推理、规划和表达的重要接口。
智源研究院其实在探索第五条路线——也就是第一条和第四条的融合:以语言为中心的分类与以视觉表征为中心的分类可能实现融合,也叫潜空间表征。同一个潜空间能够解码不同的模态。智源延续了悟界·Emu3.5模型训练的思想:将各种文字、图像、视频模态全部压缩,原生统一训练,压缩在同一个语义空间,希望未来有更多模态被压缩进来,通过统一潜空间表征各种真实物理世界的状态,再解码成为Action、画面或其他物理世界需要的状态。王仲远认为,将来统一的潜空间建模不仅仅是视觉空间,而是全模态潜空间,这很可能是世界模型真正下一个可能的路径。
“世界模型最终要解决的是看到、感知、理解真实世界,进行推理规划和决策。”王仲远说。它不应只是一个仿真器,而应是一个能够辅助人类和智能体理解物理世界、预测未来状态、做出行动决策的基座模型。
世界模型VS大语言模型:AI的重大范式变革
如果说大语言模型的核心范式是Next Token Prediction(预测下一个词),那么智源认为,世界模型的核心范式将是Next Physical Prediction(预测下一个物理状态)。王仲远直言:“这是人工智能的一次重大范式变革。”
过去几年AI的主线非常清晰:先是语言模型,让机器理解和生成文本;然后是多模态模型,让机器能够处理图像、视频、声音等信息;再往后,AI必须进入物理世界,与硬件、机器人、工业系统、科学实验和生命系统发生关系。换句话说,AI不能永远停留在屏幕里。
大语言模型已经在写作、总结、问答、编程等数字世界任务中展现出巨大价值,但真实的人类社会并不只由文字、代码和网页构成。工厂、物流、酒店、医院、实验室、道路、家庭——这些才是更复杂、更高价值、也更难建模的物理世界。
王仲远将这一过程概括为:大语言模型、多模态、世界模型,最终通往物理AGI。物理AGI不是抽象的聊天机器人,而是能够在真实世界中感知环境、理解状态、推演后果、做出决策,并通过实体或工具执行动作的智能系统。
这也是智源过去几年布局的主线。2024年,智源发布悟道大模型,开启了中国大模型时代;随后转向多模态,推出悟界系列。2024年6月的智源大会上,智源已经明确提出:AI将从原生统一多模态,进入物理世界与硬件结合,再进入微观世界AI for Science,最终通向物理AGI。世界模型不是2026年突然长出来的方向,而是技术路线中的一个阶段性结果。
这一脉络在Emu系列中已有所体现。2024年悟界·Emu3,2025年悟界·Emu3.5,实现了图像、文本、视频的原生统一。王仲远认为,Emu系列本质上是智源对世界模型的早期探索,是“多模态世界模型基座”的雏形。但他也承认,Emu3.5时代的多模态世界模型还远远不够——当时融合的主要是文字、图像和视频,连声音和动作都没有完全融合。真正进入物理世界后,模型必须理解动作、状态、时间、空间和物理规律,还要能判断一个动作会导致什么后果。
举个例子:一瓶盖着盖子的水和一瓶没盖盖子的水,如果同时从桌边跌落,人类会自然预判两者后果不同——前者可能只是摔落,后者可能洒水、造成滑倒或损坏物品。但要让模型真正学会这种物理常识,并不容易。这正是世界模型相较多模态模型的关键区别:多模态模型解决的是不同信息形式的统一理解和生成;世界模型要进一步解决的是——在真实物理世界中,状态如何变化,动作如何产生后果,因果链条如何被推演,长期状态如何保持一致。
王仲远认为,语言模型时代的能力激发方式是Prompt;世界模型时代,能力激发方式可能是State。语言模型时代,模型更多是被动观察和响应;世界模型时代,模型必须具备主动交互能力。语言模型时代可以是单模态或多模态;世界模型时代必须走向全模态。世界模型不是对大语言模型的简单替代,而是一次更大的范式扩展:从数字符号预测走向物理状态预测,从回答问题走向理解世界,从生成内容走向规划行动。
世界模型有哪些应用场景?和具身智能什么关系?
“VLA是当下,世界模型是未来。”王仲远认为,具身智能是当下最大的应用场景,但世界模型远不止于此。它可以替代传统物理仿真引擎(超越人类手工写的物理公式),可以用于科学发现甚至帮人类发现未知的物理规律,可以服务工业、物流、医疗……任何“在真实物理世界中干活”的场景。
现在的具身模型还很“笨”——一个场景一个任务地训练,换个环境就不会了,缺乏物理常识和泛化能力。这正是世界模型要解决的:做一个通用的物理世界基座模型,像大语言模型一样,能适应不同场景,做出合理决策。智源想做的,正是在这个范式尚未完全收敛的时候,提出自己的定义、分类和路线判断。
智源的路线:悟界·Physis做物理底座,悟界·RoboBrain Orca做具身大脑
今年,智源在世界模型方向最重要的两个布局,是悟界·Physis-v0.1和悟界·RoboBrain Orca。两者都指向物理世界,但侧重点不同:一个偏底座,一个偏大脑;一个更强调物理状态建模,一个更强调具身交互闭环。
先说悟界·Physis。它的核心范式是Next Physical State Prediction——预测下一个物理状态。与许多视频生成模型不同,Physis的目标不是生成更漂亮的视频,而是学习真实物理世界中状态变化的规律。智源对其定位是:全球首个通用世界基座模型,以预测下一个物理状态的范式,探索真实物理世界AI底层引擎。关键变化在于:不以像素或帧为核心,而以“物理状态”为核心。一个瓶子倒下去之后,状态变化不仅包括画面里的像素变化,还包括瓶子的姿态、速度、碰撞、接触关系、液体是否流出、桌面是否吸水、周边物体是否被带倒。一个模型如果只生成“看起来像瓶子倒了”的视频,并不等于它理解了这个过程。真正的世界模型需要知道:瓶盖是否拧紧、水量是多少、地面材质是什么、受力方向如何、撞击会传导到哪里。
悟界·Physis尝试将视频、RGB-D、3D点云、力触反馈等全模态信息压缩和统一到隐空间中——模型不是在简单预测下一帧画面,而是在latent space中学习状态的演化。它具备四类核心能力:物理一致性、动作因果性、长程可推演性、通用泛化性。潜在应用场景包括严肃工业、具身智能、物理仿真、科学研究等真实物理场景。
如果说悟界·Physis更像“物理底座”,那么悟界·RoboBrain Orca更接近“机器人大脑”。智源的定义是:以下一个物理状态预测为核心的具身大脑,具备统一表征、因果推演、模态解码三大核心能力。
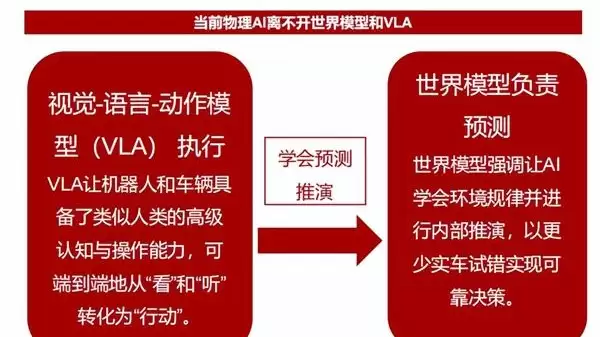
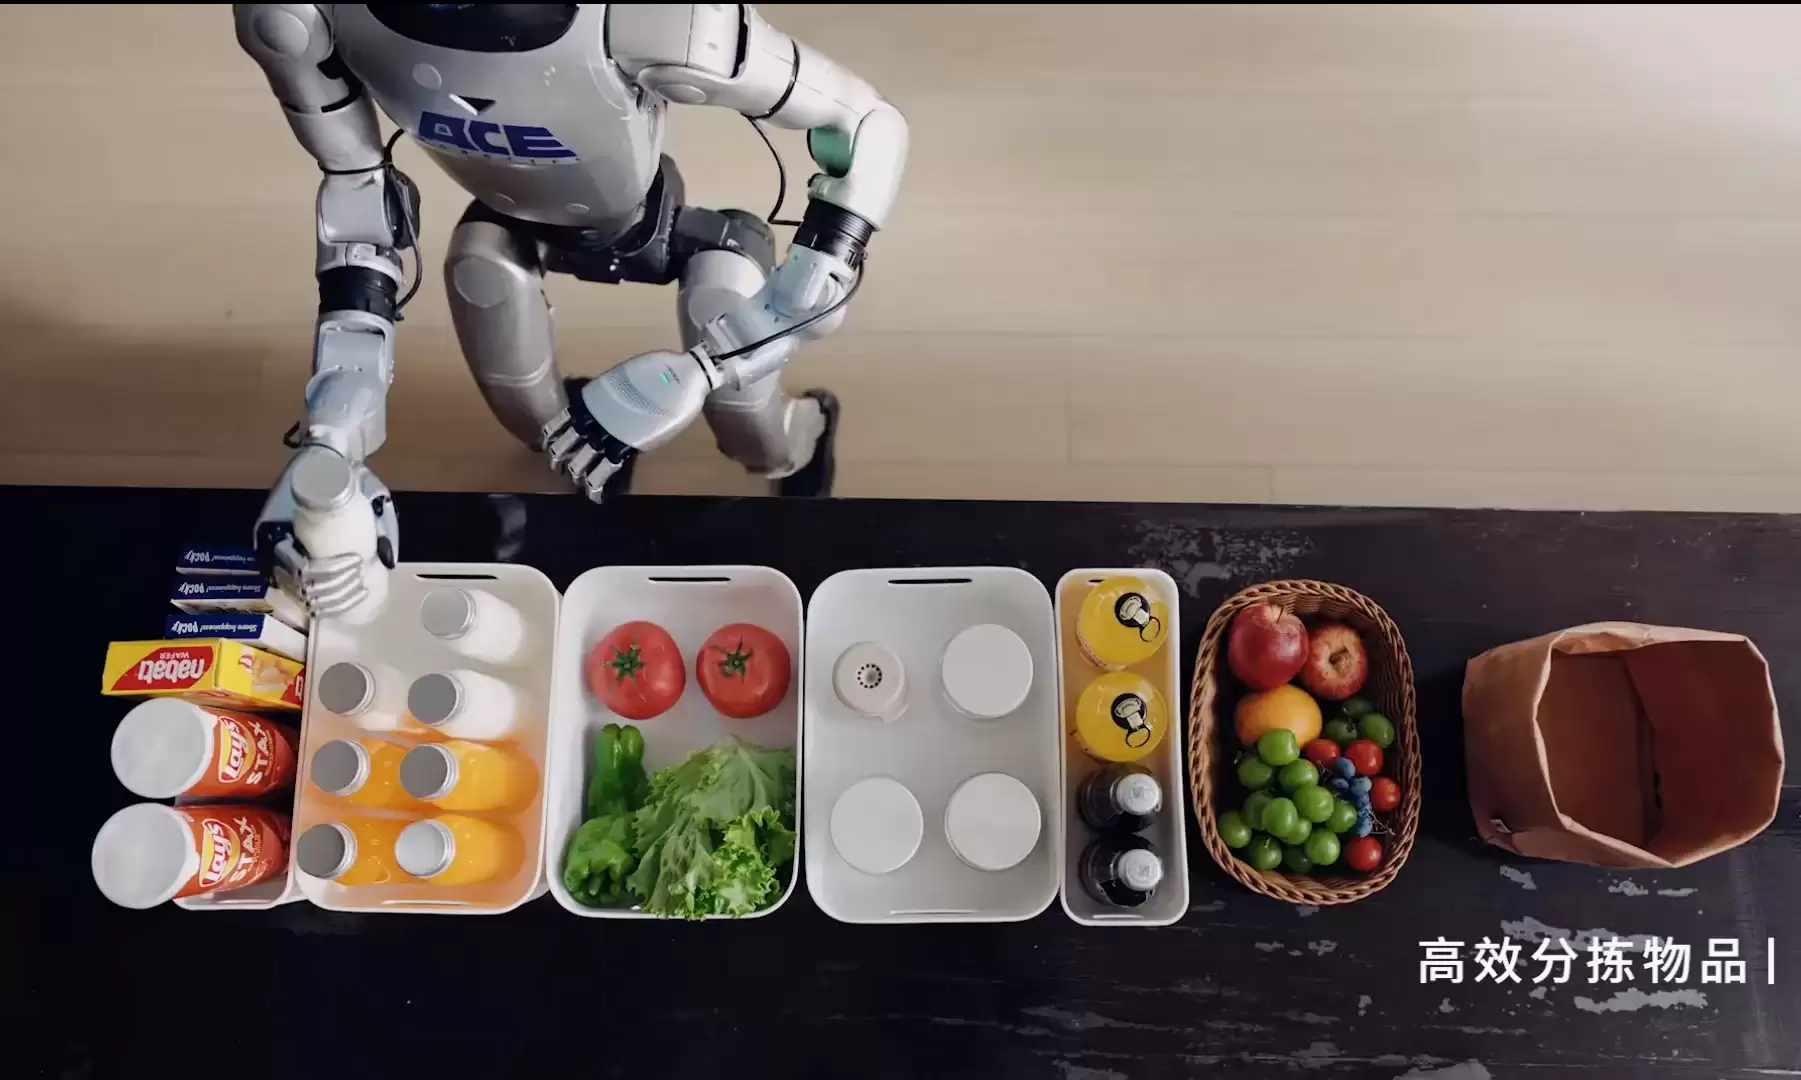
过去两年,VLA几乎是机器人“大脑”的主流叙事——机器人通过视觉观察环境,通过语言理解人类指令,再把理解转化为动作输出。它已经推动机器人在分拣、抓取、包装、酒店服务等特定场景中落地。但VLA的短板也很明显:泛化不够、长程任务不稳、复杂场景中的物理理解不足,在真实机器人上部署时还会遇到延迟、算力和响应频率问题。王仲远说得很直接:“VLA是当下,世界模型是未来。”VLA能让机器人听懂指令、看到环境、做出动作,但对世界变化的预测能力还不够。机器人不能只是执行,它还要能在行动前想一想:这个动作之后会发生什么?
悟界·RoboBrain Orca要解决的,正是具身智能里更底层的问题。它试图让机器人像人类一样,不仅执行指令,还能感知环境、理解状态、预判后果、规划动作,并在执行后根据反馈继续调整。从技术范式上看,它试图从Next Token、Next Frame、Next Action Prediction升级到Next Physical State世界状态预测,将语言、视觉、动作等信息统一到状态表征中,使模型能够同时生成语言思考、视觉预测和动作决策——实现“想、看、动”三位一体。如果机器人要端一杯水给人,它需要知道杯子有没有盖子、水会不会洒、路线中是否有障碍、机械臂抓握是否稳定、失败后如何调整。这正是世界模型要解决的深层问题。
世界模型卡点在哪?还在大语言模型的2012年
用大语言模型的发展阶段类比,今天的世界模型走到哪里了?王仲远的判断是:世界模型还处在大语言模型的2012年(深度学习阶段),非常早期。他展开了一个时间线推演:2006年Hinton提出深度信念网络;2012年AlexNet在ImageNet上大放异彩,深度学习进入产业化视野;但直到2018年Transformer和大规模预训练才真正成熟;2024年底ChatGPT爆发。从理念萌芽到改变世界的产品,走了将近二十年。世界模型需要这么长的周期吗?王仲远认为可能不需要——“随着人工智能越来越强,演化速度越来越快,可能三年五年就有足够多的数据累积。”但他同时强调,“世界模型的周期”可能是三年甚至更长时间,是一个十年维度的命题,短期价值体现在技术验证而非商业兑现。
目前,方向已经显现,大家意识到它的重要性,但技术路线尚未收敛,数据远远不足,评测标准也不清晰,还没有出现像GPT-3.5或ChatGPT那样让行业形成共识的产品。在王仲远看来,世界模型面临以下难点:
第一个卡点:怎么把物理规律教给模型。人类看到一瓶水快要跌落,会天然预判接下来会发生什么——瓶子是盖着的还是没盖着的、里面有多少水、桌面什么材质、落地后会不会碎。但模型不会天然拥有这些物理直觉。视频生成模型可以生成一段“水杯倒下”的画面,但这段画面是否真的符合物理规律,是另一回事。
第二个难点:长时间序列一致性。很多视频生成模型可以从5秒、10秒延长到更久,但看起来更长并不等于真正理解了时间。王仲远举例:如果给一个瓶子里加水,旁边放一个时钟,模型进行状态预测。镜头移开又移回来,时钟是不是真的经过了10秒或20秒?水平、动作和环境是否保持一致?今天的很多视频模型可以生成看似连续的长视频,但不一定符合真实物理世界的时间规律。
第三个难点:怎么把Action教给模型。世界模型必须理解动作和后果之间的因果关系。机器人推一下、夹一下、拧一下、倒一下,都会带来不同的状态变化。如果没有动作数据、没有交互反馈,模型很难真正知道“我做了什么”和“世界发生了什么变化”之间的关系。
第四个难点:数据的匮乏。大语言模型之所以爆发,一个关键原因是互联网文本足够多。图像和视频模型也受益于海量互联网视觉数据。但世界模型需要的数据复杂得多——它需要真实物理世界中的多模态数据:视觉、声音、动作、时间、空间、物体状态、机器人轨迹、人类指令、执行反馈、成败结果。更重要的是,这些数据必须能反映真实因果关系,而不是只呈现表面画面。这类数据目前远远不够。
但王仲远表示,世界模型不可能等到“数据完全Ready”之后再做。具身智能和真实物理场景的落地本身也会形成数据闭环——工厂分拣、酒店服务、仓储搬运等场景,虽然一开始只是解决具体问题,但落地过程中采集到的数据,反过来会帮助未来世界模型训练。世界模型的发展不是先有完美数据、再有完美模型,而是模型、场景和数据共同迭代。这也是智源为什么愿意在世界模型还不成熟时提前投入。“我们看到了一些可能的方向,但仍需要全世界一同努力。”他说。
结语:世界模型,中美在同一起跑线
在大语言模型领域,业界普遍认为中国和美国差距在6-12个月。但当问到世界模型的中美差距时,王仲远给出了一个出人意料的答案:“没有差距,中美在同一起跑线上。因为方向都刚刚开始。”
从行业竞争来看,短期内呈现“百花齐放”的状态,各类技术路线持续并存:视频生成团队、3D数字场景团队、传统大模型厂商、车企、具身智能企业都会入局。大家的研发目标和技术路径各不相同,短时间内难以形成统一标准。长期来看,能否打造出通用世界基座模型,将是决定胜负的关键。世界模型不是一场短暂的风口,而是人工智能发展的必经之路。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。