


MiniMax发布新模型M3:前沿编程能力,1M上下文和原生多模态的“三合一”模型
MiniMax发布新一代模型M3,采用自研稀疏注意力架构MSA,同时具备前沿编程能力、1M超长上下文和原生多模态,是国内首个集齐这三项核心能力的大模型,且完全开源。百万级上下文下单token计算量仅为上一代约1/20,推理效率大幅提升。
6月1日,AI圈又迎来一则重磅消息——国产大模型公司MiniMax正式发布了新一代通用模型 MiniMax M3。坦白说,这款模型从技术架构到能力组合,都颇具看点。
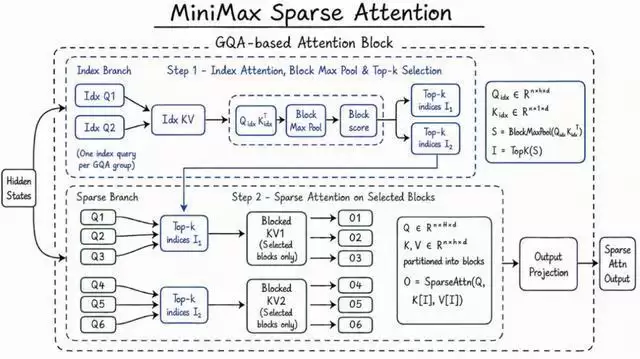
M3最大的亮点,在于它采用了一套全新的自研稀疏注意力架构,名为MiniMax Sparse Attention(MSA)。这套架构带来的直接好处是:在编程能力、智能体能力、超长上下文处理,以及原生多模态支持等多个关键方向上,都实现了代际级别的跨越。换句话说,这不仅是常规的版本迭代,更是一次底层能力的整体跃升。
从官方披露的信息来看,M3是国内首个同时具备“前沿Coding能力、1M超长上下文、原生多模态”这三项核心能力的大模型。更重要的是,它也是目前全球范围内,唯一一个把这套完整能力组合完全开源的选项。开源意味着什么?意味着开发者可以直接拿它去做更垂直的落地应用,这对整个技术生态的推动力不可小觑。
关于性能,MiniMax给出的数据也很提气:在100万级上下文规模下,M3单token的计算量仅为上一代模型的约1/20。推理效率的大幅提升,意味着在实际部署中,成本和响应速度都会有质的改善。








赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
