


波士顿大学与微软研究院联手,教AI"像大脑一样看视频"

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
人类每天都在“看视频”,但大家恐怕没意识到,我们的大脑从来不是在一块一块地处理每一帧画面。脑神经科学早就揭示了一个事实:我们的视觉系统本质上是一台精明的预测机器——它会不断预判“接下来应该发生什么”,只有当现实偏离了预测,大脑才会瞬间拉响警报、集中注意力。举个很形象的例子:一只北极熊在雪地里慢悠悠地
人类每天都在“看视频”,但大家恐怕没意识到,我们的大脑从来不是在一块一块地处理每一帧画面。脑神经科学早就揭示了一个事实:我们的视觉系统本质上是一台精明的预测机器——它会不断预判“接下来应该发生什么”,只有当现实偏离了预测,大脑才会瞬间拉响警报、集中注意力。举个很形象的例子:一只北极熊在雪地里慢悠悠地走路,步伐规律、背景固定,大脑几乎不需要费力;但当一只海豹突然从冰层里钻出来,你的精神会立刻高度集中——这才真正需要“认真看”。
一支来自波士顿大学和微软研究院印度分部的研究团队,就是受这个生物学原理启发,提出了一个名为“Swift Sampling”(快速采样)的全新视频帧选择算法。它的目标很明确:让AI在处理长视频时,也能像人类大脑一样,把有限的注意力集中在那些真正重要的瞬间。
一、长视频处理的“注意力危机”
当前的视频AI——也就是通常所说的视频大语言模型,能“看懂”视频并回答问题——面临一个根本性的困境:长视频里藏的信息量实在太大了。一段30分钟的视频,如果每秒抽一帧,就有将近1800张图片,而现有AI系统通常只能处理几十帧。于是乎,几乎所有系统都默认选择了一种最简单粗暴的做法——“均匀采样”,也就是每隔固定时间抽一帧。这就像把一本书每隔几页撕下一张纸,然后拼在一起试图理解整个故事情节。
这种做法的问题不言而喻。视频的大部分时间里,画面变化极其缓慢:说话的人嘴唇在动,背景纹丝不动;烹饪教程里炒菜的动作可能重复五分钟。这些帧与帧之间几乎一模一样,抽哪帧都无所谓。但真正关键的信息往往集中在极短的片段里:一个关键动作、一个场景切换、一件意外事件。均匀采样很可能会恰好错过这些瞬间,却把大量“冗余帧”送进AI系统,白白浪费了有限的处理资源。
那么,之前有没有人尝试改进呢?有,但各有各的问题。比如,有人引入了光学流(一种专门分析画面运动的技术)来判断哪些帧更“动感”,但这需要额外调用一个独立的运动分析模型,计算成本几乎翻倍。还有人通过对比每对帧之间的相似度来找出“与众不同”的帧,但这样做不仅要单独运行一个图像编码器来处理所有候选帧,还得人工调整“相似度阈值”这类参数——一旦参数设错了,效果就会大打折扣。
Swift Sampling的出发点,正是为了解决这些痛点:不需要额外模型,不需要手动调参,却能精准识别出视频中真正“令人意外”的关键帧。
二、泰勒展开式:预言家的数学工具
Swift Sampling的核心思想,可以用一个日常场景来理解。想象你正在开车,前方有一辆匀速行驶的货车。根据它过去几秒的运动轨迹,你很确定它下一秒会出现在哪里。如果它真的按你预测的轨迹走,那这段时间里你的注意力可以保持在较低水平;但要是它突然急刹车或猛地并线,与你的预测出现巨大偏差,你的注意力会瞬间拉满。
研究团队把视频中每一帧的视觉特征——可以理解为AI对这一帧的“感知摘要”,是一个由大量数字组成的向量——比作货车的“位置”,把时间当成“路程”。这样一来,整段视频的视觉特征序列,就变成了一条在高维空间中随时间流动的轨迹。如果视频内容变化平缓,这条轨迹就会很光滑;如果某个瞬间发生了意想不到的变化,轨迹就会出现一个急剧的拐折。
要预测轨迹的下一个点,研究团队借用了数学中一个经典工具——泰勒展开式。这个工具的本质是:只要你知道一个东西当前的“位置”、“速度”和“加速度”(乃至更高阶的变化率),就能相当精确地预测它下一时刻的状态。具体来说,如果已知前N帧的视觉特征,通过计算特征序列的“一阶差分”(速度)、“二阶差分”(加速度)、“三阶差分”(加加速度,也叫“急动度”),就能把这些信息综合起来,外推预测下一帧的视觉特征。
实验中,研究团队将泰勒展开的阶数固定为N=3,也就是同时考虑速度、加速度和急动度三个层面的变化信息。这个选择不是拍脑袋决定的——后续的系统对比实验表明,从N=1到N=3,精度明显提升;但继续增加阶数,收益会迅速递减。这说明视频特征轨迹的局部动态,用三阶近似就已经捕捉得相当充分了。
三、“意外程度”评分与关键帧筛选
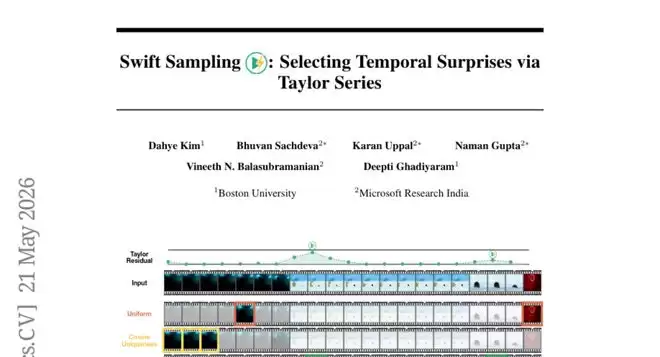
有了预测值,接下来就是计算“意外程度”。研究团队定义了一个叫做“泰勒残差”(Taylor Residual)的指标:对于每一帧,用泰勒展开预测出的特征向量与该帧实际的特征向量之间的距离(具体是欧氏距离,可以理解为空间中两点之间的直线距离),作为这一帧的“意外评分”。
距离越小,说明AI对这帧的预测越准,这帧的内容越符合视频一向的走势,属于“冗余帧”;距离越大,说明这帧的实际内容与预测偏差极大,视频在这一刻发生了某种出人意料的变化——这就是“时间惊喜”,是值得保留的关键帧。
从信息论的角度,研究团队也给这个直觉提供了数学支撑:在一种理想化的假设下,一帧的“信息量”(香农自信息量,衡量一个事件有多“出乎意料”)与泰勒残差的平方成正比。换句话说,残差越大,这帧携带的新信息越多,从信息论角度看越值得保留。
不过,这里有一个陷阱:如果直接选取全局残差最大的K帧,会出问题。在一段剧烈运动的视频片段里,每一帧的残差可能都很大;而在一段相对平静的片段里,即便有些帧相对于其邻居而言已经“算是比较意外了”,其绝对残差值却可能并不突出。如果只看绝对值,所有关键帧都会扎堆在那些最“闹腾”的时间段里,其他时段的关键事件就会被彻底忽略掉。
为了解决这个问题,研究团队设计了一种更聪明的选帧策略:选取残差序列中的“局部极大值”点——也就是每个在自己左右邻居中残差最高的帧。这就像在一条起伏的山脉中,选出每一段山峰的最高点,而不是只盯着整条山脉的最高峰。这样一来,即使视频某段时间整体比较平静,那段时间里最“出乎意料”的帧也能被找出来,实现了对视频各个时段的均衡覆盖。如果局部极大值的数量超过了预算K,就从里面挑残差最大的K个;如果视频太过平静、局部极大值不足K个,就把剩余名额留给非极大值帧中残差最高的那些,确保帧数预算被充分利用。
从工程实现角度看,Swift Sampling还有一个精妙之处:计算泰勒残差所需的视觉特征,直接复用视频大语言模型自身视觉编码器第一层(最早期)的注意力机制中的“键向量”(Key projection)。这些向量本来就是模型前向传播过程中必须计算的中间结果,提取它们几乎不产生额外的计算开销。因此,整套方法给模型原本的推理成本只增加了约2%(即1.02倍),而对比基准方法Cosine Uniqueness需要额外运行一个完整的视觉编码器,总成本高达1.60倍——Swift Sampling的额外开销只有它的三十分之一左右。
四、为什么用第一层的特征而不是深层特征?
研究团队对提取特征的层数进行了系统对比,结果挺有意思。直觉上,越深层的特征语义越丰富,应该对帧的“重要性”有更好的判断。但实验表明,第一层(l=0)的键向量在综合效果上反而最好。
研究团队对此给出的解释是:浅层特征更多反映低层次的视觉信息,比如颜色、纹理、边缘等,这些信息随时间变化的规律更平滑、更具规律性,因此泰勒展开的预测效果更好,残差对真正的场景变化也更敏感。相比之下,深层特征更关注整体语义和抽象概念,其时序变化规律更复杂,泰勒预测的效果反而打折扣,容易把语义上的“跳跃”和真正意义上的视觉“突变”混淆。
另外,从计算成本角度看,层数越浅,需要运行的计算越少,进一步降低了额外开销。
五、实验验证:在三大基准测试上的表现
研究团队在三个权威的长视频问答基准上对Swift Sampling进行了全面测试:Video-MME、MLVU和LongVideoBench(LVB)。这三个基准都采用选择题形式,题目涵盖动作识别、时序推理、空间感知、信息摘要等多种类型,视频长度从短片到超过30分钟的长视频不等。
实验以LLaVA-OneVision和LLaVA-Video两个主流视频大语言模型作为主干,对每段视频先均匀采样128帧作为候选池,再用各种方法从中选出32帧送入模型处理。
以LLaVA-OneVision为例,与直接均匀采样32帧相比,Swift Sampling在LVB数据集的整体准确率从55.3%提升至57.9%,提升了2.6个百分点;在MLVU上从64.7%提升至65.6%,提升0.9个百分点。提升最明显的是长视频子集:对于LVB中时长超过20分钟的视频,准确率从47.5%跳升至54.3%,足足提升了6.8个百分点;对于MLVU中时长超过30分钟的视频,提升达4.2个百分点。使用LLaVA-Video作为主干时,趋势同样一致:MLVU整体提升3.0个百分点,LVB长视频子集提升2.9个百分点。
与需要更高计算开销的同类方法相比,Swift Sampling的表现也很有竞争力。另一个叫做MaxInfo的方法,计算开销达到均匀采样的1.79倍,在部分指标上略高于Swift Sampling,但在LVB长视频子集上,Swift Sampling以54.3%明显超过MaxInfo的50.8%,差距达3.5个百分点。而Cosine Uniqueness(通过帧间余弦相似度寻找最“独特”帧的方法)计算开销是1.60倍,但在多个基准上反而不如均匀采样——这说明单纯追求“视觉上与众不同”,并不等于“信息丰富”。
研究团队还将Swift Sampling与一种叫做AKS(自适应关键帧采样)的查询感知方法结合使用——AKS可以根据用户提出的问题来判断哪些帧更相关。把Swift Sampling作为AKS的预筛选器(先用Swift Sampling将候选帧从128帧精简到96帧,再由AKS从96帧中选32帧),不仅将AKS的计算成本从1.53倍降至1.43倍,准确率反而有所提升,在MLVU上增加0.8个百分点,在LVB上增加0.6个百分点。这说明Swift Sampling筛掉的帧,大多是真正的“无信息帧”,留下的候选集质量更高,反而让后续的查询匹配工作更加精准。
六、帧数预算越紧,优势越突出
研究团队还专门分析了“帧数预算”——也就是最终送入AI的帧数K——对效果的影响。这个实验尤其能体现Swift Sampling的价值。
当每段视频只允许保留32帧时,Swift Sampling在MLVU的超长视频(≥30分钟)子集上比均匀采样高4.2个百分点。当预算降至16帧时,优势扩大到2.1个百分点。当预算进一步压缩到4帧时,对于超长视频,Swift Sampling比均匀采样高出惊人的12.5个百分点;当预算只剩2帧时,仍然高出10.4个百分点。
这组数据揭示了一个朴素而深刻的道理:帧数预算越紧张,选哪几帧就越关键。当每段视频只有4帧的“名额”时,均匀采样几乎注定会错过最关键的信息,而Swift Sampling通过精准定位“意外瞬间”,即便在极度受限的条件下也能最大限度地保住关键信息。
七、除了问答,还能用在哪里?
研究团队还验证了Swift Sampling在视频问答之外的应用场景。
在视频描述生成任务上,他们将Swift Sampling应用于TempCompass基准,用GPT-4o来评判生成描述的质量。结果显示,Swift Sampling在动作、方向、顺序、速度等多个类别上均有提升,唯独在“属性变化”类别上有所下降。研究团队推测,描述物体属性的逐渐变化(比如颜色慢慢变深)可能恰好是视觉特征“缓慢演变”的片段,泰勒残差较低,容易被筛掉。
在视频词元压缩(Token Compression)任务上,研究团队将Swift Sampling与当前最先进的UniComp方法结合使用。UniComp的思路是对每帧的视觉词元进行进一步压缩,减少送入语言模型的信息量。将Swift Sampling选出的帧作为UniComp的输入,在所有压缩率下均比原始均匀采样+UniComp的组合效果更好,最高提升达1.6个百分点。
对于Video-MME基准中的各类细分任务,Swift Sampling在空间推理(+5.4%)、动作推理(+3.9%)、时序推理(+2.8%)和动作识别(+2.2%)上的提升最为突出。研究团队认为,这些任务都需要对视频中“发生了什么改变”有精准的感知,而这正是基于运动轨迹“意外感”的帧选择最擅长的事情。相对地,需要全局时序连贯性的任务(如时序感知和计数)出现了轻微下降,原因在于这类任务可能依赖于视频中即使不“令人意外”也需要覆盖到的均匀时间点信息。
八、局限与未来方向
研究团队在论文中坦诚地指出了Swift Sampling目前的主要局限。由于方法是完全“查询无关”的——选帧时根本不知道后续要回答什么问题——所以偶尔会选到视觉上很“突然”、但与问题毫无关联的帧,比如视频开头或结尾的片头片尾卡,或者突然出现的字幕板。从定性对比图中可以看到,Cosine Uniqueness方法也有类似问题,甚至更严重——它会特别偏爱那些视觉上格外“特立独行”的帧,如水下镜头、黑白画面,却不管这些帧是否真的有用。Swift Sampling在这方面表现好一些,但也并非完全免疫。
研究团队提出,未来可以探索将泰勒残差信号与任务描述相结合,让帧的“意外感”评分同时参考查询内容,实现“查询感知的意外帧选择”。此外,将这一框架扩展到音频流和时空多模态信号,以获得更全面的视频理解,也是值得探索的方向。
说到底,这项研究做的事情其实很朴实:把大脑早就在用的“只关注意外”这一原则,用数学语言写清楚,嵌进现有的AI视频系统里,几乎不增加任何额外负担,却让AI在处理长视频时变得更聪明了一点。尤其对于那些动辄几十分钟的视频,这种“聪明”体现得格外明显——毕竟,在长达半小时的视频里均匀撒上32帧,和精准捕捉其中最关键的32个瞬间,效果差异可以高达12.5个百分点。这个差距在实际问答应用中,可能就是“答对”和“答错”之间的分水岭。
这项工作也提醒我们,很多时候让AI更聪明,并不需要把模型做得更大、把数据喂得更多,而是从根本上重新思考“哪些信息值得处理”这个问题。当这个问题的答案和人类大脑的工作原理高度吻合时,往往能以极小的代价换取显著的提升。对于长视频时代的AI理解系统来说,这或许是一个值得持续深挖的方向。
Q&A
Q1:Swift Sampling是一种什么类型的算法,需要单独训练吗?
A:Swift Sampling是一种无需训练的视频关键帧选择算法。它直接复用视频AI模型(视频大语言模型)自身视觉编码器第一层的中间计算结果,通过泰勒展开预测每帧的视觉特征,再计算预测值与实际值的偏差来评估每帧的“意外程度”,不需要任何额外的训练过程或独立的外部模型。
Q2:泰勒残差选帧和传统的均匀隔帧抽取相比,核心优势在哪里?
A:均匀采样会把抽帧名额平均分配到整段视频的各个时间点,不管那些时间点的内容是否有意义。泰勒残差方法则把名额集中给那些“视觉走势出现意外转折”的时刻,重复冗余的帧基本不会入选。视频越长、帧数预算越少,这种差异就越明显。在每段视频只保留4帧的极端条件下,准确率差距可达12.5个百分点。
Q3:Swift Sampling在哪类视频任务上效果最明显,哪类任务上表现会下降?
A:Swift Sampling在需要捕捉“发生了什么变化”的推理任务上提升最显著,比如空间推理、动作推理、时序推理和动作识别,提升幅度在2%至5%之间。但在需要对整段视频保持均匀时序覆盖的任务上(如计数和时序感知),由于方法会主动跳过“不意外”的时间段,可能错过一些均匀分布的必要信息,出现轻微的准确率下降。











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。