


谷歌与伊利诺伊大学联手,让AI研究助手学会"反思自己的错误"
一项关于如何教会AI像人类研究者一样“做研究”的新成果,近期以预印本形式发布。这项由伊利诺伊大学厄巴纳-香槟分校与谷歌云AI研究院合作完成的研究,论文编号为arXiv:2605.10899,感兴趣的读者可以据此检索全文。 不妨回想一下,我们自己是如何完成一项复杂任务的?比如写一篇学期论文:通常会先确
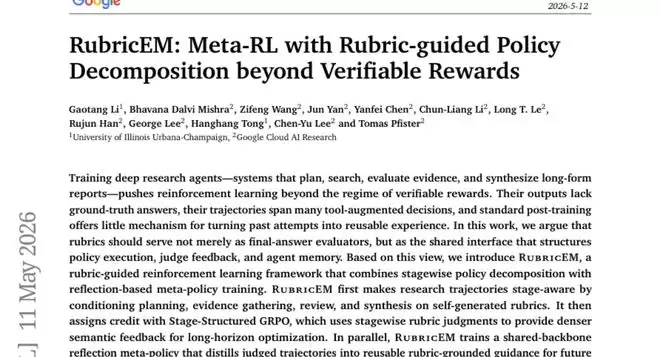
一项关于如何教会AI像人类研究者一样“做研究”的新成果,近期以预印本形式发布。这项由伊利诺伊大学厄巴纳-香槟分校与谷歌云AI研究院合作完成的研究,论文编号为arXiv:2605.10899,感兴趣的读者可以据此检索全文。
不妨回想一下,我们自己是如何完成一项复杂任务的?比如写一篇学期论文:通常会先确定研究问题,然后搜集资料,接着梳理已知与未知,最后动笔撰写。如果发现逻辑不通,还会回头修改,并把这次的经验教训用于下一次。这套包含规划、执行、审查和迭代的流程,对人类而言近乎本能。
然而,对于AI来说,要自主完成一项“深度研究”任务——即独立搜索信息、整合证据并撰写长篇分析报告——却异常困难。谷歌与伊利诺伊大学的研究团队正是瞄准了这一挑战,提出了一个名为**RubricEM**的全新训练框架。其目标很明确:让AI不仅能分阶段工作,还能从过往尝试中学习,真正像一个有经验的研究者那样思考。
一、训练“研究型AI”的固有难题
要理解RubricEM的价值,首先得看清传统方法的瓶颈所在。主流的AI训练逻辑可以概括为“做题-判分”:模型给出答案,系统根据标准答案判断对错并给予奖励或惩罚。这套方法在封闭性问题(如“2+2等于几”)上很有效,因为它依赖一个关键前提——存在明确无误的标准答案。
但当问题变成“睡眠质量如何影响老年人认知衰退”这类开放性研究课题时,麻烦就来了。首先,根本不存在唯一的“标准答案”,评判好坏本身就成了难题。其次,深度研究是一个包含数十步操作的漫长链条:规划方向、多次搜索、筛选信息、整合逻辑、撰写报告……如果最终报告质量不佳,你很难追溯问题究竟出在哪个环节:是初始计划有误?搜索关键词不当?还是最终整合混乱?传统的“只看最终结果”的奖励机制,只能给出一个笼统的“结果不好”信号,模型无法获得精准的改进指导。
第三个问题在于经验的“蒸发”。人类研究者会从每次任务中积累经验,形成方法论。但传统训练下的AI模型,每次任务结束后经验就清零了,下次遇到类似问题仍需从头摸索。如何让AI也能“吃一堑,长一智”?
面对这三个核心难题——缺乏标准答案、过程难以评估、经验无法积累——RubricEM提出了一套系统性的解决方案,其核心思路可归纳为三个关键词:**结构化**、**分段评分**、**经验复用**。
二、核心枢纽:“评分标准”如何贯穿始终
在深入方法细节前,需要先理解一个贯穿整个框架的核心概念:**评分标准(Rubric)**。
这就像教授批改论文时使用的评分表:研究问题是否明确?文献引用是否权威充分?论证逻辑是否严密?结论是否有据可依?这张表将“好报告”这个模糊概念,拆解为一系列具体、可核查的维度。
在RubricEM之前,研究者已尝试用评分标准来评估AI的最终输出。但RubricEM的核心洞见在于:评分标准不应只在终点充当“裁判”,而应成为贯穿研究全过程的“共同语言”和“行动指南”。同一套标准,可以用来引导初始规划,可以在搜索途中判断证据是否充足,可以在写作前进行自我审查,更可以成为存储经验、供未来调用的“记忆单元”。
简言之,RubricEM将评分标准提升为整个系统的元框架。AI自己生成针对具体问题的评分标准,并依据它来行动、自评和进化。框架名称中的“EM”借鉴了统计学中的“期望最大化算法”思想:先通过评分标准“估计”任务的关键维度(期望步骤),再基于此“优化”AI的行为(最大化步骤)。
三、搭建工作流:AI研究的四阶段脚手架
RubricEM的首要创新,是为AI的整个研究过程设计了一套严谨的“四阶段工作流”。
一切从**计划阶段**开始。面对一个问题,AI不会立即行动,而是先进行深度分析:明确用户需求、识别潜在误区。在此基础上,AI会生成一份个性化的评分标准,例如“回答必须区分睡眠时长与睡眠质量”、“需提供因果关系证据而非仅相关关系”。这份标准将成为后续所有阶段的“指南针”。
接着进入**研究阶段**。AI带着计划和标准,开始迭代式地搜索与阅读。每获得一批新信息,它都会进行一次“进度检查”,对照评分标准判断证据是否已充分。如果发现新证据推翻了初始假设,AI甚至可以动态调整原计划,这种灵活性在传统方法中是缺失的。
当信息收集被认为充分后,流程进入**审查阶段**。AI会系统地将所有证据与评分标准逐条核对,识别已满足和未满足的项。随后,它会制定详细的写作大纲,明确核心论点、段落结构及引用来源。
最后才是**写作阶段**。AI依据大纲生成完整的长篇报告,并对所有非显而易见的论断提供文献引用。
为何必须分阶段?研究团队从数学上给出了证明:当同一上下文(如某段证据)在不同阶段需要不同策略时(研究阶段需继续搜索,写作阶段需开始整合),一个“不知自己身处何阶段”的AI会陷入决策混乱。明确的分阶段设计,在数学期望上能保证更优的决策序列。
为了教会AI这套流程,研究团队用Gemini 3.1 Pro大模型生成了大量遵循四阶段框架的“示范研究轨迹”,并用这些数据对基础模型(Qwen3-8B)进行监督学习。生成过程本身也是一次筛选,他们剔除了那些跳过阶段或直接凭内部知识作答的不合格样本,最终获得了约1.1万条高质量训练数据。
四、精准反馈:为每个阶段的工作单独打分
第二个核心创新是一套名为**阶段结构化GRPO(SS-GRPO)**的奖励分配机制。
传统强化学习通常只在任务结束时给出一个综合分数,并将此分数均等地“广播”给过程中的每一个决策。这就好比足球队输球后,教练只批评“全队表现差”,却不指出是守门员、中场还是前锋的具体问题,球员们无从改进。
SS-GRPO的做法截然不同:它为每个阶段分别评分。一个独立的“AI法官”会评估计划是否合理、搜索是否找到关键证据、审查是否发现逻辑漏洞、报告质量如何。更重要的是,评分机制设计了“上游影响下游”的权重:一个好的计划会对后续所有阶段产生积极贡献,因此计划阶段的分数会包含这种“下游影响力”。
为确保评分本身的有效性,“AI法官”还采用了“进化式评分标准缓冲区”设计。评判者并非固守一套僵化标准,而是通过比较同一问题的多份AI答案,动态发现“区分答案优劣的关键维度”,并不断更新其评判依据。这使得评分标准能随着AI能力的进步而“水涨船高”,始终保持鉴别力。
理论分析同样支持这一机制:当分阶段评分从每个阶段捕获的真实过程信号,超过其可能引入的噪声时,它在数学上必然优于只看最终结果的评分方式。
五、经验传承:构建AI的“反思记忆库”
第三个,或许也是最独特的创新,是**反思元策略训练**与**评分标准记忆库**的结合。
其灵感来源于人类的学习方式:我们会反思每次研究的得失(“这次在无关资料上耗时过多”、“上次教会我要小心区分因果与相关”),并将这些经验提炼成指导未来的原则。
RubricEM模拟了这一过程:AI在完成一次研究后,不仅要更新模型参数(隐性知识),还需生成一段结构化的文字反思,存储为“经验条目”。反思内容固定包括针对该类问题的关键要点提醒,以及可迁移的通用经验总结。
这些条目被存入一个**评分标准记忆库**,并按语义建立索引。当AI遇到新问题时,系统会从库中检索最相关的过往经验,作为背景信息辅助其规划,这被称为“跨任务迁移”。如果AI再次遇到完全相同的问题,系统则会直接调取上次的反思,让其针对性地改进,这被称为“任务内精炼”。
一个精妙的设计在于:生成反思和执行研究任务的是**同一个AI骨干网络**。这不仅节省算力,更形成了协同效应:学习“如何写好反思”的过程,会反向提升其“如何做研究”的能力;反之,研究能力的进步也能催生更深刻的反思。理论证明,在反思方向与任务改进方向一致的条件下,这种协同训练在数学上优于只训练任务能力的模式。
为避免反思训练拖慢整体进度,研究团队设计了**异步执行机制**。主要的研究任务训练与反思数据的准备评分并行不悖:当前步骤进行任务训练时,上一步的反思评分在后台同步处理。如此一来,反思训练几乎不增加额外的训练时间。
六、实战检验:性能与洞见
研究团队在四个深度研究基准上全面评估了由RubricEM训练出的AI模型(基于80亿参数的Qwen3,命名为RubricEM-8B)。这四个基准分别是:HealthBench(医疗健康问答)、ResearchQA(覆盖75个学术领域)、DeepResearchBench(长篇报告质量)和ResearchRubrics(使用专家评分标准)。
结果令人瞩目。在四个测试的综合平均分上,RubricEM-8B以55.5分位居所有开源深度研究模型之首,超越了参数量大得多的WebThinker-32B-DPO(49.0分)和Tongyi DeepResearch-30B-A3B(50.8分),也优于使用了更强教师模型和搜索工具的DR Tulu-8B(53.6分)。值得注意的是,RubricEM仅训练了1400步就达到了这一成绩。
与顶级商业系统相比,RubricEM-8B也展现出强大竞争力。其平均分超过了Perplexity Deep Research,并在DeepResearchBench单项上超越了OpenAI的Deep Research系统。整体与OpenAI Deep Research的差距仅为4.4分。考虑到其模型规模远小于这些商业系统,这一差距已相当微小。
通过一系列“消融实验”(即逐一移除框架组件),研究团队清晰地量化了每个部分的贡献:单独使用SS-GRPO(分段评分)或单独使用反思训练,都能带来显著提升;两者结合时效果最佳,且贡献是互补的。
分阶段的工作流设计被证明是基础。实验显示,从“无结构监督学习”出发的强化学习,训练后提升微弱且不稳定;而从“有结构监督学习”出发,强化学习才能稳定地提升性能。这说明,结构化的初始训练是后续优化能够生效的前提。
另一个有趣的发现是通用能力的迁移。尽管强化学习阶段仅使用长篇研究任务数据,RubricEM-8B在多个短问题问答测试集上的平均得分达到73.5分,远高于同类模型(如DR Tulu-8B RL版的49.0分)。这表明,在复杂研究中训练出的搜索、推理与规划能力,能够有效地迁移到更简单的任务场景中。
七、启示与展望
归根结底,RubricEM回答了一个根本性问题:如何在缺乏标准答案的开放性任务上,有效地应用强化学习训练AI?其答案是:不必执着于构建一个全知全能的“外部判官”,而是让AI学会为自己建立一套内在的、自洽的评判体系,并以此指导行动、分配信用、积累经验——让评分标准成为AI的“第一语言”。
这背后是一个深刻的类比:优秀的学习者不仅依赖外界的对错反馈,更擅长为自己设定清晰目标,反思过程得失,并将经验沉淀为可复用的方法论。RubricEM将这种学习模式系统化、工程化,并通过实验验证了其效力。
当然,研究团队也坦诚指出了当前系统的局限。例如,评判模型使用的是能力相对有限的Gemini Flash,若换用更强大的模型,性能可能进一步提升。训练过程中的网络延迟等偶发因素也引入了不确定性。此外,一个根本性挑战依然存在:如果评分标准本身存在偏差,AI可能会学会“迎合”偏差而非提升真实能力——这是所有“AI评判AI”体系都需要警惕的。
这项研究提示了一个值得深思的方向:当我们期望AI在创造性、探索性任务上有所突破时,培养其内在的、基于反思的评判与学习体系,或许比设计一个完美的外部打分器更为根本,也更有价值。
Q&A
Q1:RubricEM框架与普通AI训练方法的根本区别是什么?
A:根本区别在于评估与学习的粒度。普通方法通常只根据最终输出给予一个整体奖励信号。而RubricEM让AI自己生成评分标准,并以此为标准对研究过程的每个独立阶段进行精细评估和奖励分配,同时将任务后的反思经验存入记忆库供未来调用,从而实现了在无标准答案的复杂任务上的持续、定向改进。
Q2:RubricEM训练出的AI研究助手,与OpenAI的Deep Research相比如何?
A:在综合四个深度研究基准的平均分上,仅80亿参数的RubricEM-8B与OpenAI Deep Research的差距约为4.4分,并在其中一个基准(DeepResearchBench)上实现了反超。考虑到模型规模的巨大差异,这一表现展现了该框架极高的效率与竞争力。
Q3:为何用长篇研究数据训练的RubricEM,其短问题回答能力也大幅提升?
A:因为RubricEM训练的核心是通用能力,如需求分析、信息检索、证据评估与逻辑规划。这些能力本质上是跨任务的。当AI学会了在复杂、多步骤的研究任务中严谨地工作,这种强大的基础能力自然能迁移并提升其在短问题上的表现,甚至在泛化性上优于某些专为短问答训练的模型。


正软商城本月促销专区,汇集办公、设计、安全、影音、系统工具及AI软件等正版软件优惠活动,提供限时折扣、特价授权和优惠购买信息,活动库存及价格以页面实时展示为准。

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
