


当AI试图"重新看一眼"时,它的眼睛为何总是模糊的?

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
2026年5月提出的MoCam采用分阶段新视角合成方法:早期利用粗糙点云确定布局,后期切换至原始视频修正错误并补充细节。该方法解决了传统方式中几何与外观冲突导致的画面模糊问题,在静态与动态场景中均提升了生成质量与控制精度,为影视、虚拟现实等领域提供了新思路。
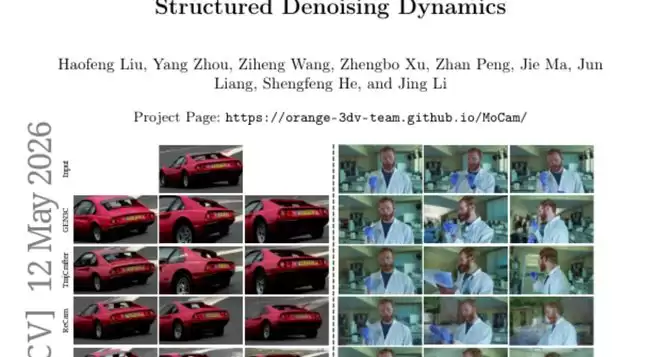
2026年5月,一项由多所高校及研究机构联合完成的研究成果以预印本形式发布,论文编号为arXiv:2605.12119。这项研究瞄准了计算机视觉领域一个颇具挑战性的问题:新视角合成。
简单来说,我们拍下的每张照片、每段视频,都只是从一个固定角度观察世界的“快照”。如果想换个角度看——比如绕到物体背后,或者从高空俯视——传统上就需要重新拍摄。那么,如果手头只有一段普通的手机视频,有没有可能让AI“脑补”出那些从未被镜头捕捉过的角度呢?听起来像魔术,但这项名为MoCam的研究,正是要解决这个难题。
它的核心突破,在于巧妙地化解了一个长期困扰业界的矛盾:指导AI生成画面的“几何信息”(空间位置与形状轮廓)和“外观信息”(颜色、纹理与细节质感),这两种信号本质上相互冲突,难以简单粗暴地同时使用。MoCam提出的“分阶段接棒”策略,让生成质量和对相机运动的控制精度,都显著超越了当时的主流方法。
一、当AI想“换个角度看”,它面临什么困难
不妨设想这样一个场景:你用手机录了一段朋友跳舞的视频,但镜头只从正面拍摄。现在你想看看他从侧面跳舞的样子,可你并没有侧面的素材。这时,你希望AI能凭借这段正面视频,“推理”出侧面的画面。
这件事的难点在于,AI必须先理解这个三维空间的结构——哪里是手臂,哪里是腿,背景的桌子又在什么位置——然后才能将这个结构从新的角度“投影”成二维图像。然而,从普通视频中“重建”三维结构本身就不精确。用单摄像头估计深度,就像用一只眼睛判断距离,误差难以避免。结果,AI重建出的三维点云(可以理解为散落在空间中的彩色点阵)往往充满漏洞、扭曲和错误。
现有的主流方法大致分两类。一类是“给AI一张三维草图,让它照着画”:先根据视频重建出粗糙的三维点云,渲染成新视角下的画面,再用AI模型把这张“草图”补全。像Gen3C和TrajectoryCrafter就属于这一类。问题在于,草图本身是错的,AI在错误基础上“加工”,最终画面里人物的手臂可能扭曲,背景出现奇怪的破洞。
另一类是“直接告诉AI相机怎么动,让它自己生成”:这类方法(如ReCamMaster)不依赖三维重建,而是把摄像机运动信息直接注入模型,期望AI自行推断新视角。但问题在于,当摄像机转动幅度很大时,AI很容易“迷失方向”,生成的画面几何结构一塌糊涂。
简而言之,前者知道“空间在哪里”,但空间信息是错的;后者知道“摄像机怎么动”,但对空间毫无把握。两种方法都卡在同一个根本矛盾上:几何信息和外观信息,各有所长,却无法和平共处。
二、两种信号为何不能同时使用
MoCam的研究团队指出,矛盾的根源在于这两种信号存在本质冲突。
几何信息(由三维点云渲染的草图)的优势在于“空间定位”:它知道新视角下物体的大致位置关系,知道摄像机移动后,背景该出现在画面左边还是右边,人物该变大还是变小。这是外观信息天生不具备的能力。但其劣势也很明显:由于深度估计不准,这张草图本身充满破洞和扭曲。如果AI全程被它引导,这些错误就会被“固化”到最终结果里,再也无法修正。
外观信息(原始参考视频)的优势在于“细节保真”:它提供了真实、清晰、丰富的纹理细节,人物的皮肤质感、衣物纹路、场景的光影变化都保存完好。但其劣势在于视角固定:它来自原始拍摄角度,与新视角不一致。如果在生成早期就引入它,AI会被原始视角的“视觉惯性”牢牢拉住,忘记新视角应有的空间布局。
研究团队将这种冲突形容为:早期若让外观信息主导,几何结构会漂移;晚期若仍让几何信息主导,其缺陷会被永久固化。两者若同时使用,则相互干扰,导致信号混乱。这好比两位厨师同时烹饪一道菜,一位只管调味,一位只管火候,但理念完全不同——结果很可能既不好吃,也不好看。
三、MoCam的核心思路:先画骨架,再填血肉
MoCam的解决方案,本质上是一个“分阶段接棒”的策略。它借鉴了一个关于创作过程的朴素直觉:先打草稿定结构,再细化润色。
要理解这个策略,需要先了解一点生成式AI(如Stable Diffusion、Wan系列模型)的工作原理。它们大多基于“扩散模型”。这个模型的工作方式可以打个比方:想象一张照片被慢慢撒上雪花,直到完全变成一片纯白,这个过程叫“加噪”。扩散模型学会的是逆向的“去噪”——从一片纯白开始,一步步去掉雪花,最终还原出清晰图像。
关键在于,在“去噪”的早期步骤(噪声还很多时),模型主要在确定画面的大体结构和构图;到了后期步骤(噪声快被去完时),才专注于处理衣服纹路、树叶形状、皮肤质感这些细节。
MoCam正是巧妙地利用了这个特性。它的策略是:在“去噪”的早期阶段,只让AI参考几何信息(那张粗糙的三维草图),用它来确定新视角下画面的大致结构和空间布局;当画面的“骨架”已经搭稳后,在后期阶段切换到外观信息(原始参考视频),用真实丰富的纹理来修正早期骨架遗留的几何错误,并填充因视角变化而新出现的“空洞”区域。
简单说,就是几何信息在早期负责“定方向”,外观信息在晚期负责“修错误+填细节”。两种信号各司其职,互不干扰,而非同时争夺AI的注意力。这个切换的时间点由一个名为“Tswitch”的参数控制,研究团队通过实验将其设定为0.85,意味着在整个去噪过程进行到85%之前使用几何信息,之后则切换为外观信息。
四、MoCam的具体工作流程
MoCam的完整流程可以分为三个环环相扣的步骤。
第一步,生成“空间草图”。 给定一段输入视频(或单张图片),系统先用深度估计模型分析每一帧,计算出每个像素距离摄像机的深度。结合摄像机内部参数(如焦距),就能将二维像素“反投影”到三维空间,形成一团三维点云——好比一堆散落在空间中的彩色沙粒,记录了场景的空间结构。接着,按照用户指定的新摄像机运动轨迹,将这团点云从新视角“投影”回二维画面,得到一段粗糙的“草图视频”。这段视频在空间和运动上是对齐的,但充满了破洞和变形。
第二步,对两种信号分别编码。 系统使用一个称为VAE(可变自编码器)的工具,分别将草图视频和原始参考视频压缩成紧凑的数学表示(可以理解为“高度压缩的视频精华”)。草图视频的压缩版称为“几何条件”,参考视频的压缩版称为“外观条件”。这两种条件信号将在不同阶段被送入核心的生成模型。
第三步,阶段性生成目标视频。 生成模型从一团纯噪声(全是“雪花”的状态)开始,按规则去噪:在前85%的步骤中,只接受“几何条件”的引导,逐步形成具有正确空间布局的粗糙画面;在后15%的步骤中,切换为只接受“外观条件”的引导,对画面进行精细修正和纹理填充,最终输出清晰完整的目标视角视频。
值得一提的是,这套流程对静态场景(单图重建多视角视频)和动态场景(运动视频重新渲染为新角度视频)同样适用。对于单张图片,系统只需将其复制成多帧,当作一段“静止视频”来处理,后续步骤完全一致。这种统一性正是研究的亮点之一——同一套方法,同时攻克了3D(静态)和4D(动态)两类问题。
五、实验验证:数字背后的真实含义
研究团队在多个数据集上进行了大量实验,将MoCam与当时最先进的几种方法,包括Gen3C、TrajectoryCrafter(论文中称TrajCrafter)、ReCamMaster(论文中称ReCam)以及ViewCrafter进行了全面比较。
评估维度相当全面:背景一致性(生成视频背景是否稳定)、主体一致性(画面主体在不同视角下外观是否连贯)、成像质量(画面清晰自然程度)、FVD-V分数(衡量生成视频与真实视频感知差距,越低越好)、CLIP-V分数(衡量不同视角间视觉相似性,越高越好),以及旋转误差和平移误差(衡量摄像机运动准确度)。
在静态场景的单视角3D重建任务中,MoCam在几乎所有指标上都取得了最优成绩。尤其是FVD-V分数,MoCam为255.16,而排名第二的Gen3C为289.37,差距明显。CLIP-V分数方面,MoCam达到0.87,也高于其他方法。旋转误差上,MoCam以1.35度与Gen3C的1.36度基本持平,均优于ReCamMaster的2.13度。
在动态场景的4D重新渲染任务中,结果同样突出。背景一致性(0.9332)、主体一致性(0.9247)、成像质量(0.6932)均优于所有对比方法。在另一个专用于视频重建的iPhone数据集上(该数据集提供真实多视角参考,可用PSNR、SSIM等像素级指标评估),MoCam的PSNR达到14.60,明显优于TrajCrafter的13.74和Gen3C的12.36;FVD分数为180.35,远低于其他方法(Gen3C为260.15,TrajCrafter为273.36,ReCamMaster为301.41)。
特别有说服力的是“抗几何退化”实验。团队故意让摄像机做越来越大幅度的旋转——从30度一路增加到90度——来模拟几何信息越来越稀疏、不准确的极端情况。90度旋转意味着摄像机几乎绕到物体背面,点云数据大量缺失,草图视频几乎全是破洞。在这种压力测试下,Gen3C和TrajCrafter的各项指标随旋转角度增大而急剧下降;ReCamMaster虽不依赖点云,但因缺乏几何骨架约束,在大旋转下几何结构完全崩塌;而MoCam的各项指标曲线则明显平稳得多,在90度旋转下仍能保持相对较高的质量。这正是MoCam设计的关键所在:早期几何锚定防止漂移,晚期外观修正弥补点云的稀疏缺陷。
六、消融实验:缺掉任何一环都不行
为了验证“阶段性切换”这一核心设计的必要性,研究团队专门进行了一组消融实验,逐一测试去掉某个组件后的效果。
“仅使用几何条件”的变体: 从头到尾只让AI看草图视频。结果成像质量分数仅为0.4807,是所有变体中最差的。几何错误被彻底固化,导致人物和场景严重变形。
“几何条件仅用于早期”的变体: 前半段用几何条件,后半段什么都不用。这避免了几何错误固化,但后期没有外观信息引导,AI只能靠自己“脑补”细节。结果画面纹理模糊,那些原始视角看不到、新视角才出现的遮挡区域,生成的内容显得平庸且不自然。
“同时使用两种条件”的变体: 从头到尾把两种信号拼在一起给AI。结果成像质量尚可,但旋转误差高达2.71度,平移误差高达11.01,意味着AI在摄像机运动方向上完全搞错了。原因正是两种信号的摄像机运动方向相互矛盾,造成严重干扰,让AI既想跟着草图走,又被原始视频拉着跑,最终迷失方向。
只有MoCam完整的“阶段切换”设计,综合了所有指标的最优表现:成像质量0.6932,旋转误差1.36度,平移误差5.12。这组实验清晰地证明,既不能全程依赖几何,也不能全程依赖外观,更不能同时依赖两者——阶段性切换,是唯一有效的解法。
此外,团队还在Wan2.1(而非主要使用的Wan2.2)骨干模型上测试了相同方法,结果同样优秀,证明这套策略与具体的视频生成模型架构无关,具备较好的通用性。团队还测试了当深度估计本身出现误差时MoCam的表现:即使草图中的物体形状因深度错误而发生扭曲,MoCam仍能在最终输出中将其修正,而对比的“同时使用两种条件”方法则无法完成这种修正。
七、这项研究意味着什么
说到底,MoCam在一个普遍认为“两种信息必须融合”的问题上,提出了一种更聪明的思路:不是融合,而是排队。就像一个优秀的导演,不会让摄影师和美术师同时对着一个场景争论,而是先让美术师搭好布景(定结构),再让摄影师调光补细节(精修饰)。这个顺序,决定了最终成果的质量。
从应用前景看,这项技术的成熟意味着,未来影视制作中的虚拟摄像机重定位(用一段普通视频生成不同角度的专业级画面)、虚拟现实内容的批量生成,乃至普通人用手机视频自由调整“拍摄角度”的个人应用,都将变得更加可行。当然,当前版本仍有局限,研究团队在结论中也提到,未来可能会探索草图和视频的联合迭代优化,让两种信号在生成过程中能相互反馈、共同演化,而不仅仅是简单的阶段切换。
对更广泛的读者而言,这项研究或许提供了一个直观的启示:当两种关键信息相互冲突时,与其强行融合,不如深思“谁在哪个时刻最有用”。有时候,时机和顺序,比简单的合并更重要。
Q&A
Q1:MoCam方法和Gen3C、TrajectoryCrafter这些旧方法相比,最根本的区别是什么?
A: 旧方法要么全程依赖有错误的三维点云草图(导致几何错误被固化),要么把草图和原始视频同时喂给AI(导致信号相互干扰)。MoCam的根本区别在于将生成过程明确分为两个阶段:前期只用草图锁定空间结构,后期切换为只用原始视频修正错误、补充细节。这种“排队”而非“融合”的思路,让两种信号在各自最合适的时机发挥作用,避免了相互干扰。
Q2:MoCam处理单张图片和处理视频的方式有什么不同?
A: 本质上没有不同。对于单张图片,系统只需将其复制成N帧,当作一段“完全静止的视频”来处理,后续的深度估计、点云重建、阶段性扩散生成流程完全一致。这也是MoCam能“统一”处理3D和4D两类问题的核心——同一套逻辑框架,无需为不同输入类型做特殊设计。
Q3:MoCam的“阶段切换时间点”是怎么确定的,如果切换太早或太晚会怎样?
A: 研究团队通过实验将切换点设定在整个去噪过程的85%处(参数Tswitch=0.85)。如果切换太早(几何阶段不充分),空间结构尚未稳定就引入外观信号,画面容易出现几何漂移;如果切换太晚(几何阶段过长),点云草图中的错误会被深度“烤入”画面,后期的外观修正将无能为力。0.85这个值是在验证集上通过实验经验选定的,未来研究可能会探索更动态、自适应的切换策略。











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,