


Python屏蔽API状态输出技巧
在Python中屏蔽第三方API调用的状态信息输出,核心方法是重定向标准输出流(sys.stdout)和配置logging模块;具体可通过contextlib.redirect_stdout将输出重定向到os.devnull以屏蔽所有print和sys.stdout.write输出,或通过logging.getLogger获取对应日志器并设置其级别为CRITICAL、添加NullHandler来精细化控制日志输出;相比粗暴的重定向,推荐使用logging模块以避免影响自身调试信息,并可在不同环境灵活调整输
在Python中屏蔽第三方API调用的状态信息输出,核心方法是重定向标准输出流(sys.stdout)和配置logging模块;具体可通过contextlib.redirect_stdout将输出重定向到os.devnull以屏蔽所有print和sys.stdout.write输出,或通过logging.getLogger获取对应日志器并设置其级别为CRITICAL、添加NullHandler来精细化控制日志输出;相比粗暴的重定向,推荐使用logging模块以避免影响自身调试信息,并可在不同环境灵活调整输出级别;需注意屏蔽输出可能掩盖关键错误、增加调试难度,因此应分阶段控制、区分日志级别,并结合集中日志系统实现生产环境的整洁与可维护性。
在Python中,要屏蔽第三方API调用的状态信息输出,核心方法主要集中在重定向标准输出流(sys.stdout)和更精细的日志模块(logging)配置上。通过这些方法,你可以有效地控制程序运行时的信息量,避免不必要的控制台干扰。
解决方案
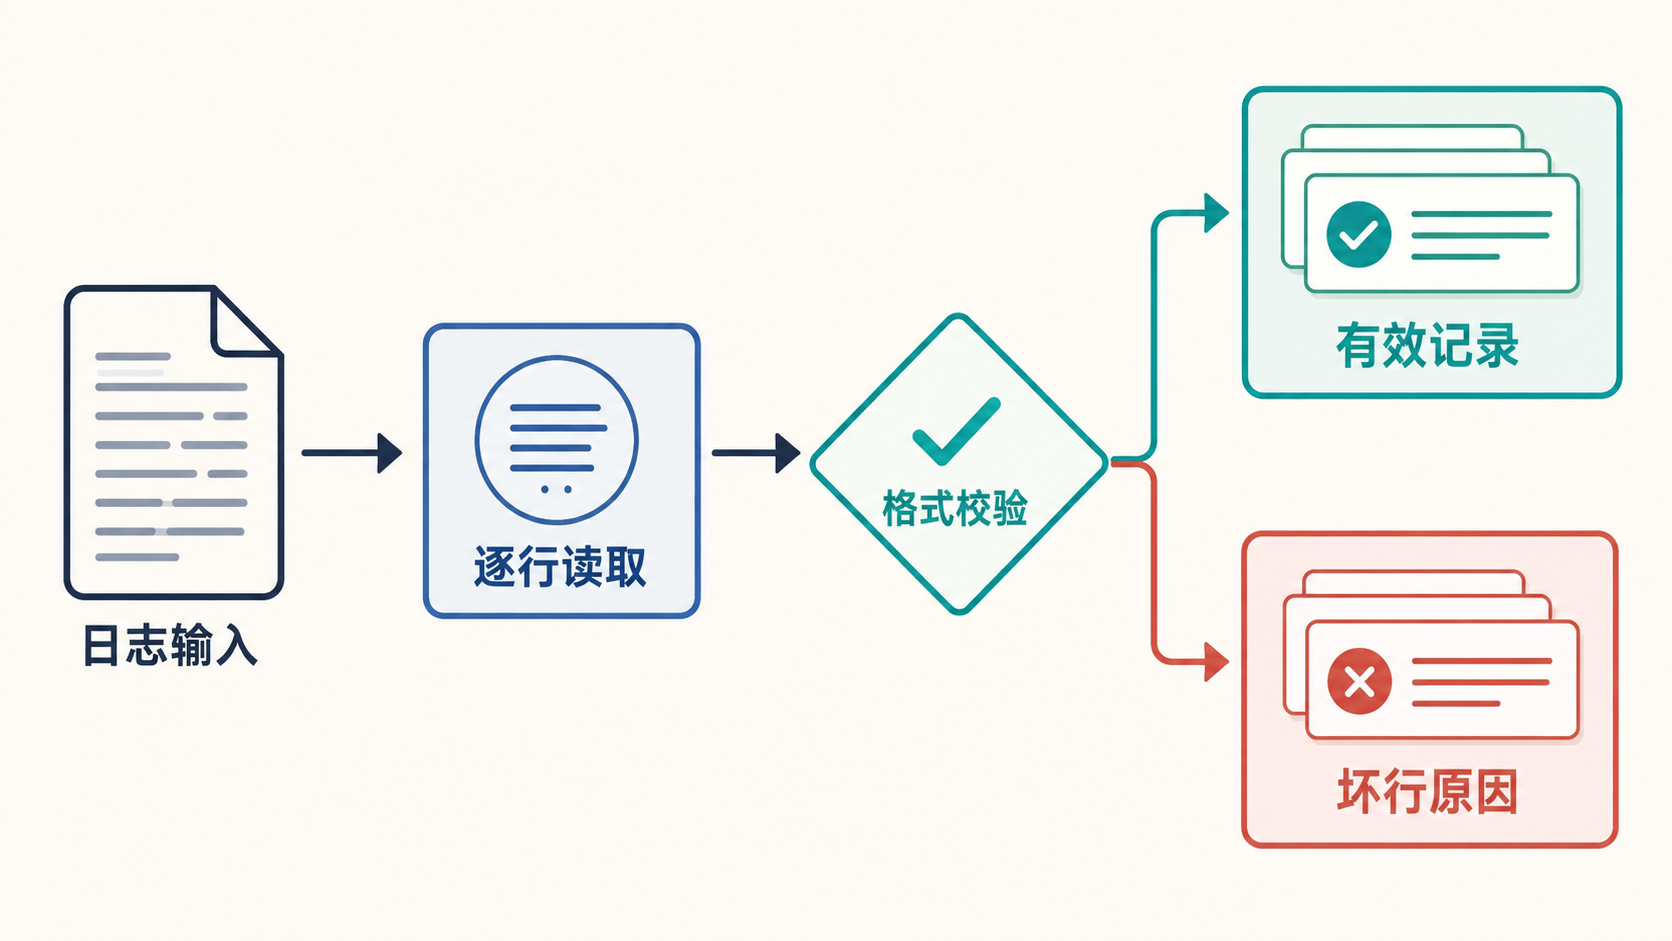
处理第三方API的输出噪音,最常见且有效的方式有两种:一是直接粗暴地重定向标准输出,二是利用Python强大的logging模块进行精细化管理。
对于前者,你可以暂时将sys.stdout指向一个空设备或自定义的“黑洞”对象。这就像给程序的嘴巴贴上胶带,它想说什么,都会被悄无声息地吞掉。
import sys
import os
from io import StringIO
import contextlib

# 假设这是一个会产生大量输出的第三方API调用
def noisy_third_party_call():
    print("第三方API:正在初始化...")
    print("第三方API:连接成功!")
    print("第三方API:数据处理中...")
    # 模拟一些更深层次的、难以控制的输出
    sys.stdout.write("第三方API:底层调试信息,通常很难禁用。\n")
    return "处理结果"

# 方法一:使用contextlib.redirect_stdout重定向到空设备
# 这种方法简单粗暴,会屏蔽所有print和sys.stdout.write的输出
with contextlib.redirect_stdout(open(os.devnull, 'w')):
    result_redirected = noisy_third_party_call()
print(f"重定向后,我只看到了结果:{result_redirected}")

# 方法二:更推荐的日志模块控制
# 大多数成熟的第三方库都会使用logging模块来输出信息
# 我们可以配置logging模块来控制其输出级别或目标
import logging

# 假设第三方库的日志器名称是 'third_party_lib'
# 如果不确定,可以尝试获取根日志器或观察其输出
logger = logging.getLogger('third_party_lib')
# 或者如果你想屏蔽所有日志,可以配置根日志器
# logger = logging.getLogger()

# 设置日志级别为CRITICAL,意味着只有CRITICAL级别的消息才会被处理
# 这会有效地屏蔽INFO, DEBUG, WARNING, ERROR等常见级别的信息
logger.setLevel(logging.CRITICAL)

# 或者,更彻底一点,将所有日志发送到一个空处理器
# 这样即使日志级别很低,也不会有任何输出
logger.addHandler(logging.NullHandler())

# 模拟一个使用logging的第三方库
def another_noisy_third_party_call_with_logging():
    logging.getLogger('third_party_lib').info("第三方库:这是一个信息日志。")
    logging.getLogger('third_party_lib').warning("第三方库:这是一个警告。")
    logging.getLogger('third_party_lib').error("第三方库:这是一个错误!")
    return "处理结果(日志屏蔽)"

result_logging_controlled = another_noisy_third_party_call_with_logging()
print(f"日志控制后,我只看到了结果:{result_logging_controlled}")

# 记得在不需要屏蔽时恢复日志配置,以免影响其他部分
# 例如,移除NullHandler或重置日志级别
# logger.removeHandler(logging.NullHandler())
# logger.setLevel(logging.NOTSET) # 恢复到默认或更低的级别我个人更倾向于使用logging模块来处理这类问题。它提供了一种更加优雅和可控的方式,而不是一刀切地屏蔽所有输出。
为什么需要屏蔽第三方API的输出?
这问题问得好,很多时候,你可能觉得输出信息越多越好,但实际情况并非总是如此。我个人在处理一些遗留系统或者集成某些“话痨”的第三方库时,深切体会到这种“输出泛滥”带来的困扰。
首先,最直观的感受就是控制台的混乱。当你运行一个复杂的脚本,里面调用了十几个不同的库,每个库都争先恐后地往屏幕上打印各种初始化、连接状态、调试信息,你的真正输出——比如你计算的结果、你程序的核心日志——很快就会被淹没。这就像在一个喧闹的菜市场里找一个特定的声音,几乎不可能。
其次,这还涉及到性能和资源消耗。别小看那些print语句或者日志输出。在高性能场景下,频繁的I/O操作(包括向控制台写入)是会带来显著开销的。尤其是在循环中或者处理大量数据时,每一条不必要的输出都在拖慢你的程序。我曾经遇到过一个情况,一个库在每次迭代都打印大量调试信息,结果导致整个批处理任务慢了不止一倍。
再者,生产环境的整洁性。在部署到生产环境时,我们通常只关心关键的错误信息和业务日志,而不是库内部的调试细节。过多的输出不仅会污染日志文件,增加存储成本,还会让运维人员难以快速定位真正的问题。想象一下,几GB的日志文件里,90%都是无关紧要的“API已连接”这类信息,这简直是噩梦。
最后,有时也出于隐私或安全的考虑。某些第三方库可能会在调试模式下输出一些敏感信息,比如API密钥的部分信息、内部IP地址、请求的完整URL等。虽然这通常是开发阶段的便利,但在生产环境中,这些信息可能成为安全漏洞。屏蔽或精细控制输出,也是一种安全实践。
所以,在我看来,屏蔽不必要的输出,不仅仅是为了视觉上的清爽,更是为了提高效率、降低维护成本和增强系统安全性。这是一种对信息流的“断舍离”,只保留真正有价值的部分。
常见屏蔽输出的方法有哪些具体实现?
具体到操作层面,我们有几种策略来对付那些喋喋不休的第三方库。
1. sys.stdout 的重定向:
这是最直接的方式,相当于把程序的标准输出流导向一个“黑洞”或者一个你指定的临时文件。Python的contextlib.redirect_stdout是一个非常方便的工具,它能以上下文管理器的形式,优雅地处理这种重定向。
import sys
import os
from io import StringIO
from contextlib import redirect_stdout

def some_noisy_function():
    print("这是函数内部的正常输出。")
    sys.stdout.write("这是通过sys.stdout.write输出的。\n")
    # 模拟第三方库的print
    print("第三方库:正在进行一些操作...")
    # 模拟第三方库的底层C扩展或其他直接写入stdout的行为
    # 注意:redirect_stdout对C扩展直接写入stdout的情况可能不完全奏效,
    # 但对Python层面的print和sys.stdout.write是有效的。
    return "操作完成"

# 方式一:重定向到空设备(彻底消失)
print("--- 开始重定向到 /dev/null ---")
with open(os.devnull, 'w') as fnull:
    with redirect_stdout(fnull):
        result = some_noisy_function()
print(f"重定向到/dev/null后的结果:{result}")
print("--- 结束重定向 ---")

# 方式二:重定向到一个字符串缓冲区(捕获但不显示)
print("\n--- 开始重定向到字符串缓冲区 ---")
buffer = StringIO()
with redirect_stdout(buffer):
    result_buffered = some_noisy_function()
captured_output = buffer.getvalue()
print(f"重定向到缓冲区后的结果:{result_buffered}")
print(f"捕获到的输出内容:\n'{captured_output}'")
print("--- 结束重定向 ---")

# 这种方法简单粗暴,但要注意它会屏蔽所有通过print和sys.stdout.write的输出,
# 包括你自己的调试信息,所以通常只在特定代码块或测试中使用。
2. logging 模块的精细控制:
这是我个人最推荐的方式,因为它更符合现代软件开发的最佳实践。大多数设计良好的第三方库都会使用Python的logging模块来输出信息。这意味着你可以通过配置logging模块来控制它们的行为。
设置日志级别: 每个日志消息都有一个级别(DEBUG, INFO, WARNING, ERROR, CRITICAL)。你可以告诉日志器只处理某个级别以上的信息。
import logging

# 假设第三方库使用了名为 'requests' 的日志器
# 也可以是其他名称,比如 'boto3', 'urllib3' 等
# 如果不确定,可以获取根日志器:logging.getLogger()
lib_logger = logging.getLogger('requests')

# 将其级别设置为ERROR,这样INFO, DEBUG, WARNING等消息就不会被处理
lib_logger.setLevel(logging.ERROR)

# 示例:模拟requests库的警告(通常是因为verify=False等)
# import requests
# try:
#     requests.get('https://expired.badssl.com/', verify=False)
# except requests.exceptions.SSLError:
#     pass # 忽略证书错误,但通常会产生InsecureRequestWarning

# 也可以为根日志器设置级别,这会影响所有未单独设置的日志器
# logging.getLogger().setLevel(logging.WARNING)
使用
NullHandler: 这是屏蔽特定日志器输出的终极武器。你可以给一个日志器添加一个NullHandler,这个处理器会接收所有日志消息,但什么也不做,就像把消息丢进了一个无底洞。import logging # 获取你想要屏蔽的第三方库的日志器 # 再次强调,你需要知道它的日志器名称,通常在库的文档或源码中可以找到 # 例如,requests库的警告通常来自 'urllib3.connectionpool' 或 'requests.packages.urllib3.connectionpool' # 简单起见,这里假设一个通用的 'my_noisy_lib' noisy_lib_logger = logging.getLogger('my_noisy_lib') # 清除该日志器可能已有的所有处理器,以防它们继续输出 noisy_lib_logger.handlers = [] # 添加一个NullHandler noisy_lib_logger.addHandler(logging.NullHandler()) # 设置日志级别,通常设置为DEBUG或INFO,确保NullHandler能接收到所有消息 # 因为NullHandler本身不关心级别,但日志器会先过滤 noisy_lib_logger.setLevel(logging.DEBUG) # 模拟第三方库的日志输出 def simulate_noisy_lib_activity(): log = logging.getLogger('my_noisy_lib') log.debug("MyNoisyLib: 调试信息") log.info("MyNoisyLib: 连接成功") log.warning("MyNoisyLib: 发生一个不重要的警告") log.error("MyNoisyLib: 这是一个错误!") print("--- 开始模拟第三方库日志,并使用NullHandler屏蔽 ---") simulate_noisy_lib_activity() print("--- 结束模拟 ---") # 你会发现上面没有任何MyNoisyLib的输出 # 恢复日志器(如果需要,比如在测试结束后) # 移除NullHandler,并重新添加一个StreamHandler或FileHandler # noisy_lib_logger.removeHandler(logging.NullHandler()) # noisy_lib_logger.addHandler(logging.StreamHandler(sys.stdout)) # noisy_lib_logger.setLevel(logging.INFO)
3. 库特定的配置或环境变量: 有些设计精良的库会提供自己的配置选项,让你在初始化时就能控制它们的输出行为。这可能是通过构造函数的参数,或者设置特定的环境变量。例如,某些深度学习框架可以通过设置环境变量来控制C++后端库的输出。这需要你查阅特定库的文档。这通常是最优雅的方式,因为它是由库开发者提供的官方控制点。
在实际操作中,我通常会先尝试logging模块的配置,因为它是Python的标准,兼容性最好。如果logging不行,或者库的输出实在太底层(比如直接写到C的stdout),才会考虑sys.stdout的重定向。
屏蔽输出可能带来的潜在问题与权衡?
说实话,屏蔽输出这事儿,就像是给你的程序戴上眼罩。它确实能让你眼前一亮,不再被各种琐碎信息干扰,但同时也可能让你错过一些重要的东西。这里面确实存在一些微妙的权衡,我个人在这方面吃过不少亏。
最大的问题就是你可能会错过关键的错误或警告。想象一下,你把一个第三方库的所有输出都屏蔽了,结果它在后台默默地因为网络问题、认证失败或者数据格式不匹配而报错,但你一无所知。你的程序可能表面上还在运行,但实际上已经偏离了预期,甚至在产生错误的结果。等到你发现问题时,往往已经积重难返,排查起来更是难上加难,因为你失去了第一手的日志信息。
其次,调试会变得异常困难。尤其是在开发和测试阶段,第三方库的输出往往是理解其内部工作机制、定位问题的重要线索。比如,一个API调用失败了,如果库能告诉你“参数校验失败:用户ID不能为空”,那比你只看到一个空洞的“调用失败”要强太多了。当你屏蔽了这些信息,就像是在黑暗中摸索,大大增加了调试的时间和复杂度。我经常发现,为了调试一个被屏蔽输出的模块,不得不临时取消屏蔽,重新运行,这本身就是一种效率的损失。
还有一点,可能掩盖了真正的性能瓶颈。虽然前面提到输出本身可能带来性能开销,但有时候,过多的输出也可能是一个信号,表明库在做一些不必要或低效的操作。如果你直接屏蔽了所有输出,你可能就错过了这个“噪音警报”,从而无法发现并优化潜在的性能问题。
所以,我的建议是:不要盲目地一刀切。在决定屏蔽输出之前,先花点时间了解这些输出的含义。
- 分阶段控制: 在开发和测试阶段,我通常会保持较高的日志级别,甚至打开所有输出,以便于观察和调试。只有在代码稳定,准备部署到生产环境时,才会考虑降低日志级别或进行更严格的输出控制。
- 区分重要性: 尝试区分哪些是真正的调试信息,哪些是重要的警告或错误。例如,你可以只屏蔽
DEBUG和INFO级别的日志,而保留WARNING和ERROR级别的日志。这样既能减少噪音,又能确保你不会错过关键问题。 - 集中日志管理: 更好的实践是将所有日志(包括第三方库的)都导向一个统一的日志系统(如ELK Stack, Grafana Loki等)。这样,即使你在控制台看不到,这些信息仍然被收集起来,需要时可以随时查询,既保证了生产环境的整洁,又保留了排查问题的能力。
总的来说,屏蔽输出是一种工具,而非目的。它的价值在于帮助你聚焦,而不是让你失明。合理地运用它,才能真正提升你的开发效率和系统稳定性。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,